检测评估
ChatGPT 能判断 AI 图片吗?从信息论看“看懂”与“鉴别”的区别
从信息保留这一理论问题解释通用大模型与专业图片检测的区别,并结合 FVIMG V2 在公开基准上的实测 ROC 与混淆矩阵,不披露内部技术路径。
发布于 · 更新于 · 6 分钟阅读
本页内容
ChatGPT 能判断一张图片是不是 AI 生成的吗?它可能指出有用线索,但“看懂图片”并不自动等于“辨别图片来源”。 两张来源不同的图片,可以表达完全相同的内容。真正的鉴别问题,是系统是否保留了与来源有关的信息,以及这些信息能否支持经过验证的判断。
Fileverity 的检测流程不调用 LLM。 我们使用专用机器学习与文件技术核验完成检测。本文只讨论一个公开的理论问题:内容信息与来源信息为什么不能相互替代。不展开我们的内部网络结构、特征选择或技术组合。
同一句正确描述,为什么可能对应两种不同来源
设想两张图片:一张由相机拍摄,另一张由生成模型合成,画面都是“一辆红色汽车停在砖墙旁”。一个视觉助手对两张图片都给出这句话,甚至准确说明了车身颜色、构图和光照。
描述没有错,但它没有回答来源问题。假如后续审核只接收这句话,两张图片就变成了同一个输入。无论再对这句话推理多少次,都无法仅凭它区分刚才那两份不同的文件。
这也解释了为什么“画面有没有不合理的地方”不能成为完整的检测逻辑。手指正常,不意味着照片一定来自相机;反光奇怪,也不意味着图片一定由 AI 生成。视觉异常可以成为线索,但线索与来源的关联需要用数据验证,而不是凭直觉赋予它确定性。
如果需要实际检查步骤,可以先阅读如何判断图片是否由 AI 生成。这里进一步解释:为什么专业检测要研究来源信号,而不是仅仅描述内容。
信息瓶颈:判断之前,哪些信息已经被丢掉了
用三个符号表示这个问题:Y 是来源类别,X 是可供检查的图片,T 是从图片得到的一种表示,例如文字描述。当判断只依据 T 时,关键在于 T 保留了多少关于 Y 的信息。
MIT 信息论讲义中的数据处理不等式给出了这一关系:I(Y; T) ≤ I(Y; X)。在这条处理链中,变换不会凭空增加有关来源的信息。
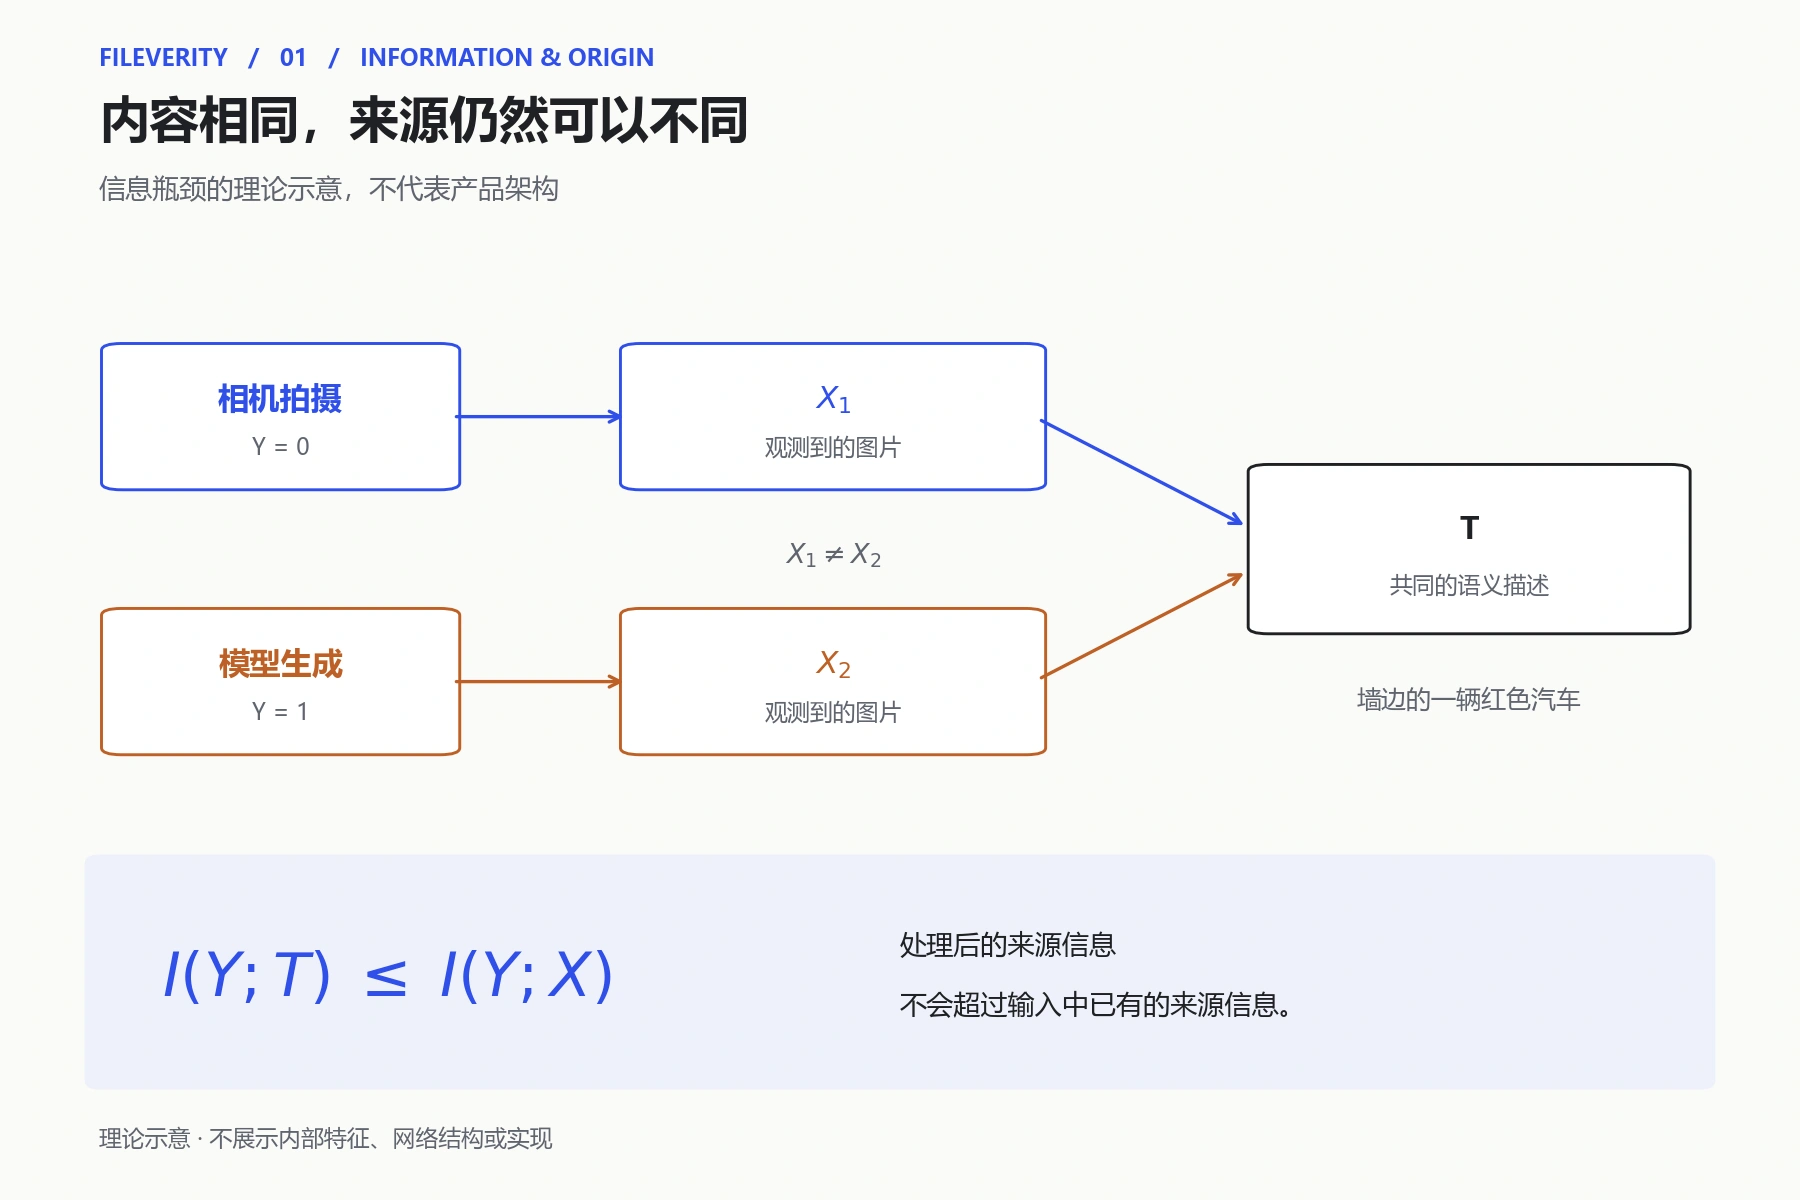
理论示意,不是 Fileverity 的模型结构图。Y 表示来源,X 表示观测到的图片,T 表示派生表示;图中不包含我们的特征或算法实现。
这里并不是说“任何压缩或特征提取都会损害检测”。设计得当的表示,可以保留某项任务需要的信息。问题在于:适合描述场景的表示,不一定充分保留了区分来源所需的信息。 理解对象、容忍外观变化与辨别生成过程,是不同的优化目标。
这条原理也不等于证明所有多模态 LLM 都不可能检测图片。有的模型直接接收图像信息,专门训练也可能改变其能力。它说明的是一个更严格的结论:不能从“通用理解能力很强”,直接推导出“来源检测能力已经得到验证”。
专用检测如何把来源信号变成可以检验的问题
假设 E 是一个抽象的观测量。来源判别关注的不是 E 是否符合故事情节,而是:在生成图片和相机照片中,观察到 E 的相对可能性有什么不同?这一问题可以用一般的似然比表达:
L(E) = p(E | 生成图片) / p(E | 相机照片)
这不是我们的实现公式,而是解释检测目标的统计模型。比值越大,表示在所假设的分布下,这个观测更支持生成来源。但它不直接等于“这张图片为假的概率”;后者还涉及先验比例与模型是否适用于当前数据。
实际工作中,可以在不知道真实分布的情况下,对学习得到的检测分数进行经验评价:固定阈值,在已知来源的样本上统计检出、漏检与误报。改变阈值,就会形成不同的检出率与误报率组合,ROC 曲线记录的正是这种关系。
公开研究也体现了这种任务划分。例如,《Zero-Shot Detection of AI-Generated Images》研究图像在真实图片模型下的统计可预测性。引用它是为了说明“来源信号”是一类可研究的问题,并不表示 Fileverity 使用了该论文的方法。
真实数据:FVIMG V2 的来源区分能力如何表现
下面的图由 2026 年 11 月 1 日 FVIMG V2 评测保存的逐图预测记录计算得到。它与前面的理论图性质不同:这里展示的是 Synthbuster 生成图片与 RAISE-1k 相机照片的实际检测结果。两者都是公开数据集,可以自行查阅;Fileverity 的模型则基于海量独家自有的专业化数据样本研发与验证。
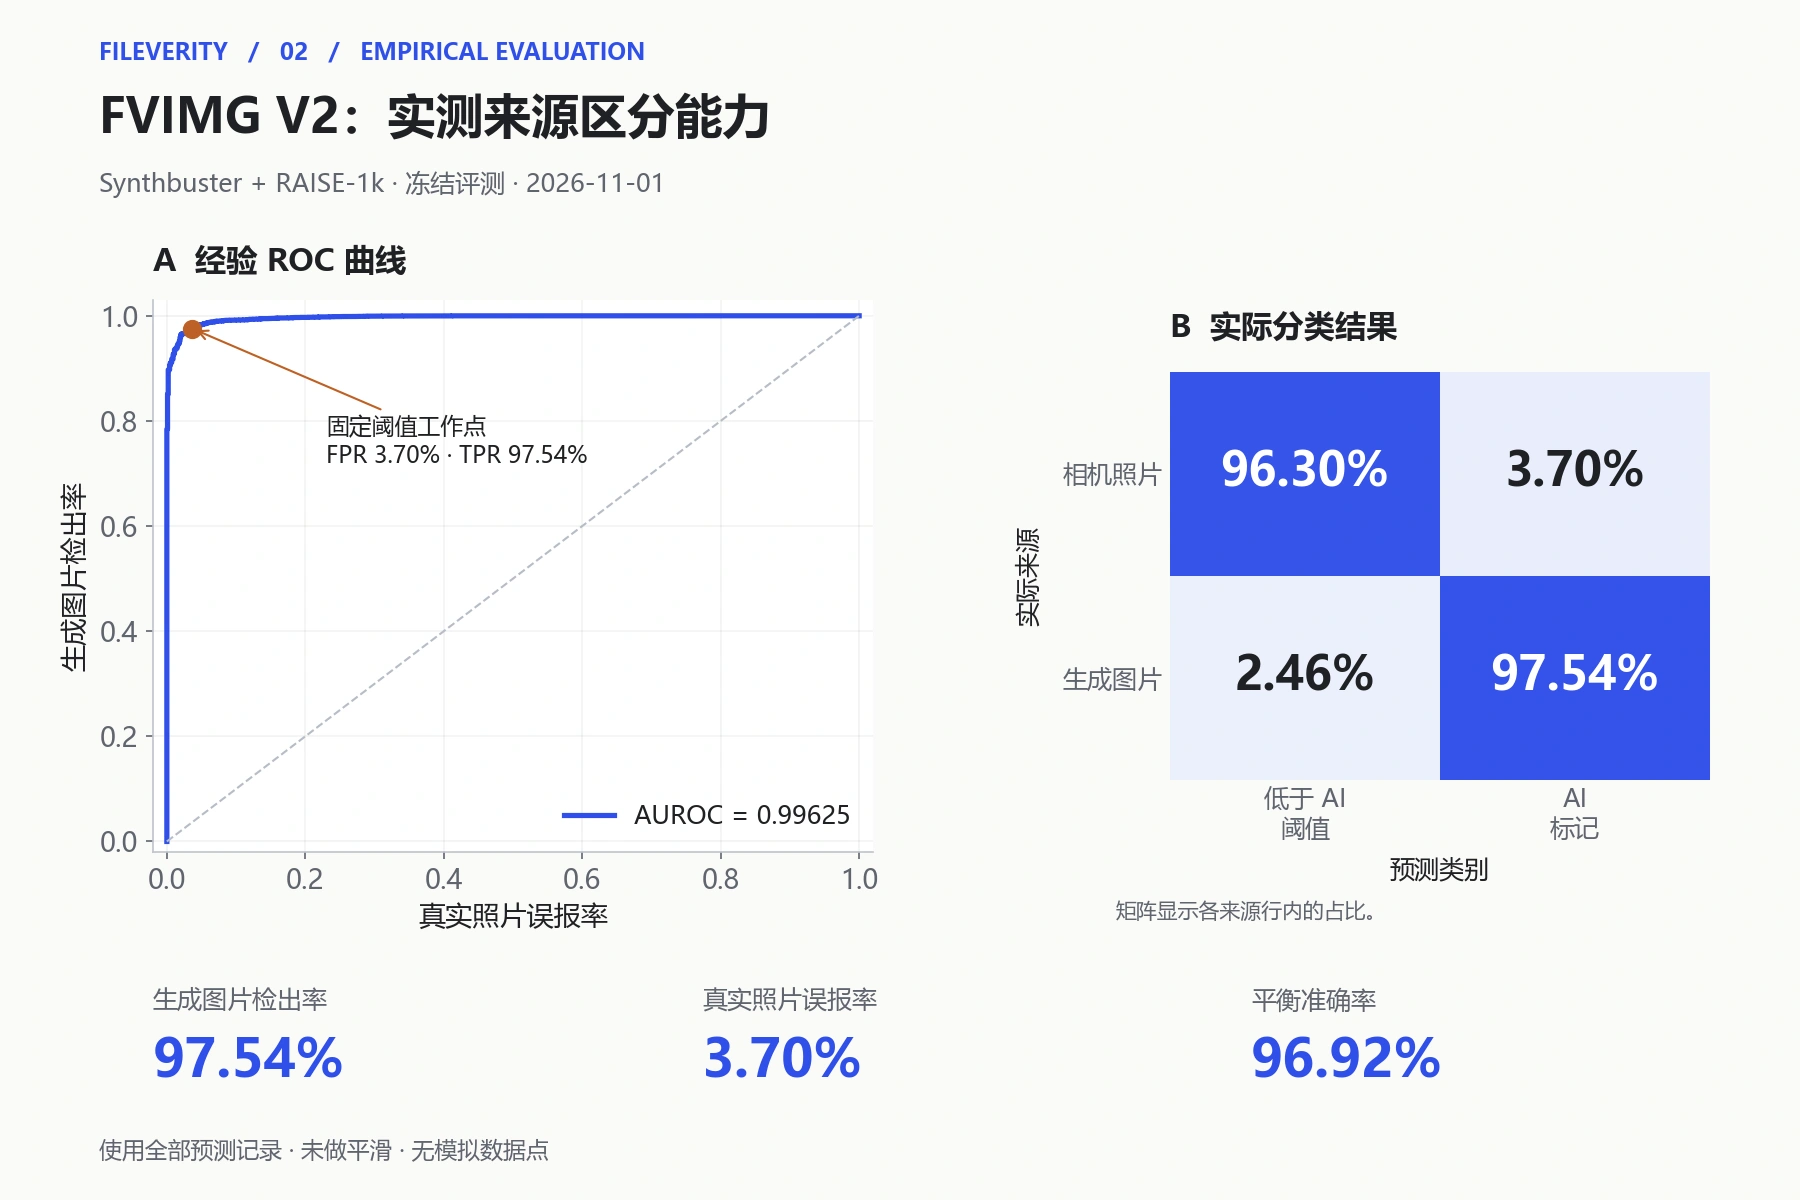
实测 ROC 由逐图分数直接计算,标记点对应评测中的固定阈值。矩阵中的百分比是各来源行内的占比。未使用平滑曲线或模拟样本。
| 评价项目 | FVIMG V2 实测结果 |
|---|---|
| AI 图片检出率 | 97.54% |
| 真实照片特异度 | 96.30% |
| 真实照片误报率 | 3.70% |
| 平衡准确率 | 96.92% |
| AUROC | 0.99625 |
ROC 展示分数在不同阈值下区分来源的表现;它不意味着任意单张文件的分数都可以直接解释为真实性概率。
完整 Synthbuster 报告公开了输入处理与评测范围。主成绩来自图片像素检测核心,没有将元数据或来源凭证叠加进去,也没有将 LLM 作为同场比较对象。这些数字支持的是一个具体版本在明确测试任务上的能力。
多重技术的价值,仍然取决于有没有新增信息
假设已经观察到 E1,再加入 E2:如果 E2 只是把 E1 换一种说法,就没有新增观测;如果 E2 提供了此前没有的信息,才有机会进一步区分来源。
这就是多重核验与“多问几个模型”的根本区别。不同检查也可能重复犯错,组件越多并不必然越准确。真正需要验证的是:组合后的系统是否在代表性样本上改善了判断,而不是它能否生成更长的解释。
Fileverity 的图片取证与真实性检测遵循这种以证据为中心的思路。FVIMG V2 与文档检测模型 FVDOC V3 分别具有明确的版本和评价范围。具体特征与组合方式属于内部实现;面向客户展示的是可以检查的结果,以及与任务、版本对应的性能证据。
企业应该关注什么,而不是只看解释是否专业
选择检测工具时,可以把问题改成:它的来源判断依据是什么?在哪些文件上验证过?固定阈值对应多少检出与误报?结果能否帮助团队定位下一步需要核查的材料?
检测准确率与误报指南进一步解释这些指标。对 Fileverity 而言,专业能力体现在完整检测流程中:让来源相关信息进入检查,形成定义清楚的结果,再用实际数据验证它的表现。理解内容是一个能力;建立来源判断的依据,是另一个需要专门完成的任务。如果您打算把检测器接入自己的系统,如何选择 AI 检测 API列出了十项集成评估项。
作者 Yang Zheng