检测评估
AI 文本水印现状(2026 年 11 月):ChatGPT、Claude、Gemini、Grok、DeepSeek 谁加了水印,谁能查
ChatGPT、Claude、Gemini、Grok、DeepSeek 的文字有水印吗?逐家列出 2026 年 11 月的水印状况、谁能验证、能证明什么,以及没有密钥时还能怎么查。
发布于 · 更新于 · 13 分钟阅读
本页内容
截至 2026 年 11 月 10 日,主流 AI 厂商对文字的态度并不一致:Anthropic 的 Claude 在全球范围内给文字加水印,OpenAI 的 ChatGPT 只在欧盟加,Google 的 Gemini 文字带 SynthID 水印,xAI 的 Grok 在 API 里默认不加,DeepSeek、Qwen 和 GLM 没有公开可验证的文本水印。更关键的是,五家都没有向公众开放文本水印检测器:想核对一段文字有没有水印,只有厂商自己和少数获批机构做得到。
所以“这段文字有没有水印”大多数时候查不出结果,也不能直接当成“是不是 AI 写的”的答案。本文逐家列出各厂商的做法、检测权限和限制,讲清统计水印怎么工作、能证明什么、不能证明什么,最后说明在没有密钥的情况下,只看写作风格的检测还能做什么。本文所有事实均注明日期,厂商的政策变化很快,请以各家页面为准。
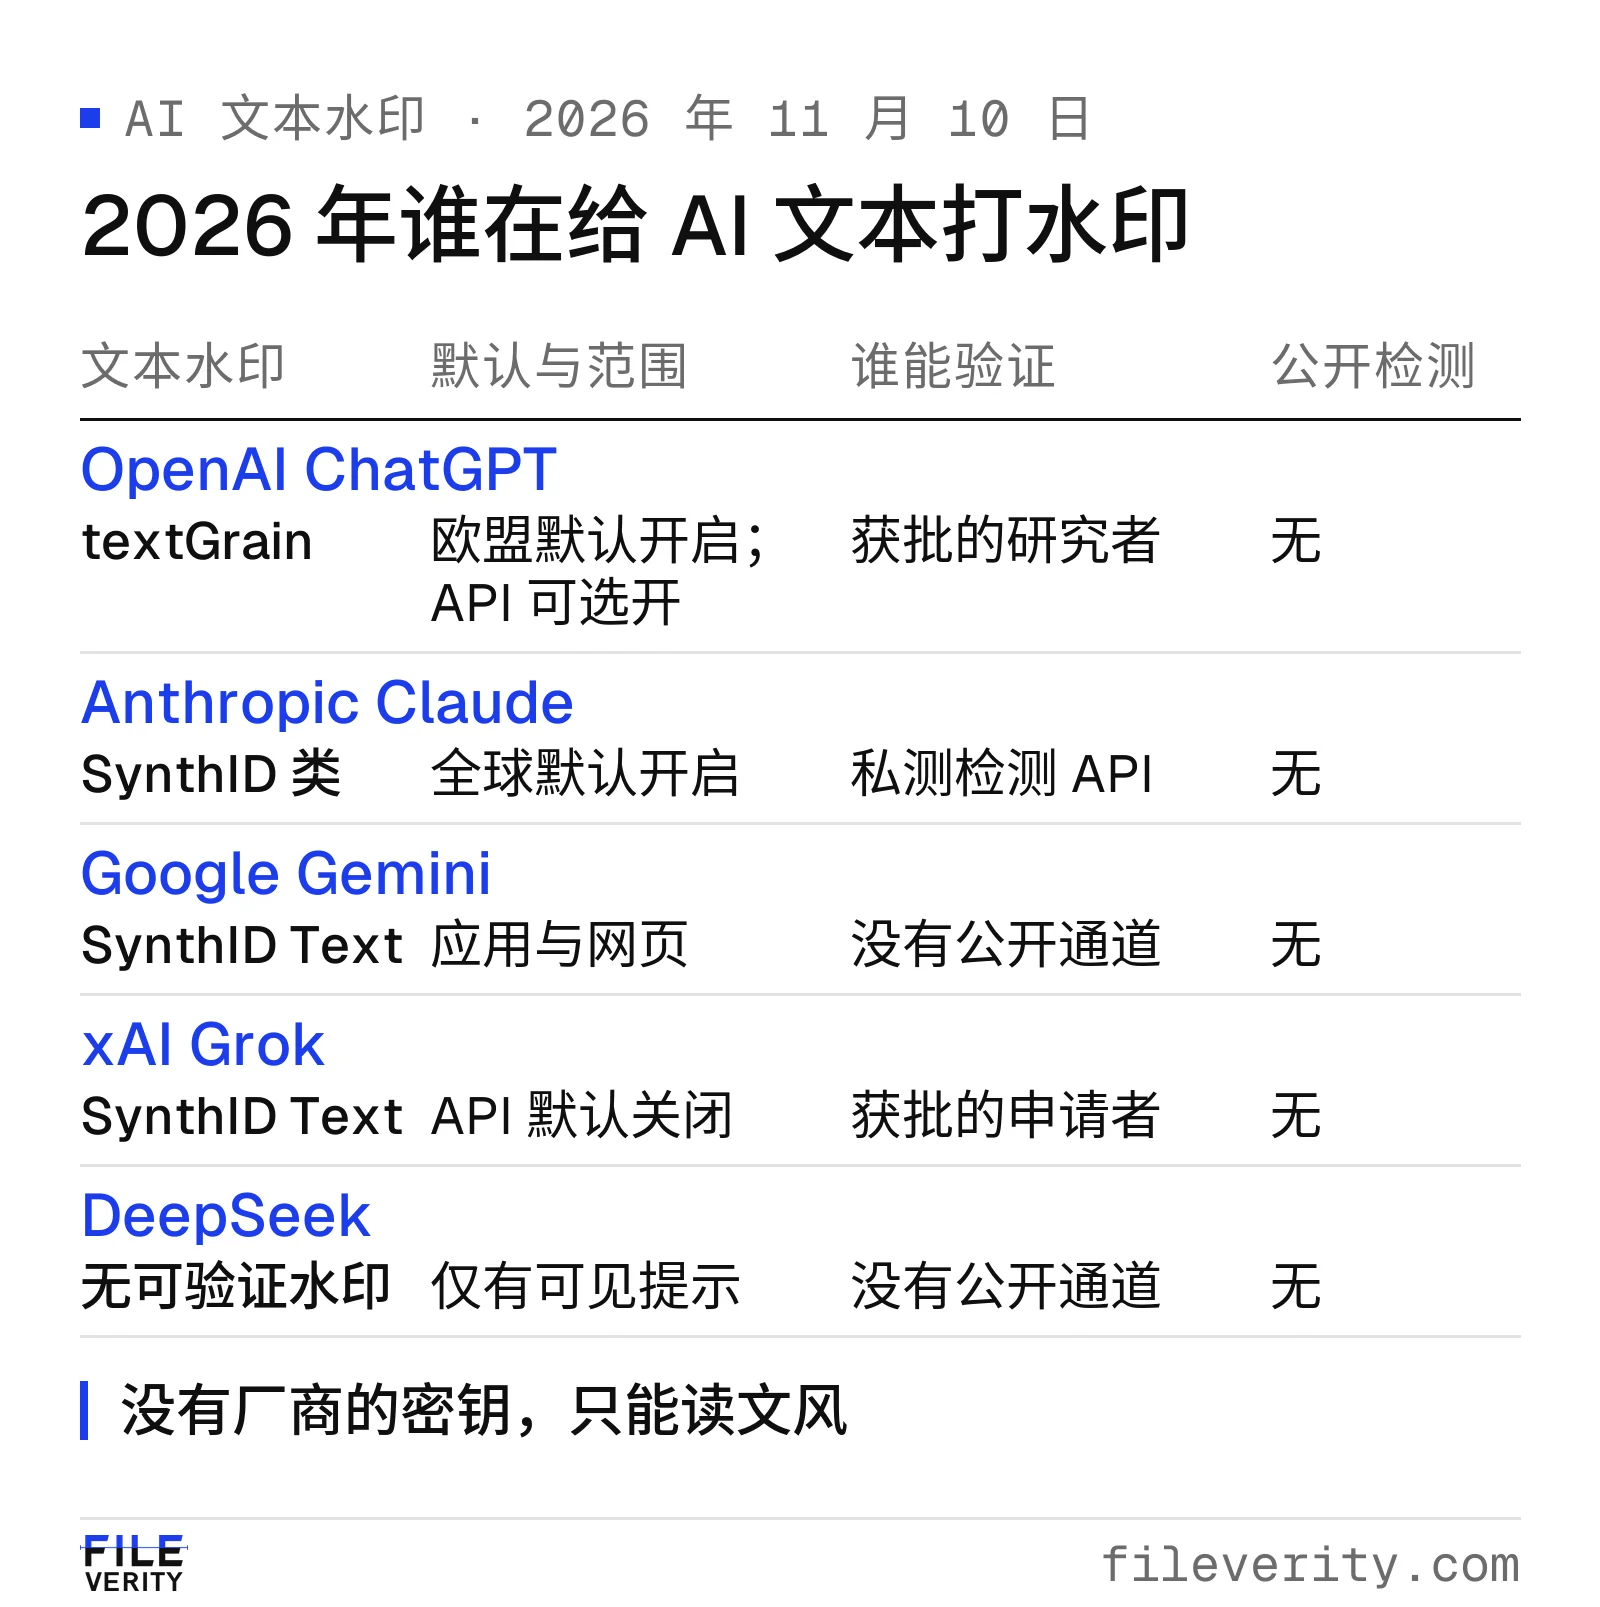
上表是 2026 年 11 月 10 日的状况:五家都没有公开的文本检测器,没有厂商的密钥,只能读文风。
先看结论:谁在给 AI 文字加水印
上面的对照图按四列整理:用了什么水印,默认开启范围,谁能验证,公众有没有检测入口。最后一列五家都是“无”。下面逐家说明依据。
水印是厂商在生成文字时嵌入的统计信号,与文末那句“本内容由 AI 生成”的可见提示是两回事。可见提示一眼能看到,也能被删掉;统计水印看不出来,只有持密钥的检测器才能读出。本文谈的是后者,也会说明可见标识的情况。
OpenAI:textGrain,仅限欧盟的 ChatGPT 与 Codex
OpenAI 在 2026 年 10 月 5 日宣布了 textGrain,这是写进选词里的一种不可见统计信号。OpenAI 说明,它会在“未来几周内”加到欧盟地区所有套餐的 ChatGPT 和 Codex 文本里,并明确表示不会在发布时把文本水印设为全球默认。API 客户在全球范围内可以对部分模型自行开启,默认关闭。截至 2026 年 11 月 10 日,OpenAI 的帮助文章写明,欧盟的 ChatGPT 文本带水印,是为了符合欧盟《人工智能法案》和欧盟《AI 生成内容透明度实践准则》;官方没有公布具体的欧盟启用日期,欧盟以外的 ChatGPT 文本不带水印。
谁能验证:文本检测器不公开。OpenAI 逐案批准申请,目前面向获批的研究者和专业机构,研究水印与检测可靠性才属于范围,商业反欺诈、转售以及检查学生作业不在项目范围内。OpenAI 自己披露的稳健性数据也显示,文本越短、改写越多,检出率越低:把一部分词换成同义词,检出率就会明显下降。OpenAI 还写明,没有检出水印“并不证明是人写的”。
想了解欧盟之外的 ChatGPT 文字该怎么查,可以看 ChatGPTDetect 的水印页面,它按同样的事实说明了 ChatGPT 文本的水印现状与替代的检测方式。
Anthropic:Claude 的水印全球生效,检测 API 仍在私测
Anthropic 在 2026 年 8 月 14 日发布了《Claude 的文本水印如何运作》,说明它采用 Google DeepMind 2024 年在《自然》(Nature)发表的 SynthID-Text 思路的一个版本,文字里不增加任何内容:没有隐藏字符,也没有额外的 token。Anthropic 于 2026 年 7 月签署了欧盟《AI 生成内容透明度实践准则》,水印在全球范围内启用,没有按地区划分。支持文章列出的覆盖范围包括 Fable 5.2、Opus 5.5、Sonnet 5.5、Haiku 5.5 等当前模型,也包括 Opus 4.5 至 4.8、Sonnet 4.5 与 4.6 和 Haiku 4.5 等较早的模型;2026 年 8 月 2 日及之后发布的模型从上线起就带水印。
谁能验证:检测 API 处于私有预览,对监管机构、执法部门、媒体、事实核查机构、独立研究者、教育机构和欧盟公民社会组织等合格机构开放,也对需要检查自己 Claude 输出的企业开放。个人无法自行检查。Anthropic 说明,水印检测对短文本效果差,对事实性段落和代码的信号更稀疏,轻度校对可能留不下足够信号;整篇重写会去掉水印,轻度修改大概率不会,Claude 的翻译也带水印。Anthropic 还指出,水印无法区分“Claude 写的”和“Claude 大幅修改过的”。
ClaudeDetect 的水印页面按问答的形式梳理了哪些 Claude 模型带水印、谁能查验,以及没有密钥时如何判断。
Google:Gemini 文字带 SynthID,公开的 SynthID Detector 不查文字
Google 在 2024 年 5 月 14 日宣布,Gemini 应用和网页生成的文字会加上 SynthID 水印,并说明这种水印对事实性问题的回答效果较差,经大幅改写或翻译后置信度会大幅降低。SynthID Text 是开源的,检测是概率性的,结果分为有水印、无水印和不确定三种;检测器可以完全私有、通过 API 半私有,或者公开,由模型的所有者决定。Google 的文档说明,水印对裁剪、改几个词和轻度意译有一定稳健性,但不是为了对付有意绕过的人而设计,最好与其他方法配合。
谁能验证:这里最容易混淆。2026 年 10 月 7 日,Google 把 SynthID Detector 向所有人开放,用来检查图片、视频或音频是否由 Google 或其合作伙伴的 AI 生成,文字没有出现在公布的范围里;Gemini 应用的验证同样只覆盖图片、视频和音频,并且只能识别 Google AI 工具生成的内容。2025 年的公告曾把文字列为计划范围,但 2026 年的说明里没有。截至本文日期,我们在 Google 的页面上没有找到第三方可以验证 Gemini 文字的公开工具或 API。
GeminiDetect 的水印页面专门回答“SynthID 能不能检测 Gemini 写的文字”,可以对照阅读。
xAI:Grok 的 API 文本水印默认关闭,按模型开启
xAI 官方文档(2026 年 11 月 9 日更新)写明:Responses 和 Chat Completions API 返回的文本可以加水印,覆盖纯文本、结构化输出和工具调用参数,团队管理员在控制台里按模型开启,默认关闭,设置对团队下所有 API 密钥生效,改动写入团队审计日志。采用的技术同样是 Google DeepMind 在 2024 年《自然》论文里发表的 SynthID Text,文档称它不改变质量,对速度影响可忽略。响应头 x-watermark: true 表示该次请求的输出已加水印。
早先有报道称水印会从 11 月 7 日起默认开启,但官方页面并没有这样写,我们以官方页面为准。官方页面只讲 API,没有提到 Grok 应用或 X,因此应用里的文字没有可依据的水印说明。
谁能验证:检测是统计性的,结果为有水印、无水印或不确定,文本越长信号越强;水印检测权限需要申请,我们没有找到公开的检测器,也不知道批准标准。关闭了水印的团队、应用中的文字和较早的模型,本来就没有水印可查。
GrokDetect 的水印页面说明了这些限制对检测意味着什么。
DeepSeek、Qwen 和 GLM:只有可见标识,没有可验证的文本水印
在国内,AI 生成内容的标识由《人工智能生成合成内容标识办法》规范,自 2025 年 9 月 1 日起施行,要求服务提供者对用户可见的内容加显式标识,并在文件元数据中加隐式标识,配套的强制性国家标准是 GB 45438-2025。具体的读取方法和边界,见隐式标识、内容凭证与水印:核查 AI 生成图片该用哪种方法。
DeepSeek 的使用条款(页面日期 2025 年 9 月 5 日)写明平台内已加上提醒用户内容由 AI 生成的显式标识,并禁止删除、篡改、伪造、隐匿或规避这些标识;它的模型原理披露说明,会在欢迎页、生成文本末尾和界面底部提示内容由 AI 生成、可能不准确。我们没有找到 DeepSeek 官方描述隐藏的统计文本水印、纯文本元数据标识或公开验证工具的材料;这只说明没有公开可查的工具,不等于一定不存在。关于元数据标识,还有一点来自文件格式本身:纯文本复制粘贴会丢掉文件元数据,所以元数据里的隐式标识不会跟着粘贴的文字走。Qwen 和 GLM 的官方文档里,我们同样没有找到关于文本水印的说明。
对用户来说,结论很直接:这三个系列的文字,可见提示一删就没有,也没有公开可验证的隐藏水印,能依靠的只有文风。DeepSeekDetect 的水印页面按“DeepSeek 有水印吗”的问法整理了现状。
欧盟《人工智能法案》第 50 条为什么推动了这件事
几家厂商都提到了欧盟:Anthropic 说明水印是为符合《人工智能法案》而加,并已签署《AI 生成内容透明度实践准则》;OpenAI 说明欧盟的 ChatGPT 文本带水印,是为符合法案与准则;xAI 说明水印有助于满足法案要求。法案第 50 条要求生成式 AI 系统的提供者,把输出以机器可读的方式标记出来,使其可被识别为人工生成或操纵。统计水印是满足这项要求的一种技术做法。
这解释了为什么不同厂商的开启范围不同:OpenAI 先在欧盟启用,Anthropic 一步到位全球启用,xAI 把选择交给 API 团队,并要求关闭水印的团队确认适用例外并自行负责披露。各家公开材料的适用日期说法不一,本文不引用日期,请以欧盟官方文件为准。
统计水印是怎么工作的
文本水印不往文字里加东西。它发生在模型挑选下一个词的那一步:
- 厂商用一把秘密密钥,加上前面的几个词,为下一个可能出现的词各自算出一个分数。
- 模型选词时,略微偏向分数高的词,对文字质量影响很小。
- 写出来的文字读起来完全正常,没有隐藏字符,也没有任何东西被附加进去。
- 持有同一把密钥的检测器,把同样的分数在这段文字上重新计算一遍,看高分词是否多得反常。
- 结果是一个可能性,分为有水印、无水印或不确定,不是裁决。
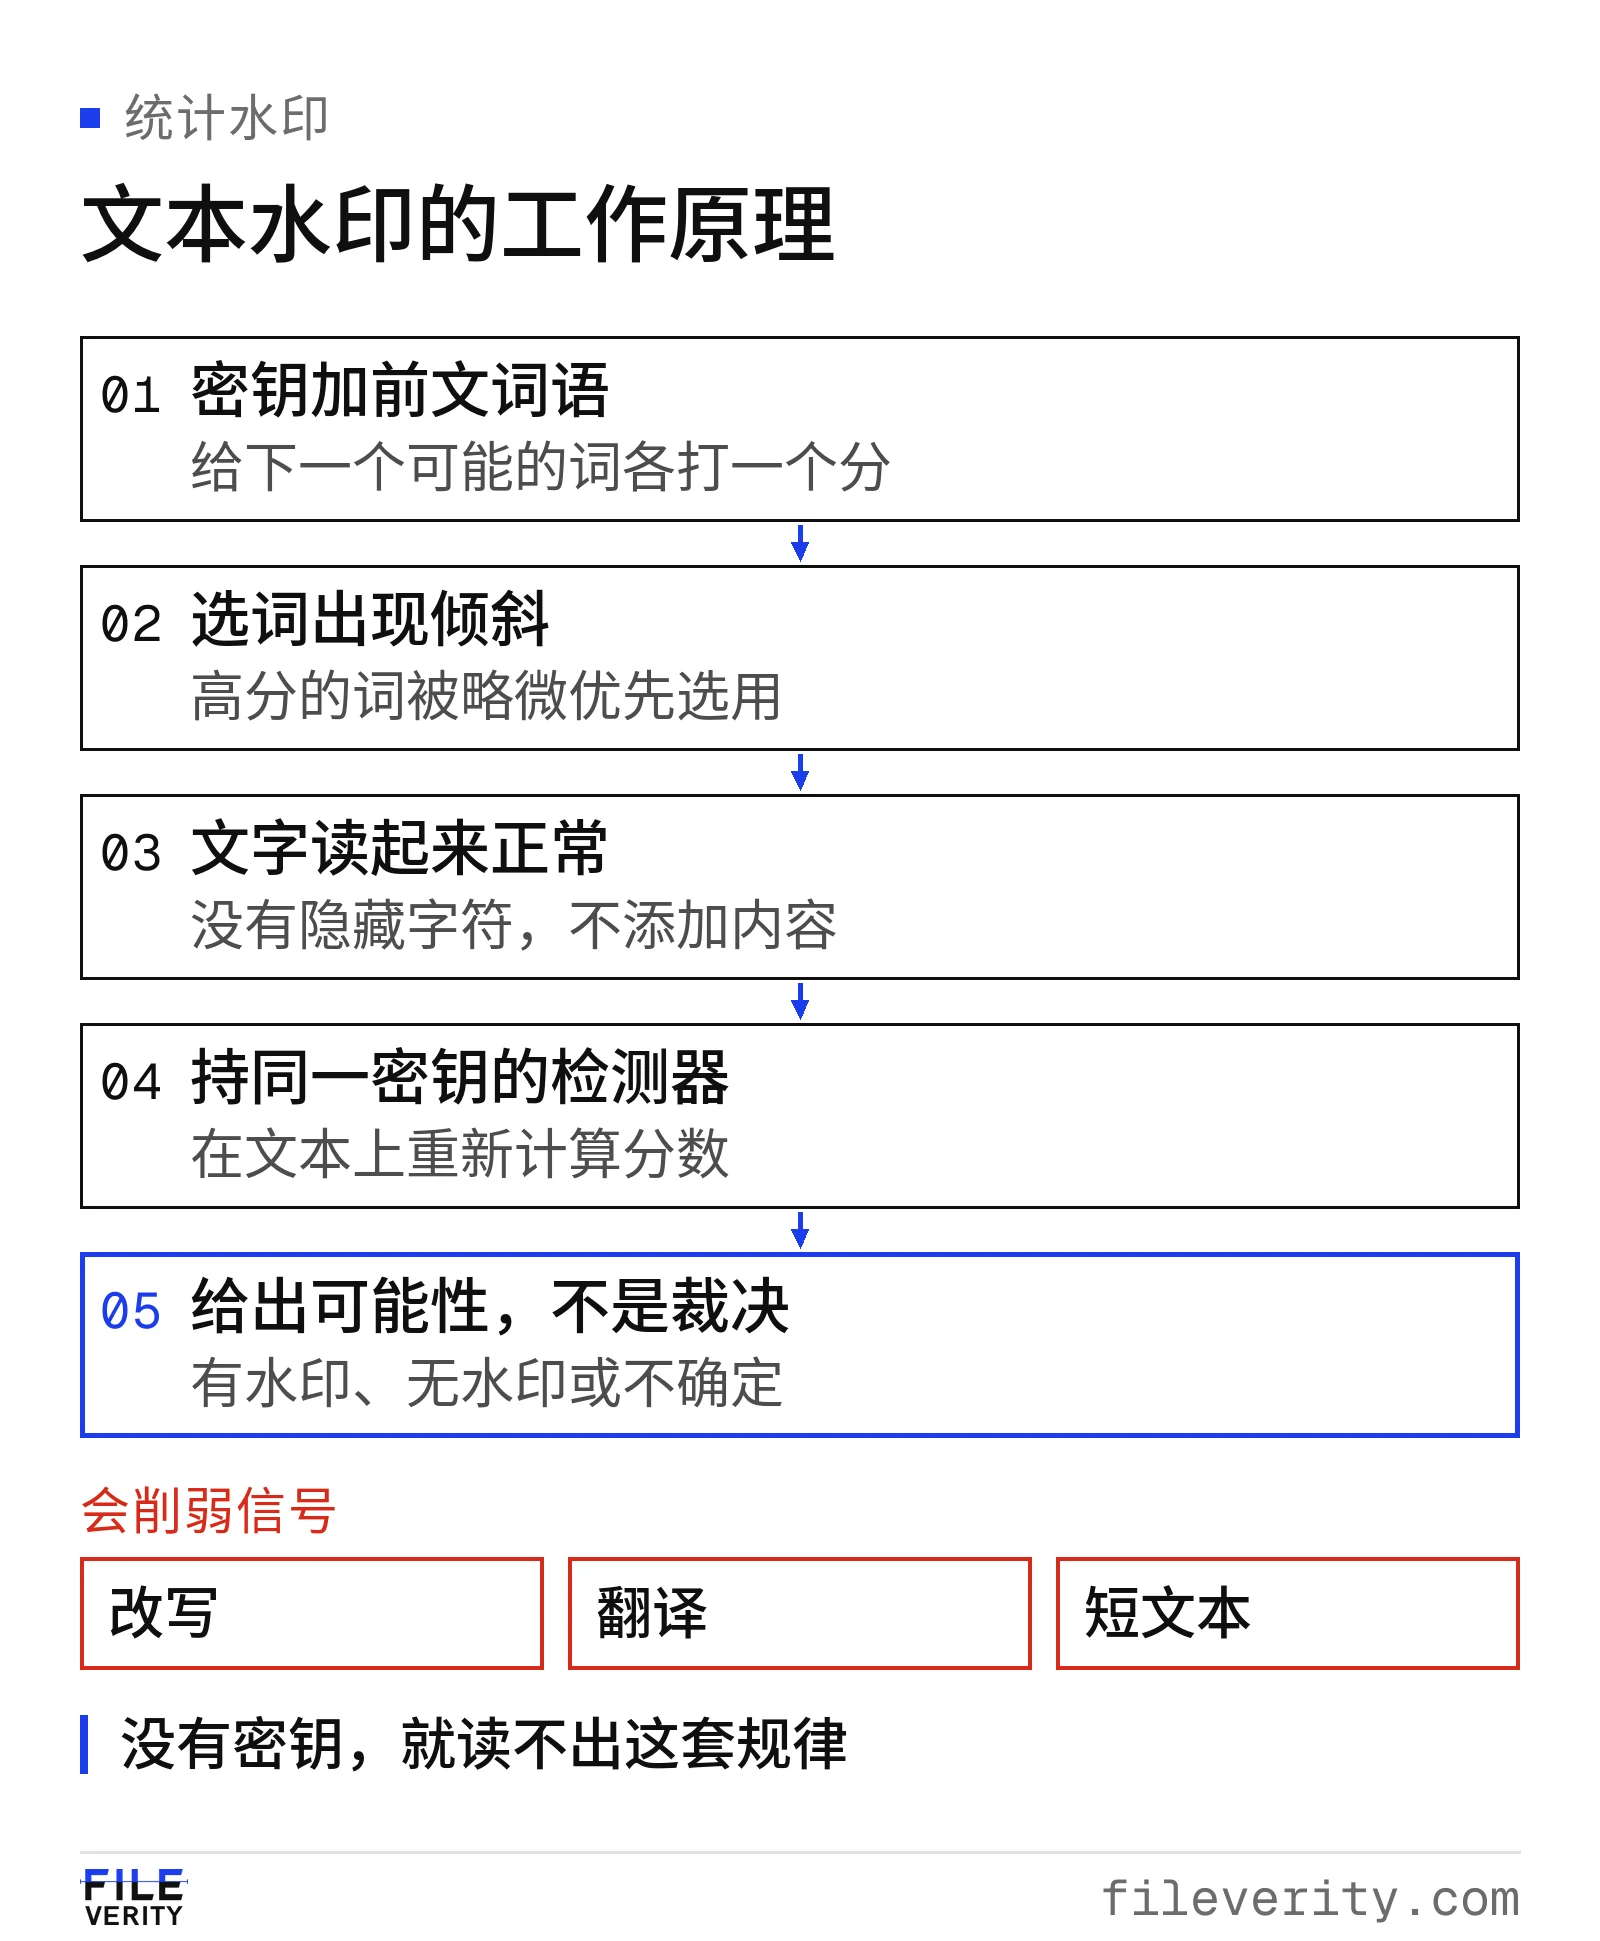
没有密钥,就读不出这套规律:水印只存在于词的选择里,看文字本身看不到。
这个机制决定了水印的能力边界。信号靠的是许多词的累积,所以文本越长越强;改写和翻译会替换词语,信号被稀释;短文本和事实性很强的文字,可选的词本来就少,倾斜的空间小,几乎留不下信号。同时,只有拿着密钥的一方才能检测,公众拿到文字也无从下手。
水印能证明什么,不能证明什么
检出水印,说明这段文字很可能经过了该厂商的模型处理。Anthropic 自己的表述是,这是“一种信号”,并不完全确定,Claude 可能并不是原作者,校对、翻译或摘要都会留下痕迹。它不能证明谁提交了文字,不能证明有多少是人写的,也不能衡量内容是否准确。
没有检出水印,并不等于是人写的:文字可能来自没有加水印的模型、在没有开启水印的地区或接口生成,也可能被改写、翻译或缩短到水印失效。OpenAI 在说明里也写明,没有检出水印不证明是人写的。把“没有水印”当成“没用过 AI”,是最常见的误读,也是对学生或员工作出误判的主要来源。
所以水印更适合回答厂商和监管机构的问题:这家的模型有没有生成过这段文字?它回答不了学校、编辑部或审核团队最关心的那个问题:这段文字是不是 AI 写的,不论来自哪个模型。
公众唯一能用的检查:读写作风格
五家厂商的水印检测都没有对公众开放,而且五家的覆盖范围、开启默认值和适用模型各不相同,水印无法给出统一的答案。公众能用的,是不需要密钥的检测:读文字本身的写法,判断它是否像 AI 撰写,以及与哪个模型系列的写作风格相近。这类检测不依赖厂商配合,对没有水印的文字同样有效,代价是它给出的是可能性,不是密钥级别的证明。
Fileverity 的 AI文本检测由 Veread 驱动,不读取任何厂商的水印,只读写作风格,并标出哪些段落最像 AI 撰写。在我们的评测中,Veread 1.1 对整篇 AI 撰写文本的检出率为 98.6%,对开发中从未使用过的模型所写的文本检出率为 94.9%,七种语言上人工撰写文本被误判的比例为 0.28%,完整成绩见准确率页面。各系列具体有哪些用词和标点习惯,见怎么判断是哪个 AI 写的。
实际操作:拿到一段可疑文字时怎么办
- 先别只靠水印。除非对方明确说明用的是哪家模型、哪个版本、在什么地区,否则没有水印什么也说明不了。
- 保留原始文件和提交记录。水印和可见标识都可能在复制、转存、截图和编辑中丢失,记录来源比事后猜测可靠。
- 做风格检测,并看标出的段落。把结果当作人工复核的线索,不单凭它对个人下结论。文字在网页或 Google 文档里时,可以用Fileverity Chrome 插件直接检测。
- 需要证明是某家模型生成的,且你是监管机构、研究者或有合规义务的企业,可以按各厂商的流程申请检测权限:OpenAI 逐案批准,Anthropic 通过私测申请表登记,xAI 通过申请表。
关于文本水印的常见问题
ChatGPT、Claude、Gemini、Grok、DeepSeek 哪些带水印?
截至 2026 年 11 月 10 日:Claude 全球带水印;ChatGPT 的文字只在欧盟带水印,API 客户可自行开启;Gemini 应用和网页的文字带 SynthID 水印;Grok 的 API 水印默认关闭,团队管理员按模型开启;DeepSeek、Qwen 和 GLM 没有公开可验证的文本水印,只有可见的 AI 生成提示。
我能自己检查一段文字有没有水印吗?
不能。五家的文本水印检测都不对公众开放,需要持有厂商的密钥或获批的检测权限。Google 的 SynthID Detector 向所有人开放,但只检查图片、视频和音频,不检查文字。
删掉“由 AI 生成”的提示,文字就没有标识了吗?
可见提示确实可以删掉,这也是它不能当证据的原因。统计水印不在可见的文字里,删提示不影响它,但整篇重写、翻译或大量改词会削弱它。
水印会误判吗?
统计水印检测给出的是概率,有误报也有漏报,改写和翻译会让它漏掉。Anthropic 说明水印不能区分“Claude 写的”和“Claude 大幅修改过的”,OpenAI 说明没有检出不证明是人写的。
Fileverity 能读出 AI 文字里的水印吗?
不能。AI文本检测不读取也不验证任何厂商的水印,它读的是写作风格,给出文本由 AI 撰写的可能性,并标出最可疑的段落。
为什么不同厂商的做法差别这么大?
欧盟法规要求对生成内容做机器可读的标记:OpenAI 先在欧盟的 ChatGPT 与 Codex 启用,Anthropic 全球启用,xAI 交给 API 团队选择;检测器给谁用,也由各家自己决定。国内则以《人工智能生成合成内容标识办法》规定的显式和隐式标识为主。
作者 Yang Zheng