检测评估
怎么判断是哪个 AI 写的:ChatGPT、Claude、Gemini、Grok、DeepSeek、Qwen、GLM 的中文写作特征
七个 AI 模型系列的中文用词、标点和句式特征,附比人类作者多出的倍数、数据的得来方式,以及为什么这些特征只是信号而不是证据。
发布于 · 更新于 · 10 分钟阅读
本页内容
各个 AI 模型系列的中文文字确实有各自的习惯:同样的题目,Claude、ChatGPT、Gemini 写出来的用词、标点和句式并不一样,与人类作者的写法更是不同。我们把每个系列整篇生成的中文文字与同类的人类文字对比,找出稳定出现的差异,包括 OpenAI、Anthropic、Google、xAI、DeepSeek、阿里巴巴(Qwen)和智谱(GLM)七个系列。这些差异能帮你缩小怀疑范围,但它只是信号,不是证据:人也会用这些词,换一个提示词,模型的风格就会变。
本文先用两张图给出全貌:各系列最突出的用词,以及标点与句式的差异;再逐个系列说明;最后讲清统计方法、使用时的注意事项,以及 Veread 为什么读的远不止词语清单。所有倍数都是相对人类作者的频率之比,数据截至 2026 年 11 月 10 日。
先看全貌:各系列最突出的用词
下图为每个系列挑出两个读起来是正常词语、读者也能在文字里搜到的词,并标出它比人类作者多出现的倍数。比如 DeepSeek 的“后续”出现的频率是人类作者的 18 倍,Qwen 的“并非”是 14 倍,ChatGPT 的“日常”是 10 倍。
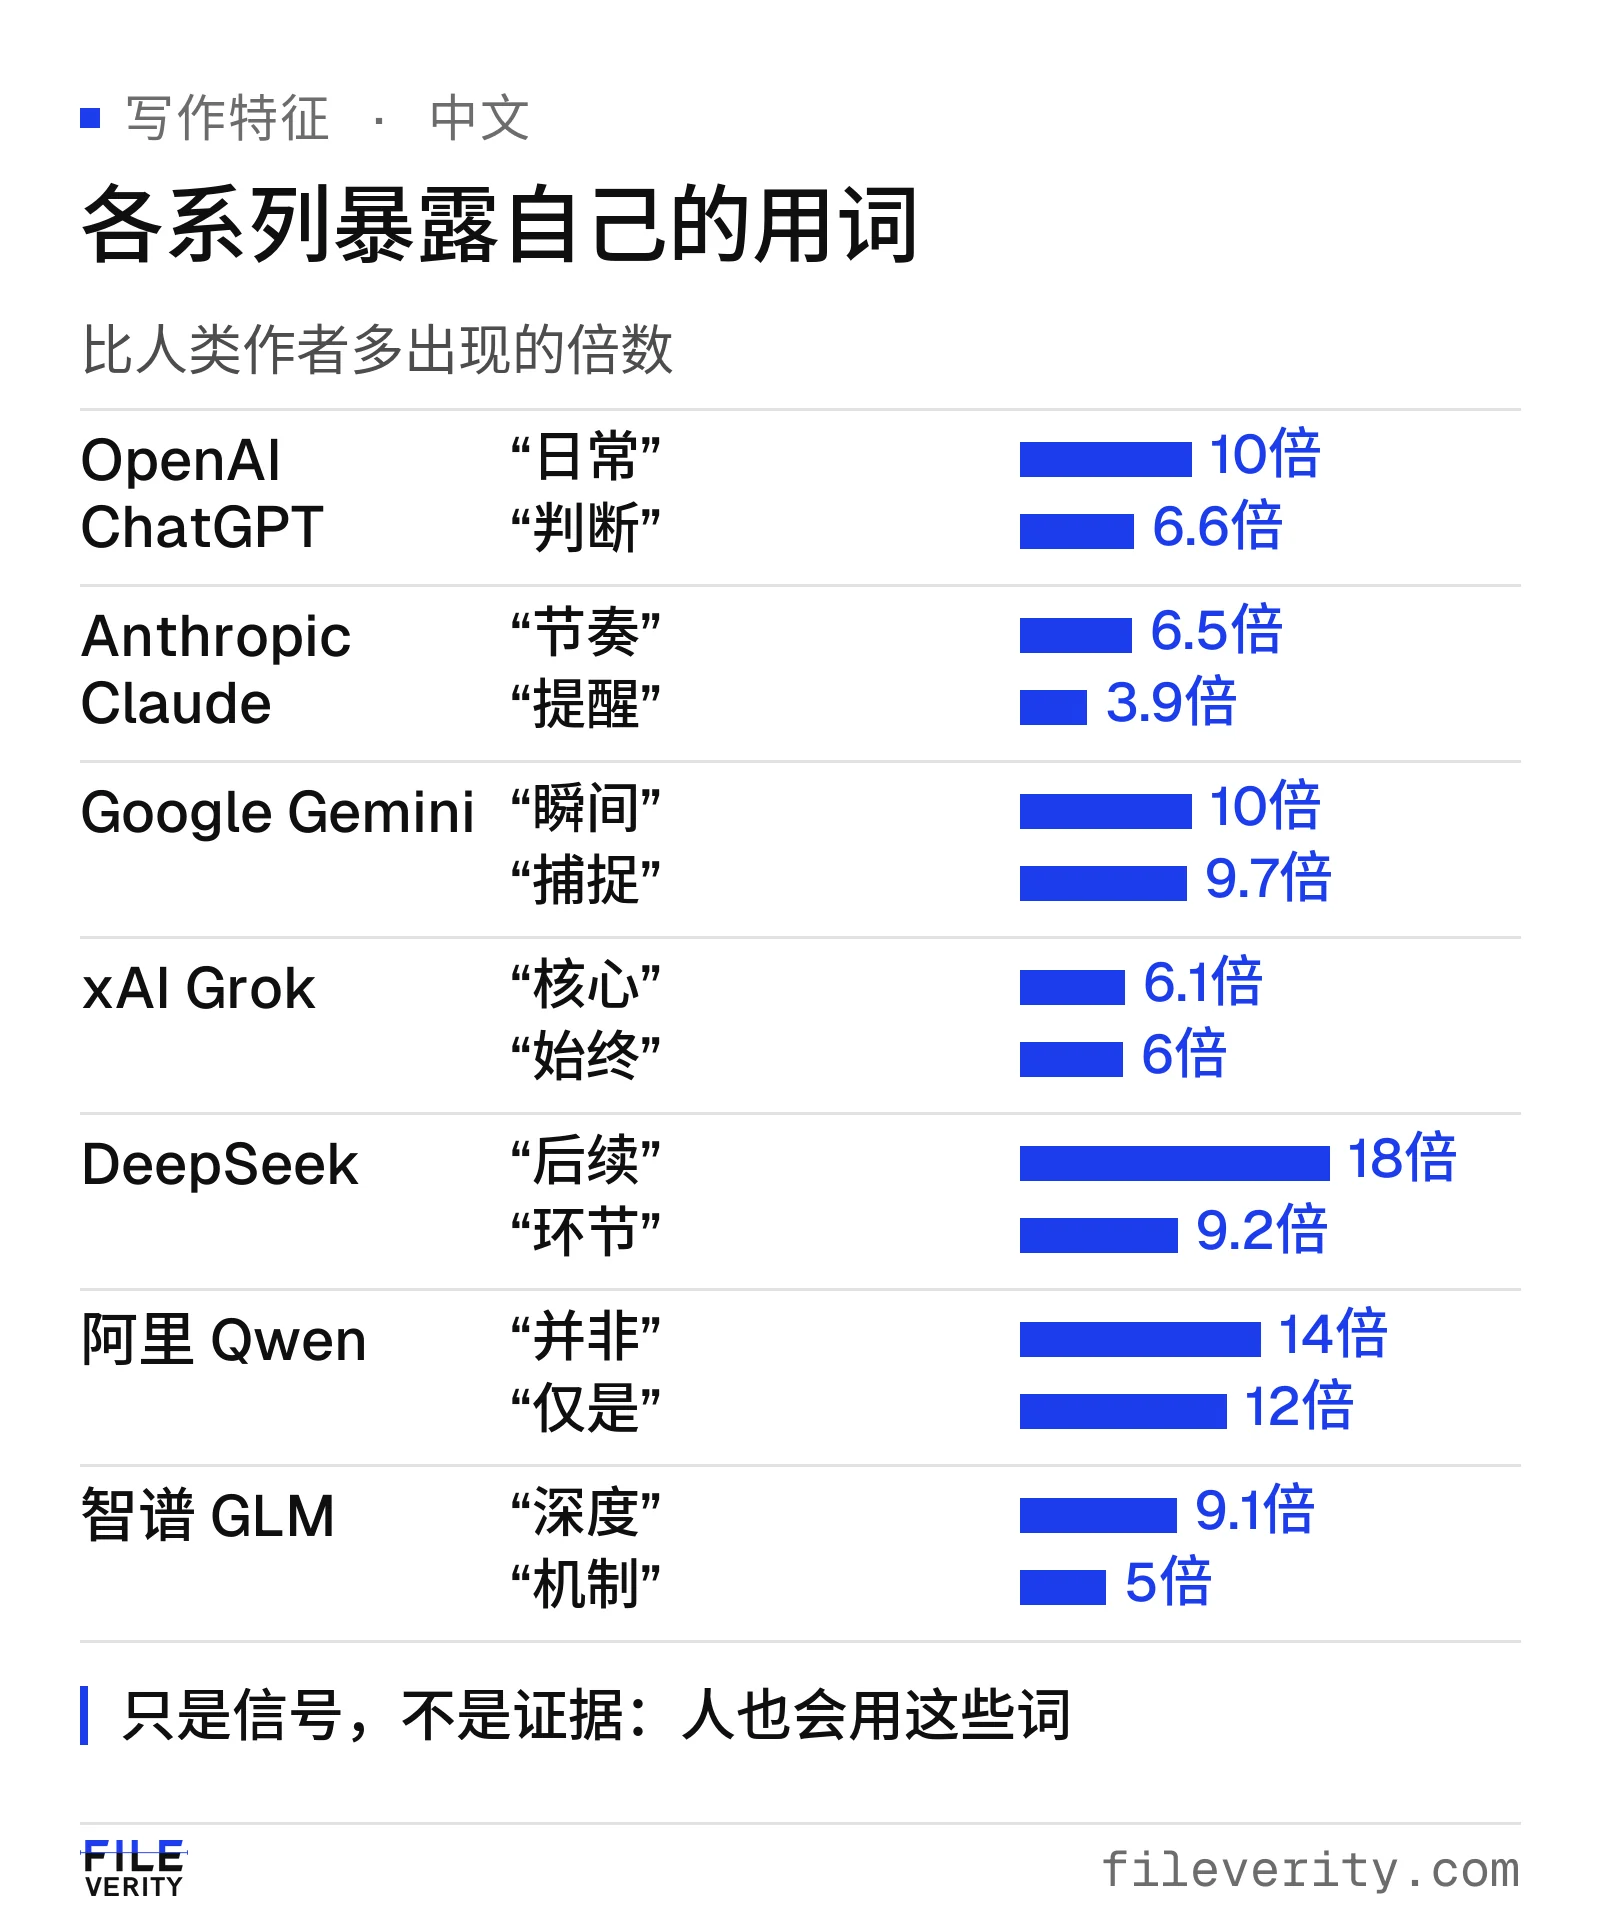
每个系列都有一些人类很少用得这么频繁的词,但它们只是信号:人也会用这些词,单个词不能作证据。
图里所有的柱子共用同一个刻度,所以像 18 倍这样的大值会让其他的显得短,这是正常的。倍数大不代表词多:一个词本来就罕见,多出几倍也不过是偶尔出现。
ChatGPT(OpenAI):“日常”“判断”“安排”
OpenAI 系的中文最突出的词是“日常”(10 倍)、“往往”(7.3 倍)和“判断”(6.6 倍),“安排”(5.4 倍)、“明确”(4.9 倍)、“而是”(4.5 倍)也很常见。与其他 AI 系列相比,它更常用“能否”(3.4 倍)、“条件”(2.6 倍)、“并不”(2.3 倍)和“是否”(2 倍)这类设问和限定的词。
结构上,它爱用“不是……而是……”的对比句,频率是人类的 4 倍;感叹号少得多(少 3.4 倍),括号也少(少 2.6 倍)。平均句长约 37 个字,人类约 59 个字,句子长短也更整齐。
想看这些特征如何用在检查 ChatGPT 文字上,可以看 ChatGPTDetect 的判断方法页面。
Claude(Anthropic):“节奏”“并非”“提醒”
Claude 的中文用词更偏描述和提醒:“往往”(6.7 倍)、“节奏”(6.5 倍)、“并非”(4.7 倍)、“真正”(4.1 倍)、“在于”和“提醒”(均 3.9 倍)。与其他 AI 系列相比,它更常用“所以”(2.8 倍)、“几乎”(2.5 倍)、“之后”(2.4 倍)和“几个”(2.4 倍),用词更口语化。
标点上,它最克制:省略号少 5.1 倍,感叹号少 3.8 倍,括号少 2.5 倍,问号也少 1.7 倍。我们没有找到它比人类明显更多的结构标记,“不是……而是……”在它那里反倒比其他 AI 系列更少。平均句长约 38 个字,人类约 53 个字。
ClaudeDetect 的判断方法页面整理了 Claude 的中文用语与文风特征。
Gemini(Google):“瞬间”“捕捉”“浓郁”
Gemini 偏爱画面感强的词:“瞬间”和“务必”(均 10 倍)、“捕捉”(9.7 倍)、“浓郁”(8.3 倍)、“极其”(7.2 倍)、“氛围”(4.9 倍)、“格外”(4.6 倍)。与其他 AI 系列相比,“极其”高出 5 倍,“捕捉”高出 3.6 倍,“顶级”高出 3.6 倍。
句式上,它写“不是……而是……”的频率是人类的 9.6 倍,是七个系列里最高的,与其他 AI 系列相比也高 2.3 倍。同时感叹号少 3.9 倍,括号少 2.7 倍,省略号少 2.4 倍。它的文字分段也少:约 60% 的文本分成了多个段落,人类约 81%。
GeminiDetect 的判断方法页面给出了 Gemini 的更多用词和使用上的注意事项。
Grok(xAI):“核心”“始终”“一定要”
Grok 的突出词是“而是”和“核心”(均 6.1 倍)、“真正”(5.2 倍)、“始终”(6 倍)、“迅速”(4.6 倍)。与其他 AI 系列相比,差别主要在口语化的词:“一定要”(4.2 倍)、“就会”(2.6 倍)、“一样”和“每次”(均 2.2 倍),整体读起来更像对读者说话。
标点上,感叹号少 4.3 倍,括号少 2.7 倍,省略号少 3.2 倍,冒号也少 2.1 倍;“不是……而是……”则是人类的 4 倍。平均句长约 36 个字,是七个系列里最短的,人类约 52 个字。
GrokDetect 的判断方法页面说明了如何看待这些特征。
DeepSeek:“后续”“环节”“节奏”
DeepSeek 的特征最集中:“后续”(18 倍)、“节奏”(11 倍)、“环节”(9.2 倍)、“往往”(9.1 倍)、“并非”(8.8 倍)、“而是”(6.8 倍)、“在于”(6.2 倍)。与其他 AI 系列相比,更突出的是口语化的词:“那个”(2.7 倍)、“东西”(2.6 倍)、“心里”(2.8 倍)、“而不是”(3.3 倍)。
标点上,它是七个系列里唯一明显多用破折号的:每千字 0.6 个,是人类的 3.5 倍,与其他 AI 系列相比高 3.2 倍;“不是……而是……”是人类的 3.9 倍;感叹号少 2.7 倍。约 51% 的文本分成多个段落,人类约 80%。
DeepSeekDetect 的判断方法页面同时覆盖 DeepSeek 在中文和英文里的差异。
Qwen(阿里巴巴):“并非”“仅是”“不仅”
Qwen 的用词最偏书面和说理:“并非”(14 倍)、“仅是”(12 倍)、“往往”(10 倍)、“核心”(9.8 倍)、“不仅”(8.3 倍)、“更是”(8.1 倍)、“而是”(8 倍)。与其他 AI 系列相比,“仅是”高出 2.3 倍,“并非”“尽管”“仅仅”“而言”等词都高出约 2.4 至 2.5 倍,递进、转折的连接词用得很多。
句式上,“不是……而是……”是人类的 9 倍,与其他 AI 系列相比也高 2.1 倍。感叹号少 4 倍,省略号少 2.9 倍,括号少 2.5 倍,问号少 2 倍。约 50% 的文本分成多个段落,人类约 76%。
Qwen(通义千问)和 GLM 没有单独的检测页面,DeepSeekDetect 的判断方法页面里有一节专门说明它们与 DeepSeek 的不同。
GLM(智谱):“深度”“环节”“机制”
GLM 的突出词包括“深度”(9.1 倍)、“往往”(8.7 倍)、“核心”(8.5 倍)、“日常”(8.2 倍)、“环节”(7.9 倍)、“并非”(6.5 倍)、“仅是”(6.1 倍)、“机制”(5 倍)。能把它与其他 AI 系列区分开的词不多,主要是“十分”(2.2 倍)、“深度”(2.2 倍)、“毫无”(2.7 倍)和“探讨”(2.7 倍),所以仅凭词语去分辨 GLM,区分度有限。
结构上,“不是……而是……”是人类的 4 倍,省略号少 2.7 倍,括号少 2.5 倍,平均句长约 39 个字,人类约 55 个字。
GLM 同样没有单独的检测页面,可参考 DeepSeekDetect 的判断方法页面里对 Qwen 和 GLM 的说明。
标点与句式:比词语更稳的线索
词语容易随主题变化,标点和句式的差异更稳定。下图列出七个系列在四个标记上相对人类写作的倍数:“不是……而是……”的对比句式、感叹号、括号和省略号,蓝色向上表示比人类多,黑色向下表示比人类少,灰色横线表示没有明显差异。
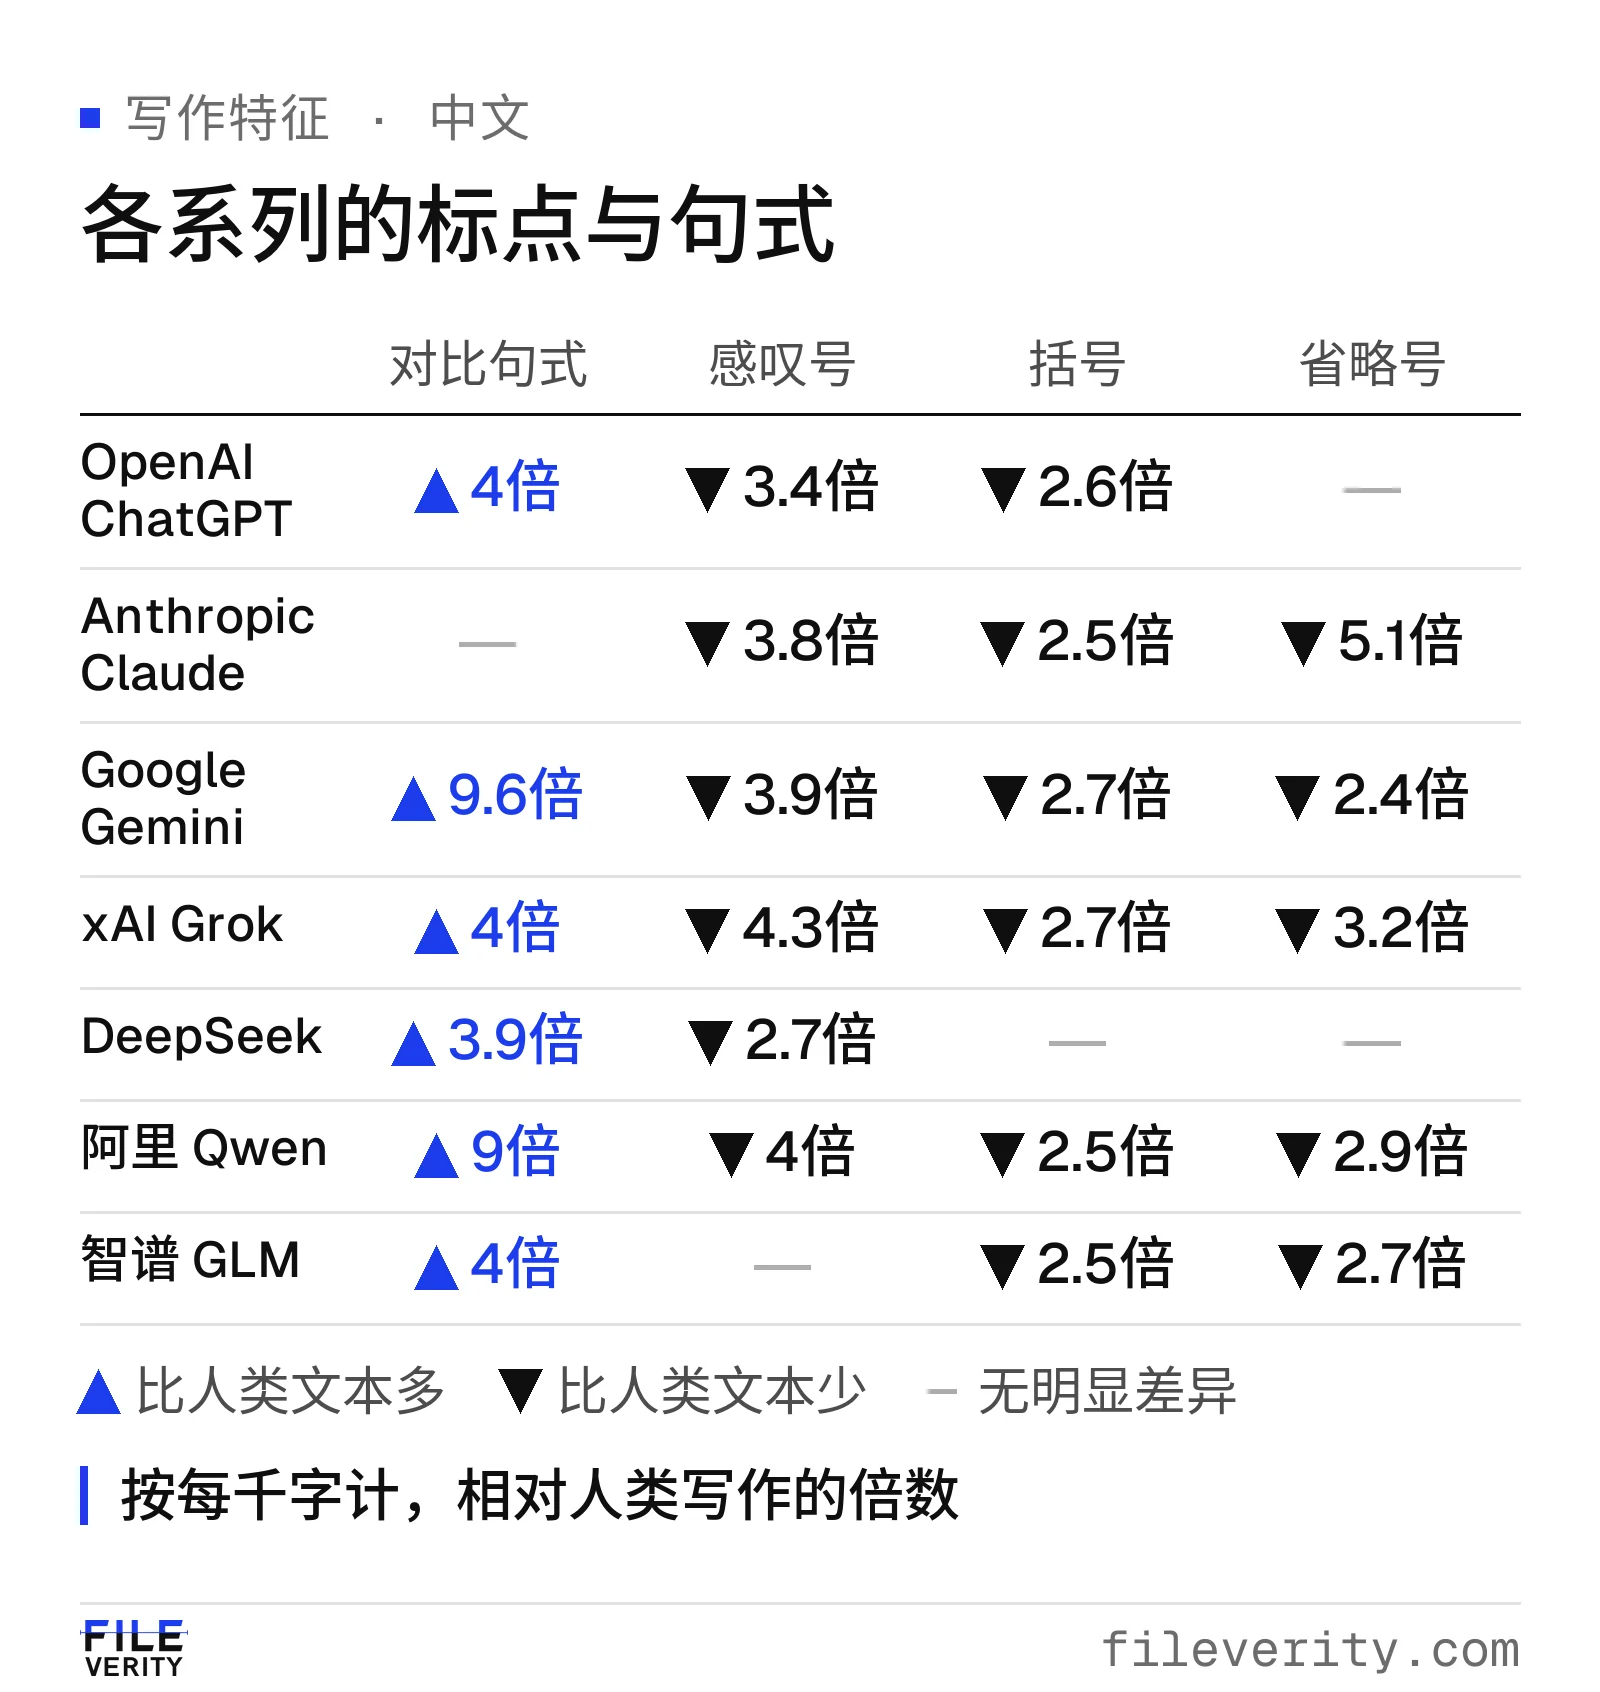
按每千字计,AI 的感叹号、括号和省略号普遍比人类少,对比句式则普遍比人类多。
有两点值得注意。第一,感叹号和括号几乎所有系列都少用,这是 AI 文字相对干净、情绪标记少的一个共同特点,所以它说明“像 AI”,却分不出“哪个 AI”。第二,能把系列区分开的是少数几个标记:DeepSeek 的破折号、Gemini 和 Qwen 的对比句式,以及 Claude 的省略号。
这些数字是怎么得来的
我们用同一种方法分别比较每个系列:
- 用该系列整篇生成的文档,与同一语言的人类文档对比。人类文档按来源和文体的比例重新加权到与 AI 文档一致,这样差异就不是文体或题材造成的;另外还拿 AI 文字所依据的人类原文做了一次对照,用来核对方向没有搞反。
- 词语是 2 到 4 个字的连续片段,用带先验的对数几率比来打分;与其他 AI 系列的比较里,每个系列权重相同。
- 只保留满足以下条件的词:出现在多个来源和文体的许多文档里;不只是虚词、数字、人名或主题词;把数据随机分成两半,两半的方向一致。倍数是平滑后的相对频率。
- 标点和句式来自原始文字,要求两半数据方向一致,写作和改写两类任务中也一致。
这是统计倾向,不是证明作者身份的证据:个别文本差异很大,提示词也会改变风格。
使用这些特征时的注意事项
- 人也会用这些词。“日常”“往往”“并非”都是正常的中文词语,只是 AI 用得更频繁。单个词不能作为证据,看到一两个词不应得出结论。
- 经过编辑的 AI 文字,特征会被冲淡。换词、改写和通篇润色之后,词语清单的作用会下降。
- 倍数不等于概率。“后续”多出 18 倍,不代表出现这个词的文字有 18 倍的可能性是 DeepSeek 写的。
- 系列之间会相互接近。几个国内模型的用词相似,只靠词语很难区分;与人类作者的差别,比系列之间的差别大得多。
- 文体会改变一切。公文、论文、短视频文案和聊天记录,本来就有各自的习惯。
Veread 读的远不止词语清单
词语和标点清单是人能看懂的线索,但它很粗糙:改几个词就失效,也不能说明整段文字的写法。Fileverity 的 AI文本检测由 Veread 驱动,读的是文字整体的写法,而不是几个词,并标出哪些段落最像 AI 撰写,给出与各模型系列的写作风格相似度。Veread 不读取任何厂商的水印;各家水印的现状见AI 文本水印现状。
在我们的评测中,Veread 1.1 对整篇 AI 撰写文本的检出率为 98.6%,对开发中从未使用过的模型所写的文本为 94.9%,七种语言上人工撰写文本被误判的比例为 0.28%,完整成绩见准确率页面。
关于各模型写作特征的常见问题
怎么判断一段文字是哪个 AI 写的?
只看词语和标点,只能得到线索,得不到结论。先看整段文字是否像 AI 撰写,再看它与哪个系列的写作风格相似;系列之间的差异比 AI 与人类之间的差异小得多,所以应把系列判断当作辅助。
哪些词最能说明是 AI 写的?
没有一个词能单独说明问题。AI 文字里常见的词包括“往往”“并非”“而是”“核心”“关键”,每个系列各有倾向,比如 DeepSeek 的“后续”和“环节”、Gemini 的“瞬间”和“捕捉”、Qwen 的“仅是”。这些词人也会用。
不同的 AI 在标点上有什么区别?
AI 文字普遍比人类少用感叹号、括号和省略号,多用“不是……而是……”的对比句式。DeepSeek 更多用破折号,Claude 的省略号特别少,Gemini 和 Qwen 的对比句式特别多。
这些特征对英文也适用吗?
不适用,本文的数据是中文的。每种语言单独统计,英文的特征词和标点与中文完全不同。
用这些特征能判断学生作业吗?
不能单独用来对个人下结论。风格只是信号,须与来源记录、写作过程和当面沟通结合,并经过人工复核。
作者 Yang Zheng