模型发布
Veread 1.1:误判更少,混写文档的段落标注更精准
Veread 1.1 整篇 AI 文本检出率 98.6%,误判率降至 0.28%,混写文档检出率 92.2%。2026 年 11 月 18 日起全面上线。
发布于 · 7 分钟阅读
要点速览
- 版本
- Veread 1.1
- 发布日期
- 2026 年 11 月 18 日
- 人工写作误判率
- 0.28%(1.0 为 0.45%)
- 整篇 AI 撰写文本检出率
- 98.6%
- 人工与 AI 混写文档检出率
- 92.2%(1.0 为 87.3%)
- 未见过的 AI 模型所写文本检出率
- 94.9%
Veread 1.1 于 2026 年 11 月 18 日发布。在七种语言的留出测试数据上,它对整篇 AI 撰写文本的检出率达 98.6%,人工写作被误判为 AI 的比例仅为 0.28%,低于 Veread 1.0 的 0.45%;对人工与 AI 混写文档的检出率为 92.2%(1.0 为 87.3%),标出 AI 撰写段落的精确率达 97.2%。
Veread 是 Fileverity 自研的 AI 文本检测模型。现在,Fileverity 的所有文本与文档检测,均已运行在 1.1 版上。
Veread 1.1 的更新内容
- 训练重点放在英语、西班牙语和法语。 英语、法语、德语、西班牙语、中文、越南语和阿拉伯语七种语言仍由同一个模型覆盖。
- 人工写作的来源大幅拓宽。 涵盖学生作文与课程作业、完整的学术论文、信函与投诉、影评与商品评论、论坛讨论、小说与文学性散文、法律与行政文书、新闻以及百科类文章。
- 有意加入高难度的人工样本。 行文正式、套路化或打磨得很工整的人工写作,正是检测工具特别容易误判为 AI 的一类,如今已成为训练的核心部分。
- 覆盖新一代 AI 写作,来自九个模型系列: OpenAI、Anthropic、Google、DeepSeek、Alibaba、Meta、Mistral、xAI 和 Zhipu,其中包括为规避检测而被改写、“拟人化”处理的 AI 文本,以及 AI 对人工文本的改写。
- 逐句标注。 混合文档中,每一句 AI 撰写的文字都带有标签,模型因此能准确学到人工写作在哪里结束、AI 写作从哪里开始。
- 更干净的训练文本。 署名、版权与来源说明、Cookie 与订阅提示、网页标记、脚注编号和字数统计,均只做删除处理,正文一字不改,因此 Veread 判断的是文字本身,而不是格式。
- 训练与评测之间严格去重。 完全重复和近似重复的文本都经过筛查,模型不会在自己实际上见过的文本上接受测试。
- 判定阈值重新校准。 阈值依据留出的人工写作确定;段落标注和写作风格比对也针对新模型重新校准,后者现在出现得更频繁,也更准确。
评测结果:Veread 1.1 与 1.0 对比
两个版本使用同一套评测:留出的文本约 100 词及以上,涵盖七种语言。
| 指标 | Veread 1.0 | Veread 1.1 |
|---|---|---|
| 人工写作被误判为 AI | 0.45% | 0.28% |
| 整篇 AI 撰写文本检出率 | 98.3% | 98.6% |
| 各类 AI 撰写与 AI 辅助文本检出率 | 95.4% | 95.9% |
| 人工起笔、AI 续写的文本检出率 | 91.7% | 94.3% |
| 人工与 AI 混写文档的检出率 | 87.3% | 92.2% |
| 约 100 词短文本检出率 | 92.9% | 94.1% |
| 完整文档检出率 | 96.6% | 96.8% |
| AI 改写文本检出率 | 92.5% | 92.8% |
| 段落标注 F1 | 90.3 | 92.9 |
| AUROC,短文本 | 0.995 | 0.996 |
此外,Veread 1.1 对插入人工文本中的 AI 段落检出率为 100%,对经 AI 润色的文本为 97.6%,对来自开发中从未使用过的 AI 模型的文本为 94.9%;完整文档上的 AUROC 为 0.999。
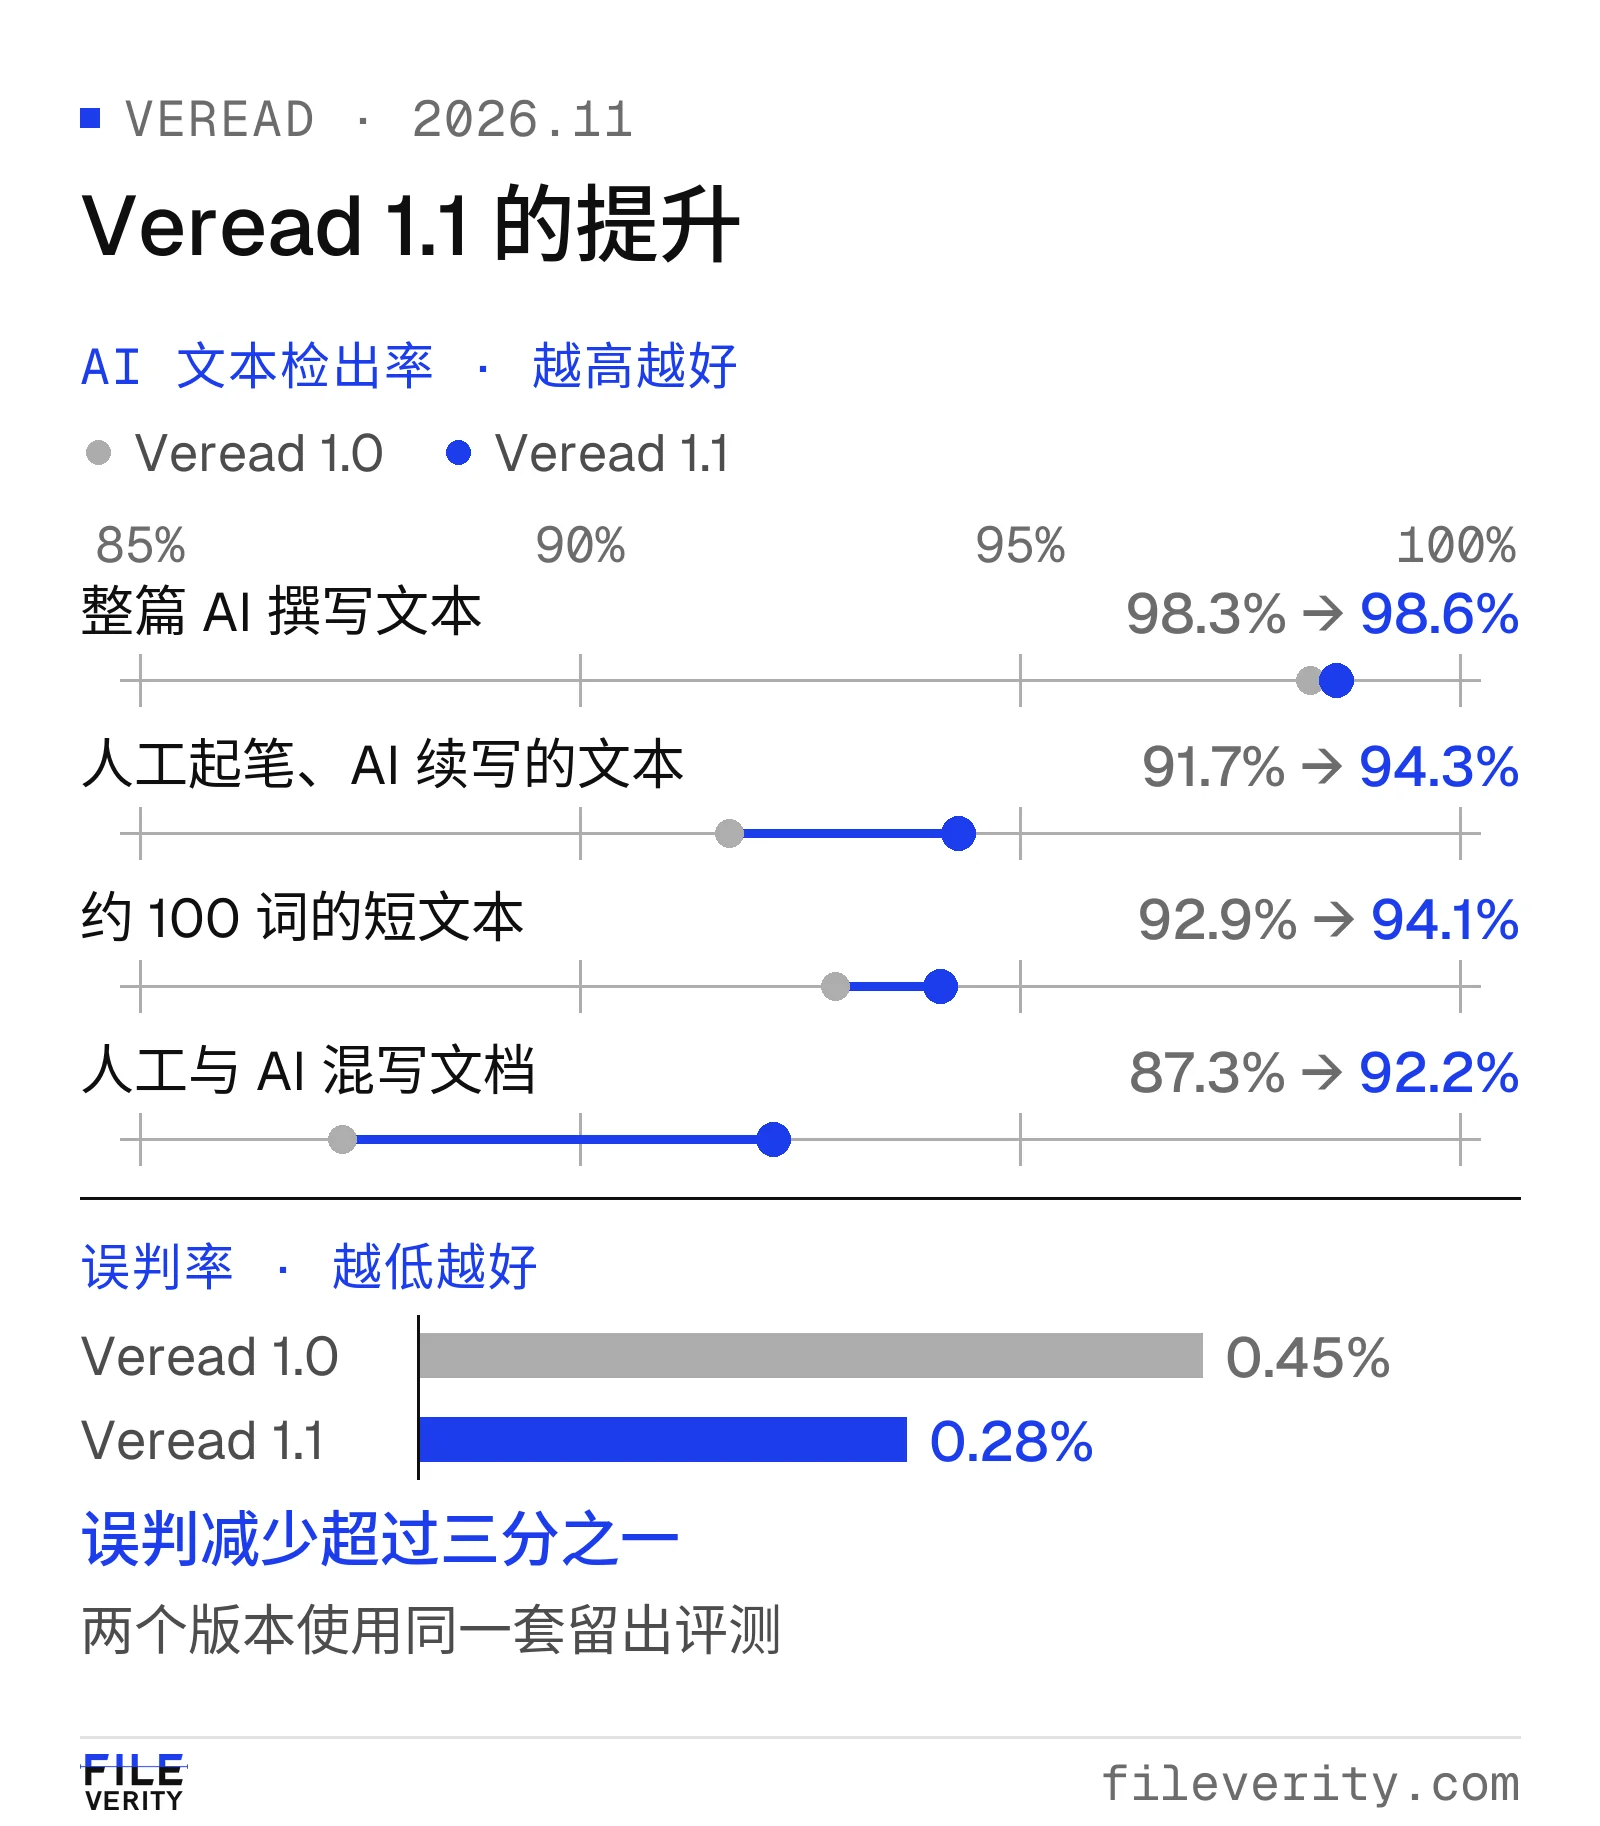
误判减少超过三分之一,各项主要检出指标同步提升。
指标含义
- 误判率: 人工撰写的文本中,被判为含 AI 撰写内容的比例。越低越好。
- 检出率: AI 撰写或 AI 辅助的文本中,被 Veread 识别出来的比例。越高越好。
- AI 辅助: 只有 AI 确实改动了文字,才计入此类,无论是续写、改写、润色,还是插入人工文本中的 AI 段落。
- AUROC: 不论判定点设在哪里,Veread 的评分对人工写作与 AI 写作的区分有多清晰。满分 1 表示完全分开。
- 段落标注 F1: 把“找到多少 AI 撰写的段落”与“标出的段落中有多少确为 AI 撰写”合成一个分数。
- 标注段落的精确率: 被标出的文字中,确由 AI 撰写的比例。
对人工写作的误判更少
误判,就是把一个人自己写的作品标成机器所写。对教师、招生办公室和编辑来说,这个数字决定了检测工具能否用在真实的人的作品上。
Veread 1.1 对人工写作的误判率为 0.28%,比 Veread 1.0 减少超过三分之一。这一数字涵盖全部留出的人工写作,其中包括来自训练中从未使用过的来源的独立人工样本。完整文档的误判率为 0.23%。
每种语言的误判率都低于 0.5%:英语由 0.43% 降至 0.18%,西班牙语由 0.77% 降至 0.41%,法语由 0.76% 降至 0.45%,其余语言见下文语言表。每种文体的误判率都低于 1%:文学与文学性散文由 0.62% 降至 0.08%,评论与论坛由 0.84% 降至 0.38%,学生与语言学习者的作文由 0.51% 降至 0.30%,学术与科学文本由 1.08% 降至 0.77%。
混合文档中的段落标注更精准
现实中的来稿很少是纯粹的机器输出。Veread 1.1 通过逐句标注学习,对人工与 AI 混写文档的检出率达 92.2%(1.0 为 87.3%),标注段落的精确率达 97.2%,段落标注 F1 为 92.9(1.0 为 90.3)。以上结果均通过生产引擎端到端测得。
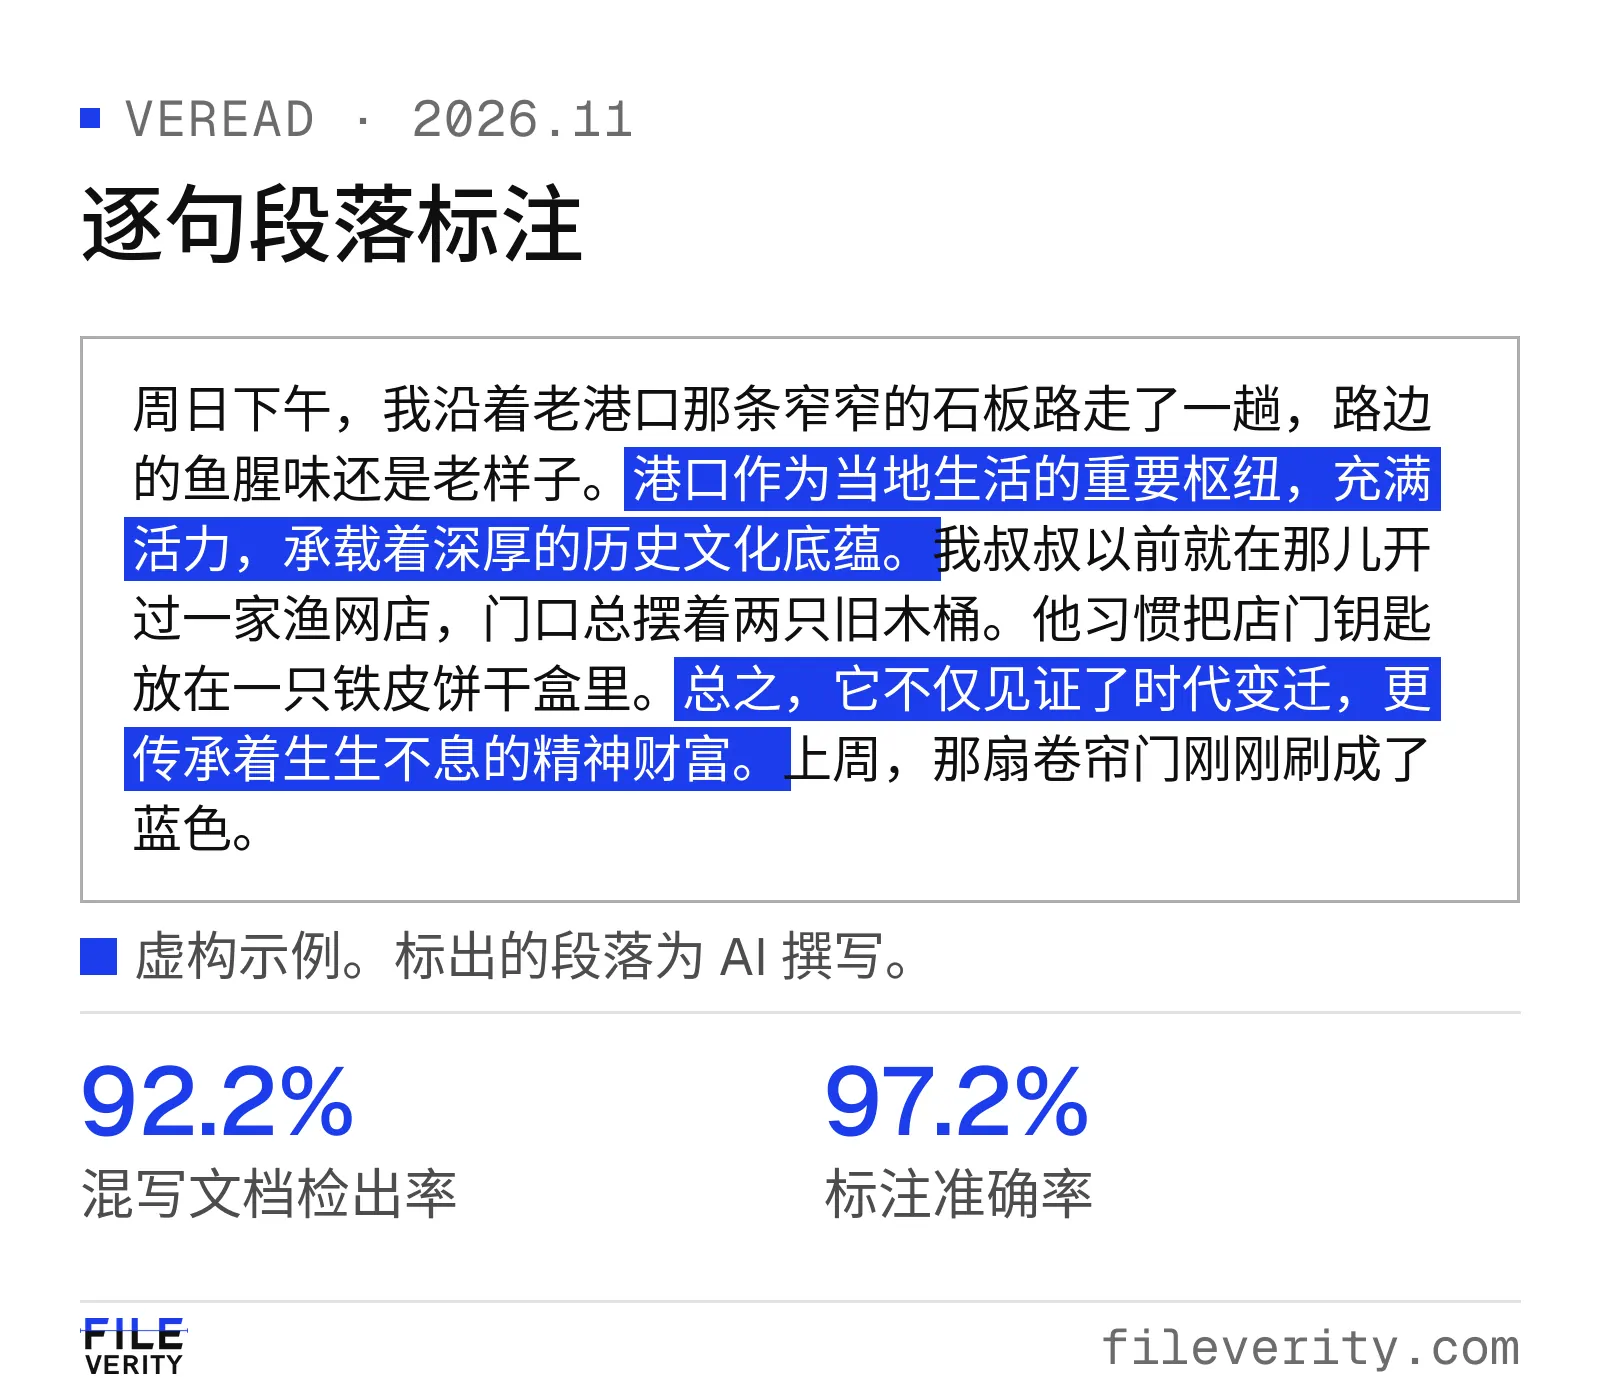
虚构示例。Veread 1.1 在同时含有人工写作的文档中,标出 AI 撰写的句子。
七种语言,逐一实测
一个模型服务七种语言,每种语言都单独测量,结果如下。
| 语言 | 人工写作被误判 | AI 撰写与 AI 辅助文本检出率 | 整篇 AI 撰写文本检出率 |
|---|---|---|---|
| 英语 | 0.18% | 94.5% | 95.1% |
| 法语 | 0.45% | 96.8% | 99.1% |
| 德语 | 0.27% | 94.1% | 100% |
| 西班牙语 | 0.41% | 96.0% | 100% |
| 中文 | 0.03% | 98.8% | 100% |
| 越南语 | 0.48% | 92.8% | 95.5% |
| 阿拉伯语 | 0.13% | 97.5% | 98.5% |
AI 撰写与 AI 辅助文本的检出率在英语(1.0 为 93.3%)、德语(93.2%)、越南语(90.7%)和阿拉伯语(97.2%)上均有提升;整篇 AI 撰写的德语文本检出率由 99.1% 升至 100%。
按模型系列看,整篇 AI 撰写文本中,来自 OpenAI、Alibaba、Mistral、xAI 和 Meta 的检出率均为 100%(Meta 此前为 96.8%),DeepSeek 为 96.3%(此前 95.1%),Google 为 95.9%(此前 93.9%)。
按文体看,学术与科学文本、信函邮件与投诉中的 AI 撰写与 AI 辅助文本检出率为 100%,学生与语言学习者的作文为 99.1%(此前 98.1%)。
我们如何评测 Veread
检测工具是否可信,取决于它如何被检验。Veread 基于海量独家自有的专业化数据样本开发与验证,本文的每一项结果,都来自下面这套评测方法。
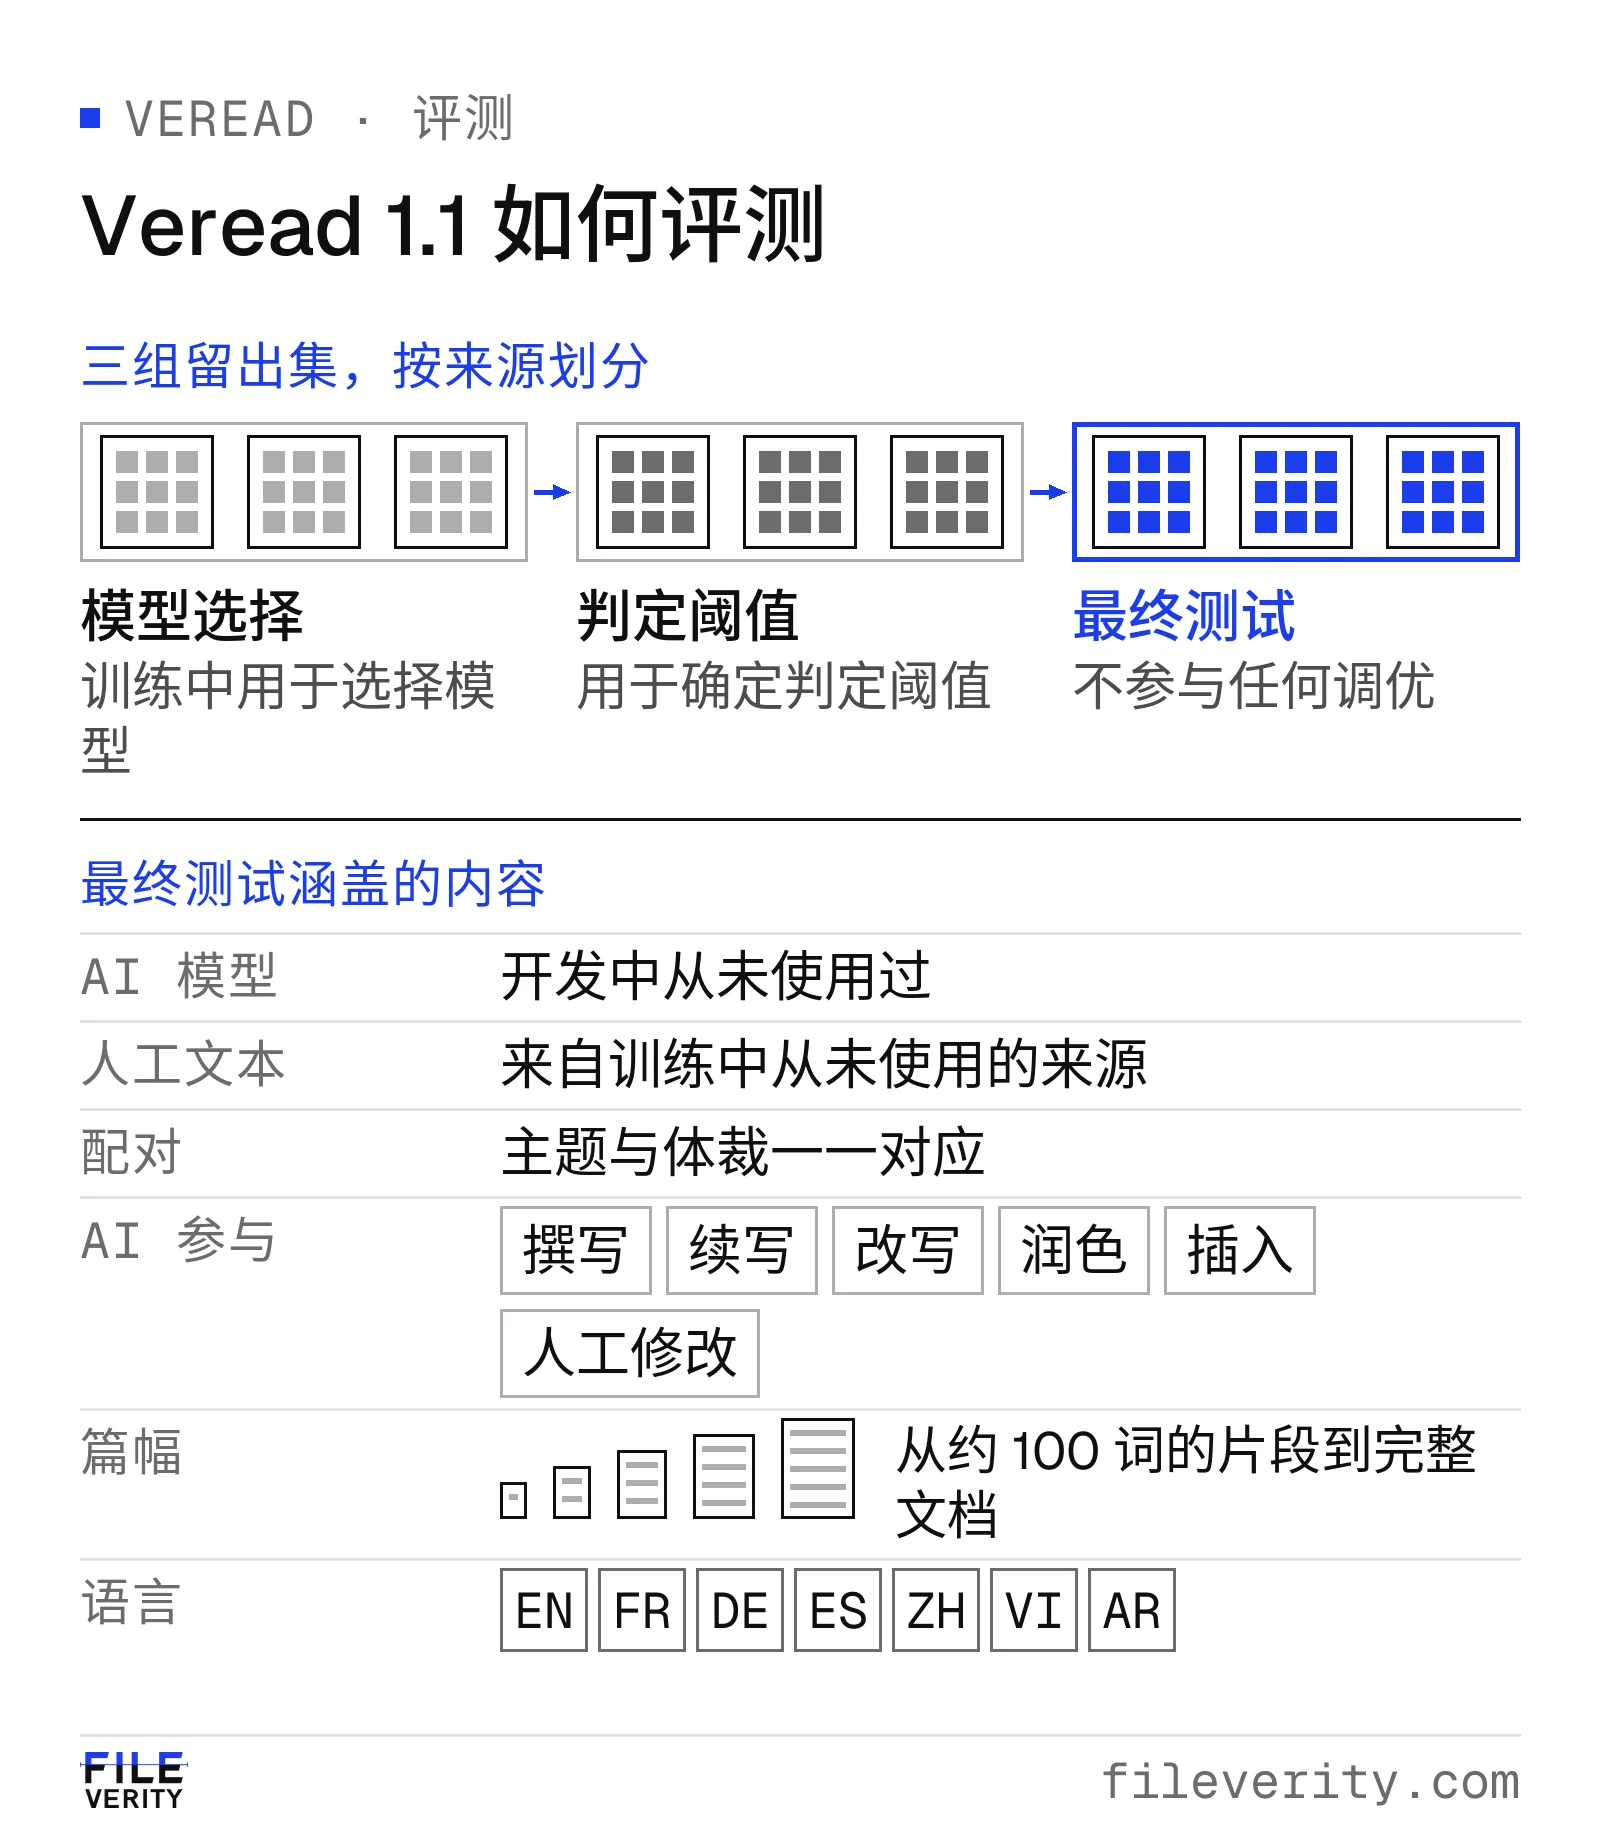
评测把选模型、定阈值和最终测试彼此分开,并直接测量客户实际使用的引擎。
- 三组留出集,各司其职。 一组用于训练中选择模型,一组用于确定判定阈值,一组用于最终测试。最终测试集不参与任何调优。
- 按来源留出。 来源或作者群体相同的文档,一律划在划分的同一侧,因此测试检验的是泛化能力,而非记忆。
- 从未见过的 AI 模型。 测试包含来自开发全过程中从未使用过的模型的文本。
- 从未见过的人工写作来源。 以训练中从未使用过的来源组成的人工样本,按客户实际遇到的情形衡量误判。
- 配对文本。 AI 文本与对应的人工文本主题相同、体裁相同,检测工具无法仅凭主题或格式取胜,只能靠写作本身。
- 涵盖各种 AI 参与方式。 从零撰写、人工起笔后由 AI 续写、AI 改写、AI 润色、AI 段落插入人工文本,以及人工修改 AI 草稿。
- 只计真正的 AI 写作。 经编辑的文本,只有在 AI 确实改动了文字时才计为 AI 辅助;仅作轻微修饰、人工措辞原样保留的文本不计入。
- 输入范围完整。 从约 100 词的片段到完整文档,涵盖七种语言,以及法律与行政文书、文学作品、学生写作、学术论文、新闻、网页内容、评论与论坛、实务文书、信函与投诉等体裁。
- 生产引擎。 结果直接取自为客户提供服务的同一套引擎,端到端测得,而非实验室副本。
现已上线
Veread 1.1 自 2026 年 11 月 18 日起上线,无需任何操作:
- 网页版 AI 文本检测与控制台。
- API:模型 ID 保持不变(文本为
veread-1-text,文档为veread-1),新快照日期为 2026-11-18。详见文本检测 API 文档。 - 文档报告:Veread 会检查文档内的文本。准确率页面列出了主要测量数据。
- Chrome 插件,以及面向教师的班级批量检测。
按语言、文体和模型系列划分的 Veread 1.1 完整成绩单,见 Veread 评测指南。
作者 Yang Zheng