Erkennung bewerten
Wie zuverlässig sind KI-Bilddetektoren? Genauigkeit und Fehlalarme erklärt
Genauigkeit, Fehlalarme und Schwellenwerte von KI-Bilddetektoren verstehen – mit Rechenbeispielen zu Prävalenz, Prüfaufwand und Kalibrierung.
Veröffentlicht · Aktualisiert · 14 Min. Lesezeit
Auf dieser Seite
Die Zuverlässigkeit eines KI-Bilddetektors lässt sich nur mit einer definierten Aufgabe, geeigneten Testbildern und einem festen Schwellenwert beurteilen. Eine hohe Gesamtgenauigkeit kann im Betrieb trotzdem mehr Fehlalarme als Treffer erzeugen. Eine kurze Prüfliste kann umgekehrt viele übersehene KI-Bilder verbergen. Bewerten Sie deshalb auch Trefferquote, Fehlalarmrate, den Anteil tatsächlicher KI-Bilder und den Umgang mit Dateien ohne verwertbares Ergebnis.
Stellen Sie deshalb drei zusammenhängende Fragen: Was genau erkennt der Detektor? Welche Fehler entstehen am vorgesehenen Schwellenwert? Und was geschieht mit Dateien, die er nicht bewerten kann? Die Rechenbeispiele unten verbinden diese Antworten mit dem Prüfaufwand, der in Ihrem Team ankommt.
Für einen schnellen Check einer Genauigkeitsangabe genügen die Abschnitte zu Konfusionsmatrix, Prävalenz und Schwellenwert. Wenn Sie eine Bewertung verantworten, lesen Sie weiter bis zu Kalibrierung, Abdeckung und Testdesign und nutzen Sie am Ende die Anfrage an Anbieter. Alle Zahlen in diesem Ratgeber sind fiktiv: Sie sind weder Messergebnisse von Fileverity noch Schätzungen dazu, wie häufig KI-Bilder oder Betrugsfälle vorkommen.
Auf einen Blick
| Frage | Kennzahl | Worauf Sie achten sollten |
|---|---|---|
| Wie viele Entscheidungen waren richtig? | Genauigkeit | Bei seltenen KI-Bildern fast immer hoch, auch bei schwachem Detektor |
| Wie viele Markierungen stimmen? | Präzision | Hängt stark von der Prävalenz in Ihrem Eingang ab |
| Wie viele KI-Bilder werden gefunden? | Trefferquote (Recall) | Nur am tatsächlich genutzten Schwellenwert aussagekräftig |
| Wie viele echte Fotos werden markiert? | Falsch-positiv-Rate | Nicht dasselbe wie der Anteil der Fehlalarme unter den Markierungen |
| Was bedeutet ein Wert von 0,9? | Kalibrierung | Kein Wert ist automatisch eine Wahrscheinlichkeit |
| Was passiert mit schwierigen Dateien? | Abdeckung | „Nicht bestimmbar“ gehört in den Nenner, nicht unter den Tisch |
Festlegen, was bei der Erkennung KI-generierter Bilder als positiv gilt
Beginnen Sie mit einem Satz wie: „Diese Bewertung prüft, ob ein eingereichtes Bild vollständig KI-generiert wurde.“ Damit sind vollständig generierte Bilder die positiven Fälle und echte Kamerafotos die negativen. Für lokale KI-Bearbeitungen, klassische Retusche, irreführende Bildunterschriften oder wiederverwendete Fotos ist damit noch nichts getestet.
Wenn Ihr Prozess auch teilweise generierte Bilder erkennen muss, bewerten Sie das als eigene Aufgabe mit eigenen Labels. Ein echtes Foto mit einem neu erzeugten Bereich, etwa durch Generative Füllung, darf nicht je nach gewünschtem Ergebnis mal bei den positiven, mal bei den negativen Fällen landen. Wie lokale Änderungen geprüft werden, beschreibt der Ratgeber KI-bearbeitete Bilder erkennen. Und: Zulässiger KI-Einsatz ist nicht automatisch Täuschung. Detektor-Labels beschreiben den Inhalt; ob ein Befund relevant ist, entscheiden Ihre Richtlinie und weitere Nachweise.
Legen Sie auch die Einheit fest. Fünf Bilder aus einer Schadenmeldung sind fünf Bildentscheidungen, aber womöglich nur ein Prüffall. Wenn ein markiertes Bild die Prüfung des ganzen Vorgangs auslöst, sagt die Genauigkeit pro Bild den Prüfaufwand pro Fall nicht direkt voraus.
Die Konfusionsmatrix vor der Schlagzeile lesen
Eine Konfusionsmatrix stellt die Entscheidungen des Detektors unabhängig festgestellten Labels gegenüber. Nehmen Sie 10.000 fiktive Bilder: 100 generierte und 9.900 nicht generierte. Bei einem festen Schwellenwert markiert der Detektor 90 generierte und 99 nicht generierte Bilder.
| Tatsächliches Label | Markiert | Nicht markiert | Summe |
|---|---|---|---|
| Generiert | 90 richtig positiv (TP) | 10 übersehen, falsch negativ (FN) | 100 |
| Nicht generiert | 99 Fehlalarme, falsch positiv (FP) | 9.801 richtig negativ (TN) | 9.900 |
| Summe | 189 | 9.811 | 10.000 |
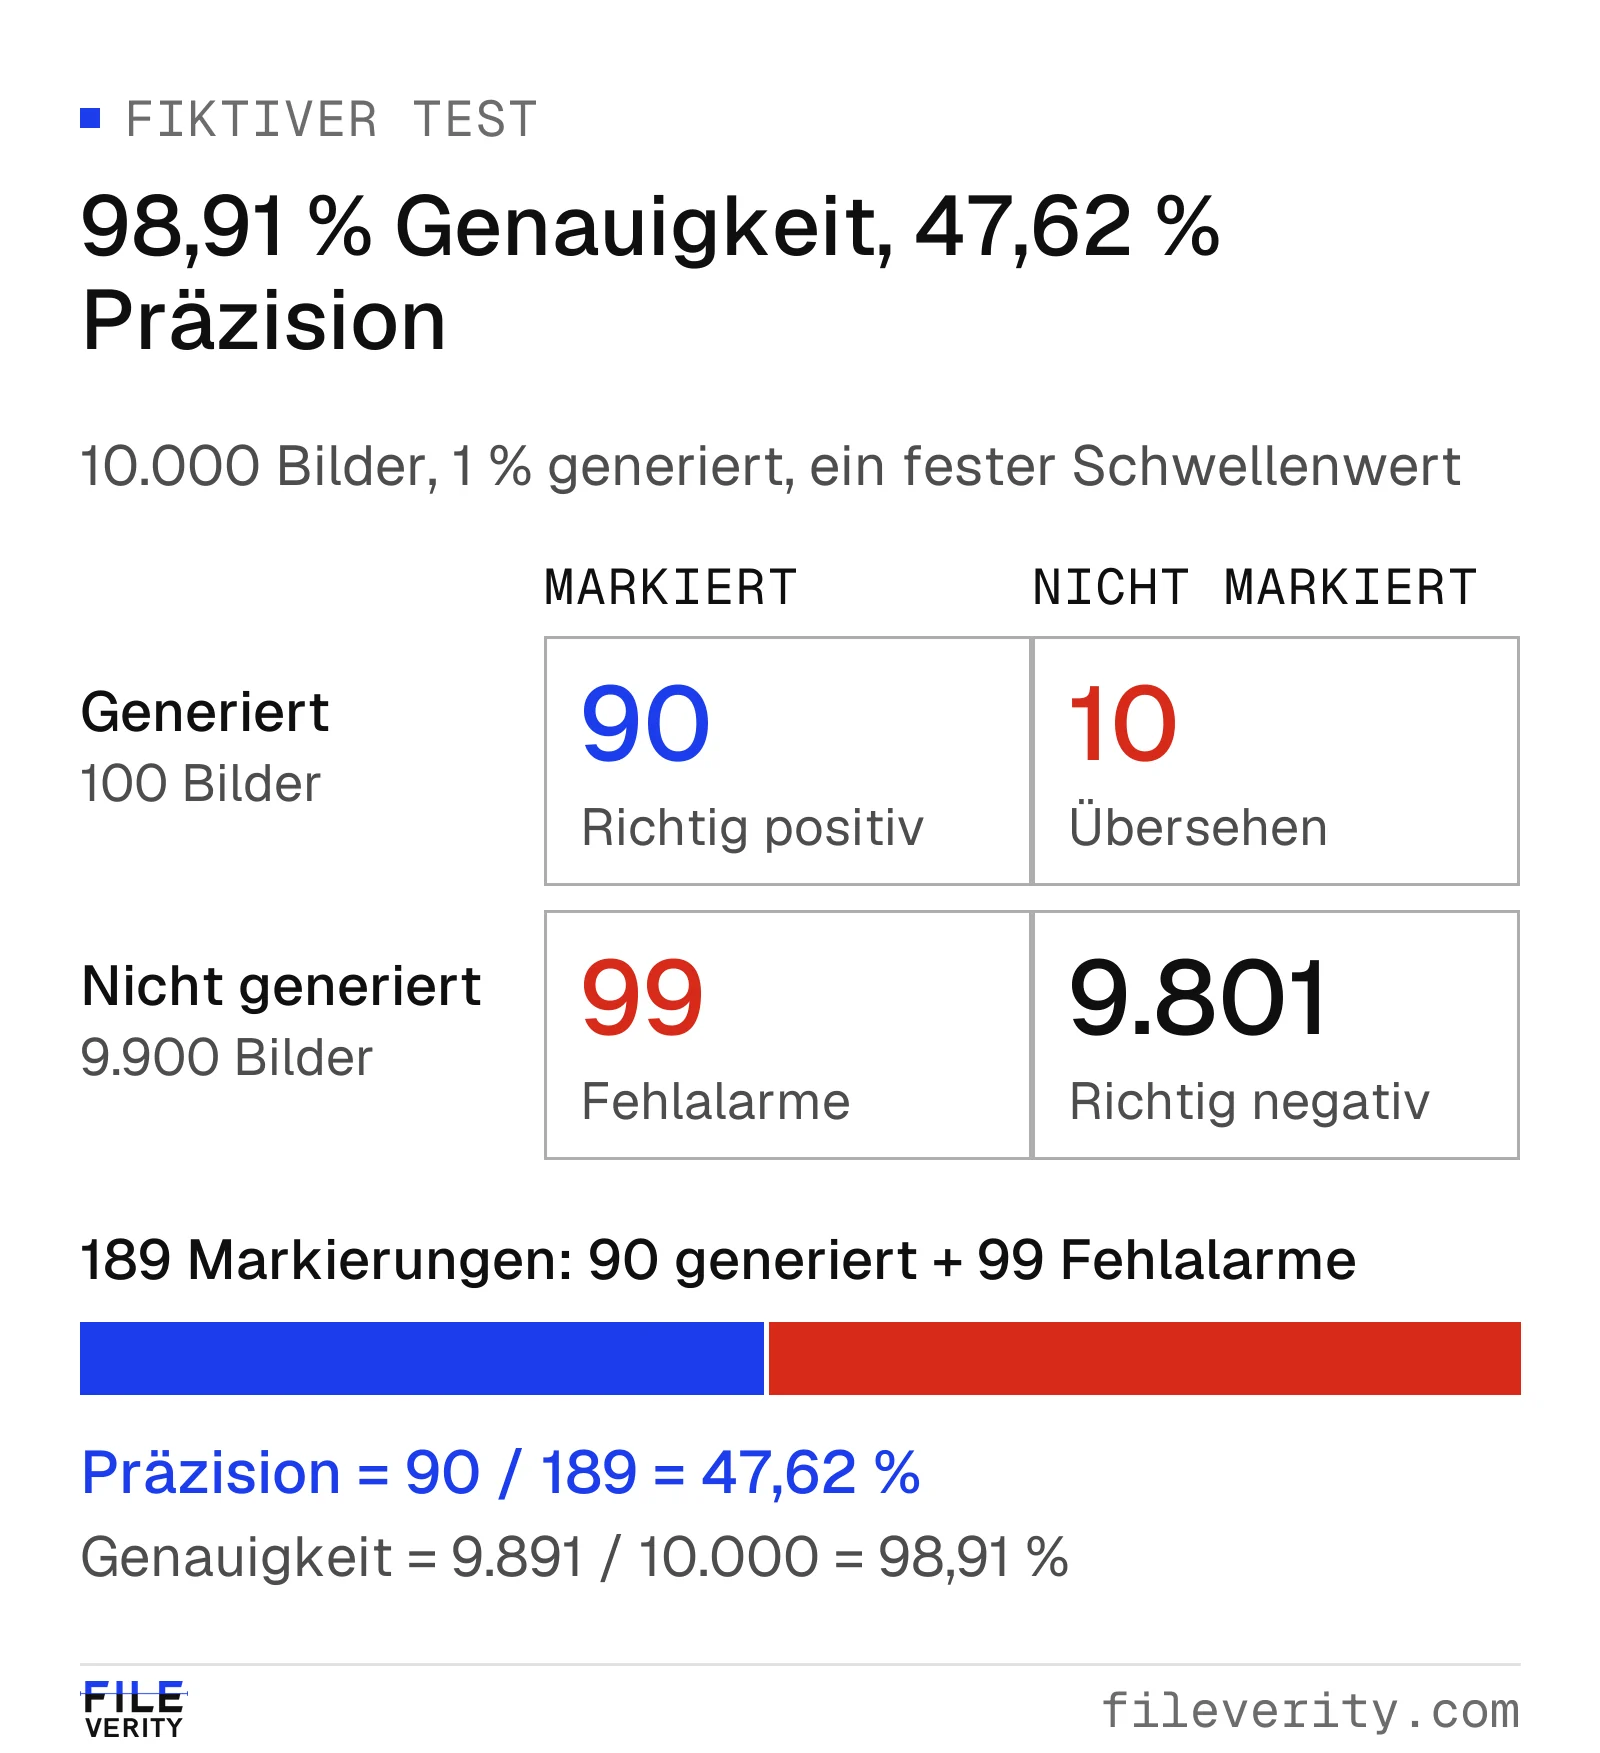
Von 189 Markierungen sind 90 richtig und 99 Fehlalarme – obwohl die Genauigkeit insgesamt 98,91 % beträgt.
Jede Kennzahl beantwortet eine andere Frage:
| Kennzahl | Berechnung | Ergebnis | Beantwortete Frage |
|---|---|---|---|
| Genauigkeit | (TP + TN) / alle Bilder | 98,91 % | Wie viele Entscheidungen waren richtig? |
| Trefferquote (Recall, Sensitivität) | TP / (TP + FN) | 90 % | Wie viele generierte Bilder wurden gefunden? |
| Falsch-negativ-Rate | FN / (TP + FN) | 10 % | Wie viele generierte Bilder wurden übersehen? |
| Falsch-positiv-Rate | FP / (FP + TN) | 1 % | Wie viele echte Bilder wurden markiert? |
| Spezifität | TN / (FP + TN) | 99 % | Wie viele echte Bilder blieben unmarkiert? |
| Präzision (positiver Vorhersagewert) | TP / (TP + FP) | 47,62 % | Wie viele Markierungen waren richtig? |
Die Präzision ist auf 90/189 gerundet. Entscheidend ist der Unterschied zwischen Falsch-positiv-Rate und Präzision: Eine Falsch-positiv-Rate von 1 % heißt nicht, dass nur 1 % der Markierungen Fehlalarme sind. Die Nenner sind verschieden. Hier sind 99 von 189 Markierungen, also 52,38 %, Fehlalarme. Die Standarddefinitionen und ihr Bezug zur Konfusionsmatrix dokumentiert die Referenz zu Klassifikationsmetriken von scikit-learn.
Eine Regel, die nie etwas markiert, erreicht auf derselben Bildmenge 99 % Genauigkeit und findet kein einziges generiertes Bild. Ein brauchbarer Detektor ist das nicht. Das Beispiel zeigt, warum ein Vergleich nach Genauigkeit das falsche Verhalten belohnen kann, wenn eine Klasse stark überwiegt.
Was die Prävalenz aus der Prüfwarteschlange macht
Die Prävalenz ist der Anteil positiver Fälle in der geprüften Menge, im Beispiel 1 %. Bleiben Trefferquote und Falsch-positiv-Rate gleich, ergibt sich die erwartete Präzision so:
Präzision = (Trefferquote × Prävalenz) / [(Trefferquote × Prävalenz) + (Falsch-positiv-Rate × (1 − Prävalenz))]
In Anteilen: 0,90 × 0,01 / [(0,90 × 0,01) + (0,01 × 0,99)] = 0,009 / 0,0189 = 47,619… %.
Die folgende Tabelle arbeitet mit Erwartungswerten; eine Nachkommastelle bei den Fehlalarmen beschreibt also einen Durchschnitt, kein halbes Bild.
Fiktive erwartete Ergebnisse je 10.000 Bilder bei 90 % Trefferquote und 1 % Falsch-positiv-Rate.
| Angenommene Prävalenz | Erwartete Treffer | Erwartete Fehlalarme | Erwartete Präzision |
|---|---|---|---|
| 0,1 % | 9 | 99,9 | 8,26 % |
| 1 % | 90 | 99 | 47,62 % |
| 10 % | 900 | 90 | 90,91 % |
| 50 % | 4.500 | 50 | 98,90 % |
Ein ausgewogener Benchmark mit 50 % KI-Bildern kann also eine eindrucksvolle Präzision liefern, die sich auf einen Eingang mit wenigen KI-Bildern nicht überträgt. Die Rechnung setzt außerdem voraus, dass Trefferquote und Falsch-positiv-Rate gleich bleiben. In der Praxis enthält ein anderer Eingang oft auch schwierigere Bilder, und dann verschieben sich diese Werte selbst.
Schätzen Sie die Prävalenz nicht aus dem Anteil markierter Bilder, denn dieser Anteil enthält die Fehler. Nutzen Sie eine unabhängig gelabelte Stichprobe Ihres Eingangs, weisen Sie ungeklärte Labels aus und rechnen Sie mehrere plausible Szenarien durch, wenn die Schätzung unsicher bleibt. Mit diesen Szenarien planen Sie die Prüfkapazität, bevor Sie sich auf einen Schwellenwert festlegen.
Den Schwellenwert nach der Folgeaktion wählen
Steht ein höherer Wert für stärkere Hinweise auf KI-Generierung, werden bei einem niedrigeren Schwellenwert mehr Bilder markiert. Auf derselben Bildmenge fällt dabei keine bisherige Markierung weg; es können also mehr Treffer und mehr Fehlalarme entstehen. Ein höherer Schwellenwert wirkt umgekehrt. Die Präzision muss nicht mit jeder Stufe steigen; das hängt davon ab, wie die tatsächlichen Labels über die Werte verteilt sind.
Das folgende konstruierte Beispiel nutzt dieselben 10.000 Bilder. Konkrete Schwellenwerte sind bewusst nicht angegeben, weil jedes System eine eigene Werteskala hat.
Fiktiver Vergleich: dieselben 100 generierten und 9.900 nicht generierten Bilder bei drei Schwellenwerten.
| Schwellenwert | Richtig positiv | Fehlalarme | Übersehen | Trefferquote | Falsch-positiv-Rate | Präzision | Markierungen |
|---|---|---|---|---|---|---|---|
| Niedrig | 95 | 297 | 5 | 95 % | 3 % | 24,23 % | 392 |
| Mittel | 90 | 99 | 10 | 90 % | 1 % | 47,62 % | 189 |
| Hoch | 70 | 20 | 30 | 70 % | 0,202 % | 77,78 % | 90 |
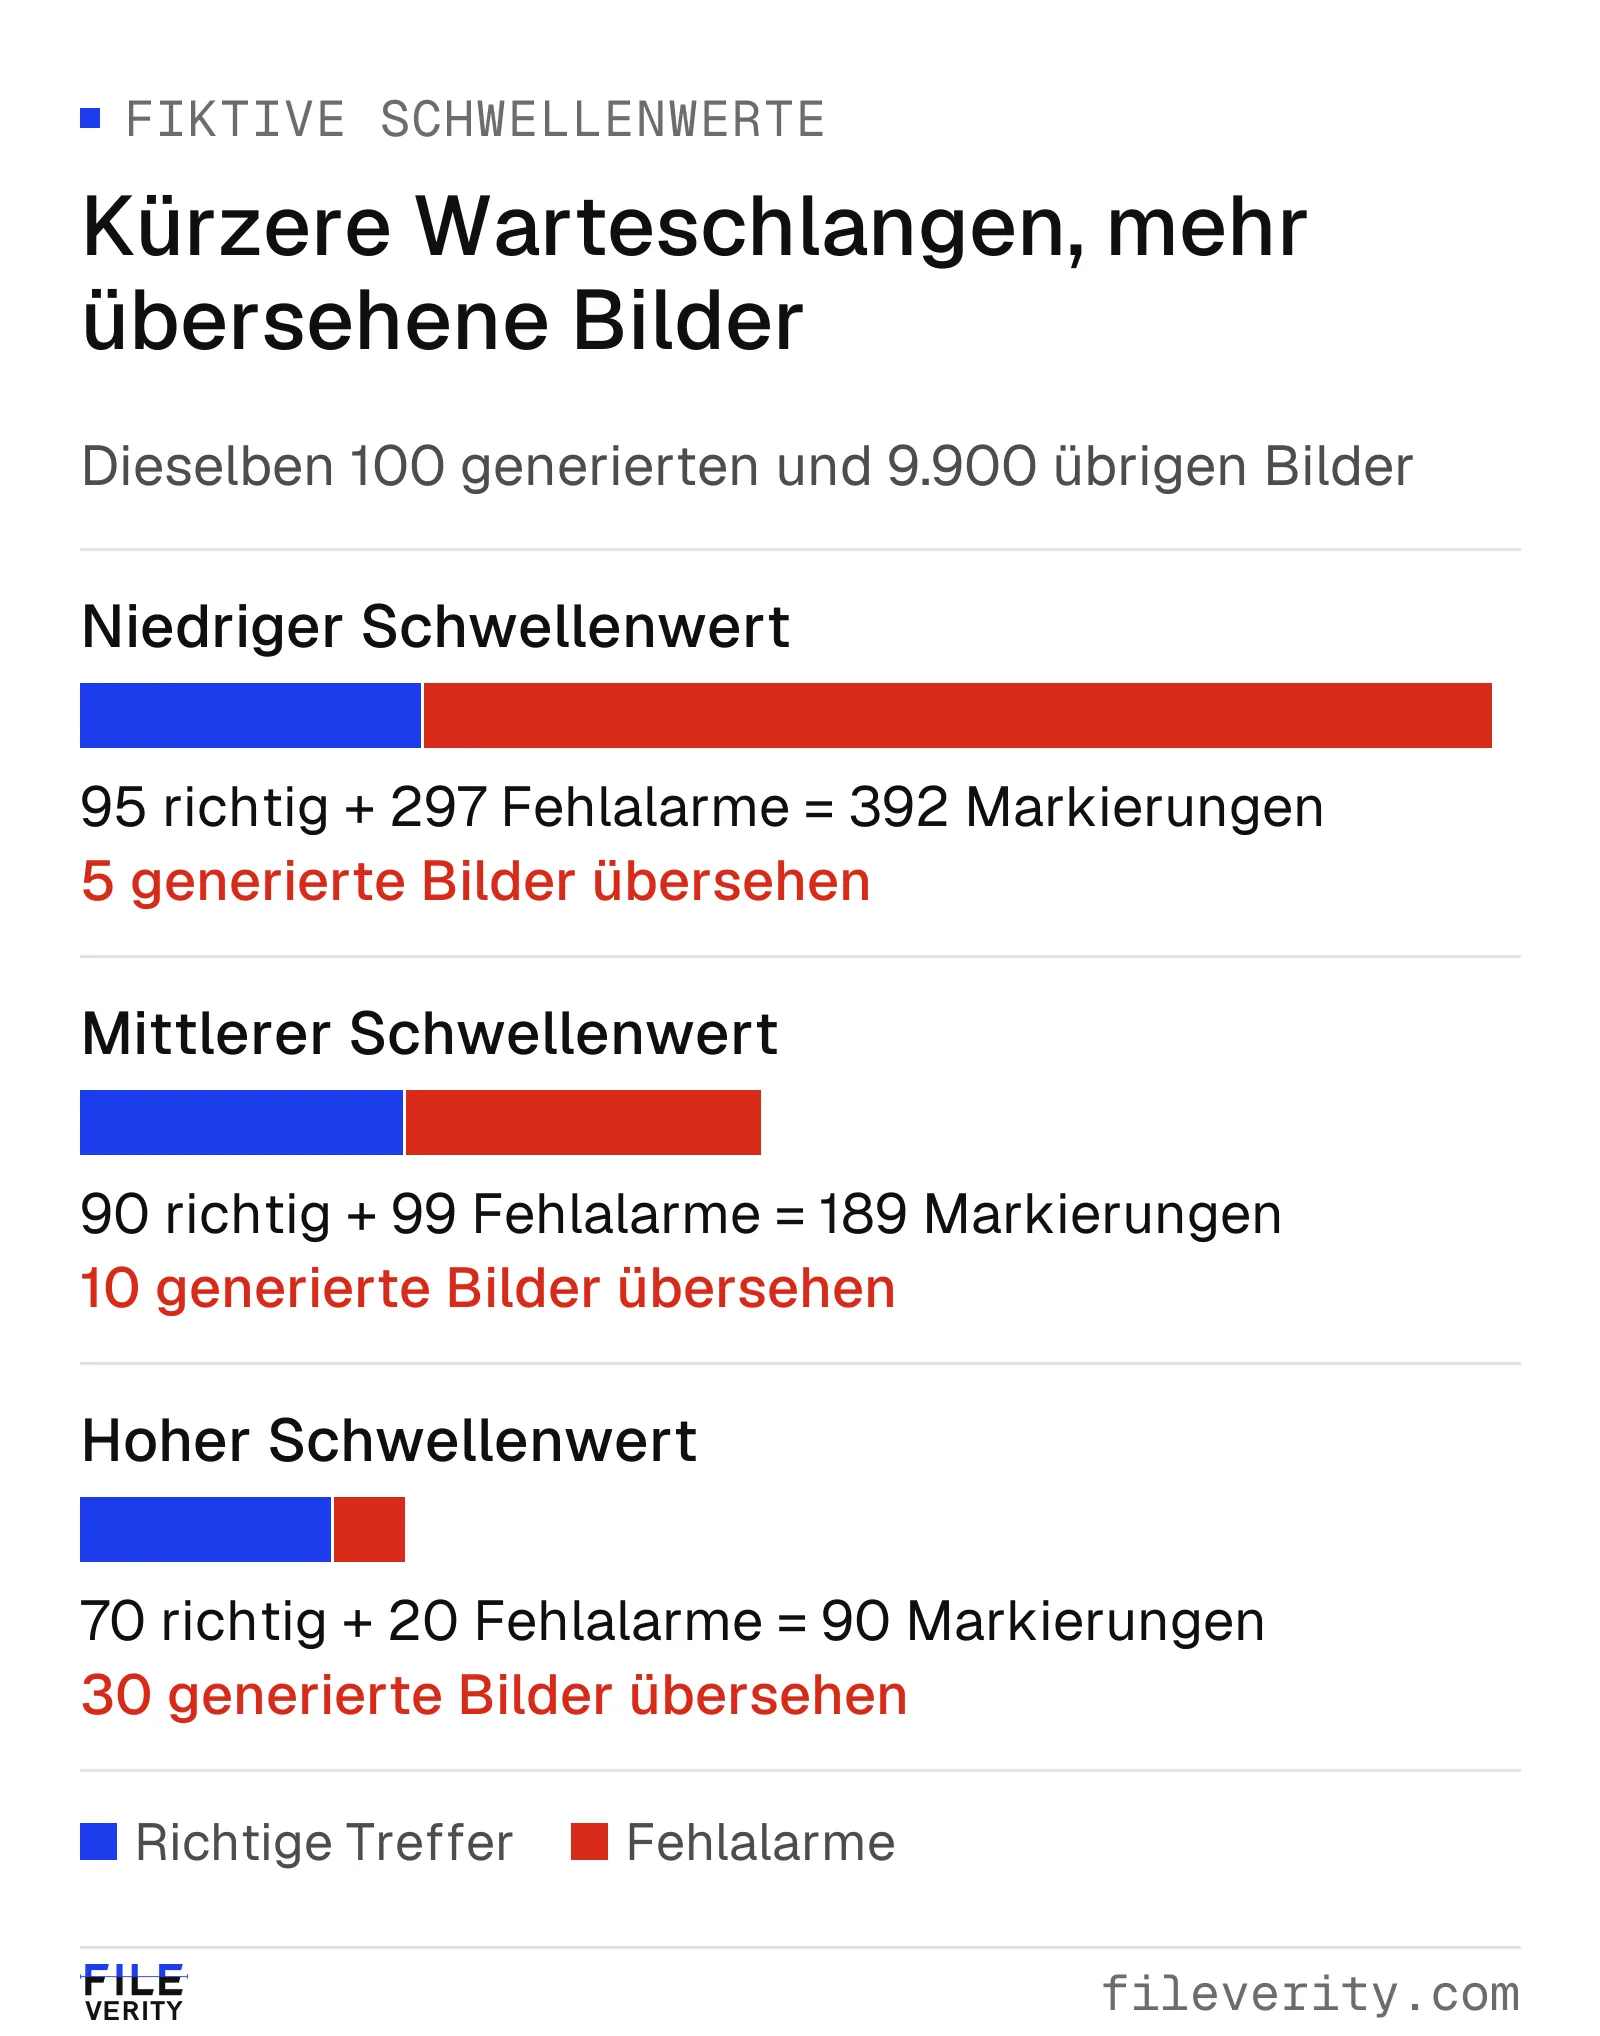
Ein höherer Schwellenwert verkleinert die Warteschlange von 392 auf 90 Bilder und erhöht die übersehenen KI-Bilder von 5 auf 30.
Bei angenommenen sechs Minuten je markiertem Bild bedeuten diese Warteschlangen 39,2, 18,9 und 9 Arbeitsstunden, noch ohne weitere Ermittlungen. Wer die kleinste Warteschlange wählt, nimmt 30 statt 5 übersehene Bilder in Kauf. Keine der Varianten ist an sich richtig: Die vorgesehene Folgeaktion, die verfügbare Sachbearbeitung und die Folgen eines Fehlers bestimmen, was vertretbar ist.
Fordern Sie Leistungswerte genau für den Arbeitspunkt an, den Sie nutzen wollen. Eine ROC-Kurve fasst Trefferquote gegen Falsch-positiv-Rate über alle Schwellenwerte zusammen; die Fläche darunter verrät nicht, welche Trefferquote Sie bei Ihrer Fehlalarmgrenze erreichen. NIST weist darauf hin, dass Fehlalarme – menschliche Inhalte als KI-generiert eingestuft – in vielen Kontexten erheblichen Schaden anrichten können, und beschreibt deshalb die Angabe der Trefferquote bei einer fest vorgegebenen niedrigen Falsch-positiv-Rate (NIST AI 100-4, Abschnitt 4.2.2 und Anhang E).
Ein Detektorwert ist keine Wahrscheinlichkeit
Ein Wert von 90 kann ein Rangsignal sein, eine umgerechnete Modellausgabe oder eine Wahrscheinlichkeitsschätzung. Er bedeutet nicht automatisch eine Wahrscheinlichkeit von 90 % für KI-Generierung, und schon gar nicht, dass 90 % der Pixel verändert wurden. Lassen Sie sich die Definition des Werts geben, bevor Sie ihm eine Bedeutung zuschreiben.
Kalibrierung fragt, ob Wahrscheinlichkeitsangaben über vergleichbare Fälle hinweg zu den beobachteten Häufigkeiten passen. Trennschärfe fragt, ob die Werte die Zielkategorien voneinander unterscheiden. Beides zählt, und keines ersetzt das andere.
Kalibrierung prüfen: vorhergesagte und beobachtete Häufigkeiten
Ein anschauliches Werkzeug ist das Zuverlässigkeitsdiagramm: Sie gruppieren die Vorhersagen nach Wertebereichen und vergleichen in jeder Gruppe die mittlere Vorhersage mit dem beobachteten Anteil positiver Fälle.
Für eine Gruppe B gilt p̄_B = Σp_i / n_B und r_B = Σy_i / n_B. Dabei ist p_i die vorhergesagte Wahrscheinlichkeit, y_i gleich 1 für einen unabhängig bestätigten positiven Fall und sonst 0, n_B die Gruppengröße. Perfekte Übereinstimmung in einer Gruppe heißt p̄_B = r_B; sie bedeutet nicht, dass jede einzelne Vorhersage sicher ist. Guo und Kollegen zeigen, dass moderne neuronale Klassifikatoren oft schlecht kalibriert sind, und arbeiten dabei mit Zuverlässigkeitsdiagrammen (Guo et al., ICML 2017).
Fiktive Auswertung einer Aufgabe „generiert / nicht generiert“:
| Wertebereich | Bilder | Mittlere Vorhersage | Bestätigt positiv | Beobachteter Anteil | Absolute Abweichung |
|---|---|---|---|---|---|
| 0,0 bis unter 0,4 | 100 | 0,20 | 10 | 0,10 | 0,10 |
| 0,4 bis unter 0,7 | 100 | 0,50 | 40 | 0,40 | 0,10 |
| 0,7 bis 1,0 | 100 | 0,80 | 60 | 0,60 | 0,20 |
Die nach Gruppengröße gewichtete absolute Abweichung ist Σ(n_B / N) × |p̄_B − r_B|, hier (0,10 + 0,10 + 0,20) / 3 = 0,1333, also rund 13,3 Prozentpunkte. Das beschreibt die Abweichung in diesen Gruppen. Es ist weder eine Fehlerquote der Klassifikation noch die Aussage, jeder Wert liege um 13,3 Punkte daneben. Andere Gruppengrenzen können Abweichungen verdecken oder sichtbar machen; bewahren Sie deshalb die Zählungen und das Diagramm neben der Kennzahl auf.
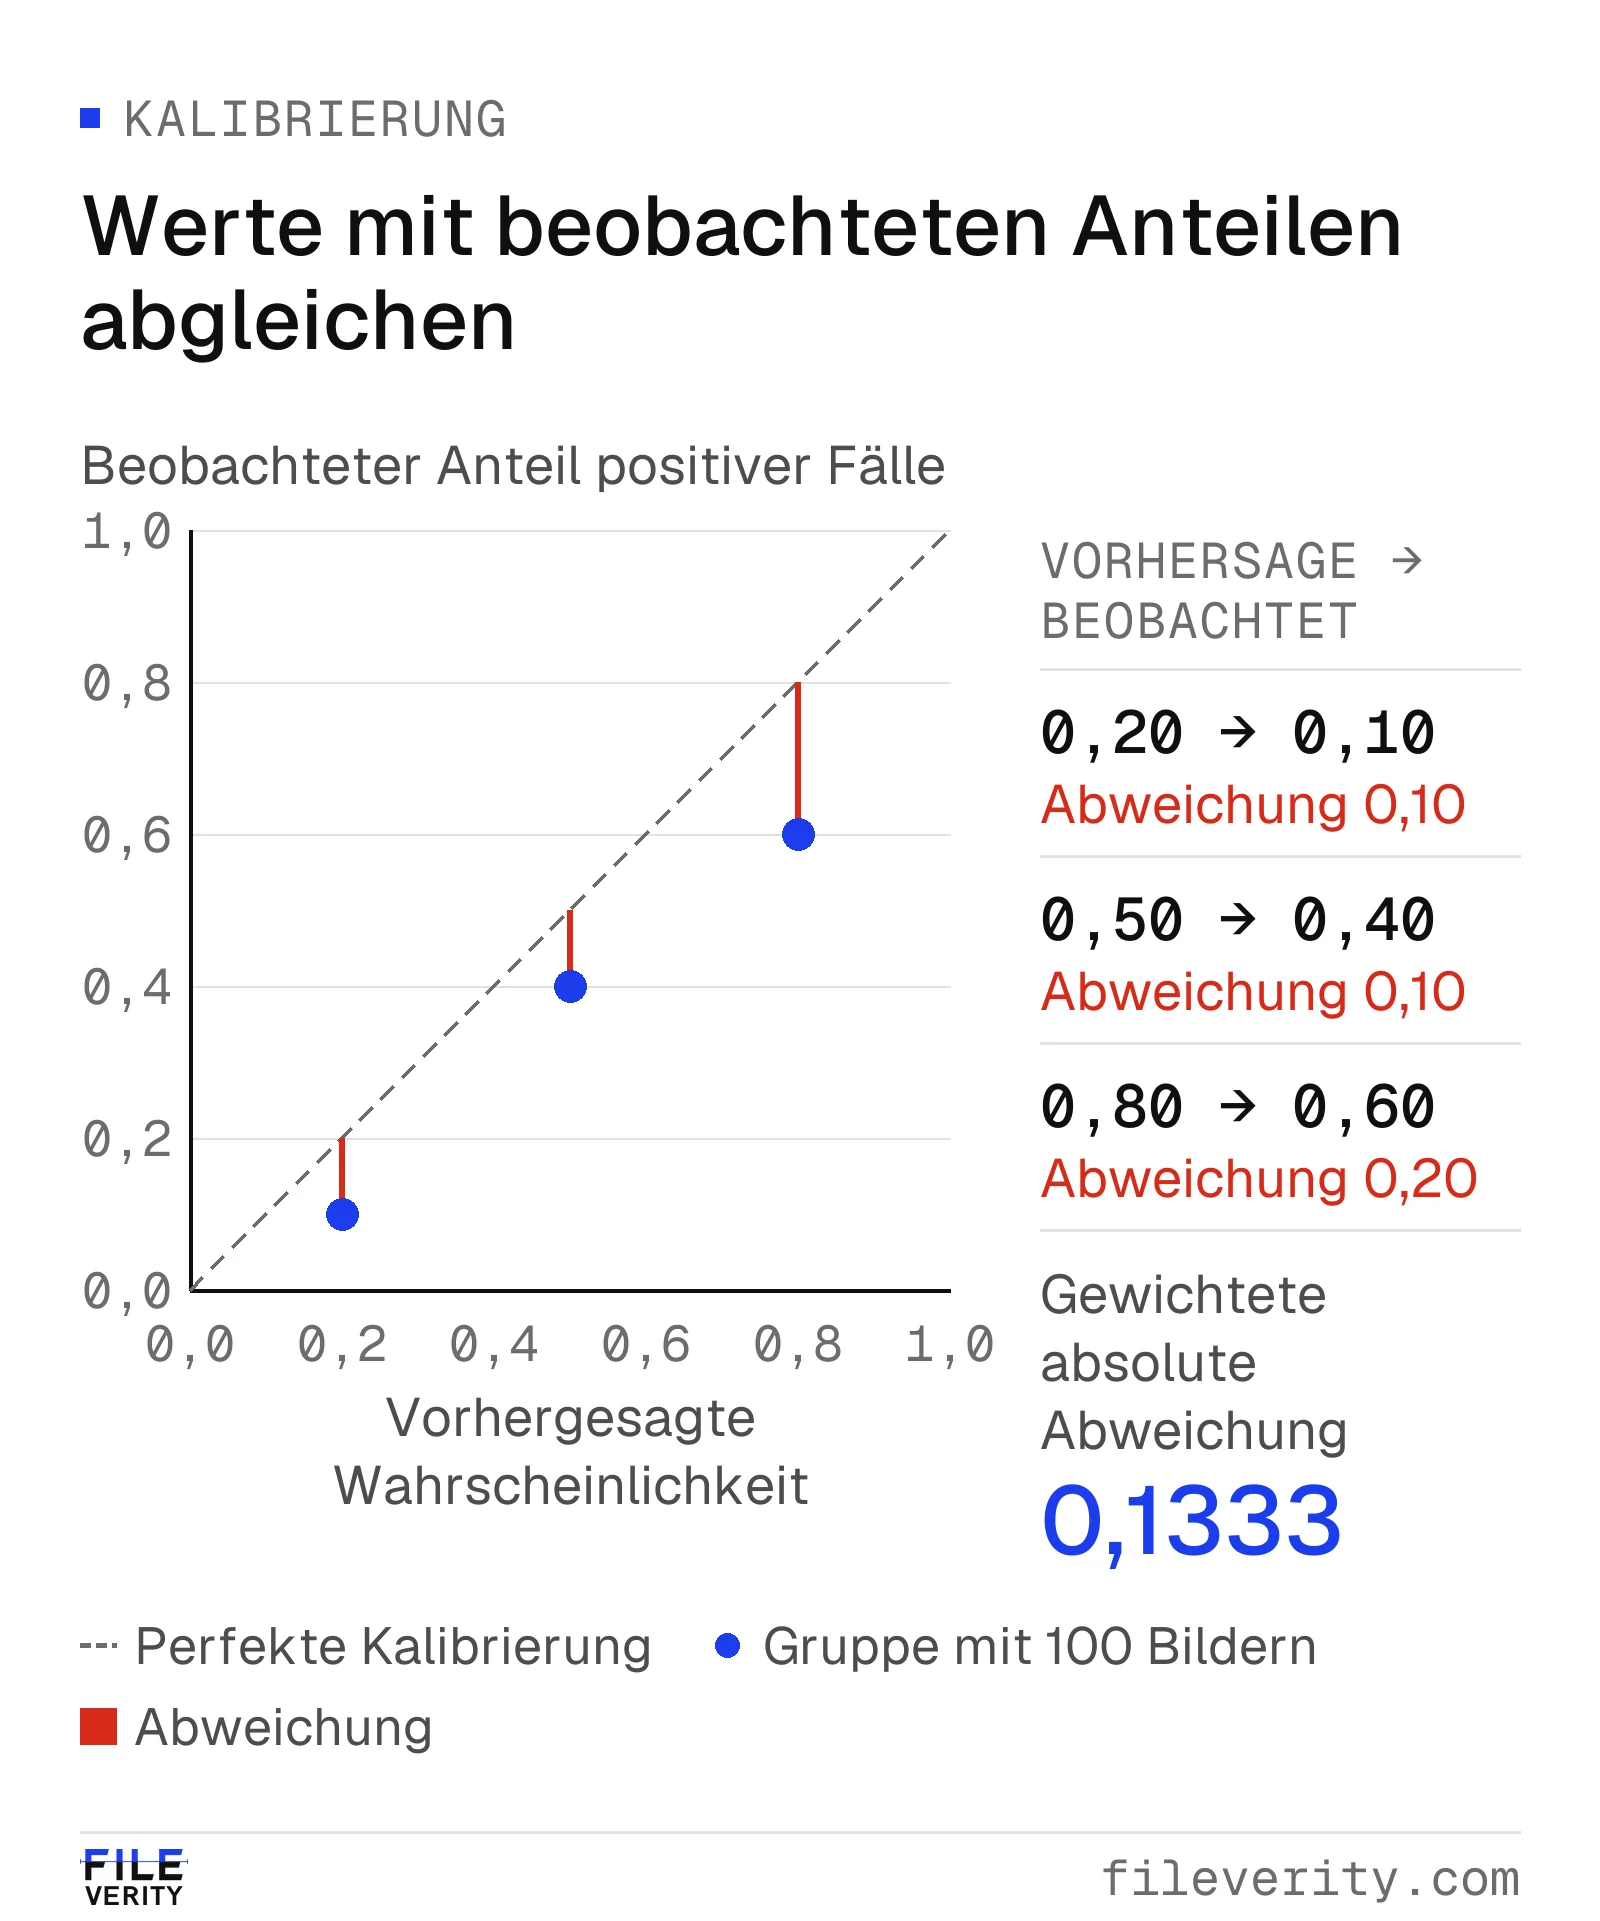
Fiktive Kalibrierungsdaten mit je 100 Bildern pro Gruppe: Die Vorhersagen liegen 10, 10 und 20 Prozentpunkte über den beobachteten Anteilen.
Warum kann sich die Kalibrierung verbessern, ohne dass die Trennschärfe steigt? Eine streng monoton steigende Umrechnung der Werte erhält die Reihenfolge aller Bildpaare. Eine Rangkennzahl wie die ROC-AUC bleibt daher gleich, während sich die Wahrscheinlichkeitswerte den beobachteten Häufigkeiten annähern können. Der Zahlenwert des Schwellenwerts für dieselben Entscheidungen ändert sich dabei. Fragen Sie deshalb nach Belegen für beides: für Rangfolge und Fehler am Arbeitspunkt und für die Deutung als Wahrscheinlichkeit.
Kalibrierung hängt außerdem von der geprüften Bildmenge ab. Ovadia und Kollegen zeigen, dass übliche nachträgliche Kalibrierung bei einer Verschiebung der Datenverteilung nicht ausreicht (Ovadia et al., NeurIPS 2019). Passen Sie eine Kalibrierung getrennt von der finalen Abnahmestichprobe an und prüfen Sie wichtige Eingangskanäle einzeln. Fragen Sie auch bei uns nach der Definition der Berichtswerte und prüfen Sie die Kalibrierung auf Ihren eigenen Eingangskanälen in einem Pilotprojekt.
Generalisierbarkeit: Warum neue Generatoren die Zahlen verschieben
Eine gemessene Trefferquote gilt für die Generatoren, Bildquellen und Bearbeitungswege der Testmenge. Das BSI nennt die mangelhafte Generalisierbarkeit ein zentrales Problem der meisten Detektionsmethoden: Sie funktionieren häufig nur unter bestimmten Rahmenbedingungen zuverlässig. Gegenmaßnahmen bieten nach Einschätzung des BSI in der Regel keinen vollständigen Schutz und sollten kombiniert werden (BSI, Deepfakes – Gefahren und Gegenmaßnahmen; die Seite ist undatiert und wurde am 28.10.2026 abgerufen).
Die Forschung testet die Übertragbarkeit auf andere Generatoren gerade deshalb ausdrücklich, weil Erfolg bei einer Quelle keine allgemeine Abdeckung belegt (Wang et al., CVPR 2020). Für Ihre Bewertung heißt das: Fragen Sie, welche Generatoren und Versionen getestet wurden, wann, und wie die Leistung auf Generatoren ausfällt, die bei der Entwicklung nicht verwendet wurden. Ein Ergebnis ohne Datum und Generatorliste ist für eine Beschaffungsentscheidung kaum verwertbar.
Unsichere und nicht unterstützte Bilder im Nenner behalten
Ein Detektor kann sich enthalten, ein Format ablehnen, in eine Zeitüberschreitung laufen oder vor geringer Bildqualität warnen. Diese Ergebnisse brauchen eigene Zählungen. Wer sie herausrechnet, lässt ein System gerade deshalb zuverlässig aussehen, weil die schwierigsten Fälle verschwunden sind.
Ein weiteres fiktives Beispiel: 1.000 Einreichungen, davon erhalten 850 eine verwertbare Einstufung, 100 ein unsicheres Ergebnis und 50 scheitern technisch. Die Abdeckung beträgt 850 / 1.000 = 85 %. Sind 833 Einstufungen richtig, liegt die Genauigkeit unter den eingestuften Bildern bei 833 / 850 = 98 %. Über alle Einreichungen erhielten 83,3 % eine richtige Einstufung; das ist eine beschreibende Kennzahl unter Einbezug der Abdeckung, keine Genauigkeit im üblichen Sinn. Die übrigen 150 sind ungeklärt – weder automatisch falsch noch automatisch unauffällig.
Weisen Sie Genauigkeit und Abdeckung immer gemeinsam aus und schlüsseln Sie die Abdeckung nach bekanntem Label und Eingangskanal auf. Manche Systeme enthalten sich bei positiven Fällen häufiger. Berichten Sie deshalb die Trefferquote einmal mit ausdrücklicher Behandlung der Enthaltungen und einmal nur über die eingestuften Fälle, damit sichtbar wird, was jeder Nenner ausschließt. Legen Sie einen Ersatzweg für ungeklärte Dateien fest und planen Sie ihn in den Prüfaufwand ein. Bei Fileverity lautet ein solches Ergebnis in der Analyse „Nicht bestimmbar“; es ist ein eigener Ausgang und kein verdeckter Freispruch.
Eine repräsentative, unberührte Testmenge aufbauen
Eine Bewertung braucht belastbare Labels und einen Stichprobenplan. Verwenden Sie Material, das Sie nutzen dürfen und dessen Herkunft dokumentiert ist: kontrolliert erzeugte KI-Bilder, Kamera-Originale mit bekanntem Aufnahmeverlauf und gegebenenfalls separat gelabelte Bearbeitungen. Das Urteil eines anderen Detektors ist keine Referenz. Strittige Labels bleiben als ungeklärt stehen, und die Regel zur Klärung wird dokumentiert.
Bilden Sie die Dateien ab, die tatsächlich bei Ihnen eingehen, nicht nur makellose Originale: Kanäle, Bildgrößen, Motivkategorien und übliche Übertragungswege, etwa Bilder aus Messengern oder Screenshots. Was dabei an Bildinformation verloren geht, erklärt der Ratgeber Screenshots und komprimierte Bilder prüfen. Halten Sie Varianten desselben Ausgangsbilds beim Aufteilen zusammen; sonst gelangt dieselbe Szene sowohl in die Feinabstimmung als auch in die Bewertung. Trennen Sie, wo möglich, auch Aufnahmeserien und Quellsammlungen.
Wählen Sie Schwellenwerte auf einer Entwicklungsmenge und prüfen Sie die gewählte Einstellung genau einmal auf einer getrennten Testmenge. Führt ein Fehlschlag zu Änderungen, gilt die Testmenge als verbraucht, und die überarbeitete Einstellung braucht eine neue, unberührte Testmenge. Fragen Sie bei proprietären Diensten nach bekannten Überschneidungen mit öffentlichen Benchmarks und halten Sie fest, welche Überschneidungen mit Trainingsdaten sich nicht prüfen lassen.
Ergänzen Sie eine bewusst schwierige Prüfmenge, berichten Sie sie aber getrennt von der repräsentativen Stichprobe. Sonst wirkt die Überrepräsentation ungewöhnlicher Fälle wie eine normale Prävalenz.
Abnahmekriterien vor dem Blick auf die Ergebnisse festlegen
Schreiben Sie ein Bewertungsprotokoll, das jede Kennzahl mit der Entscheidung verknüpft, die sie stützen soll.
Beispielhafte Abnahmekriterien für einen Prozess, der Bilder zur manuellen Prüfung weiterleitet.
| Punkt | Beispielkriterium oder Eintrag |
|---|---|
| Vorgesehener Einsatz | Weiterleitung zur manuellen Prüfung; keine automatische nachteilige Entscheidung |
| Eingefrorene Konfiguration | Dienstversion, Schwellenwert, Definition des Werts und Vorverarbeitung festgehalten |
| Fehlalarme | Einseitige obere 95-%-Konfidenzgrenze der Falsch-positiv-Rate höchstens 1 % |
| Erkennung | Einseitige untere 95-%-Konfidenzgrenze der Trefferquote mindestens 85 % |
| Abdeckung | Mindestens 95 % eingestuft; jede ungeklärte Datei hat einen Ersatzweg |
| Kapazität | Prüf- und Ersatzaufwand passt in ein vorab festgelegtes Tagesbudget |
| Teilgruppen | Kritische Eingangskanäle getrennt berichtet; unzureichende Belege bleiben ungeklärt |
| Verantwortung | Namentlich benannte Person dokumentiert Abnahme, Ablehnung oder begrenzten Pilot |
Konfidenzgrenzen verhindern, dass eine kleine, saubere Stichprobe mit Gewissheit verwechselt wird. Bei null Fehlalarmen unter 300 unabhängigen negativen Fällen liegt die exakte einseitige obere 95-%-Grenze der Binomialverteilung bei 1 − 0,05^(1/300), also rund 0,994 %. Bei null unter 100 Fällen sind es rund 2,951 %.
Die Herleitung ist kurz: Ist die Fehlalarmwahrscheinlichkeit p, beträgt die Wahrscheinlichkeit für null Fehlalarme in n unabhängigen negativen Fällen (1 − p)^n. Setzt man das gleich 0,05, ergibt sich die obere Grenze p = 1 − 0,05^(1/n). Null beobachtete Fehler belegen also keine Fehlerquote von null. Die Rechnung setzt unabhängige, repräsentative Fälle voraus; viele fast identische Fotos liefern nicht dieselbe Evidenz wie unabhängige Einreichungen.
Die beobachtete Falsch-positiv-Rate von 1 % am mittleren Schwellenwert würde das Kriterium „obere Konfidenzgrenze höchstens 1 %“ nicht erfüllen. Punktschätzung und Unsicherheitsgrenze beantworten verschiedene Fragen. Planen Sie den Stichprobenumfang nach der benötigten Evidenz, bevor Sie die Testmenge zusammenstellen.
Veröffentlichte Fehlerquoten: was Sie erwarten können
Eine offen genannte Fehlerquote mit Bedingungen ist ein Zeichen von Sorgfalt, keine Schwäche. Eine belastbare Angabe nennt Modellversion, Datum, Stichprobengröße, Konfidenzintervall und die Fälle, in denen die Erkennung schwächer ist.
Fileverity belegt Bildbefunde und Dokumentbefunde auf unterschiedliche Weise:
- Bilder: Die Bildanalyse weist je Datei aus, welche Belegkategorien angeschlagen haben, wie stark die Belege sind und welche Risikostufe (L0 bis L5) sich daraus ergibt; reichen die Belege nicht aus, lautet das Ergebnis „Nicht bestimmbar“. Welche Erkennungs- und Fehlalarmquoten sich auf Ihrem eigenen Material ergeben, gehen wir gemeinsam mit Ihrem Team an echten Fällen nach den oben beschriebenen Kriterien durch.
- Dokumente: Für die Textanalyse mit FVDOC V3 stehen Fehlalarm- und Erkennungsquoten je Sprache und Dokumenttyp öffentlich. Bei von Menschen verfassten deutschen Texten lag die Fehlalarmquote in der Validierung vom Oktober 2026 bei 0,2 %. Die Werte für weitere Bedingungen stehen dort mit derselben Offenheit.
Die Dokumentwerte gelten nur für Texte und lassen sich nicht auf Bilder übertragen. Sie zeigen aber, welche Bedingungen zu einer Fehlerquote gehören: Details auf der Seite Zuverlässigkeit der Dokumentprüfung.
Drift überwachen und Befunde sauber formulieren
Beobachten Sie nach der Einführung Markierungsquote, Anteil ungeklärter Ergebnisse, Kanalmix, Prüfzeit und unabhängig bestätigte Ergebnisse. Eine steigende Markierungsquote allein unterscheidet nicht zwischen mehr KI-Bildern und mehr Fehlalarmen. Ziehen Sie auch Stichproben aus nicht markierten Bildern; wer nur Markierungen prüft, sieht übersehene KI-Bilder kaum. Berücksichtigen Sie die Auswahlwahrscheinlichkeiten, wenn Sie aus bewusst überrepräsentierten Gruppen auf den gesamten Eingang schließen.
Dokumentieren Sie Änderungen an Modell, Schwellenwert und Eingangsprozess. Bewerten Sie nach wesentlichen Änderungen neu und behalten Sie regelmäßige gelabelte Kontrollen bei, auch wenn die Durchschnittswerte stabil wirken. Ein neuer Generator, ein neuer Einreichungskanal oder eine neue Motivkategorie kann die Leistung verändern, ohne dass ein Gesamtwert auffällt.
Trennen Sie im Prüfprotokoll Beobachtung und Entscheidung. „Das Bild hat den Prüfschwellenwert überschritten“ ist eine Beobachtung. „Das stützt einen Verdacht auf KI-Generierung“ ist eine Schlussfolgerung. Ein bestätigtes Original oder ein dokumentierter Entstehungsverlauf ist eine Absicherung. Diese Unterlagen anzufordern ist eine Maßnahme. Keine dieser Aussagen belegt für sich einen Betrug oder die Wahrheit der abgebildeten Szene. Die Entscheidung trifft Ihr Fachteam.
Anfrage an Anbieter (zum Kopieren)
Fordern Sie so viel Information an, dass sich das behauptete Ergebnis mit Ihrem Eingang und Ihrer nächsten Maßnahme verbinden lässt. Die folgende Anfrage können Sie in ein Anbietergespräch übernehmen:
Wir müssen [vollständige KI-Generierung / lokale Bearbeitung / eine andere definierte Aufgabe] bei [Dateiformaten, Eingangskanälen und Qualitätsbedingungen] bewerten. Ein Befund löst [Prüfmaßnahme] aus, bei etwa [Bildern und Fällen pro Tag]. Unsere Prüfkapazität beträgt [Arbeitsstunden oder Fälle pro Tag].
Bitte nennen Sie die bewertete Produktversion und die Definition des ausgegebenen Werts; Herkunft der Labels und Anzahl positiver und negativer Fälle; alle vier Felder der Konfusionsmatrix am vorgeschlagenen Arbeitspunkt; Konfidenzintervalle; getrennte Zählungen für nicht eindeutige, nicht unterstützte und fehlgeschlagene Eingaben; die getesteten Generatoren mit Testdatum. Geben Sie an, welche Dateien aus welcher Kennzahl ausgeschlossen wurden, wie sich Abdeckung und Trefferquote ändern, wenn sie einbezogen werden, und ob Varianten desselben Ausgangsbilds sowohl in der Feinabstimmung als auch in der Bewertung vorkamen.
Bitte benennen Sie, welche Belege für diesen Einsatz gelten, welche Bedingungen ungetestet sind und was ein Pilotprojekt klären müsste.
Nächste Schritte
Fileverity ist für die Bildprüfung auf KI-Generierung, Manipulation und Herkunft ausgelegt. Wie die Analyse aufgebaut ist und was ein Bericht enthält, zeigt die Seite Funktionsweise. Für die gesamte Kaufentscheidung, einschließlich Datenverarbeitung und Prüfkosten in Euro, lesen Sie weiter mit Software zur Erkennung von KI-Bildern auswählen. Wie Sie ein einzelnes Bild Schritt für Schritt einordnen, beschreibt der Ratgeber Wie erkennt man, ob ein Bild KI-generiert ist?.
Datenschutz: Ihre Dateien werden nach der Analyse gelöscht und nie zum Training genutzt; die Analyse läuft auf von Entogo betriebenen Servern in Toronto, Kanada, und Enterprise-Kunden erhalten auf Anfrage eine private Bereitstellung. Alle Verarbeitungsorte stehen unter Sicherheit und Datenschutz, den Vertrag nach Art. 28 DSGVO finden Sie unter Auftragsverarbeitung.
Wenn Sie die Anfrage oben zu Arbeitspunkt, Abdeckung und Belegen stellen möchten, schreiben Sie unserem Team und nennen Sie Ihre Eingangskanäle und die Maßnahme, die ein Befund auslösen soll.
Von Yang Zheng · Geprüft von Bill Liu