Évaluer les outils de vérification
Choisir un logiciel de détection d’images IA : critères, pilote et cahier des charges
Critères éliminatoires, essai pilote, coût de la file d’examen, RGPD et sous-traitance : une grille d’achat fondée sur des éléments vérifiables.
Publié le · Mis à jour le · 21 min de lecture
Dans cet article
Pour choisir un logiciel de détection d’images IA, partez d’une décision concrète : quel fichier faut-il examiner, quel doute faut-il lever et quelle suite donner au résultat ? Testez ensuite l’outil sur les fichiers que votre équipe reçoit réellement. Les résultats doivent être compréhensibles, le volume d’alertes gérable et les cas non évaluables clairement orientés. Vérifiez la couverture, la protection des données et les conditions de traitement avant de comparer les scores d’un pilote.
Procédez en trois étapes plutôt que de commencer par un grand banc d’essai :
- Analyse documentaire : confirmer les tâches requises, les formats pris en charge, les conditions de traitement des données et l’accès au produit ou à l’offre envisagés. Écarter les inadéquations manifestes avant de transmettre le moindre fichier.
- Échantillon d’usage autorisé : soumettre un petit nombre de fichiers représentatifs, dont l’usage est permis, pour voir si les analystes comprennent les résultats et savent quelle suite donner. C’est un test d’adéquation, pas une estimation de performance.
- Évaluation formelle : tester les candidats restants sur des étiquettes établies de façon indépendante, avec des limites d’erreur convenues et la même charge de travail. La grille et la comparaison des coûts ci-dessous servent à consigner la décision.
La demande d’informations proposée à la fin permet de soumettre ces exigences aux fournisseurs présélectionnés, dans un cahier des charges ou une consultation.
Partir de la décision que le logiciel doit éclairer
Rédigez une exigence qui nomme les fichiers concernés, la question posée et l’action suivante. Par exemple : « Trier les photos d’état de produit pour repérer d’éventuelles modifications de contenu, puis transmettre les cas signalés ou non résolus à un analyste formé, habilité à demander le fichier d’origine. » Une telle phrase se teste. « Détecter les fausses images » ne se teste pas.
Définissez ce qui pose problème avant de qualifier un cas de positif : un usage autorisé de l’IA et des retouches courantes peuvent être acceptables. Savoir si un vendeur est de bonne foi, ou si l’événement photographié s’est produit comme décrit, exige un contexte et des recoupements qui dépassent un score de détecteur.
Précisez s’il faut repérer des images entièrement générées, localiser des retouches, examiner des données de provenance ou combiner ces tâches. Une photo comportant une zone régénérée est un cas d’évaluation différent d’une scène entièrement générée. Une photo authentique utilisée dans une transaction trompeuse peut passer les deux contrôles alors que la transaction mérite encore une instruction.
Le rapport NIST AI 100-4 (novembre 2024) distingue le suivi des données de provenance de la détection des contenus synthétiques, et précise qu’aucune de ces techniques n’offre à elle seule une solution complète : leur valeur dépend du cas d’usage. Cette distinction aide à délimiter le périmètre de l’achat. NIST AI 100-4, sections 1 et 3
Consignez les formats attendus, les canaux de réception, la qualité des fichiers, le volume quotidien et la sensibilité des fichiers. Incluez les complications ordinaires : images téléchargées depuis une messagerie, captures d’écran. Désignez un responsable de la file d’examen qui en résultera. Si personne ne peut donner suite à un signalement, la fonction la plus impressionnante du produit n’aura guère de valeur opérationnelle.
Analyse documentaire : séparer l’indispensable de l’accessoire
Demandez à chaque fournisseur de remplir la même matrice de couverture, avec une réponse datée et rattachée à l’offre et à la version proposées. Chaque fonction est qualifiée de disponible, limitée, non prise en charge ou prévue ; un engagement de feuille de route ne satisfait pas une exigence actuelle.
| Tâche requise | Élément à demander | Limite à clarifier |
|---|---|---|
| Images entièrement générées | Évaluation sur des images générées et des photos d’origine documentée | Quelles familles d’images et quelles conditions ont été testées ? |
| Modifications locales du contenu | Résultats séparés sur des images aux zones retouchées documentées | L’outil détecte-t-il une modification, la localise-t-il, ou les deux ? |
| Examen de la provenance | Exemple de résultat de validation et formats pris en charge | L’outil valide-t-il signatures et liens au contenu, ou affiche-t-il seulement les métadonnées ? |
| Attribution du générateur | Évaluation étayant chaque catégorie de source annoncée | Sait-il s’abstenir face à une source inconnue ? |
| Fichiers non pris en charge | États documentés et exemples | Un échec produit-il un état explicite plutôt qu’un score rassurant ? |
| Intégration à l’examen | Interface, export ou documentation d’API disponibles | Vos analystes peuvent-ils conserver le lien entre fichier et résultat ? |
Pour la provenance, « identifiants trouvés » et « identifiants validés » sont deux constats différents. Demandez quels contrôles de validation sont effectués et comment sont présentés les historiques absents, invalides ou émis par un signataire non reconnu. La note explicative (Explainer) C2PA 2.2 décrit les Content Credentials comme une structure qui rend toute altération détectable, et précise qu’ils ne portent aucun jugement sur la véracité des informations de provenance. Explainer C2PA 2.2 Le guide C2PA, filigranes IA et détecteurs d’images détaille ces niveaux de validation.
Évaluez les fonctions qui répondent à votre exigence avant de noter les fonctions accessoires. Une carte de chaleur soignée ne compense pas des formats non pris en charge, et une longue liste de générateurs reconnus ne démontre rien sur la détection des retouches locales.
Pour Fileverity, commencez par le périmètre de la vérification d’images, les informations sur la sécurité et le traitement des données et les tarifs. Le service est conçu pour examiner la génération par IA, les retouches et la provenance ; votre matrice de couverture établit quels contrôles et quelles modalités d’accès conviennent à la tâche visée. L’API, le traitement par lots, l’intégration à vos systèmes et le déploiement privé relèvent d’un contrat Entreprise, sur demande : confirmez ces besoins avec l’équipe plutôt que de les déduire d’un intitulé de catégorie.
Poser des critères éliminatoires avant toute note pondérée
Certaines exigences doivent suspendre l’achat tant qu’elles ne sont pas satisfaites : utilisation des fichiers transmis pour l’entraînement, lieu de traitement incompatible avec votre politique, types de fichiers critiques non pris en charge, absence de voie praticable pour les cas incertains. C’est votre organisation qui fixe ces critères. Une bonne note de détection ne doit pas compenser un critère de traitement des données non satisfait.
Une fois les critères éliminatoires franchis, une grille pondérée structure la comparaison. Les pondérations ci-dessous constituent un point de départ pour un processus fondé sur l’examen humain ; ajustez-les avant de connaître les résultats des fournisseurs.
| Critère | Poids | Éléments nécessaires pour une bonne note |
|---|---|---|
| Couverture des tâches | 25 | Tâches requises démontrées sur des fichiers pertinents ; limites documentées |
| Qualité de l’évaluation | 25 | Étiquettes indépendantes, dénominateurs, erreurs et fichiers non résolus déclarés |
| Ergonomie pour les analystes | 20 | Les analystes interprètent les résultats et consignent une suite justifiée |
| Fiabilité opérationnelle | 15 | Échecs, délais, capacité et changements de version gérés de façon prévisible |
| Gouvernance des données | 10 | Conditions approuvées et traitement documenté des fichiers et données dérivées |
| Coût total d’exploitation | 5 | Coûts modélisés sur la même charge, examen humain compris |
Notez chaque ligne de zéro à quatre : zéro, aucun élément ; un, une affirmation écrite ; deux, une démonstration ou une documentation partielle ; trois, des éléments que votre équipe a confrontés à ses exigences ; quatre, des éléments qui satisfont la condition d’acceptation convenue à l’avance. Fondez les notes de performance et d’ergonomie sur le pilote, et les autres sur la documentation contractuelle ou opérationnelle examinée. Calculez les points par poids × note ÷ 4, puis additionnez-les, pour un maximum de 100. Consignez l’élément et la réserve à côté de chaque note.
Le total est un support de discussion. Ne convertissez pas une information manquante en note moyenne neutre et ne fixez pas de seuil de réussite universel. Un candidat peut obtenir un total élevé tout en échouant sur une tâche obligatoire : consignez cet échec explicitement, puis reportez l’achat ou réduisez le périmètre visé.
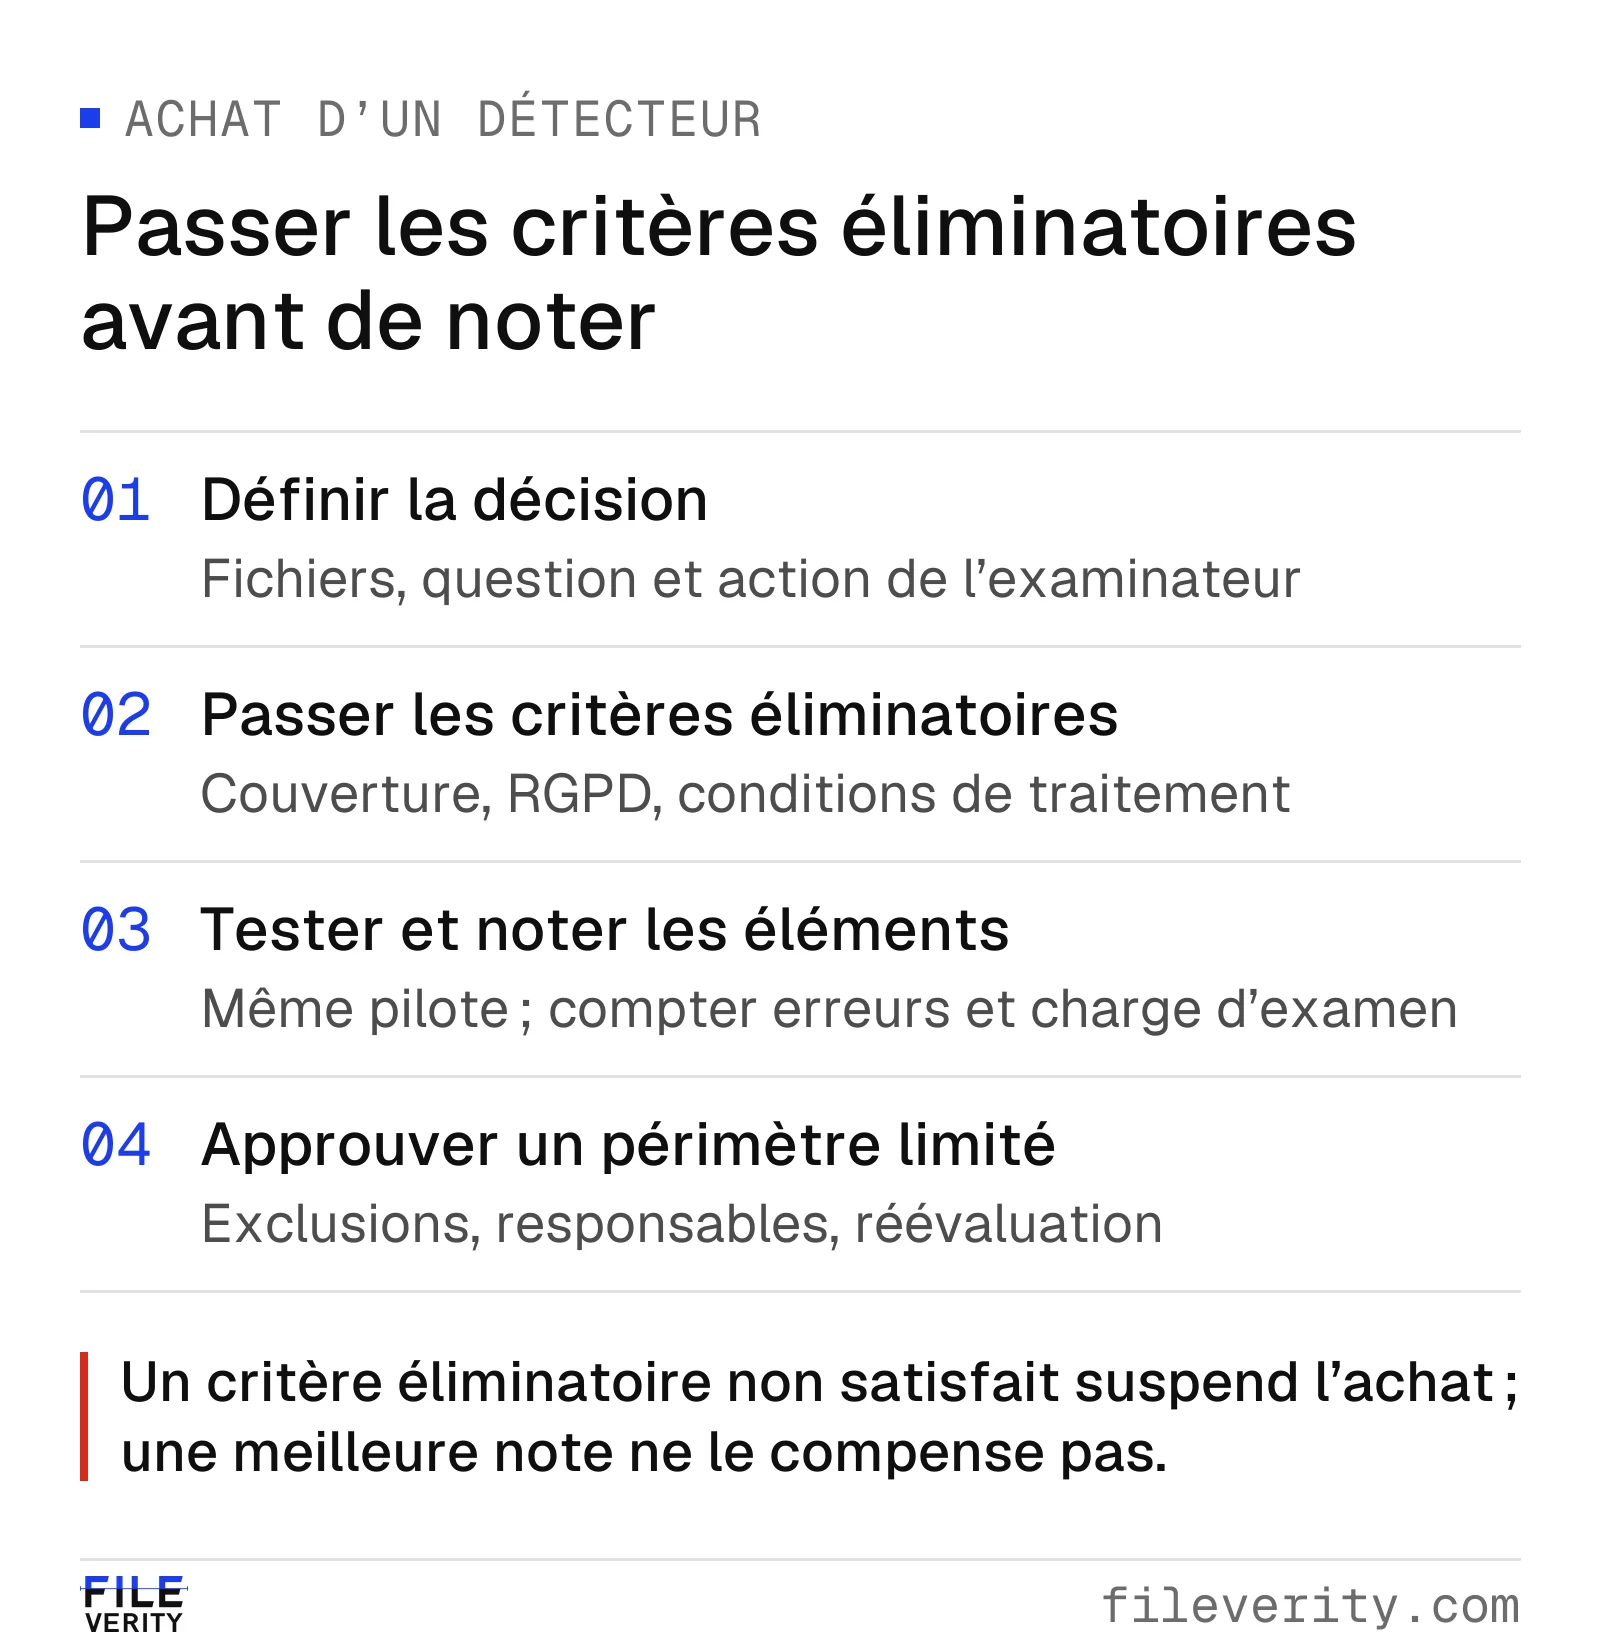
Réglez les exigences obligatoires avant de noter les candidats. Un critère éliminatoire non satisfait suspend l’achat, quelle que soit la note pondérée.
Les critères éliminatoires du contexte européen : RGPD et AI Act
Les photos de sinistre, les pièces d’entrée en relation ou les images de clients contiennent souvent des données personnelles. Dans ce cas, le fournisseur du service de détection agit en principe comme sous-traitant, et plusieurs critères éliminatoires découlent directement du RGPD. Ce qui suit oriente les questions à poser ; la qualification juridique du traitement revient à votre DPO et à votre conseil.
Sous-traitance et accord de traitement des données
L’article 28 du RGPD impose au responsable du traitement de ne faire appel qu’à des sous-traitants présentant des garanties suffisantes, et exige un contrat ou un autre acte juridique. Ce contrat prévoit notamment un traitement sur instruction documentée, la confidentialité des personnes autorisées, l’encadrement de la sous-traitance ultérieure, la suppression ou le renvoi des données au terme de la prestation et la mise à disposition des informations permettant les audits. RGPD, article 28, sur le site de la CNIL Demandez l’accord de traitement des données, la liste des sous-traitants ultérieurs avec leur rôle et leur localisation, et les règles de conservation par catégorie de données.
Pour Fileverity, les fichiers sont supprimés après l’analyse et ne servent pas à entraîner les modèles, et l’accord de traitement des données est proposé aux clients professionnels ; un déploiement privé est possible sur demande pour les clients Entreprise. Les lieux de traitement (analyse à Toronto, stockage temporaire à Montréal, application et base de données aux États-Unis), la liste des sous-traitants ultérieurs et l’encadrement des transferts hors de l’Union figurent sur la page Sécurité et dans l’accord de traitement, pour examen par votre DPO.
Analyse d’impact et décisions automatisées
Une analyse d’impact relative à la protection des données (AIPD) est requise lorsqu’un traitement est susceptible d’engendrer un risque élevé pour les droits et libertés des personnes. CNIL, l’analyse d’impact relative à la protection des données Le recours à un détecteur pour trier des dossiers de clients peut relever de cette analyse selon le contexte : intégrez-la au calendrier d’achat plutôt que de la découvrir après le pilote.
L’article 22 du RGPD donne à la personne concernée le droit de ne pas faire l’objet d’une décision fondée exclusivement sur un traitement automatisé produisant des effets juridiques ou l’affectant de manière significative de façon similaire. RGPD, article 22, sur le site de la CNIL Si un signalement peut conduire à un refus ou à une suspension, prévoyez dans le processus l’intervention d’un analyste habilité. Fileverity suit ce modèle : chaque niveau de risque est assorti d’une action recommandée, et la décision revient à votre propre processus d’examen.
Ce que l’AI Act impose, et à qui
Les obligations de transparence de l’article 50 du règlement européen sur l’IA s’appliquent depuis le 2 août 2026. Elles visent les fournisseurs de systèmes d’IA générative, dont les contenus produits doivent être marqués dans un format lisible par machine et détectables comme générés ou manipulés artificiellement, et les déployeurs, tenus de signaler notamment les hypertrucages (deepfakes). Le code de bonnes pratiques qui accompagne ces obligations est volontaire ; les obligations, elles, sont légales. Commission européenne, code de bonnes pratiques sur la transparence des contenus générés par IA
Pour un acheteur, la conséquence est double. Davantage d’images reçues porteront des marquages qu’un outil doit savoir lire. Un outil de détection aide à vérifier les contenus reçus, tandis que les obligations de l’article 50 pèsent sur les fournisseurs et les déployeurs de systèmes génératifs. Méfiez-vous d’une offre présentée comme une « mise en conformité AI Act ».
Tester un petit échantillon autorisé avant le pilote formel
Une fois que l’analyse documentaire a validé les conditions de transmission des fichiers, choisissez un petit échantillon autorisé comprenant des fichiers ordinaires, un cas présentant une préoccupation connue et un fichier peut-être inadapté. Écartez les données sensibles tant que leur traitement n’est pas approuvé. L’objectif est de repérer à moindre coût les inadéquations évidentes, non de communiquer un taux de réussite établi sur une poignée d’images.
Demandez aux futurs analystes d’utiliser l’interface ou l’intégration qu’ils recevront réellement. Savent-ils identifier le fichier, expliquer le résultat, distinguer un résultat non concluant d’un résultat négatif et rédiger la demande de pièce suivante ? Notez les incompréhensions et le temps passé. Si l’interface ou la prise en charge des fichiers échoue à ce stade, réglez ce problème avant d’investir dans une comparaison formelle.
Demander ce qu’un chiffre d’exactitude a réellement mesuré
Demandez la population testée, la définition des étiquettes, le seuil, la version du produit et les dénominateurs. Le mot « exactitude » peut masquer un échantillon composé surtout de photos ou surtout d’images générées. Demandez séparément combien de cas positifs pertinents ont été signalés, combien de cas légitimes l’ont été à tort et combien de fichiers n’ont reçu aucune évaluation exploitable.
Les travaux publiés montrent pourquoi le périmètre compte. L’étude CIFAKE évalue une tâche de classification binaire précise, des images réelles opposées à des images produites par diffusion latente selon les classes de CIFAR-10. Son résultat renseigne sur cette expérience ; il ne mesure pas un service commercial sur des photos de clients, des retouches locales ou des processus inconnus. Bird et Lotfi, CIFAKE
Pour chaque chiffre d’un fournisseur, obtenez de quoi reconstituer l’affirmation : effectifs de positifs et de négatifs, effectifs d’erreurs, traitement des fichiers exclus. Demandez si des variantes d’une même image source figuraient à la fois dans les données de développement et dans celles d’évaluation. Si le fournisseur ne peut pas communiquer son jeu de données, demandez une description suffisante pour en apprécier la pertinence et conservez votre propre jeu réservé comme contrôle distinct.
Convenez d’une règle de comparaison commune. Un choix utile est un budget fixe de faux positifs : comparer le rappel que chaque candidat obtient en respectant ce budget. Un autre est un objectif fixe de rappel : comparer le taux de faux positifs et la charge d’examen nécessaires pour l’atteindre. Choisissez la règle avant de voir les résultats finaux et présentez l’incertitude des estimations. Un même seuil numérique appliqué à des services différents ne constitue pas un point de fonctionnement commun, car leurs échelles de score peuvent différer.
Choisissez les seuils sur des données de développement, puis évaluez les réglages figés sur le jeu réservé. Si un service ne permet pas de régler le seuil, évaluez le réglage disponible et indiquez s’il respecte la contrainte retenue, sans laisser entendre que tous les candidats ont été testés au même taux d’erreur. La distinction entre scores et décisions seuillées, et la nécessité de régler le seuil sur des données distinctes, sont exposées dans le guide de scikit-learn sur le réglage du seuil de décision.
Un score de 0,9 ne signifie pas automatiquement 90 % de probabilité qu’une image soit générée. Demandez sa définition et les éléments qui justifient toute interprétation probabiliste. Le guide Fiabilité d’un détecteur d’images IA détaille les dénominateurs, la calibration et les arbitrages de seuil.
Évaluation formelle : un pilote aux étiquettes défendables
Utilisez des fichiers dont l’usage est autorisé et l’origine documentée. Pour les photos, conservez si possible les éléments de prise de vue ou d’acquisition. Pour les exemples générés ou retouchés, conservez l’historique de création et une description de la modification. La prédiction d’un autre détecteur n’est pas une étiquette indépendante. Placez les fichiers d’origine incertaine dans un jeu exploratoire distinct plutôt que de les forcer dans le calcul principal.
Constituez deux ensembles complémentaires. Un jeu de diagnostic comprend délibérément assez d’exemples de chaque tâche importante pour révéler les défaillances. Un échantillon opérationnel reproduit la composition et la qualité du flux réel pour estimer la taille de la file et le temps de traitement. Un jeu de diagnostic équilibré ne doit pas servir à prédire la fréquence réelle des alertes lorsque le flux a une autre composition.
Séparez le choix du seuil de l’évaluation finale. Gardez les images d’origine et leurs variantes dans la même partition, puis figez les fichiers et les réglages avant la comparaison. Donnez aux analystes les mêmes informations de contexte pour tous les candidats, mais masquez les étiquettes attendues jusqu’à ce que leurs appréciations soient consignées. Conservez les sorties brutes des services avant d’en discuter avec les fournisseurs.
Jeu de diagnostic fictif de 1 000 images pour un processus de photos de produits ; ni taille d’échantillon ni composition recommandées.
| Ensemble | Effectif illustratif | Objet |
|---|---|---|
| Photos d’origine documentée | 400 | Mesurer les fausses alertes sur le flux ordinaire |
| Photos avec réglages courants autorisés | 200 | Vérifier si un traitement acceptable déclenche un examen |
| Images entièrement générées | 200 | Mesurer la tâche annoncée sur l’image entière |
| Photos avec retouches locales documentées | 200 | Tester l’exigence distincte de retouche locale |
Étiquetez le format, la source, le sujet et les conditions de transmission de chaque fichier afin d’examiner les sous-groupes importants. Un petit sous-groupe peut révéler un problème sérieux sans permettre d’estimer précisément son taux d’erreur. Une absence d’erreur observée se présente avec son dénominateur, jamais comme la preuve d’un taux d’erreur nul.
Le principe technique : mesurer l’arbitrage entre risque et couverture
Un service peut réduire ses erreurs sur les cas qu’il tranche en laissant les cas difficiles non résolus. Ce choix peut être judicieux, mais il modifie la lecture de l’« exactitude » dans un achat. Le cadre technique est la prédiction sélective : on évalue à la fois la part des cas éligibles qui reçoivent une appréciation définitive et le taux d’erreur parmi ces cas. Ces deux mesures s’appellent la couverture et le risque sélectif, appelé ici erreur sélective. Geifman et El-Yaniv, SelectiveNet, ICML 2019, section 2
Pour un jeu étiqueté, notons N le nombre de cas éligibles, A le nombre de cas recevant une appréciation définitive et E le nombre d’appréciations erronées parmi ces A. Alors couverture = A / N et erreur sélective = E / A. Si A = 0, l’erreur sélective n’est pas définie ; elle ne vaut pas zéro.
Les résultats construits suivants illustrent trois points de fonctionnement sur le même jeu de 1 000 cas. Ils supposent que toutes les requêtes ont abouti et que tous les cas étaient éligibles : les cas non évalués sont donc uniquement des cas incertains.
| Point de fonctionnement illustratif | Appréciations définitives A | Erronées E | Couverture | Erreur sélective | Cas incertains |
|---|---|---|---|---|---|
| Plus sélectif | 500 | 5 | 50 % | 1 % | 500 |
| Intermédiaire | 800 | 24 | 80 % | 3 % | 200 |
| Couverture élargie | 950 | 57 | 95 % | 6 % | 50 |
Le premier point affiche 99 % d’exactitude sur les cas tranchés, mais laisse la moitié des fichiers sans réponse. Passer du point intermédiaire au point élargi ajoute 150 réponses et 33 erreurs dans cet ensemble fictif. Le groupe ajouté présente donc un taux d’erreur de 33 / 150 = 22 %, en supposant des sous-ensembles évalués emboîtés. Ce calcul marginal révèle un arbitrage que les moyennes affichées masquent.
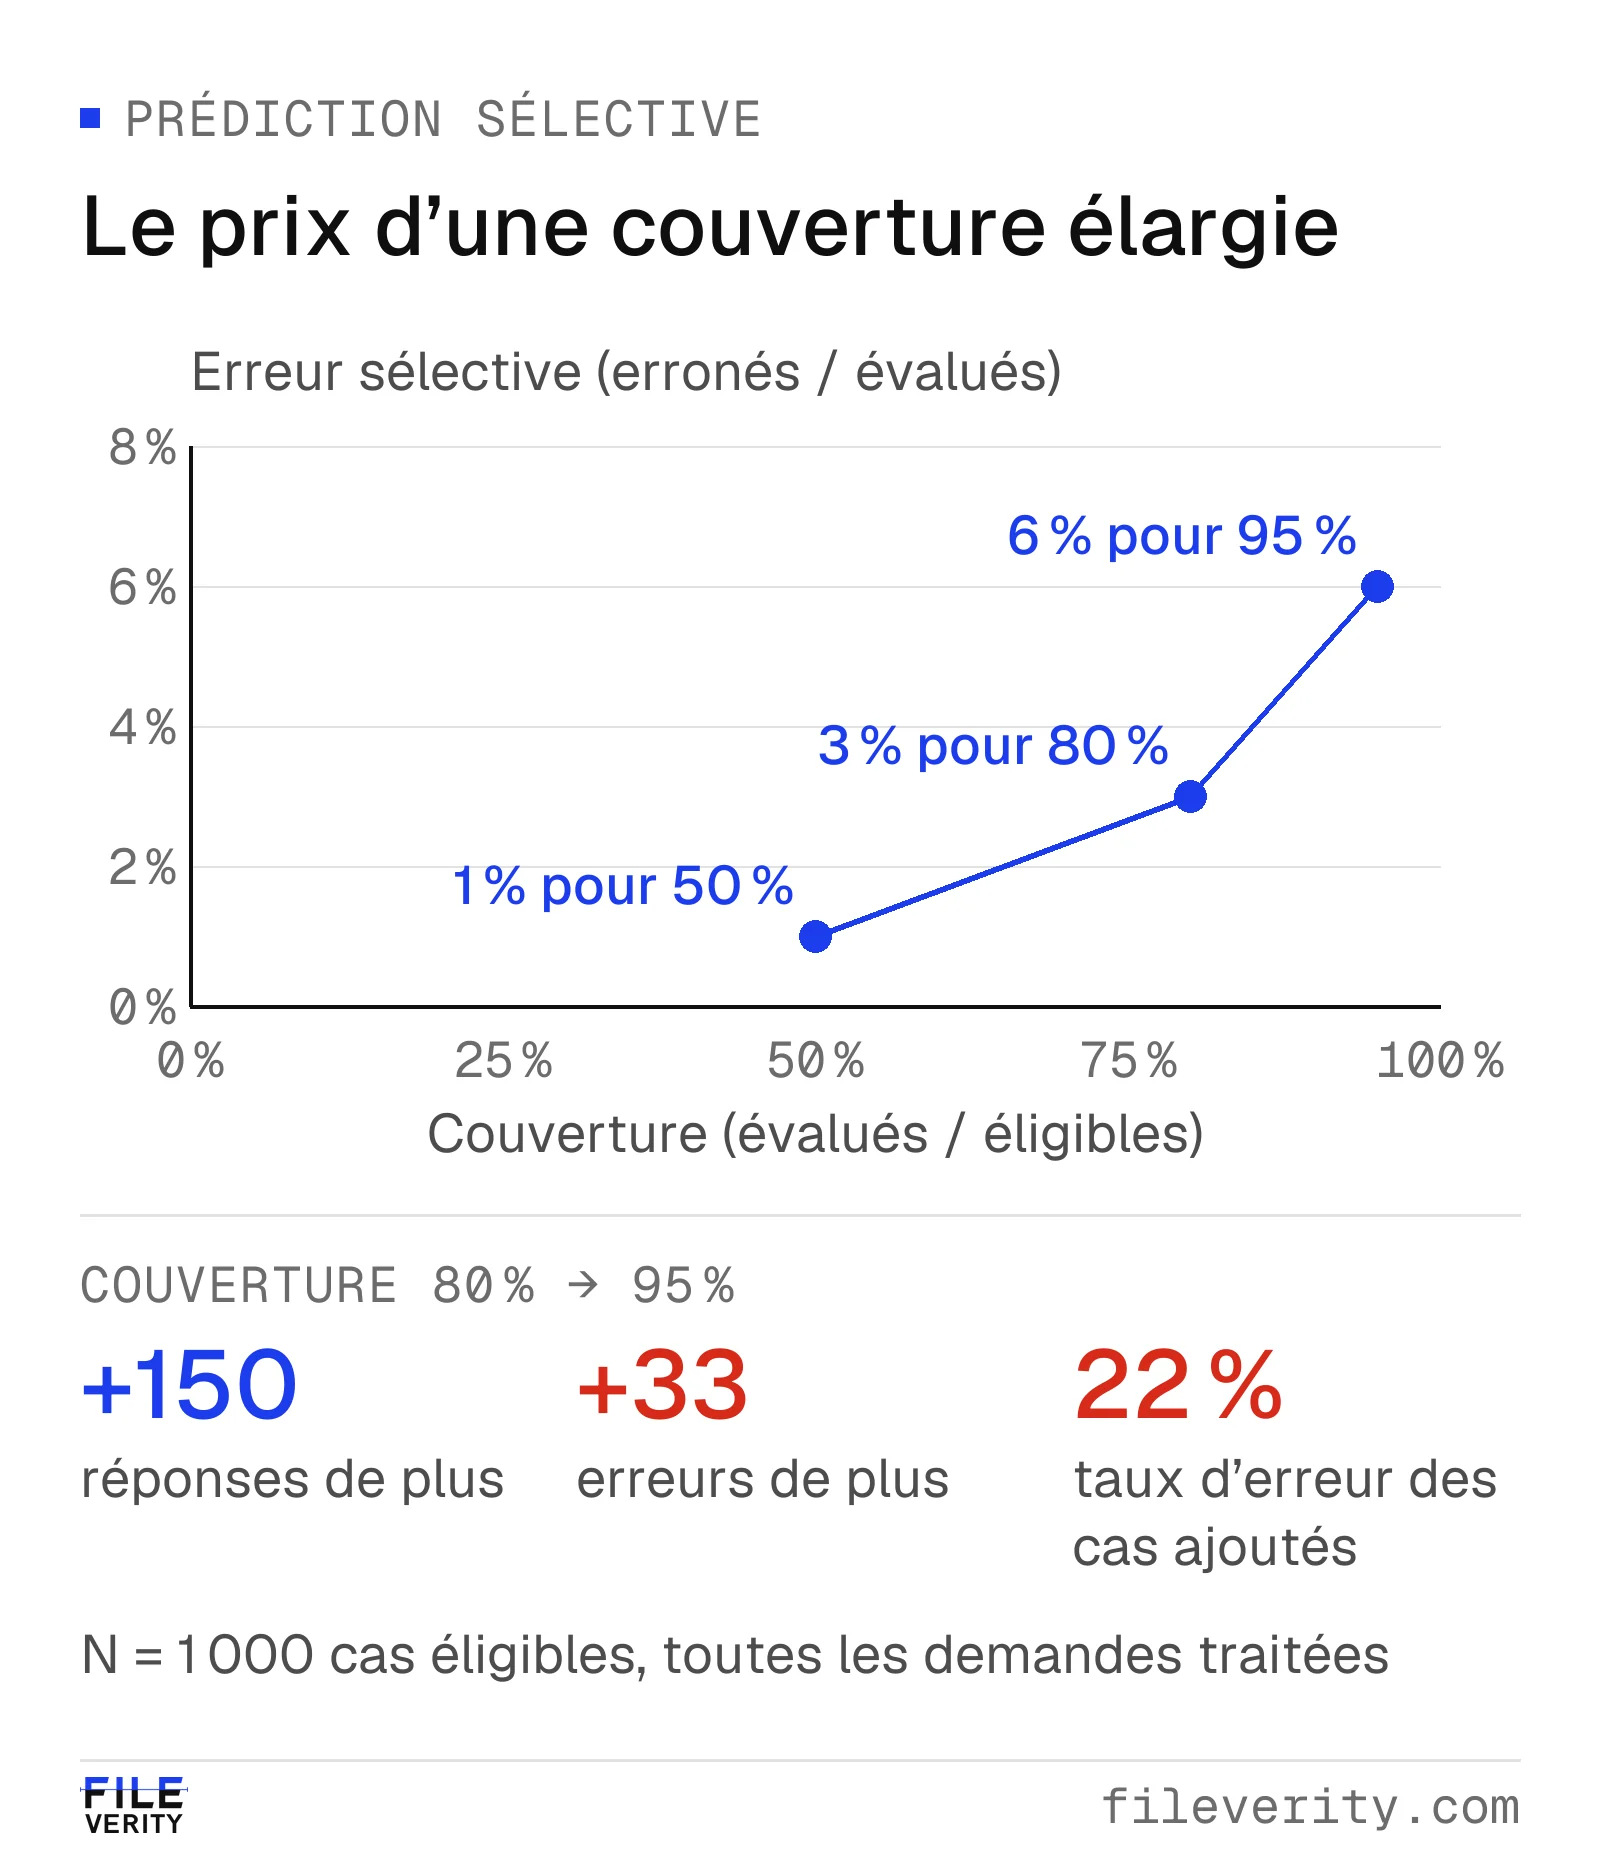
Arbitrage illustratif : passer de 80 % à 95 % de couverture ajoute 150 appréciations et 33 erreurs. Comparez le coût de ces erreurs au travail nécessaire pour résoudre les cas laissés sans réponse.
Distinguer les résultats incertains, les échecs et les fichiers inadaptés est l’un des principes de l’analyse d’images de Fileverity : le verdict peut rester « Indéterminé » lorsque les éléments sont insuffisants. La prédiction sélective fournit un cadre d’évaluation pour ces issues ; elle ne décrit pas l’architecture des modèles de Fileverity. Une requête en échec ou un fichier non pris en charge doit être compté à part, ni recodé en appréciation incertaine ni en constat négatif.
Pour décider d’un achat, comparez les fournisseurs à un niveau de couverture ou à un budget d’erreur convenu, et comptez le travail d’examen restant. Distinguez faux positifs et faux négatifs, dont les coûts diffèrent. Une erreur sélective plus faible n’a de valeur qu’accompagnée d’un niveau de couverture et d’une charge de résolution que votre équipe peut assumer.
Compter les fichiers non résolus et la charge d’examen
Gardez les états de résultat explicites : signalé, non signalé, non concluant, non pris en charge, échec technique. Un résultat non concluant signifie que le service n’a pas pu atteindre l’appréciation visée ; un échec technique signifie que l’analyse n’a pas abouti. Ni l’un ni l’autre ne doit devenir silencieusement « authentique ».
Présentez le taux de faux positifs sur les fichiers négatifs connus et éligibles, et le taux de détection sur les positifs connus et éligibles, en précisant si les cas non résolus sont exclus. Présentez aussi le rendement de détection de bout en bout : positifs pertinents signalés rapportés à l’ensemble des positifs pertinents soumis. Ensemble, ces mesures révèlent un service performant sur un sous-ensemble étroit, mais qui laisse sans réponse une grande partie des cas.
Mesurez l’ensemble du circuit d’examen : temps d’ouverture du dossier, de compréhension du résultat, de vérification des pièces, de demande d’un autre fichier, de clôture ou d’escalade. Relevez les désaccords entre analystes. Un résultat d’apparence précise qui mène régulièrement à des conclusions non étayées pose un problème d’ergonomie, même si le classifieur sous-jacent est performant.
Dans la comparaison ci-dessous, les deux candidats fictifs signalent 80 images cibles et en manquent 20. Ils diffèrent par leurs fausses alertes. Chaque signalement donne lieu à une revue, et il n’y a pas d’autres fichiers non résolus. Un « cas » désigne ici une image, non un dossier de plusieurs images.
Comparaison fictive : 1 000 images évaluées, 100 positifs cibles, 900 négatifs ; huit minutes par signalement et un coût de main-d’œuvre supposé de 45 € de l’heure. Coûts logiciels et cas manqués exclus.
| Résultat ou coût | Candidat A | Candidat B |
|---|---|---|
| Positifs pertinents signalés | 80 | 80 |
| Fausses alertes sur 900 négatifs | 18 | 45 |
| Taux de faux positifs | 2 % | 5 % |
| Total des signalements à examiner | 98 | 125 |
| Part des positifs pertinents dans les signalements | 81,6 % | 64,0 % |
| Temps d’examen | 784 minutes | 1 000 minutes |
| Coût d’examen à 45 € de l’heure (hypothèse) | 588 € | 750 € |
Les deux candidats ont le même rendement de détection de 80 %, mais B crée 27 revues supplémentaires. Avec ces hypothèses, cela représente 216 minutes, soit 3,6 heures, et 162 € de coût d’examen en plus pour 1 000 images. Un prix de licence plus bas devrait compenser cet écart avant que B ne devienne moins cher sur ces deux postes. Ajoutez le coût des cas manqués, des délais et des nouvelles soumissions pour adapter la comparaison à votre flux.
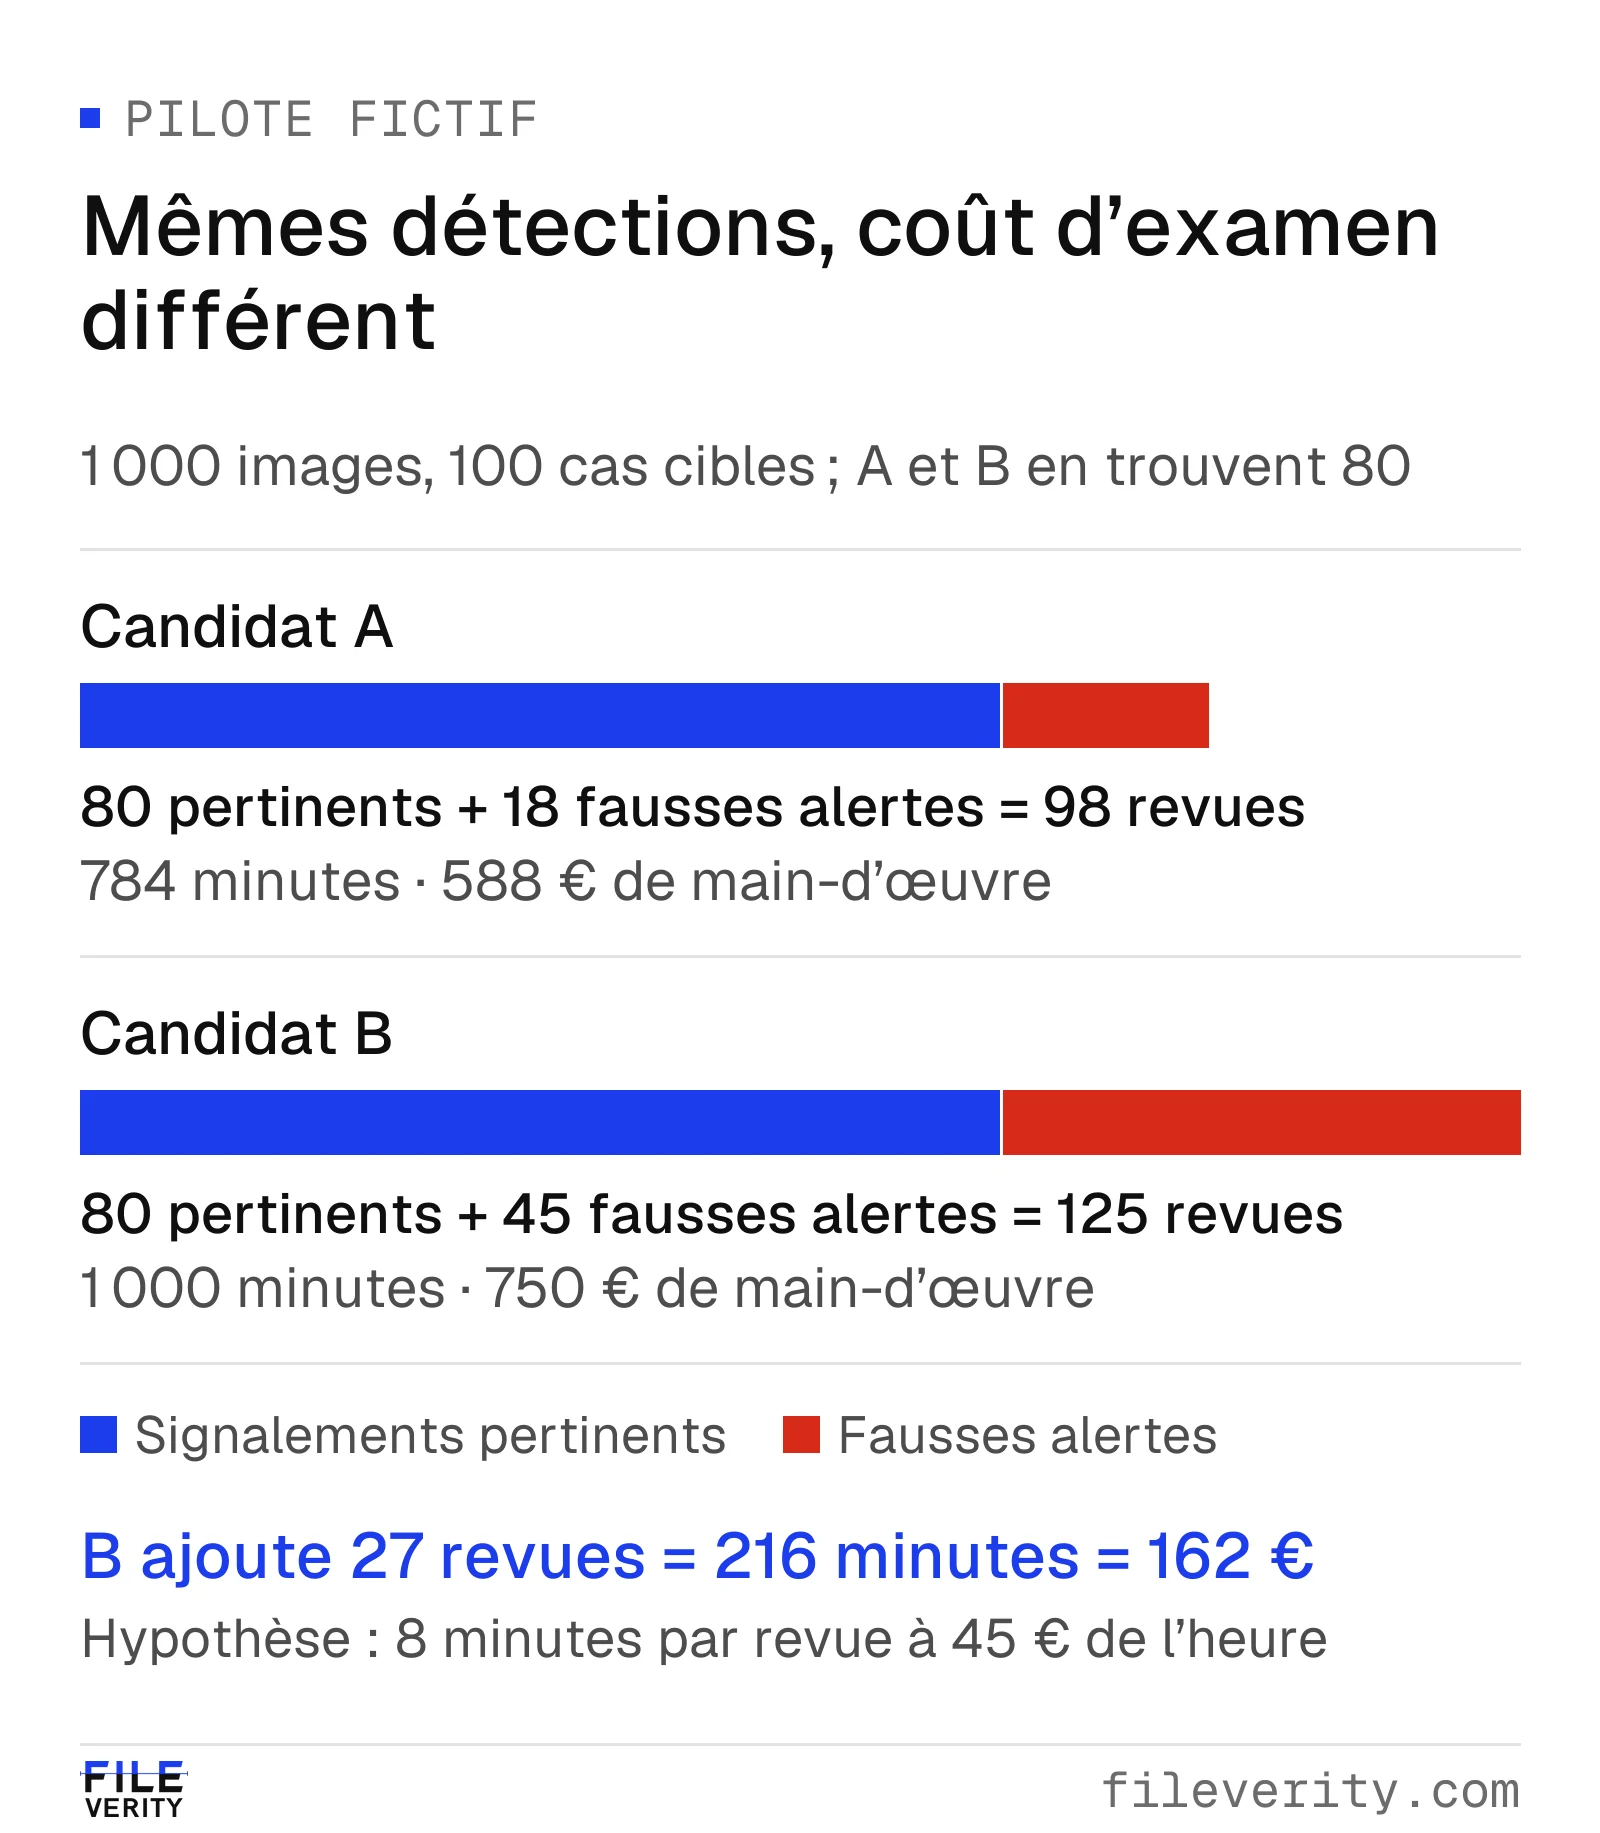
Les deux candidats trouvent 80 images cibles. Le candidat B ajoute 27 fausses alertes, soit 216 minutes d’examen supplémentaires à huit minutes par signalement.
Ce que l’analyste doit pouvoir conserver
Demandez des résultats représentatifs couvrant un signalement, un résultat négatif ordinaire, une appréciation non concluante et une requête en échec. Vérifiez qu’un analyste peut rattacher chaque résultat au fichier soumis, à l’heure du traitement et à l’identifiant de version du service lorsqu’il existe. Le cas échéant, conservez l’empreinte SHA-256 du fichier pour reconnaître des fichiers identiques au bit près ; une empreinte n’établit pas que la scène est véridique.
Si une carte de chaleur apparaît, demandez si elle représente l’attention du modèle, une prédiction de localisation ou une autre grandeur. Exigez une légende et une explication claire des limites. Ne traitez pas une mise en évidence visuelle comme une confirmation indépendante d’une retouche.
Vérifiez que les analystes savent rédiger une mention délimitée : « Le service a signalé l’image soumise pour une possible génération par IA. Le fichier d’origine et des photos complémentaires ont été demandés. Aucune conclusion sur la transaction n’est arrêtée. » Cette phrase sépare l’observation, la déduction, le recoupement et l’action.
Le rapport complet de Fileverity porte un identifiant et l’empreinte SHA-256 du fichier, avec une page de vérification publique. Il précise le statut de l’horodatage de confiance et du sceau PDF. Ces éléments permettent de rattacher les constats au fichier examiné et d’en vérifier les données ; chaque constat conserve sa portée propre.
Vérifier le traitement des données et le comportement opérationnel
Faites examiner par les responsables internes compétents (DPO, RSSI, achats) les lieux de traitement, les sous-traitants, les contrôles d’accès, la conservation et les conditions d’utilisation pour l’entraînement. Demandez des réponses par catégorie de données : fichiers d’origine, aperçus, métadonnées extraites, résultats, journaux applicatifs et sauvegardes. « Nous supprimons les fichiers » reste incomplet tant que l’on ne sait pas ce qui est supprimé, quand, et ce qui subsiste.
Si la suppression ou la restriction d’accès est exigée, intégrez sa vérification à la recette. Obtenez par écrit les conditions d’accès du support et de notification des incidents.
Testez l’intégration réellement envisagée : un fichier non pris en charge, un dépassement de délai, une soumission en double, une limite de capacité, un résultat livré après que le processus appelant a cessé d’attendre. Vérifiez quelles tentatives sont facturées. Si vous avez besoin d’une API, vérifiez sa disponibilité dans l’offre chiffrée au lieu de la déduire d’un bouton d’export.
Convenez de la façon dont les évolutions du produit sont communiquées. Un changement de seuil, de modèle ou de prétraitement peut rompre la comparabilité avec le pilote. Demandez une visibilité sur les versions lorsqu’elle existe et définissez les événements qui déclenchent une nouvelle recette. Gardez une procédure de repli en cas d’indisponibilité et un responsable nommé, habilité à suspendre l’orientation automatique si le volume d’examen devient ingérable.
Prendre une décision d’achat délimitée
Intégrez au modèle de coût l’abonnement ou la consommation, le travail d’intégration, l’examen manuel, les nouvelles soumissions et les contrôles de qualité récurrents. Appliquez la même charge à tous les candidats et affichez les hypothèses. Ne comptez pas des pertes évitées hypothétiques comme des économies acquises.
La fiche de décision indique la tâche approuvée, les usages exclus, l’issue des critères éliminatoires, les éléments notés, les résultats du pilote, les limites non résolues et les responsables. Elle fixe la taille du déploiement initial et les événements qui déclenchent une réévaluation. Une approbation étroite et conditionnelle peut convenir lorsqu’une tâche est étayée et qu’une autre ne l’est pas encore.
Traitez l’évaluation comme une responsabilité continue : réexaminez l’usage approuvé lorsque le modèle, les fichiers reçus ou les conditions d’exploitation changent. Le cadre de gestion des risques de l’IA du NIST, d’application volontaire, inscrit l’évaluation dans cette démarche plus large. NIST AI Risk Management Framework Le guide Fraude à l’assurance et IA montre comment une telle décision s’insère dans un circuit d’examen de sinistres.
Une demande d’informations à adresser aux fournisseurs, Fileverity compris
Posez les mêmes questions à chaque fournisseur présélectionné. Complétez les éléments entre crochets et demandez une réponse datée, rattachée à l’offre et à la version proposées. Le texte ci-dessous peut être repris tel quel dans une demande d’informations (RFI) ou en annexe d’un cahier des charges.
1. Décision et suite donnée. Un signalement déclenchera : [action]. Merci d’indiquer les usages couverts, les usages exclus et le traitement des résultats incertains.
2. Tâches requises. [Génération de l’image entière, retouches locales, provenance]. Pour chaque tâche, merci d’indiquer si elle est disponible, limitée, non prise en charge ou prévue, avec la documentation correspondante.
3. Fichiers. [Formats, canaux, tailles, qualité, contenus représentatifs]. Merci de préciser les exigences sur les fichiers, les limites importantes et les modalités d’un échantillon d’usage autorisé.
4. Volumes. [Images par jour, images par dossier, pointes, capacité d’examen]. Merci de préciser le mode d’accès disponible, les conditions de capacité, le comportement en cas d’échec et l’information sur les changements de version.
5. Évaluation. [Budget de faux positifs ou objectif de rappel]. Merci de fournir les éléments d’évaluation pertinents, les dénominateurs, les exclusions, la couverture et ce qu’un pilote formel devrait établir.
6. Données personnelles. [Lieux de traitement acceptés, conservation, accès, usages permis]. Merci de décrire le traitement des fichiers d’origine, des données dérivées, des résultats, des journaux et des sauvegardes ; de joindre l’accord de traitement des données et la liste des sous-traitants ultérieurs ; et d’indiquer les exigences non satisfaites.
7. Périmètre commercial. [Usage web ou intégration ; volume initial et prévu]. Merci de fournir l’offre et le devis, les tentatives facturables, les coûts d’intégration et de support, et toute dépendance de périmètre.
Adressez la demande complétée à Fileverity pour établir l’adéquation avant de vous engager dans un pilote : notre équipe précise ce qui peut être démontré tout de suite, ce qui exige une évaluation sur vos fichiers et quelles exigences sortent du périmètre proposé. Pour un premier essai, chaque compte comprend une vérification d’image gratuite ; les prix de l’analyse figurent sur la page Tarifs. Conservez la réponse à côté de la matrice de couverture, afin que l’achat repose sur la charge et les exigences que vous avez évaluées.
Par Yang Zheng · Relu par Bill Liu