Évaluer les outils de vérification
Fiabilité d’un détecteur d’images IA : taux d’erreur et faux positifs
Exactitude, précision, faux positifs, seuil, calibration : lire les chiffres d’un détecteur d’images IA et mesurer leur effet sur votre file d’examen.
Publié le · 16 min de lecture
Dans cet article
La fiabilité d’un détecteur d’images IA se juge sur une tâche, un jeu d’images et un seuil de décision précis. Un bon taux de classement global peut malgré tout produire plus de fausses alertes que de détections utiles dans votre file d’examen. Une file courte peut, à l’inverse, masquer de nombreuses images manquées. Comparez donc la précision, le rappel et le taux de faux positifs au seuil que votre équipe utilisera, en tenant compte des fichiers que l’outil ne peut pas évaluer.
Pour évaluer un détecteur, posez trois questions liées : que détecte-t-il exactement, quelles erreurs produit-il au seuil retenu, et que deviennent les fichiers qu’il ne peut pas évaluer ? Ce guide s’adresse aux équipes achats, DSI, RSSI, DPO et direction des risques qui doivent juger un chiffre avant de s’engager. Les exemples chiffrés relient chaque réponse au travail d’examen que recevra votre équipe.
Pour contrôler rapidement un chiffre annoncé, lisez les sections sur la matrice de confusion, la prévalence et le seuil : elles montrent pourquoi une exactitude élevée peut coexister avec une file d’examen médiocre. Si vous pilotez une évaluation, poursuivez avec la calibration, la couverture et le jeu de test réservé, puis utilisez la demande de pièces proposée à la fin. Tous les exemples numériques sont des hypothèses : ce ne sont ni des résultats de Fileverity ni des estimations de la fréquence de la fraude.
Définir ce qui compte comme un positif
Commencez par une phrase du type : « Cette évaluation vérifie si une image soumise a été générée par IA dans son ensemble. » Cette définition fait des images entièrement générées les cas positifs et des photographies authentiques prises à l’appareil photo les cas négatifs. Elle ne fournit aucun test pour les retouches locales par IA, les retouches classiques, les légendes trompeuses ou les photos réutilisées hors contexte.
Si votre processus exige de repérer une génération partielle, évaluez-la comme une tâche distincte, avec ses propres étiquettes. Une photographie réelle contenant une zone régénérée ne doit pas passer d’un groupe à l’autre selon l’interprétation qui améliore le résultat. De même, un usage autorisé de l’IA n’est pas nécessairement trompeur. Les étiquettes de détection décrivent un contenu ; c’est votre politique interne, appuyée sur d’autres éléments, qui en fixe la portée. Le guide Comment savoir si une image est générée par IA détaille ces distinctions au niveau d’un fichier.
Définissez aussi l’unité de compte. Cinq images issues d’un même dossier représentent cinq décisions sur des images, mais peut-être une seule instruction de dossier. L’exactitude mesurée image par image ne prédit pas directement la charge d’examen par dossier lorsque le signalement d’une seule image déclenche le réexamen de l’ensemble du dossier.
Lire la matrice de confusion avant le chiffre mis en avant
Une matrice de confusion compare les décisions du détecteur à des étiquettes établies de façon indépendante. Prenons 10 000 images fictives : 100 images générées et 9 900 images non générées. À un seuil fixe, le détecteur signale 90 images générées et 99 images non générées.
| Étiquette connue | Signalée | Non signalée | Total |
|---|---|---|---|
| Générée | 90 vrais positifs (VP) | 10 faux négatifs (FN) | 100 |
| Non générée | 99 faux positifs (FP) | 9 801 vrais négatifs (VN) | 9 900 |
| Total | 189 | 9 811 | 10 000 |
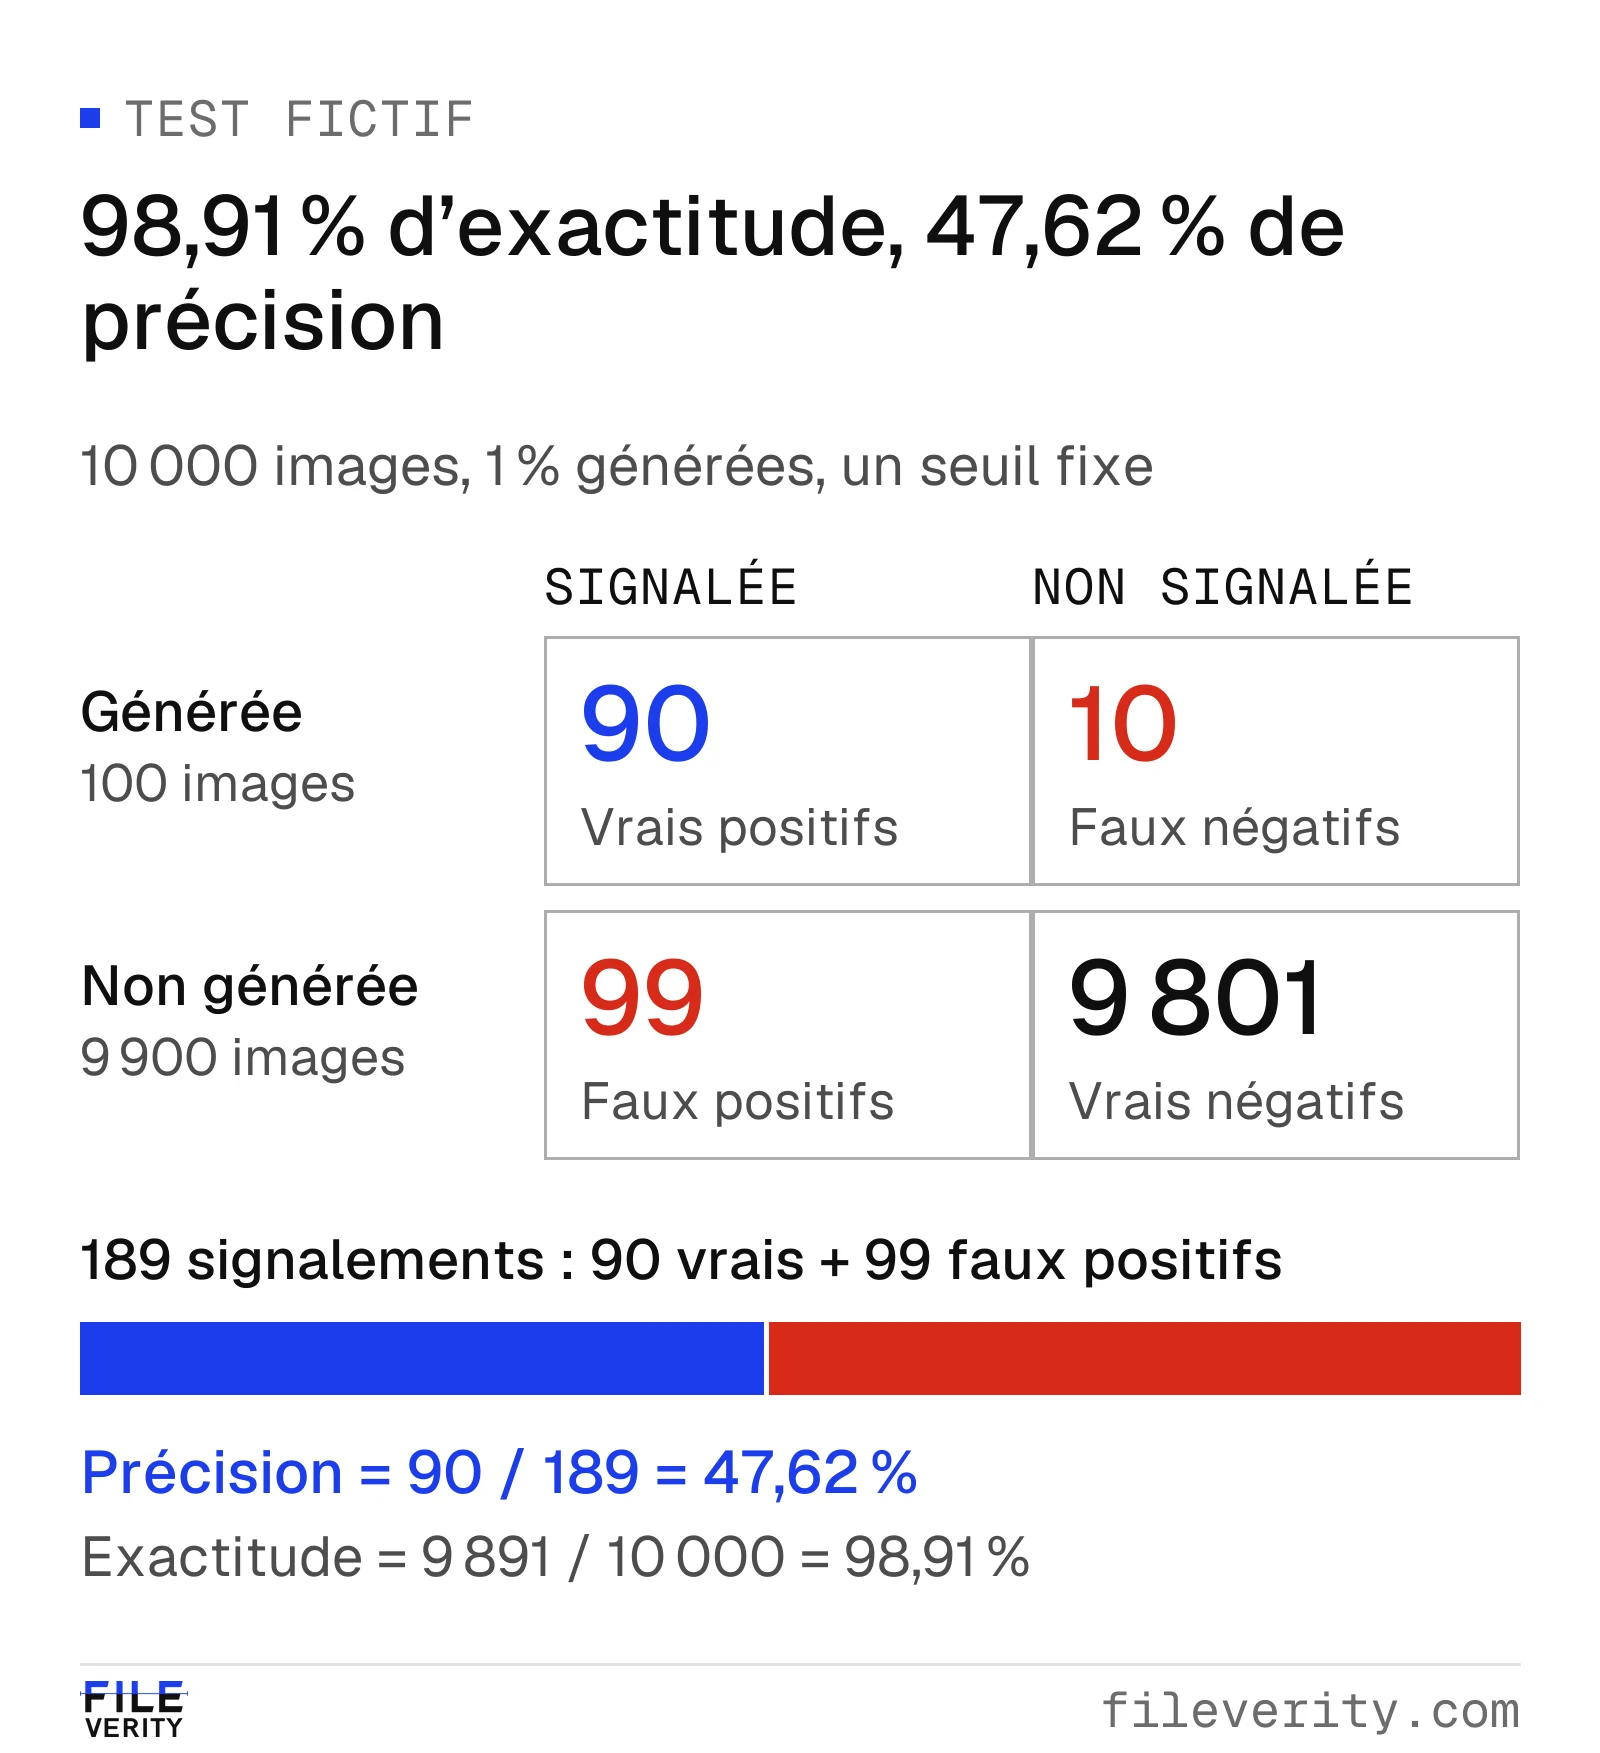
Sur 189 signalements, 90 sont justes et 99 sont de fausses alertes, alors que l’exactitude globale atteint 98,91 %.
Chaque indicateur répond à une question différente :
| Indicateur | Calcul | Résultat | Question à laquelle il répond |
|---|---|---|---|
| Exactitude (accuracy) | (VP + VN) / ensemble des images | 98,91 % | Quelle part des décisions est correcte ? |
| Rappel, ou sensibilité, ou taux de détection | VP / (VP + FN) | 90 % | Quelle part des images générées a été trouvée ? |
| Taux de faux négatifs | FN / (VP + FN) | 10 % | Quelle part des images générées a été manquée ? |
| Taux de faux positifs | FP / (FP + VN) | 1 % | Quelle part des images non générées a été signalée ? |
| Spécificité | VN / (FP + VN) | 99 % | Quelle part des images non générées a échappé au signalement ? |
| Précision, ou valeur prédictive positive (VPP) | VP / (VP + FP) | 47,62 % | Quelle part des signalements est fondée ? |
La précision est arrondie à partir de 90/189. Les définitions usuelles et leur lien avec la matrice de confusion sont documentés dans la référence de scikit-learn sur les métriques de classification.
À ne pas confondre : exactitude et précision. En français courant, les deux mots sont synonymes ; en évaluation, ils ne le sont pas. L’exactitude (accuracy) rapporte les décisions correctes à l’ensemble des images. La précision (precision) rapporte les signalements fondés aux seuls signalements. Un fournisseur qui annonce « 99 % de précision » doit pouvoir dire lequel des deux il mesure, et sur quel dénominateur.
La distinction entre taux de faux positifs et précision est tout aussi décisive : un taux de faux positifs de 1 % ne signifie pas que 1 % seulement des images signalées sont de fausses alertes. Les dénominateurs diffèrent. Ici, 99/189, soit 52,38 % des signalements, sont de fausses alertes.
Une règle qui ne signalerait jamais rien atteindrait 99 % d’exactitude sur ce même ensemble, sans trouver une seule image générée. Elle n’en serait pas utile pour autant. L’exemple montre pourquoi une comparaison fondée sur l’exactitude récompense le mauvais comportement lorsqu’une classe domine.
Calculer l’effet de la prévalence sur la file d’examen
La prévalence est la part de cas positifs dans la population examinée ; elle est de 1 % dans l’exemple. À rappel et taux de faux positifs constants, la précision attendue suit cette relation :
VPP = (rappel × prévalence) / ((rappel × prévalence) + (taux de faux positifs × (1 − prévalence)))
En proportions : 0,90 × 0,01 / ((0,90 × 0,01) + (0,01 × 0,99)) = 0,009 / 0,0189 = 47,619… %.
Le tableau suivant raisonne en effectifs attendus : une valeur décimale décrit une moyenne attendue, non une fraction d’image observée.
Résultats attendus pour 10 000 images, hypothèse d’un rappel de 90 % et d’un taux de faux positifs de 1 %.
| Prévalence hypothétique | Vrais signalements attendus | Faux signalements attendus | Précision attendue |
|---|---|---|---|
| 0,1 % | 9 | 99,9 | 8,26 % |
| 1 % | 90 | 99 | 47,62 % |
| 10 % | 900 | 90 | 90,91 % |
| 50 % | 4 500 | 50 | 98,90 % |
Un banc d’essai équilibré peut donc afficher une précision remarquable qui ne se transpose pas à un flux où les images générées sont rares. Ce calcul suppose en outre que les performances par classe restent identiques ; en pratique, un autre flux peut contenir des images plus difficiles, ce qui modifie le rappel et le taux de faux positifs eux-mêmes.
N’estimez pas la prévalence à partir de la part d’images signalées : cette part inclut les erreurs. Utilisez un échantillon du flux étiqueté de façon indépendante, déclarez les étiquettes non tranchées et testez plusieurs hypothèses plausibles si l’estimation reste incertaine. Servez-vous de ces scénarios pour dimensionner la capacité d’examen avant de fixer un seuil.
Choisir le seuil en fonction de l’action qu’il déclenche
Pour un score dont la valeur croît avec la force des indices de génération, abaisser le seuil de signalement fait entrer davantage d’images dans la file. Sur un même jeu noté, cela ne retire aucune image déjà signalée : les vraies détections et les fausses alertes peuvent augmenter ensemble. Relever le seuil produit l’effet inverse. La précision ne s’améliore pas forcément à chaque cran ; tout dépend de l’ordre dans lequel se répartissent les étiquettes réelles.
Voici une comparaison construite sur la même population de 10 000 images. Aucune valeur de seuil réelle n’est indiquée, car les échelles de score diffèrent d’un système à l’autre.
Comparaison fictive : les mêmes 100 images générées et 9 900 images non générées à chaque seuil.
| Seuil | Vrais positifs | Faux positifs | Positifs manqués | Rappel | Taux de faux positifs | Précision | Taille de la file |
|---|---|---|---|---|---|---|---|
| Bas | 95 | 297 | 5 | 95 % | 3 % | 24,23 % | 392 |
| Médian | 90 | 99 | 10 | 90 % | 1 % | 47,62 % | 189 |
| Haut | 70 | 20 | 30 | 70 % | 0,202 % | 77,78 % | 90 |
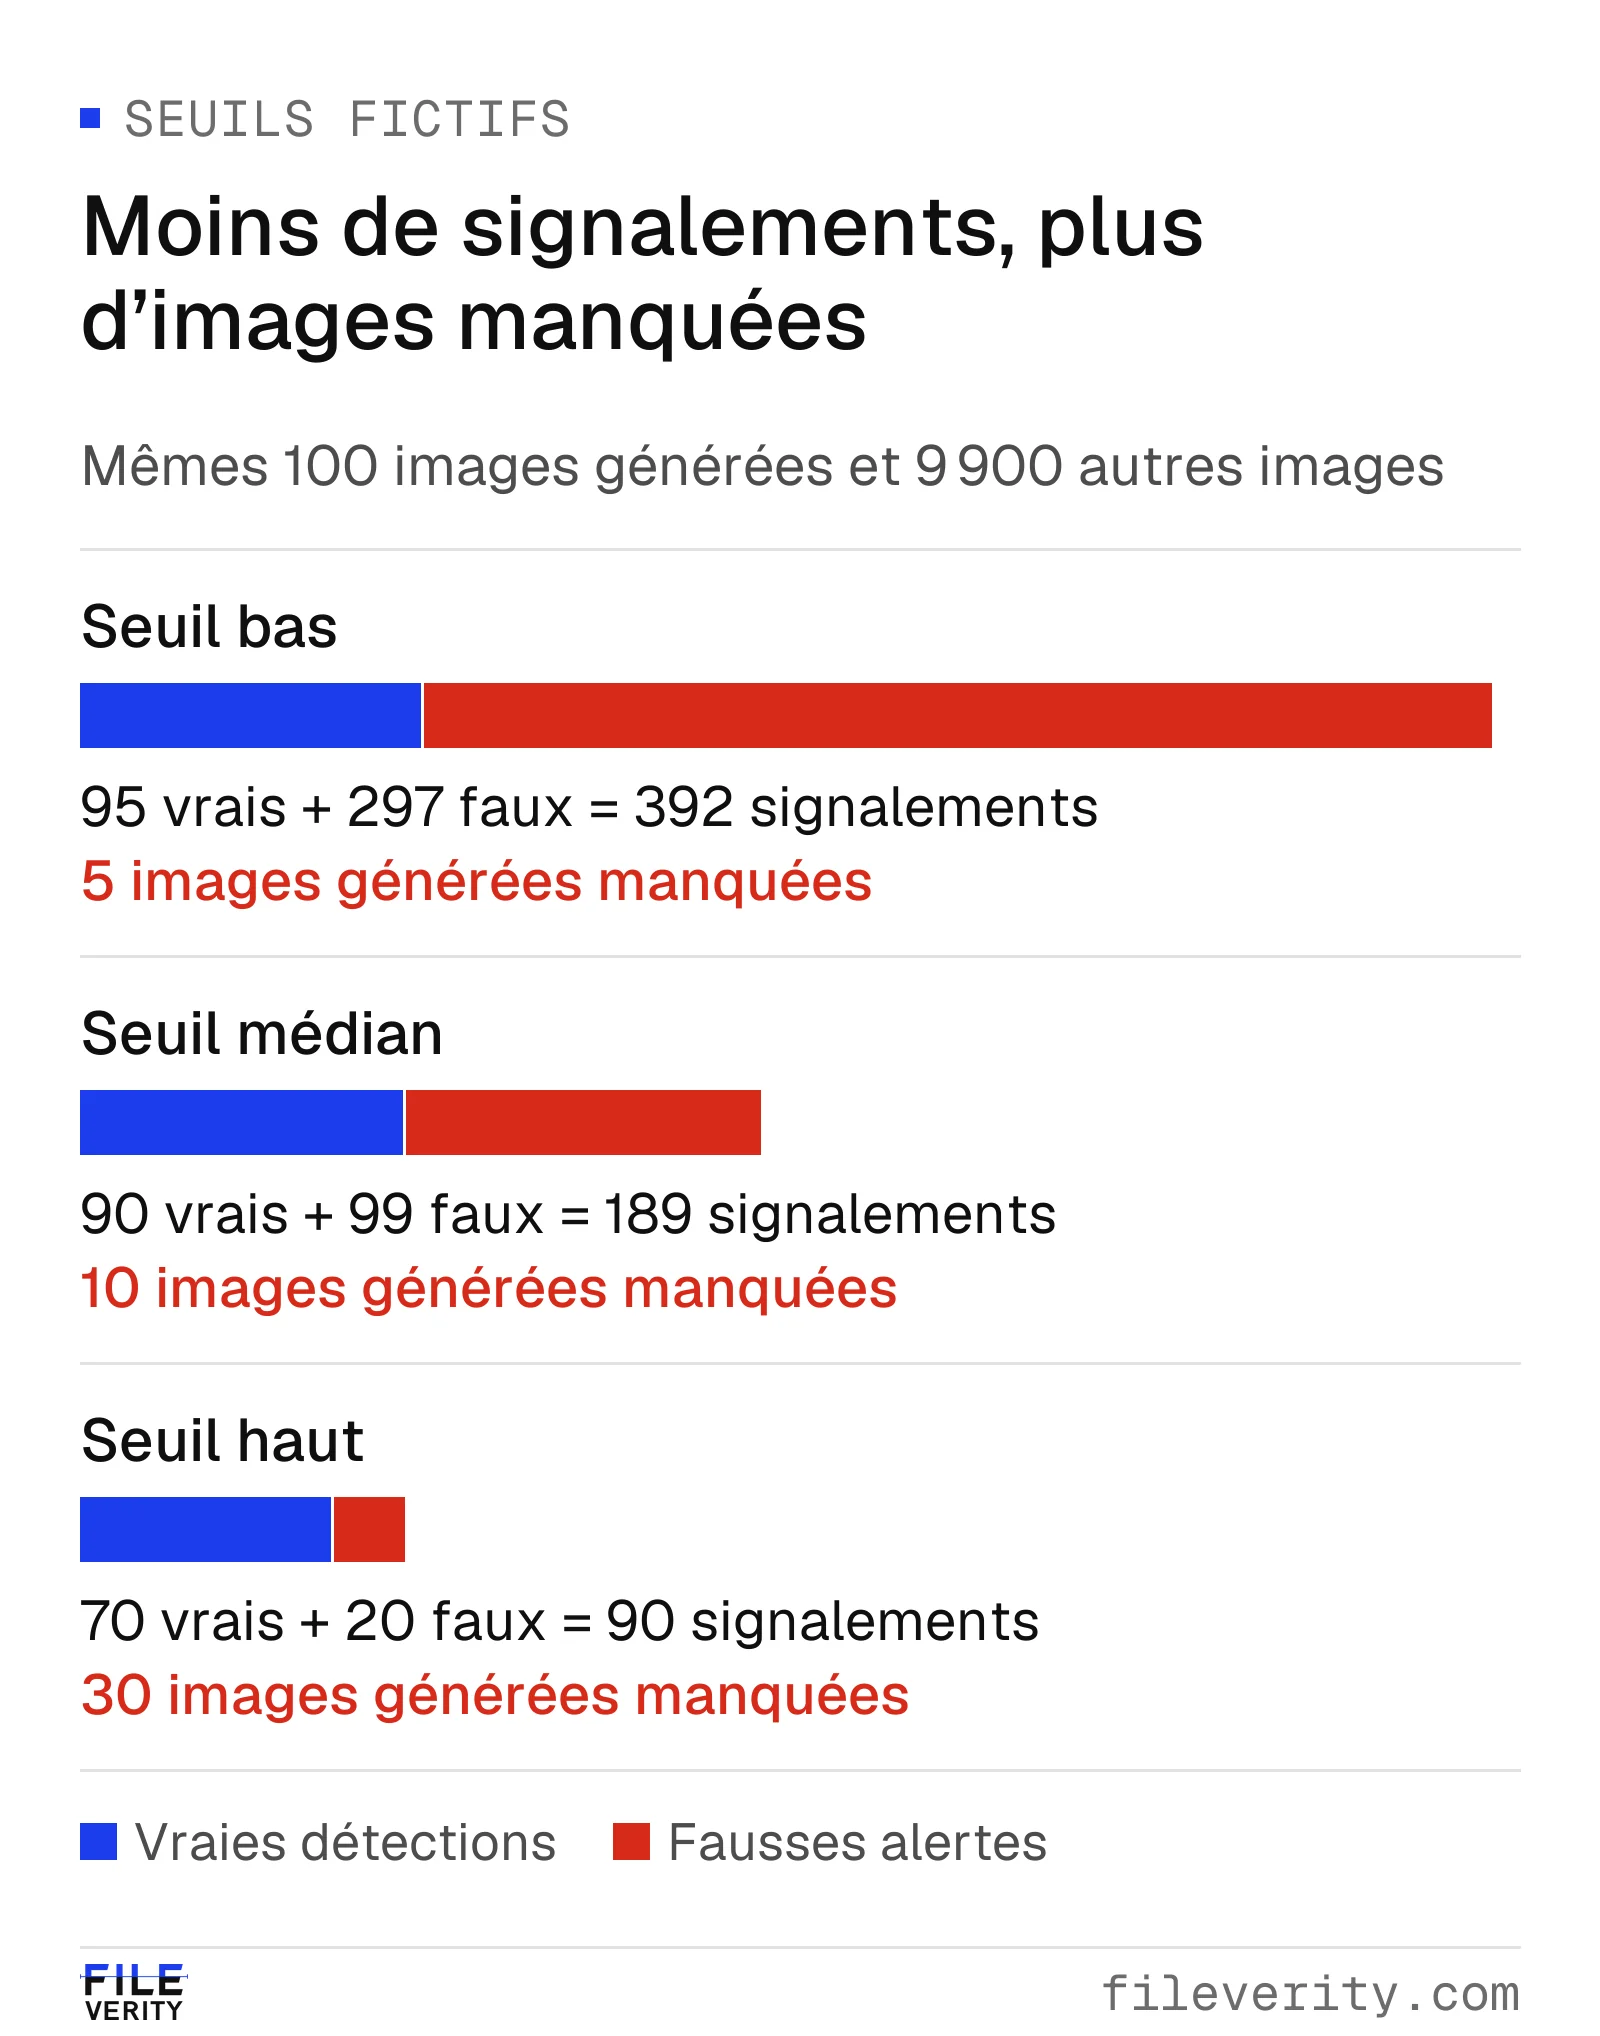
Relever le seuil réduit la file de 392 à 90 images, mais fait passer les positifs manqués de 5 à 30.
À raison de six minutes par image signalée (hypothèse), ces files représentent respectivement 39,2, 18,9 et 9 heures de travail, avant toute instruction complémentaire. Choisir la file la plus courte, c’est aussi accepter 30 images manquées au lieu de 5. Aucun de ces choix n’est juste en soi : l’action prévue, les effectifs disponibles et les conséquences des erreurs déterminent ce qui est acceptable.
Demandez les performances au point de fonctionnement que vous comptez utiliser. Une courbe ROC résume le rappel en fonction du taux de faux positifs sur l’ensemble des seuils ; l’aire sous la courbe ne vous donne pas le rappel à votre limite de fausses alertes. Le NIST relève que, lorsque les faux positifs peuvent causer un préjudice important, certaines études préfèrent publier le taux de vrais positifs obtenu à un taux de faux positifs fixé à une valeur basse (TPR@FPR). NIST AI 100-4, section 4.2.2 et annexe E
Distinguer score de confiance et calibration
Un score de 90 peut être un indicateur de classement, une sortie de modèle transformée ou une estimation de probabilité. Il ne correspond pas automatiquement à une probabilité de 90 % que l’image soit générée, et ne signifie pas que 90 % des pixels ont été modifiés. Obtenez la définition du score avant de lui attribuer un sens.
La calibration vérifie si les probabilités annoncées concordent avec les fréquences observées sur des cas comparables. La discrimination vérifie si les scores séparent bien les catégories visées. Les deux comptent, et aucune ne remplace l’autre. L’exemple ci-dessous montre comment examiner une affirmation de probabilité avant de l’intégrer à une règle de traitement.
Vérifier la calibration sur les fréquences observées
Les résultats de Fileverity s’accompagnent d’un niveau de risque (L0 à L5) et d’une action recommandée. Le moyen concret de vérifier, chez nous comme chez tout autre fournisseur, qu’un score correspond aux fréquences observées est le diagramme de fiabilité : regroupez les prédictions par tranche de probabilité, puis comparez, dans chaque groupe, la prédiction moyenne et la fréquence observée des positifs.
Pour un groupe B, calculez p̄_B = Σp_i/n_B et r_B = Σy_i/n_B, où p_i est la probabilité prédite, y_i vaut 1 pour un positif établi de façon indépendante et 0 sinon, et n_B est l’effectif du groupe. Un accord parfait dans ce groupe signifie p̄_B = r_B ; il ne signifie pas que chaque prédiction prise isolément est certaine. Guo et ses coauteurs étudient la calibration des réseaux de neurones modernes, les diagrammes de fiabilité et les mesures d’écart associées. Guo et al., ICML 2017
Prenons cette évaluation binaire illustrative (exemple fictif d’un détecteur dont les prédictions sont trop confiantes) :
| Tranche de probabilité | Images | Prédiction moyenne | Positifs connus | Fréquence positive observée | Écart absolu |
|---|---|---|---|---|---|
| 0,0 à <0,4 | 100 | 0,20 | 10 | 0,10 | 0,10 |
| 0,4 à <0,7 | 100 | 0,50 | 40 | 0,40 | 0,10 |
| 0,7 à 1,0 | 100 | 0,80 | 60 | 0,60 | 0,20 |
L’écart absolu pondéré par les effectifs s’écrit Σ(n_B/N) × |p̄_B − r_B|. Il vaut ici (0,10 + 0,10 + 0,20) / 3 = 0,1333, soit environ 13,3 points de pourcentage. Ce chiffre décrit un désaccord dans ces groupes ; ce n’est ni un taux d’erreur de classification ni l’affirmation que chaque score se trompe de 13,3 points. Un autre découpage en tranches peut masquer ou révéler d’autres écarts : conservez les effectifs et le diagramme à côté du résumé.
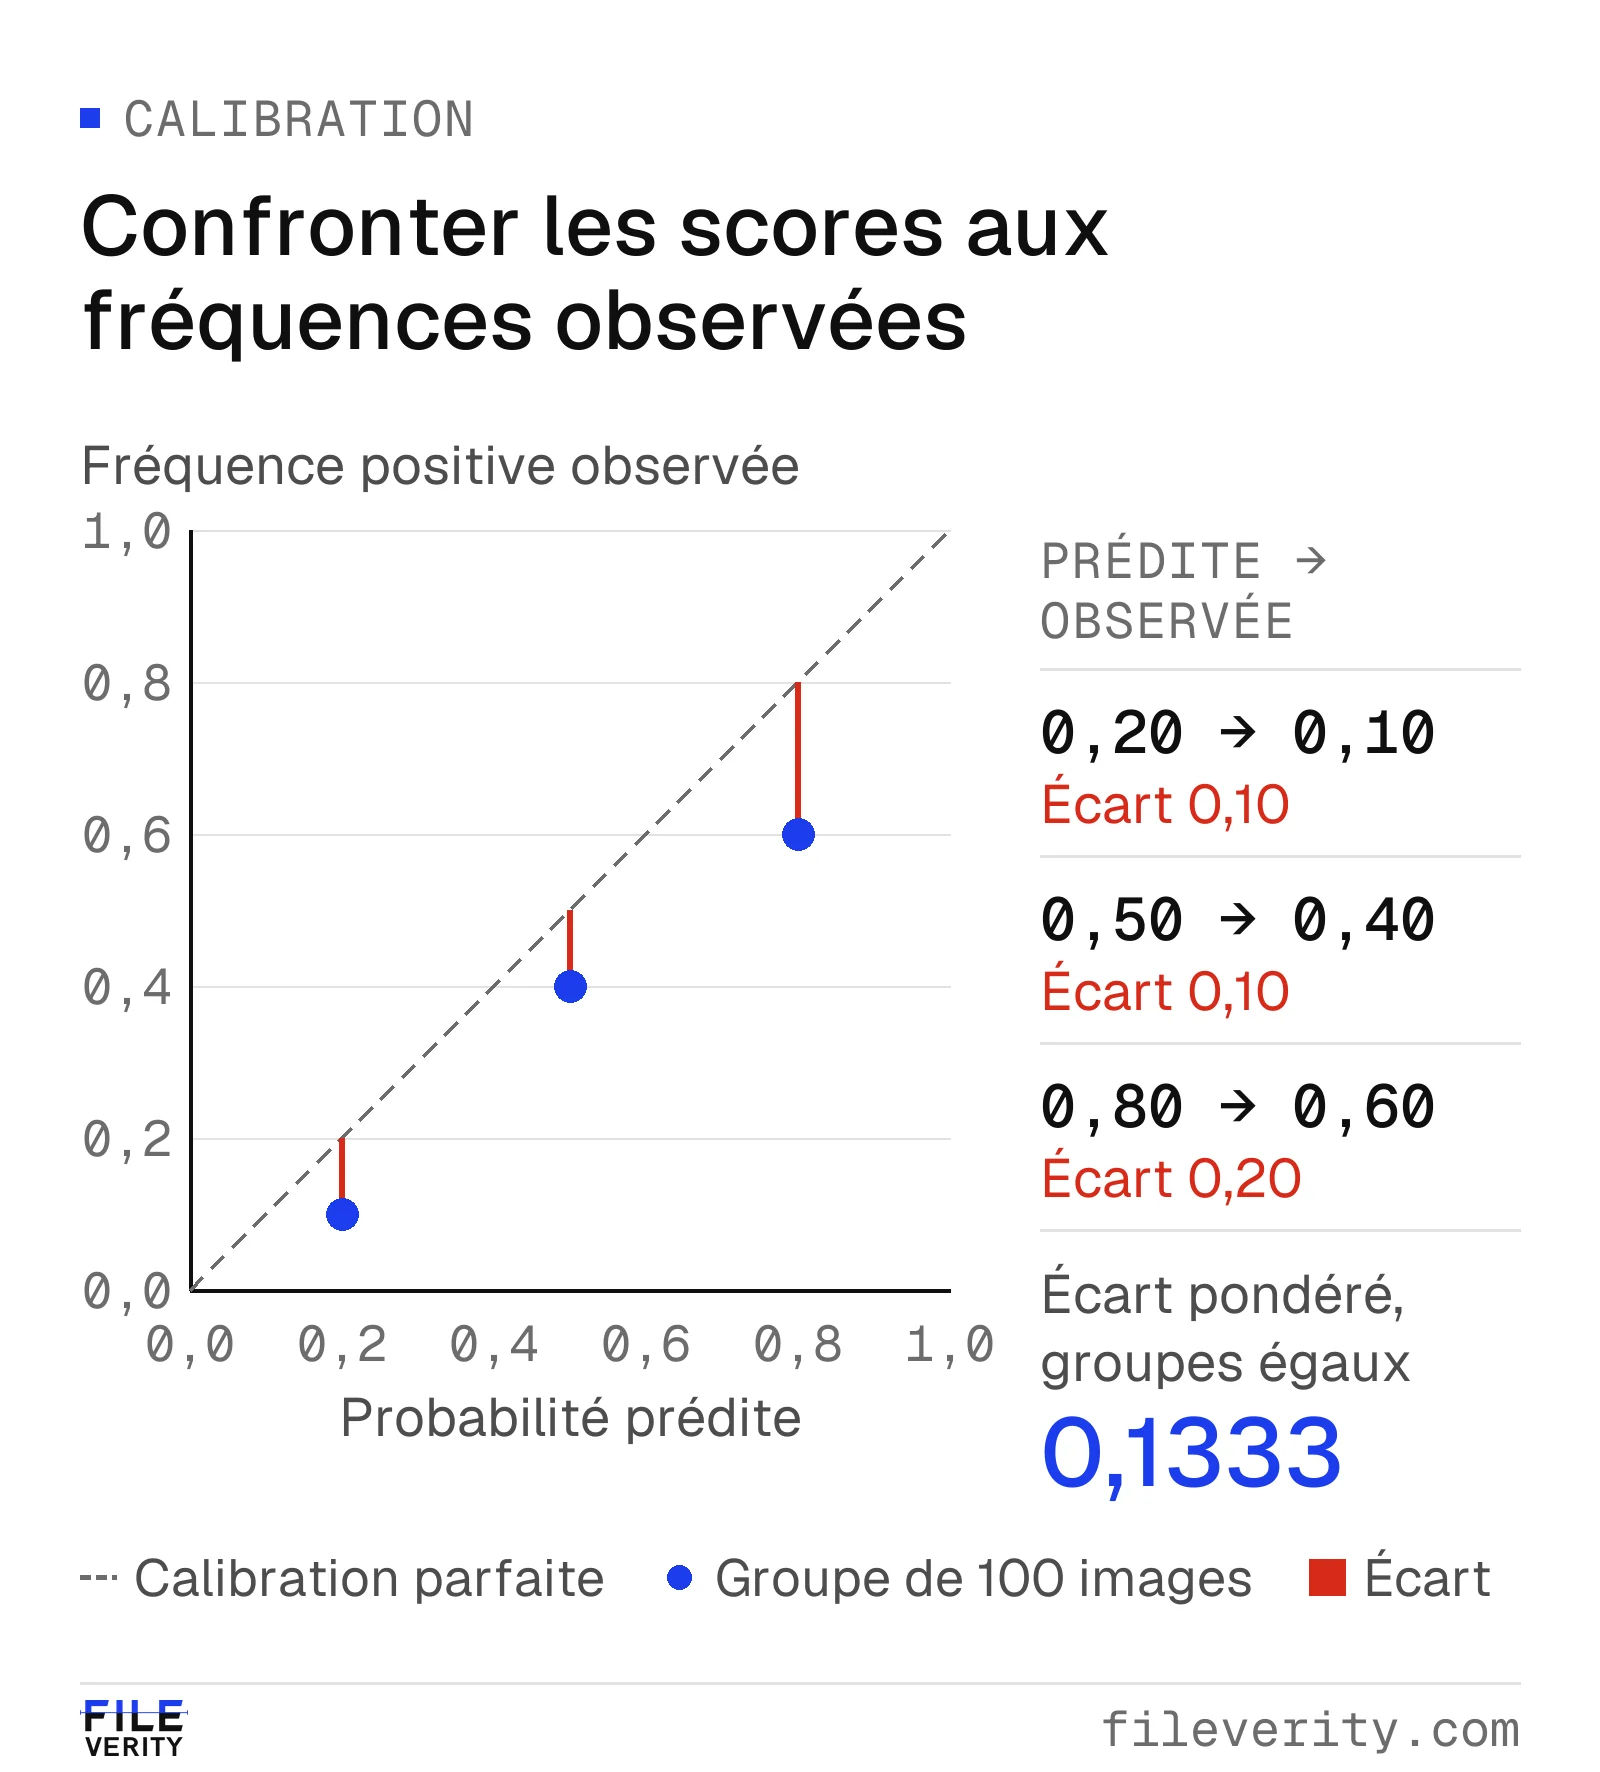
Données illustratives, 100 images par groupe : les prédictions dépassent les fréquences observées de 10, 10 et 20 points de pourcentage.
Pourquoi la calibration peut-elle s’améliorer sans meilleure discrimination ? Une transformation strictement croissante des scores conserve l’ordre de chaque paire : une mesure de classement comme l’aire sous la courbe ROC ne change pas, alors que les probabilités peuvent se rapprocher des fréquences observées. La valeur numérique du seuil associé aux mêmes décisions peut, elle, changer. Demandez donc des éléments à la fois sur les erreurs au point de fonctionnement et sur l’interprétation probabiliste.
La calibration dépend aussi de la population évaluée. Ovadia et ses coauteurs étudient l’effet d’un changement de distribution des données sur l’exactitude et la calibration, et constatent que la calibration a posteriori classique ne suffit pas dans ces conditions. Ovadia et al., NeurIPS 2019 Ajustez toute correspondance de calibration sur des données distinctes de l’échantillon d’acceptation final, puis examinez séparément chaque canal de réception pertinent. Pour un pilote avec Fileverity, incluez vos propres canaux dans ce contrôle.
Garder les fichiers incertains et non pris en charge dans le dénominateur
Un détecteur peut s’abstenir, refuser un format non pris en charge, dépasser un délai ou renvoyer un avertissement de qualité. Ces issues doivent être comptées à part. Les exclure peut donner une impression de fiabilité précisément parce que les cas les plus difficiles ont disparu du calcul.
Prenons un autre lot fictif : 1 000 fichiers, dont 850 reçoivent une classification exploitable, 100 un résultat incertain et 50 échouent au traitement. La couverture de classification est de 850/1 000 = 85 %. Si 833 classifications sont justes, l’exactitude parmi les fichiers classés est de 833/850 = 98 %. Sur l’ensemble des fichiers, 83,3 % ont reçu une classification juste : c’est un indicateur descriptif qui tient compte de la couverture, non une exactitude binaire au sens habituel. Les 150 autres fichiers restent non résolus ; ils ne sont ni automatiquement erronés ni automatiquement négatifs.
Publiez l’exactitude et la couverture ensemble, puis ventilez la couverture par étiquette connue et par canal de réception : un système peut s’abstenir plus souvent sur les cas positifs. Donnez le rappel global en précisant le traitement des abstentions, à côté du rappel limité aux cas classés, afin que chacun voie ce que chaque dénominateur exclut. Prévoyez une voie de repli pour les fichiers non résolus et intégrez-la dans l’estimation de la charge. Les captures d’écran et les images recompressées en sont la source la plus fréquente ; le guide Captures d’écran et images compressées explique quel fichier redemander.
À quoi ressemble un chiffre bien documenté
Un chiffre exploitable indique son périmètre, son effectif, son intervalle de confiance, sa date et la version évaluée. Pour l’analyse de documents, Fileverity publie ses taux de faux positifs avec leur périmètre, leur date et la version évaluée : lors de la validation d’octobre 2026, FVDOC V3 a signalé à tort entre 0,11 % et 0,87 % des textes rédigés par des personnes selon la langue (0,87 % en français). Le détail figure sur la page Fiabilité du détecteur de documents.
Ces chiffres portent sur du texte et illustrent la forme d’un chiffre documenté. Pour les images, la performance se mesure sur vos propres fichiers plutôt que sur un chiffre général : les rapports d’image de Fileverity exposent le fondement et la solidité de chaque constat, et notre équipe parcourt avec vous des cas réels issus de votre propre processus. Ces cas vous permettent d’appliquer à notre outil la méthode décrite dans ce guide : matrice de confusion, couverture, intervalles de confiance. Pour tout chiffre qu’un fournisseur vous présente, nous compris, demandez le périmètre, l’échantillon, la version et la date.
Constituer un jeu de test représentatif et intact
Une évaluation exige des étiquettes défendables et un plan d’échantillonnage. Utilisez des fichiers dont l’usage est autorisé et l’origine documentée : exemples générés dans des conditions maîtrisées, originaux d’appareil photo à l’historique connu et, le cas échéant, retouches étiquetées séparément. L’avis d’un autre détecteur n’est pas une vérité de terrain. Conservez les étiquettes contestées comme non tranchées et documentez la règle d’arbitrage.
Reproduisez les fichiers tels que vous les recevez, pas seulement des originaux impeccables. Intégrez les canaux, tailles d’image, catégories de contenu et manipulations ordinaires que rencontre votre processus. Lors du découpage des données, gardez ensemble les variantes d’une même image source : sinon, la même scène peut se retrouver à la fois dans les données de réglage et dans celles d’évaluation. Séparez aussi, si possible, les sessions de prise de vue et les collections d’origine.
Utilisez un jeu de développement pour choisir les seuils, et un jeu réservé distinct pour vérifier une seule fois la règle retenue. Si un échec sur le jeu réservé conduit à modifier la règle, ce jeu devient un jeu de développement : constituez-en un nouveau, intact, pour la version révisée. Pour un service propriétaire, interrogez le fournisseur sur les recoupements connus avec les bancs d’essai publics et reconnaissez ce qui ne peut pas être vérifié quant aux données d’entraînement.
Ajoutez un jeu de cas délibérément difficiles, présenté séparément de l’échantillon représentatif, pour que la surreprésentation de cas inhabituels ne soit pas prise pour la prévalence normale du flux. Les travaux sur la détection d’images générées testent la généralisation d’un générateur à l’autre, précisément parce qu’un succès sur une source n’établit pas une couverture universelle. Wang et al., « CNN-generated images are surprisingly easy to spot… for now », CVPR 2020
Fixer les critères d’acceptation avant de voir les résultats
Rédigez une fiche d’évaluation qui relie chaque indicateur à la décision qu’il doit éclairer.
Exemple de critères d’acceptation pour un processus qui oriente des images vers un examen humain.
| Élément | Exemple de critère ou de mention |
|---|---|
| Usage prévu | Orienter des images vers un examen humain ; aucune décision défavorable automatique |
| Configuration figée | Version du service, seuil, définition du score et prétraitement consignés |
| Fausses alertes | Borne supérieure unilatérale à 95 % du taux de faux positifs inférieure ou égale à 1 % |
| Détection | Borne inférieure unilatérale à 95 % du rappel supérieure ou égale à 85 % |
| Couverture | Au moins 95 % de fichiers classés ; chaque fichier non résolu dispose d’une voie de repli |
| Capacité | Charge totale d’examen et de repli compatible avec un effectif quotidien fixé à l’avance |
| Sous-groupes | Canaux critiques présentés séparément ; éléments insuffisants laissés non tranchés |
| Responsable | Un analyste nommé consigne l’acceptation, le refus ou un pilote limité |
Les bornes de confiance évitent de prendre un petit échantillon sans erreur pour une certitude. Avec zéro faux positif sur 300 cas négatifs indépendants, la borne supérieure binomiale exacte unilatérale à 95 % vaut 1 − 0,05^(1/300), soit environ 0,994 %. Avec zéro sur 100, elle vaut environ 2,951 %.
Le calcul est court : si la probabilité de faux positif est p, la probabilité de n’observer aucun faux positif sur n cas négatifs indépendants est (1 − p)^n ; en égalant cette valeur à 0,05, on obtient la borne supérieure p = 1 − 0,05^(1/n). Zéro erreur observée n’établit donc pas un taux d’erreur nul. Ces calculs supposent des cas indépendants et représentatifs : de nombreuses photos quasi identiques n’apportent pas autant d’information que des dossiers indépendants.
Dans l’exemple du seuil médian, le taux de faux positifs observé de 1 % ne satisferait pas une exigence de borne supérieure inférieure ou égale à 1 %. Une estimation ponctuelle et une borne d’incertitude répondent à des questions différentes. Dimensionnez l’échantillon en fonction du niveau d’assurance requis avant de constituer le jeu de test.
Surveiller la dérive et formuler les conclusions avec prudence
Après la mise en service, suivez le taux de signalement, le taux de fichiers non résolus, la répartition par canal, le temps d’examen et les issues confirmées de façon indépendante. Une hausse du taux de signalement ne permet pas, à elle seule, de distinguer une augmentation des images générées d’une augmentation des fausses alertes. Échantillonnez aussi des cas non signalés : n’examiner que les signalements laisse les positifs manqués largement invisibles. Tenez compte des probabilités d’échantillonnage lorsque vous estimez des indicateurs sur l’ensemble du flux à partir de groupes volontairement surreprésentés.
Consignez les changements de modèle, de seuil et de processus de réception. Réévaluez après tout changement significatif et maintenez des contrôles périodiques sur des cas étiquetés, même lorsque les moyennes du tableau de bord paraissent stables. Un nouveau générateur, un nouveau canal ou une nouvelle catégorie de contenu peut modifier les performances sans alerte globale visible.
Dans une fiche de dossier, séparez l’observation de la décision. « L’image a dépassé le seuil de revue » est une observation. « Cela appuie un doute sur une génération par IA » est une déduction. Un original vérifié ou un historique de création documenté constitue un élément de recoupement. Demander ces pièces est une action. Aucun de ces énoncés, pris isolément, n’établit une fraude ni la réalité de la scène représentée.
Transformer un chiffre annoncé en demande de pièces
Demandez assez d’informations pour rattacher le résultat annoncé à votre flux et à l’action qui suivra. Vous pouvez reprendre la demande suivante dans un échange avec un fournisseur :
Nous devons évaluer [la génération de l’image entière / la retouche locale / une autre tâche définie] sur [formats, canaux et conditions de qualité]. Le résultat déclenchera [action d’examen], pour environ [nombre d’images et de dossiers par jour]. Notre capacité d’examen est de [heures de travail ou dossiers par jour].
Merci d’indiquer la version du produit évaluée et la définition du score ; l’origine des étiquettes et les effectifs de positifs et de négatifs ; les quatre effectifs de la matrice de confusion au point de fonctionnement proposé ; les intervalles de confiance ; et, séparément, le nombre de fichiers non concluants, non pris en charge et en échec. Précisez les fichiers exclus de chaque indicateur, l’évolution de la couverture et du rappel lorsque ces fichiers sont réintégrés, et si des images de même source figurent à la fois dans les données de réglage et dans celles d’évaluation.
Indiquez quels éléments s’appliquent à cet usage, quelles conditions restent non testées et ce qu’un pilote devrait établir.
Pour appliquer cette méthode à Fileverity, situez d’abord la tâche qui vous concerne avec la présentation de la vérification d’images, puis parcourez des cas réels de votre processus avec notre équipe en joignant votre demande de pièces. Pour la décision d’achat dans son ensemble, y compris le traitement des données et le coût total de l’examen, poursuivez avec le guide Choisir un logiciel de détection d’images IA.
Par Yang Zheng · Relu par Bill Liu