تقييم الكشف
كشف الصور المولَّدة بالذكاء الاصطناعي: الدقة والإيجابيات الكاذبة
افهم الدقة والإيجابيات الكاذبة وحدود الدرجات في كشف الصور المولَّدة بالذكاء الاصطناعي، مع مثال حسابي يقارن العتبات وعبء المراجعة وعدم اليقين.
تاريخ النشر · آخر تحديث · 13 د للقراءة
في هذه الصفحة
لا تفيد دقة كاشف الصور بالذكاء الاصطناعي (AI Image Detector) إلا إذا عرفت المهمة التي اختُبر الكاشف عليها، والصور التي شملها الاختبار، والقاعدة التي تحوّل الدرجات إلى قرارات. فقد يصنّف الكاشف كل صورة تقريبًا تصنيفًا صحيحًا، ومع ذلك يرسل إلى قائمة انتظار المراجعة إنذارات كاذبة (إيجابيات كاذبة) أكثر مما يرسل من حالات الكشف الصحيحة. وقد تُخفي قائمة المراجعة الصغيرة كذلك أعدادًا كبيرة من الصور التي فاتت الكاشف.
لتقييم كاشف الصور المولَّدة بالذكاء الاصطناعي، اطرح ثلاثة أسئلة مترابطة: ما الذي يكشفه تحديدًا؟ وما الأخطاء التي يرتكبها عند العتبة التي تنوي اعتمادها؟ وماذا يحدث للملفات التي لا يستطيع تقييمها؟ ويخاطب هذا الدليل فرق المشتريات وتقنية المعلومات وأمن المعلومات وإدارة المخاطر ومكافحة الاحتيال التي تراجع صورًا مرفقة بالمطالبات والطلبات والمستندات. وتربط الأمثلة الحسابية أدناه كل إجابة بعبء المراجعة الذي سيصل إلى فريقك.
للتحقق السريع من رقم دقة معلن، ابدأ بالأقسام المتعلقة بمصفوفة الارتباك ومعدل الانتشار والعتبة؛ فهي توضح كيف يمكن أن يجتمع رقم دقة مرتفع مع قائمة انتظار مراجعة غير مجدية. وإذا كنت مسؤولًا عن تقييم كاشف، فانتقل إلى أقسام المعايرة والتغطية وتصميم مجموعة الاختبار المحجوزة، ثم استخدم طلب الأدلة في ختام هذا الدليل. جميع الأمثلة العددية افتراضية، وليست نتائج من Fileverity ولا تقديرات لانتشار الاحتيال.
تستخدم Fileverity نموذج FVIMG V2 لكشف الصور المولَّدة بالذكاء الاصطناعي، ونموذج FVDOC V3 لكشف النص المكتوب بالذكاء الاصطناعي في المستندات (يدعم FVDOC V3 النصوص المكتوبة بالإنجليزية والفرنسية والألمانية والإسبانية والصينية، ولا يدعم العربية). ويعرض تقييم Synthbuster لنموذج FVIMG V2 نسبة كشف للصور المولَّدة بالذكاء الاصطناعي قدرها 97.54% ودقة متوازنة (Balanced Accuracy) قدرها 96.92% في اختبار مرجعي علني، مع نتائج مفصلة بحسب أداة التوليد ومنهجية الاختبار. وتُطوَّر نماذج Fileverity وتُختبر على بيانات ضخمة خاصة وحصرية أعدّها مختصون بعناية، أما هذا التقييم فيعتمد مجموعتي بيانات علنيتين يستطيع أي طرف فحصهما بنفسه. وتُعرض نتائج الصور هذه بمعزل عن نتائج التحقق من FVDOC V3 على النصوص.
عرّف ما يُعدّ حالة إيجابية
ابدأ بجملة من قبيل: «يختبر هذا التقييم ما إذا كانت الصورة المقدَّمة بأكملها مولَّدة بالذكاء الاصطناعي». يجعل هذا التعريف الصور المولَّدة بالكامل حالات إيجابية، والصور الملتقطة بالكاميرا والمستوفية للشروط حالات سلبية. لكنه لا يُعدّ اختبارًا للتعديلات الموضعية بالذكاء الاصطناعي، ولا للتنقيح التقليدي للصور، ولا للتعليقات المضللة، ولا للصور المعاد استخدامها خارج سياقها. ويتناول دليل كيف تعرف إن كانت الصورة مولَّدة بالذكاء الاصطناعي هذه الفروق على مستوى الملف الواحد.
إذا كان مسار عملك يتطلب كشف التوليد الجزئي، فقيّمه بوصفه مهمة منفصلة بوسوم صريحة. ولا ينبغي أن تنتقل صورة التقطتها كاميرا وتحتوي على منطقة مولَّدة بين مجموعة الحالات الإيجابية ومجموعة الحالات السلبية دون إعلان، تبعًا للتفسير الذي يحسّن النتيجة. وبالمثل، ليس كل استخدام مسموح به للذكاء الاصطناعي خداعًا بالضرورة. فتصنيفات الكاشف تصف المحتوى، أما دلالته فتحددها السياسة الداخلية والأدلة المؤيدة.
حدّد وحدة العدّ أيضًا. فخمس صور في طلب واحد هي خمسة قرارات بشأن الصور، لكنها قد تمثل تحقيقًا واحدًا فقط. ولا تتيح الدقة الكلية المحسوبة على مستوى الصورة التنبؤ مباشرة بعبء المراجعة على مستوى الحالة، حين يؤدي وضع علامة على صورة واحدة إلى مراجعة الطلب بأكمله.
اقرأ مصفوفة الارتباك قبل الرقم الرئيسي
تقارن مصفوفة الارتباك (Confusion Matrix) بين قرارات الكاشف والوسوم المحددة بصورة مستقلة. تأمّل 10,000 صورة افتراضية: 100 منها مولَّدة و9,900 غير مولَّدة. وعند عتبة ثابتة واحدة، يضع الكاشف علامة (Flag) على 90 صورة مولَّدة وعلى 99 صورة غير مولَّدة.
| الوسم المعروف | معلَّمة | غير معلَّمة | الإجمالي |
|---|---|---|---|
| مولَّدة | 90 إيجابية حقيقية (TP) | 10 سلبيات كاذبة (FN) | 100 |
| غير مولَّدة | 99 إيجابية كاذبة (FP) | 9,801 سلبية حقيقية (TN) | 9,900 |
| الإجمالي | 189 | 9,811 | 10,000 |
يعرض الشكل الآتي المصفوفة نفسها، ويبلغ الضبط (Precision) فيها 47.62%.
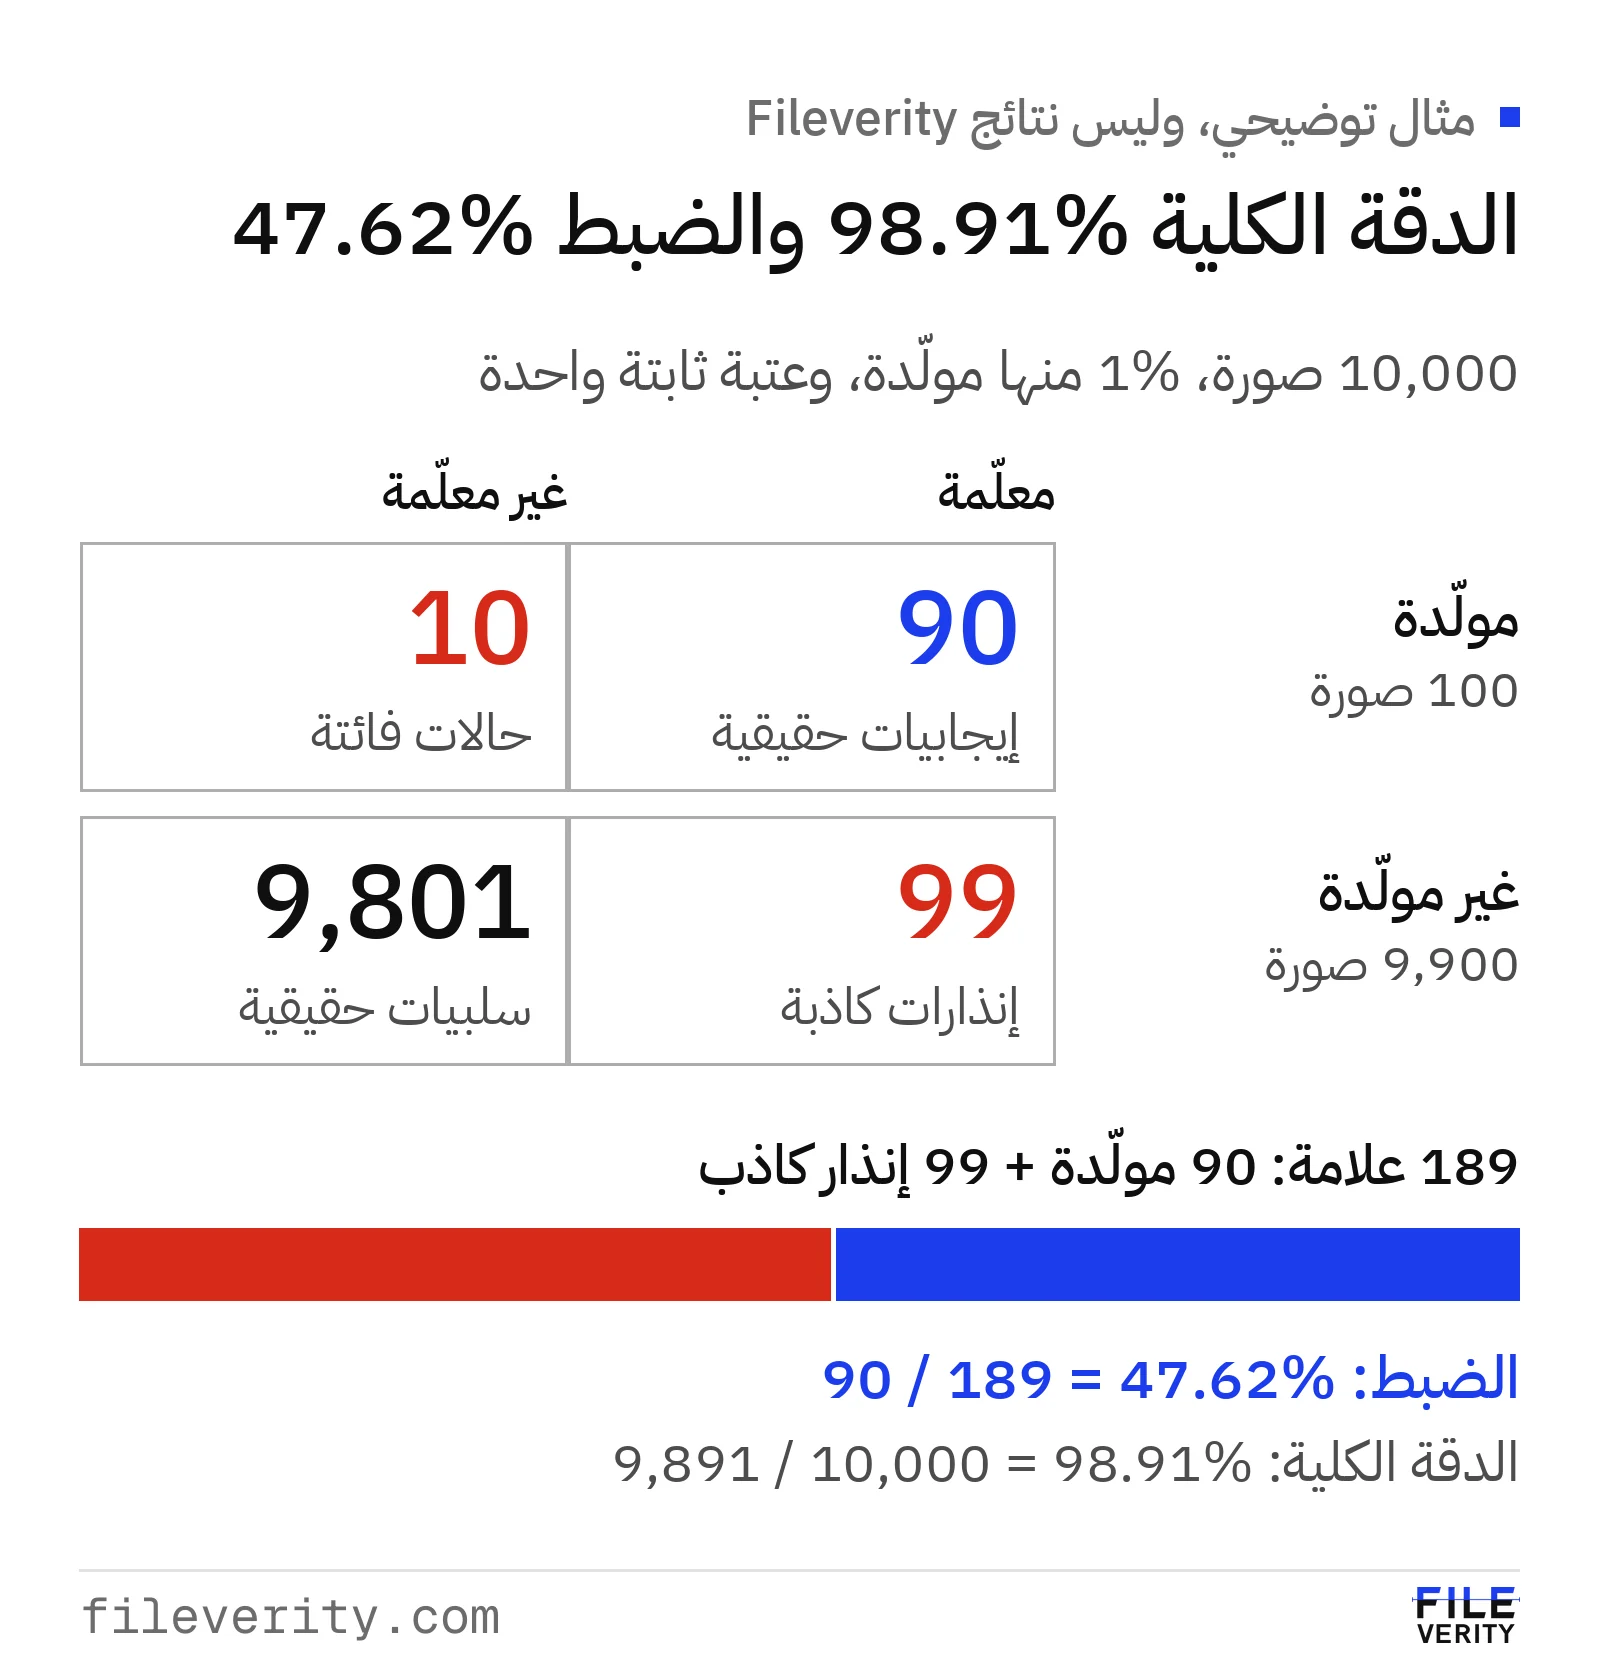
من بين 189 علامة، 90 علامة صحيحة و99 إنذارًا كاذبًا، رغم أن الدقة الكلية تبلغ 98.91%.
يجيب كل مقياس عن سؤال مختلف:
| المقياس | طريقة الحساب | النتيجة | السؤال الذي يجيب عنه |
|---|---|---|---|
| الدقة الكلية (Accuracy) | (TP + TN) / جميع الصور | 98.91% | كم قرارًا كان صحيحًا؟ |
| الاستدعاء (Recall) أو الحساسية | TP / (TP + FN) | 90% | كم صورة مولَّدة جرى العثور عليها؟ |
| معدل السلبيات الكاذبة | FN / (TP + FN) | 10% | كم صورة مولَّدة فاتت الكاشف؟ |
| معدل الإيجابيات الكاذبة (FPR) | FP / (FP + TN) | 1% | كم صورة غير مولَّدة وُضعت عليها علامة؟ |
| النوعية (Specificity) | TN / (FP + TN) | 99% | كم صورة غير مولَّدة نجت من العلامة؟ |
| الضبط (Precision) أو القيمة التنبؤية الإيجابية (PPV) | TP / (TP + FP) | 47.62% | كم علامة كانت صحيحة؟ |
ملاحظة حول المصطلحات. لا يوجد مصطلح عربي موحد لهذه المقاييس؛ فتطلق المراجع كلمة «الدقة» على Accuracy تارة وعلى Precision تارة أخرى. ولذلك يستخدم هذا الدليل «الدقة الكلية» مقابل Accuracy، و«الضبط» مقابل Precision، و«الاستدعاء» مقابل Recall. وإذا أعلن مورّد «دقة 99%» فاطلب منه أن يحدد أي المقياسين يقصد، وعلى أي مقام.
الضبط هو 90/189، مقرَّبًا إلى 47.62%. والتمييز بين معدل الإيجابيات الكاذبة والضبط حاسم: فمعدل إيجابيات كاذبة قدره 1% لا يعني أن 1% فقط من الصور المعلَّمة إنذارات كاذبة، فالمقامان مختلفان. وفي هذا المثال تشكّل الإنذارات الكاذبة 99/189، أي 52.38%، من العلامات. وتورد الوثائق المرجعية لمكتبة scikit-learn حول مقاييس التصنيف (بالإنجليزية) التعريفات المعيارية وعلاقتها بمصفوفات الارتباك.
ولو اعتُمدت قاعدة لا تضع علامة على أي صورة أبدًا لحققت دقة كلية قدرها 99% على المجموعة نفسها دون أن تعثر على أي صورة مولَّدة. وهذا لا يجعلها كاشفًا مفيدًا؛ بل يبيّن كيف قد تكافئ مقارنة أرقام الدقة المعلنة السلوك الخاطئ حين تهيمن فئة واحدة.
احسب أثر معدل الانتشار في قائمة انتظار المراجعة
معدل الانتشار (Prevalence) هو نسبة الحالات الإيجابية في المجتمع الإحصائي الذي يجري تقييمه، وهو 1% في هذا المثال. وعند تثبيت الاستدعاء ومعدل الإيجابيات الكاذبة (FPR)، يتبع الضبط المتوقع (PPV) العلاقة الآتية:
PPV = (Recall × Prevalence) / [(Recall × Prevalence) + (FPR × (1 − Prevalence))]
وباستخدام النسب العشرية يصبح الحساب:
0.90 × 0.01 / [(0.90 × 0.01) + (0.01 × 0.99)] = 0.009 / 0.0189 = 47.619…%
تستخدم السيناريوهات الآتية أعدادًا متوقعة، فالعدد الكسري يصف متوسطًا متوقعًا لا جزءًا مرصودًا من صورة.
نتائج متوقعة افتراضية لكل 10,000 صورة، مع تثبيت الاستدعاء عند 90% ومعدل الإيجابيات الكاذبة عند 1%.
| معدل الانتشار الافتراضي | العلامات الصحيحة المتوقعة | العلامات الكاذبة المتوقعة | الضبط المتوقع |
|---|---|---|---|
| 0.1% | 9 | 99.9 | 8.26% |
| 1% | 90 | 99 | 47.62% |
| 10% | 900 | 90 | 90.91% |
| 50% | 4,500 | 50 | 98.90% |
لذلك قد يحقق اختبار مرجعي متوازن ضبطًا لافتًا لا ينتقل إلى قناة استلام منخفضة الانتشار. ويفترض هذا الحساب أن أداء كل فئة يبقى ثابتًا؛ أما عمليًا فقد تحتوي قناة أخرى على صور أصعب، فيتغير الاستدعاء ومعدل الإيجابيات الكاذبة أنفسهما.
لا تقدّر معدل الانتشار من نسبة الصور المعلَّمة، فهذه النسبة تتضمن الأخطاء. استخدم عينة موسومة بصورة مستقلة من قناة الاستلام، ووثّق الوسوم التي لم تُحسم، وجرّب عدة سيناريوهات معقولة إذا بقي التقدير غير مؤكد. واستعن بهذه السيناريوهات لتحديد طاقة المراجعة قبل الالتزام بعتبة.
اختر العتبة بحسب الإجراء الذي تطلقه
إذا كانت القيم الأكبر للدرجة تدل على دليل أقوى على التوليد، فإن خفض عتبة وضع العلامة يُدخل صورًا أكثر في القائمة. وعلى مجموعة الدرجات نفسها لا يمكن لهذا الخفض أن يزيل صورًا سبق وضع علامة عليها، ولذلك قد تزداد حالات الكشف الصحيحة والإنذارات الكاذبة معًا. أما رفع العتبة فيحدث العكس. ولا يتحسن الضبط بالضرورة عند كل خطوة؛ فالذي يحدد ذلك هو ترتيب الوسوم الفعلية على سلّم الدرجات.
وفيما يلي مقارنة افتراضية مبنية على المجموعة نفسها المكوَّنة من 10,000 صورة. ولم نُسند قيمًا فعلية لعتبات الدرجات لأن مقاييس الدرجات تختلف من نظام إلى آخر.
مقارنة افتراضية للعتبات: الصور نفسها (100 مولَّدة و9,900 غير مولَّدة) عند كل عتبة.
| العتبة | إيجابيات حقيقية | إيجابيات كاذبة | إيجابيات فائتة | الاستدعاء | معدل الإيجابيات الكاذبة | الضبط | حجم قائمة الانتظار |
|---|---|---|---|---|---|---|---|
| منخفضة | 95 | 297 | 5 | 95% | 3% | 24.23% | 392 |
| متوسطة | 90 | 99 | 10 | 90% | 1% | 47.62% | 189 |
| مرتفعة | 70 | 20 | 30 | 70% | 0.202% | 77.78% | 90 |
يوضح الشكل الآتي حجم قائمة الانتظار وعدد الصور الفائتة عند كل عتبة.
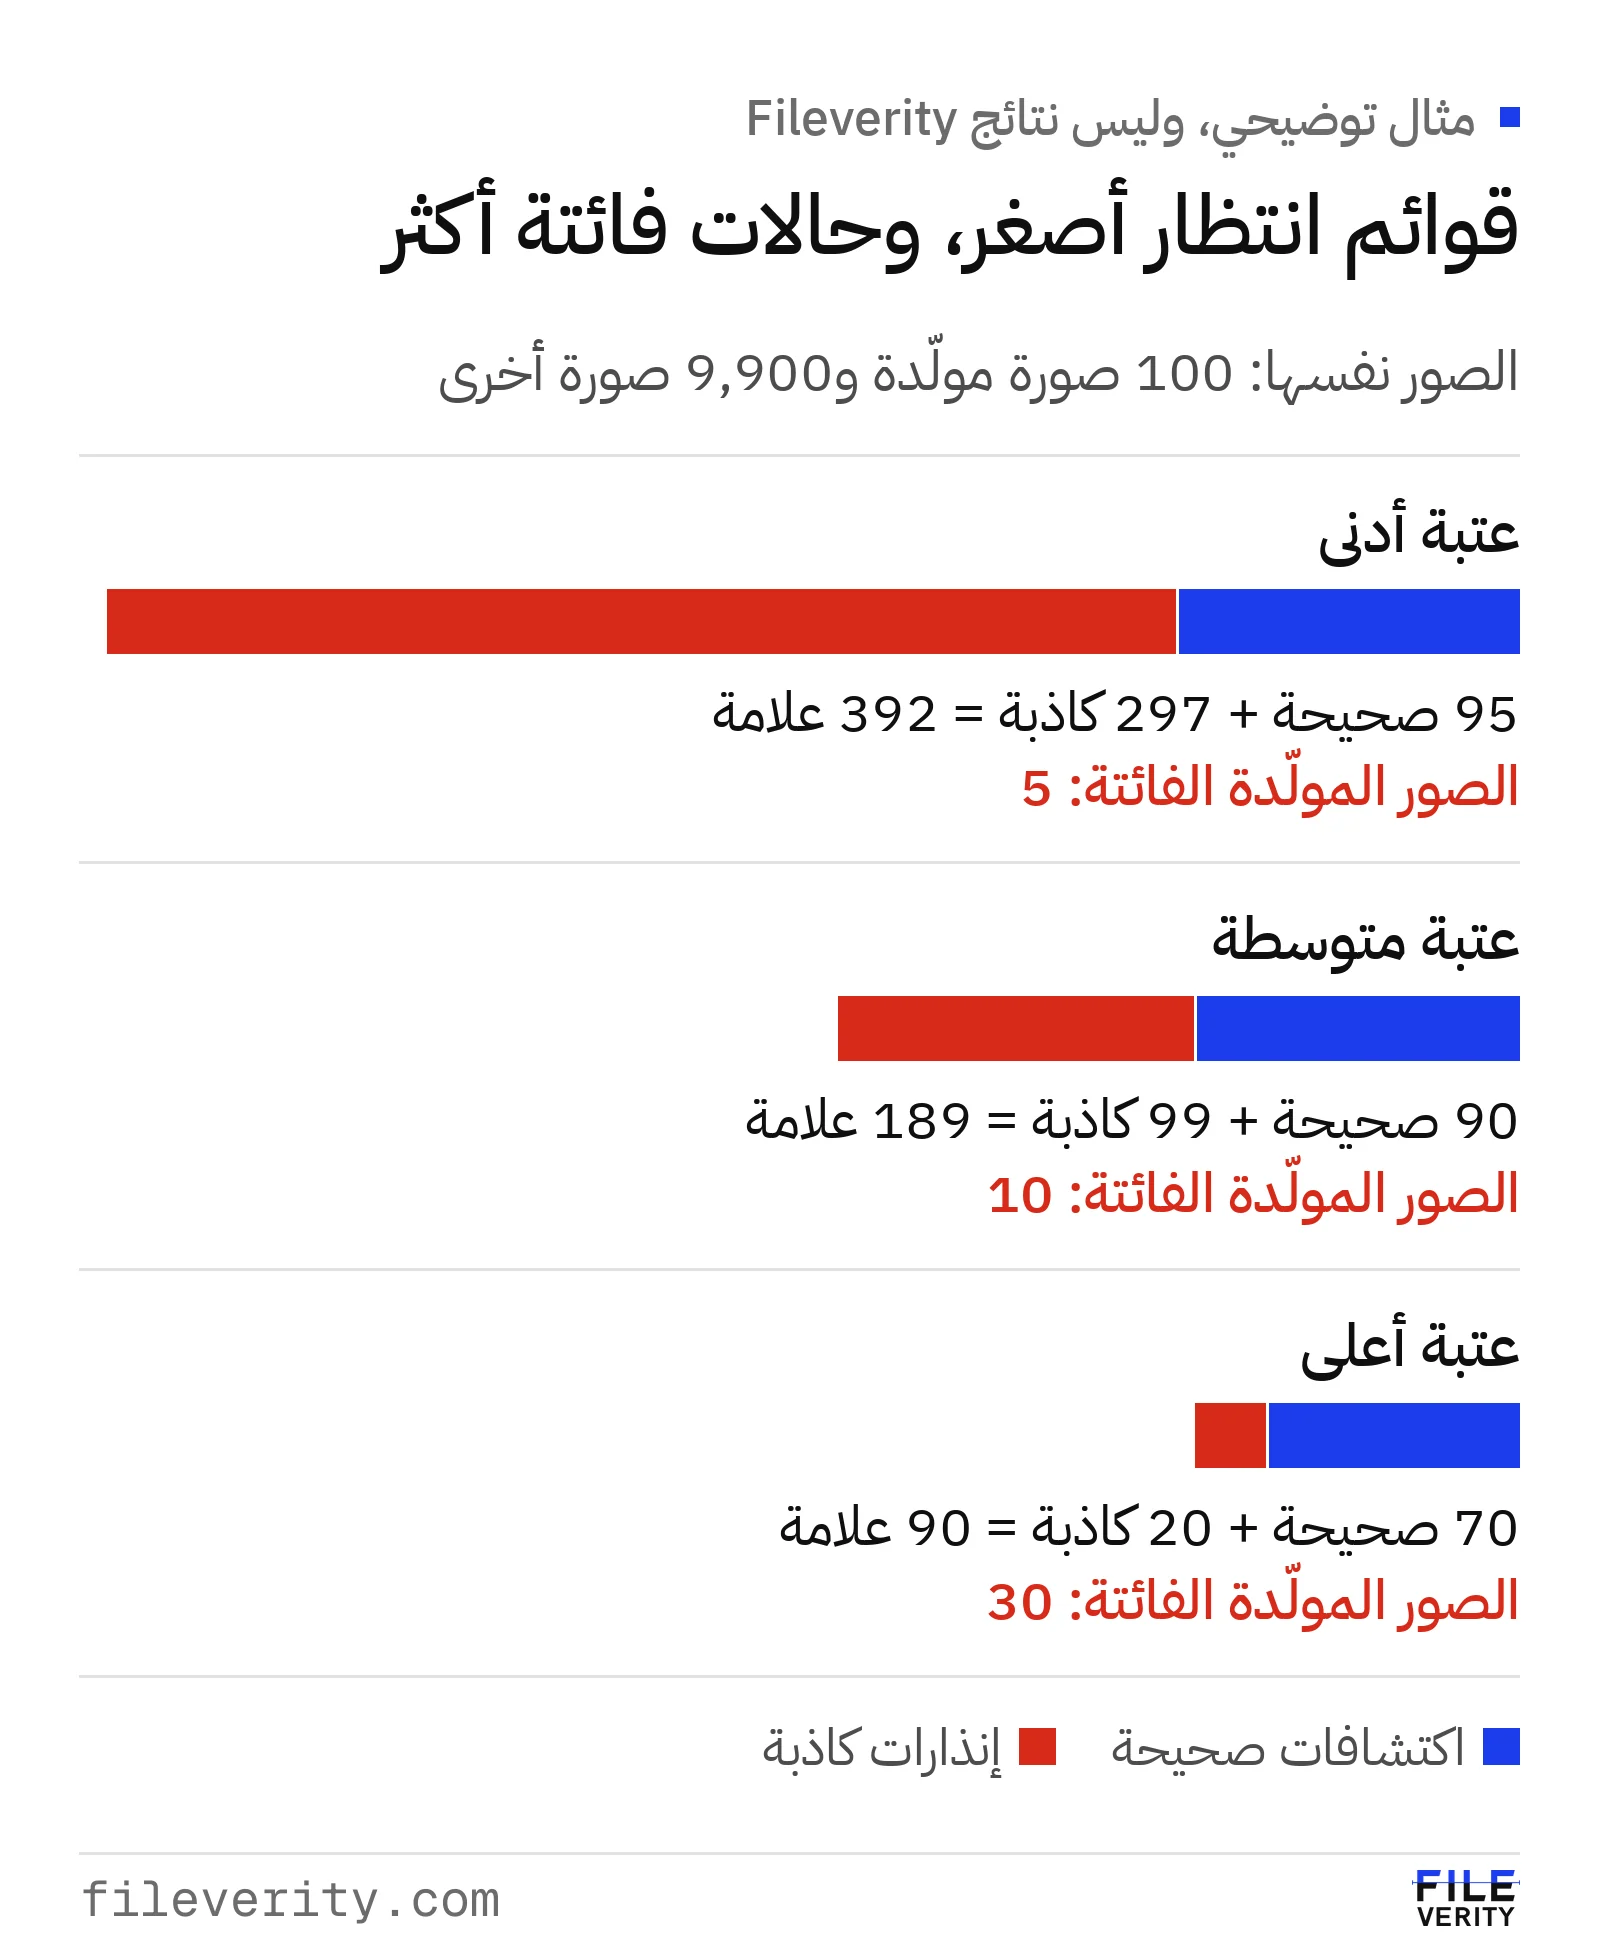
رفع العتبة يخفض قائمة الانتظار من 392 إلى 90 صورة، لكنه يرفع الإيجابيات الفائتة من 5 إلى 30.
وبافتراض ست دقائق لكل صورة معلَّمة، تتطلب هذه القوائم 39.2 و18.9 و9 ساعات عمل على التوالي، قبل أي تحقيق إضافي. وإذا افترضنا أن ساعة العمل تكلّف 100.00 ر.س (رقم توضيحي وليس أجرًا سائدًا في أي سوق، فاستبدل به تكلفة فريقك)، فإن تكلفة القوائم الثلاث تبلغ 3,920.00 ر.س و1,890.00 ر.س و900.00 ر.س. واختيار أصغر قائمة يعني أيضًا قبول 30 حالة فائتة بدلًا من خمس حالات. ولا يُعدّ أي من الخيارين صحيحًا في ذاته: فالإجراء المقصود والمراجعون المتاحون وعواقب الأخطاء هي التي تحدد المقبول.
اطلب الأداء عند نقطة التشغيل التي تنوي استخدامها. يلخّص منحنى ROC الاستدعاء مقابل معدل الإيجابيات الكاذبة عبر العتبات، لكن المساحة تحته لا تبيّن الاستدعاء عند الحد الذي تقبله من الإنذارات الكاذبة. وتتناول وثيقة NIST عرض معدل الإيجابيات الحقيقية (أي الاستدعاء) عند معدل إيجابيات كاذبة منخفض محدد (TPR@FPR) حين يترتب على الاتهامات الخاطئة عواقب جسيمة. NIST AI 100-4، القسم 4.2.2 والملحق E (ملف PDF بالإنجليزية)
ميّز بين درجة الثقة والمعايرة
قد تكون الدرجة 90 مؤشر ترتيب، أو ناتجًا محوَّلًا من النموذج، أو تقديرًا للاحتمال. وليست بالضرورة احتمالًا بنسبة 90% للتوليد، ولا تعني أن 90% من البكسلات عُدّلت. احصل على تعريف الدرجة قبل أن تنسب إلى الرقم أي معنى.
تسأل المعايرة (Calibration) عمّا إذا كانت تقديرات الاحتمال تتوافق مع التكرارات المرصودة في حالات متماثلة. ويسأل التمييز (Discrimination) عمّا إذا كانت الدرجات تفصل بين الفئات المستهدفة. كلاهما مهم، ولا يغني أحدهما عن الآخر. ويبيّن التشخيص العملي الآتي كيف تفحص ادعاء الاحتمال قبل اعتماده في سياسة التشغيل.
داخل الدرجة: اختبر المعايرة بالتكرارات المرصودة
المعايرة خاصية ينبغي اختبارها في أي كاشف، بما في ذلك كاشفنا. والجدول الآتي تقييم توضيحي، وليس بيانات من Fileverity. وطريقة عملية لفحص المعايرة هي مخطط الموثوقية (Reliability Diagram): صنّف التنبؤات في نطاقات احتمالية، ثم قارن متوسط التنبؤ في كل مجموعة بالتكرار الإيجابي المرصود فيها.
لمجموعة B احسب p̄_B = Σp_i/n_B وr_B = Σy_i/n_B، حيث p_i هو الاحتمال المتنبَّأ به، وy_i يساوي 1 للحالة الإيجابية المثبتة بصورة مستقلة وصفرًا فيما عدا ذلك، وn_B حجم المجموعة. ويعني التطابق التام في تلك المجموعة أن p̄_B = r_B؛ ولا يعني ذلك أن كل تنبؤ منفرد مؤكد. ويناقش Guo وزملاؤه مخططات الموثوقية وقياس المعايرة في التصنيف بالشبكات العصبية. Guo et al., ICML 2017
لنتأمل هذا التقييم التوضيحي للتصنيف الثنائي للتوليد:
| نطاق الاحتمال | الصور | متوسط التنبؤ | الإيجابيات المعروفة | التكرار الإيجابي المرصود | الفجوة المطلقة |
|---|---|---|---|---|---|
| من 0.0 إلى أقل من 0.4 | 100 | 0.20 | 10 | 0.10 | 0.10 |
| من 0.4 إلى أقل من 0.7 | 100 | 0.50 | 40 | 0.40 | 0.10 |
| من 0.7 إلى 1.0 | 100 | 0.80 | 60 | 0.60 | 0.20 |
الفجوة المطلقة المرجّحة بحجم العينة للنطاقات هي Σ(n_B/N) × |p̄_B − r_B|. وتساوي هنا (0.10 + 0.10 + 0.20) / 3 = 0.1333، أي نحو 13.3 نقطة مئوية. يصف هذا الرقم مقدار عدم التطابق في هذه المجموعات؛ وهو ليس معدل خطأ في التصنيف، ولا يعني أن كل درجة خاطئة بمقدار 13.3 نقطة. وقد يُخفي اختلاف تقسيم النطاقات فجوات مختلفة أو يكشفها، فاحتفظ بالأعداد والمخطط إلى جانب الملخص. ويعرض الشكل الآتي المجموعات الثلاث نفسها.
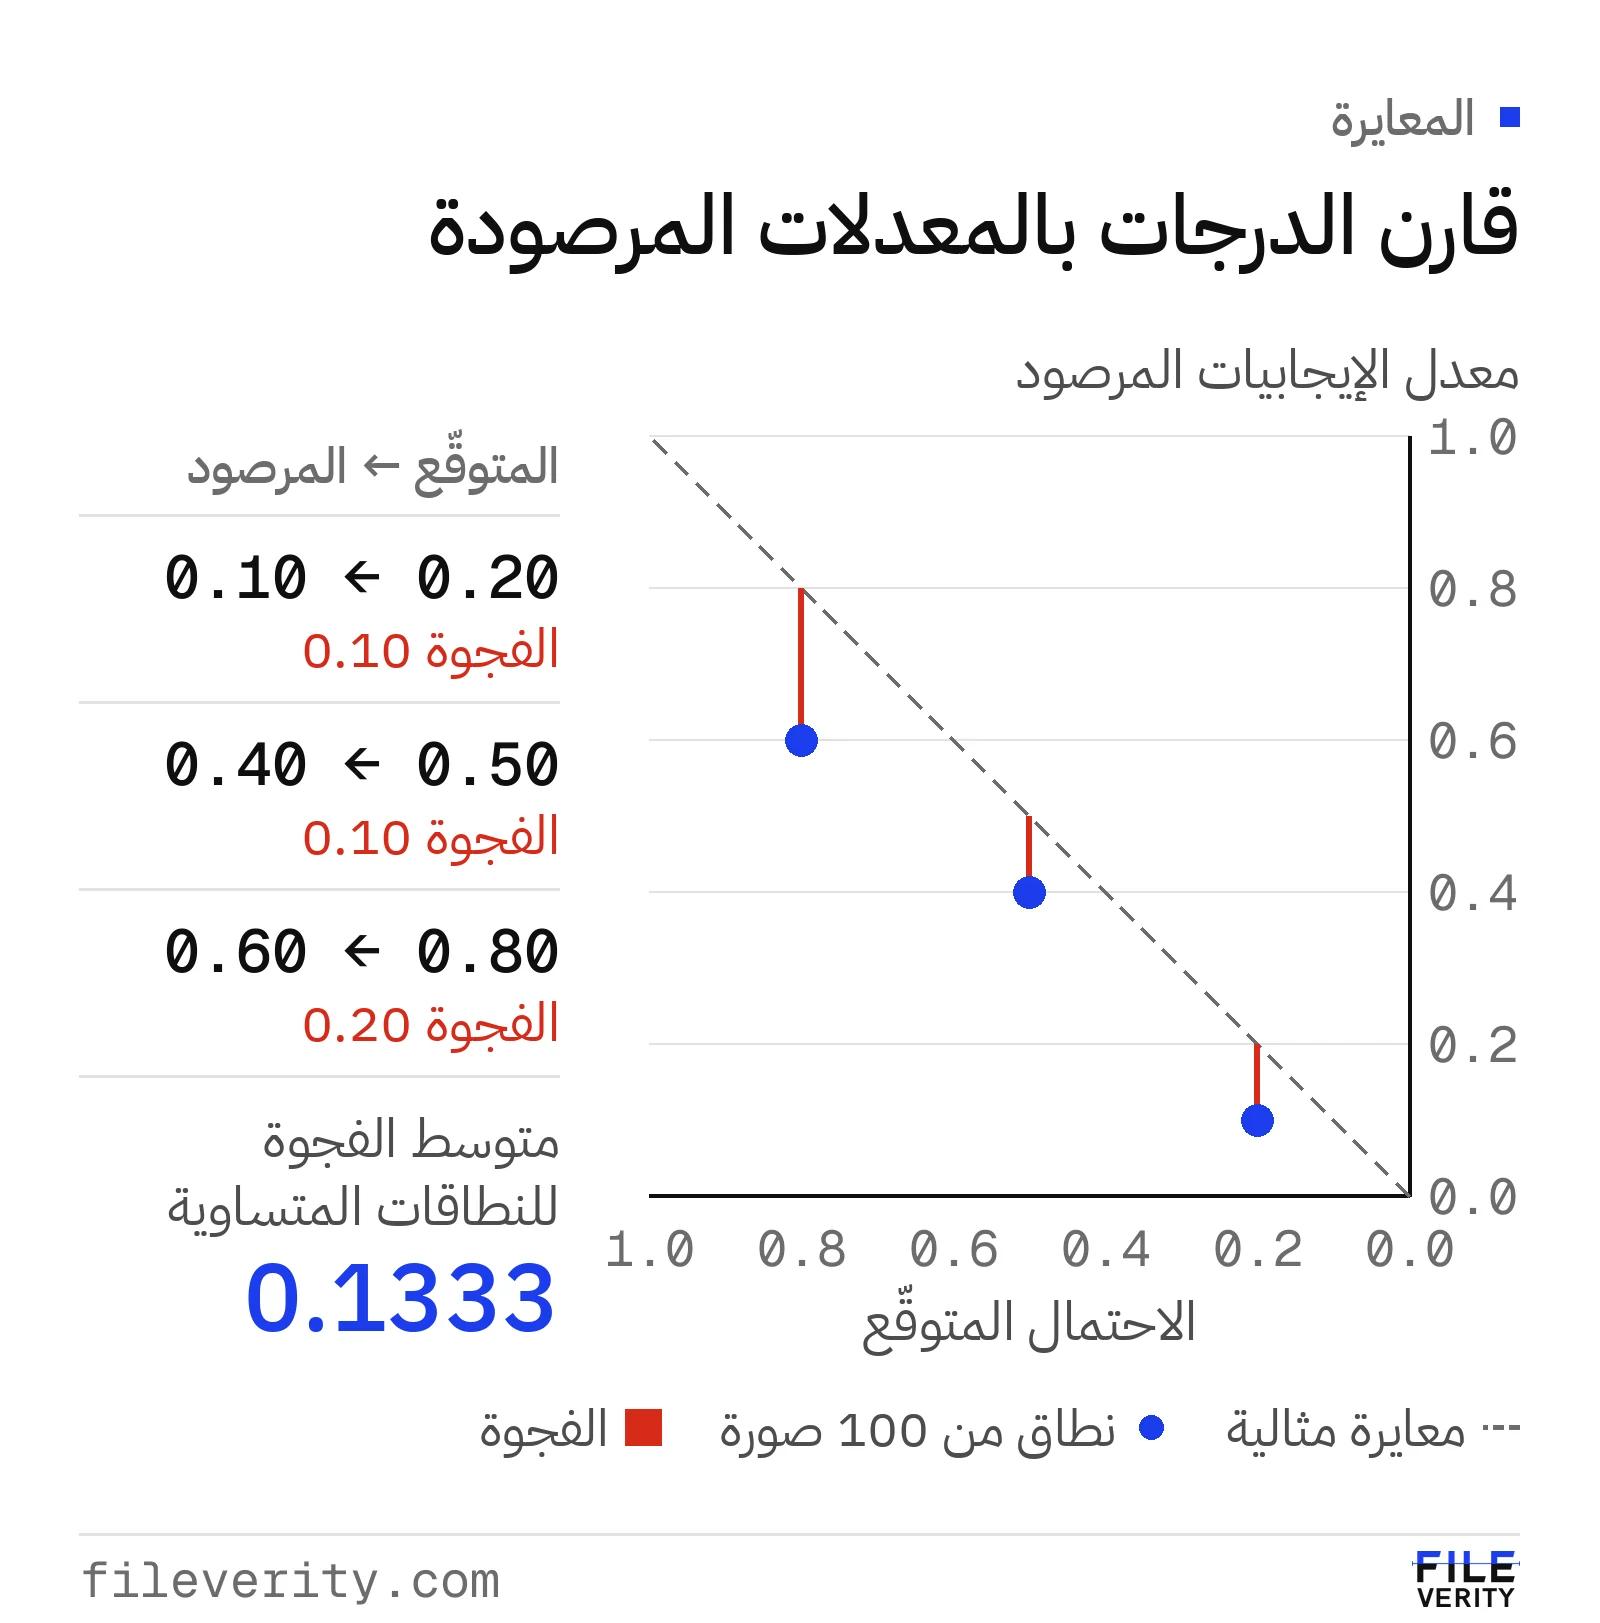
بيانات معايرة توضيحية، 100 صورة في كل مجموعة: تتجاوز التنبؤات التكرارات الإيجابية المرصودة بمقدار 10 و10 و20 نقطة مئوية.
لماذا يمكن أن تتحسن المعايرة دون أن يتحسن التمييز؟ لأن أي تحويل متزايد تمامًا للدرجات يحفظ ترتيب كل زوج منها، فيبقى مقياس الترتيب مثل المساحة تحت منحنى ROC (ROC AUC) ثابتًا، بينما قد تقترب قيم الاحتمال من التكرارات المرصودة. وقد تتغير القيمة العددية للعتبة المقابلة للقرارات نفسها. لذلك اطلب أدلة عن أخطاء الترتيب أو نقطة التشغيل، وعن تفسير الاحتمال معًا.
وتعتمد المعايرة كذلك على المجتمع الإحصائي الذي جرى تقييمه. فقد بيّن Ovadia وزملاؤه أن تقديرات عدم اليقين قد تسوء عند انزياح البيانات. Ovadia et al., NeurIPS 2019 واضبط أي دالة معايرة على بيانات منفصلة عن عينة القبول النهائية، ثم افحص قنوات الاستلام المعنية كلًّا على حدة. وأدرج قنوات الاستلام الخاصة بك في فحص المعايرة هذا.
أبقِ الملفات غير الحاسمة وغير المدعومة في المقام
قد يمتنع الكاشف عن الحكم، أو يرفض صيغة غير مدعومة، أو تنتهي مهلة معالجته، أو يُرجع تحذيرًا بشأن الجودة. وتحتاج هذه النتائج إلى عدّ منفصل؛ فاستبعادها قد يجعل النظام يبدو موثوقًا لأن أصعب حالاته اختفت من الحساب.
لنأخذ دفعة افتراضية أخرى: 1,000 طلب، منها 850 حصلت على تصنيف قابل للاستخدام، و100 على نتيجة غير حاسمة، و50 أخفقت معالجتها. تغطية التصنيف هي 850/1,000 = 85%. وإذا كان 833 تصنيفًا صحيحًا، فإن الدقة الكلية بين الطلبات المصنَّفة هي 833/850 = 98%. وعلى مستوى جميع الطلبات، حصل 83.3% على تصنيف صحيح؛ وهذا رقم وصفي يراعي التغطية، وليس دقة ثنائية بالمعنى المعتاد. أما الطلبات الباقية وعددها 150 فغير محسومة، وليست خاطئة أو سلبية بالضرورة.
اعرض الدقة الكلية والتغطية معًا، ثم فصّل التغطية بحسب الوسم المعروف وقناة الاستلام؛ فقد يمتنع النظام عن الحكم في الحالات الإيجابية أكثر من غيرها. واعرض الاستدعاء الإجمالي مع بيان صريح لكيفية معاملة الحالات التي امتنع الكاشف عن الحكم فيها، إلى جانب الاستدعاء المقصور على الحالات المصنَّفة، ليرى المستخدمون ما يستبعده كل مقام. ووفّر مسارًا بديلًا للملفات غير المحسومة وضمّنه في تقديرات عبء العمل. وقد تدخل لقطات الشاشة والصور التي ضُغطت أكثر من مرة ضمن الملفات التي يصعب الحكم عليها؛ ويوضح دليل فحص لقطات الشاشة والصور المضغوطة أي ملف ينبغي أن تطلبه من جديد.
ابنِ مجموعة اختبار ممثِّلة ومحجوزة بالكامل
يحتاج التقييم إلى وسوم يمكن الدفاع عنها وخطة لأخذ العينات. استخدم مواد مصرَّح باستخدامها وموثَّقة المصدر: أمثلة مولَّدة في ظروف مضبوطة، وصورًا أصلية ملتقطة بالكاميرا ذات تاريخ التقاط معروف، وتعديلات موسومة على حدة عند الحاجة. ورأي كاشف آخر ليس حقيقة مرجعية. أبقِ الوسوم المتنازع عليها غير محسومة ووثّق قاعدة الفصل فيها.
اجعل العينة ممثِّلة للملفات كما تصلك فعلًا، لا للأصول النقية وحدها. وأدرج القنوات وأحجام الصور وفئات المحتوى وأنماط المعالجة والتداول المعتادة التي تمر بها الملفات قبل وصولها إلى مسار عملك. وعند تقسيم البيانات أبقِ النسخ المشتقة من الصورة المصدر نفسها معًا؛ وإلا فقد يتسرب المشهد الأساسي نفسه إلى بيانات التطوير وبيانات التقييم معًا. وافصل كذلك جلسات الالتقاط ومجموعات المصادر متى أمكن.
استخدم مجموعة تطوير لاختيار العتبات، ومجموعة اختبار محجوزة مستقلة لفحص السياسة المختارة مرة واحدة. وإذا دفع إخفاق في المجموعة المحجوزة إلى إجراء تعديلات، فاعتبرها جزءًا من بيانات التطوير، واحصل على مجموعة اختبار جديدة لم تُستخدم في أي تعديل لتقييم السياسة المعدّلة. وفي الخدمات المغلقة المصدر، اسأل عن أي تداخل معروف مع الاختبارات المرجعية العامة، وأقرّ بحدود ما يمكن التحقق منه من تداخل بيانات التدريب.
واحتفظ بمجموعة تحدٍّ صُمّمت لتكون صعبة عمدًا بوصفها مكمّلًا، واعرض نتائجها بمعزل عن العينة الممثِّلة حتى لا يُظن أن الإفراط في تمثيل الحالات غير المعتادة هو معدل الانتشار الطبيعي في قناة الاستلام. وتختبر الأبحاث في كشف الصور المولَّدة التعميم عبر أدوات التوليد على وجه التحديد، لأن النجاح مع مصدر واحد لا يثبت تغطية شاملة. Wang et al., CNN-generated images are surprisingly easy to spot… for now
حدّد معايير القبول قبل الاطلاع على النتائج
اكتب سجل تقييم يربط كل مقياس بالقرار الذي ينبغي أن يدعمه.
أمثلة على معايير القبول في مسار يوجّه الصور إلى مراجعة بشرية.
| البند | مثال على المعيار أو السجل |
|---|---|
| الاستخدام المقصود | توجيه الصور إلى مراجعة بشرية؛ دون اتخاذ أي قرار سلبي تلقائي بحق صاحب الصورة |
| الإعداد المثبَّت | تسجيل إصدار الخدمة والعتبة وتعريف الدرجة والمعالجة المسبقة |
| الإنذارات الكاذبة | ألا يتجاوز الحد الأعلى أحادي الجانب بثقة 95% لمعدل الإيجابيات الكاذبة نسبة 1% |
| الكشف | ألا يقل الحد الأدنى أحادي الجانب بثقة 95% للاستدعاء عن 85% |
| التغطية | تصنيف 95% على الأقل من الملفات؛ ولكل ملف غير محسوم مسار بديل |
| طاقة المراجعة | أن يقع إجمالي عبء المراجعة والمسار البديل ضمن ميزانية يومية محددة مسبقًا من ساعات المراجعين |
| المجموعات الفرعية | عرض نتائج كل قناة استلام حرجة على حدة؛ وما لا تكفي أدلته يبقى غير محسوم |
| صاحب القرار | مراجع معيَّن بالاسم يسجّل قرار القبول أو الرفض أو إجراء تجربة أولية محدودة |
تمنع حدود الثقة أن تُعدّ عينة صغيرة نظيفة يقينًا. فمع صفر إيجابيات كاذبة بين 300 حالة سلبية مستقلة، يبلغ الحد الأعلى الدقيق وفق التوزيع ذي الحدين (أحادي الجانب وبمستوى ثقة 95%) نحو 1 − 0.05^(1/300)، أي ما يقارب 0.994%. ومع صفر بين 100 حالة يبلغ نحو 2.951%.
الاشتقاق قصير: إذا كان احتمال الإيجابية الكاذبة هو p، فإن احتمال عدم ظهور أي إيجابية كاذبة في n حالة سلبية مستقلة هو (1 − p)^n؛ وبمساواته بالقيمة 0.05 نحصل على الحد الأعلى p = 1 − 0.05^(1/n). فعدم رصد أي خطأ لا يثبت أن معدل الخطأ صفر. وتفترض هذه الحسابات حالات مستقلة وممثِّلة؛ أما الصور المتشابهة تقريبًا فلا توفر من الأدلة ما توفره الطلبات المستقلة.
ومعدل الإيجابيات الكاذبة المرصود في مثال العتبة المتوسطة، وهو 1%، لا يستوفي شرطًا يقضي بألا يتجاوز حده الأعلى للثقة 1%. فالتقدير النقطي وحد عدم اليقين يجيبان عن سؤالين مختلفين. خطّط لحجم العينة بحسب الأدلة المطلوبة قبل جمع مجموعة الاختبار.
راقب الانجراف وصُغ الاستنتاجات بحذر
بعد بدء التشغيل، راقب معدلات وضع العلامات، ومعدلات الحالات غير المحسومة، وتوزيع القنوات، وزمن المراجعة، والنتائج المؤكدة بصورة مستقلة. فارتفاع معدل العلامات وحده لا يميّز بين زيادة الصور المولَّدة وزيادة الإنذارات الكاذبة. وخذ عينات من الحالات غير المعلَّمة أيضًا، فمراجعة العلامات وحدها تُبقي الإيجابيات الفائتة غير مرئية في معظمها. وراعِ احتمالات أخذ العينات عند تقدير المقاييس على مستوى الاستلام بأكمله انطلاقًا من مجموعات أُفرط عمدًا في أخذ العينات منها.
سجّل التغييرات في النموذج والعتبة وعملية الاستلام. وأعد التقييم بعد أي تغيير جوهري، وأبقِ على فحوص دورية بوسوم حتى حين تبدو متوسطات لوحة المتابعة مستقرة. فقد تغيّر أداة توليد جديدة أو قناة تقديم جديدة أو فئة محتوى جديدة الأداء دون تنبيه عام واضح.
افصل في سجل الحالة بين الملاحظة والقرار. فعبارة «تجاوزت الصورة عتبة المراجعة» ملاحظة، وعبارة «هذا يدعم الاشتباه في التوليد» استنتاج. أما الأصل الموثَّق أو تاريخ الإنشاء الموثَّق فدليل مؤيد، وطلب هذه المواد إجراء. ولا يثبت أي من هذه العبارات وحده الاحتيال، ولا صحة المشهد المصوَّر.
حوّل الرقم المعلن إلى طلب أدلة
اطلب معلومات كافية لربط النتيجة المعلنة بقناة الاستلام لديك وبالإجراء الذي سيليها. ويمكنك نسخ الطلب الآتي عند مناقشة المورّد:
نحتاج إلى تقييم [توليد الصورة بالكامل / التعديل الموضعي / مهمة محددة أخرى] على [صيغ الملفات والقنوات وظروف الجودة]. وستؤدي النتيجة إلى [إجراء المراجعة]، بمعدل يقارب [عدد الصور والحالات يوميًا]. وطاقة المراجعة لدينا [ساعات العمل أو عدد الحالات يوميًا].
يرجى تزويدنا بإصدار المنتج الذي جرى تقييمه وتعريف الدرجة؛ ومصادر الوسوم وأعداد الحالات الإيجابية والسلبية؛ والأعداد الأربعة في مصفوفة الارتباك عند نقطة التشغيل المقترحة؛ وتقديرات عدم اليقين؛ وأعداد منفصلة للمدخلات غير الحاسمة وغير المدعومة والمخفقة. ويرجى تحديد الملفات المستبعدة من كل مقياس، وبيان كيف تتغير التغطية والاستدعاء عند إدراج هذه الملفات، وما إذا كانت نسخ مشتقة من الصورة المصدر نفسها تتكرر بين بيانات التطوير وبيانات التقييم.
ويرجى بيان أي الأدلة ينطبق على هذا الاستخدام، وما الظروف التي لم تُختبر بعد، وما الذي ينبغي أن تثبته تجربة أولية.
تعرض Fileverity كل نتيجة بحسب المهمة، وتُظهر المدخلات غير الحاسمة وغير المدعومة بوصفها نتائج منفصلة بدل إخفائها، وتبيّن قوة الدليل وراء كل نتيجة؛ وتوضح صفحة منهجية تحليل الصور كيف يعمل هذا التحليل. أرسل إلينا طلب الأدلة وقنوات الاستلام لديك، وسنستعرضه مع فريقك على حالات حقيقية؛ تواصل مع فريق المبيعات. وللاطلاع على قرار الشراء الأوسع، بما في ذلك التعامل مع البيانات وتكلفة المراجعة الإجمالية، انتقل إلى قائمة التحقق لمشتري برامج كشف الصور المولَّدة بالذكاء الاصطناعي. ولمراجعة جانب التكامل (الحدود وإعادة المحاولة والاحتفاظ بالبيانات والفوترة وإشعارات Webhook) راجع كيف تختار واجهة API لكشف الذكاء الاصطناعي.
بقلم Yang Zheng · مراجعة Bill Liu