إصدار نموذج
Veread 1.1: نتائج إيجابية كاذبة أقل وتحديد أدق للمقاطع
يكتشف Veread 1.1 98.6% من النصوص المكتوبة كليًا بالذكاء الاصطناعي و92.2% من المستندات المختلطة، مع 0.28% فقط من النتائج الإيجابية الكاذبة. متاح منذ 18 نوفمبر.
نُشر في · 6 دقائق قراءة
أبرز الحقائق
- الإصدار
- Veread 1.1
- تاريخ الإصدار
- 18 نوفمبر 2026
- نتائج إيجابية كاذبة على الكتابة البشرية
- 0.28% (من 0.45%)
- نصوص مكتوبة كليًا بالذكاء الاصطناعي اكتُشفت
- 98.6%
- مستندات تمزج الكتابة البشرية بكتابة الذكاء الاصطناعي اكتُشفت
- 92.2% (من 87.3%)
- نصوص من نماذج ذكاء اصطناعي لم يرَها النموذج اكتُشفت
- 94.9%
يكتشف Veread 1.1، الذي صدر في 18 نوفمبر 2026، 98.6% من النصوص المكتوبة كليًا بالذكاء الاصطناعي، ولا يضع علامة الذكاء الاصطناعي خطأً إلا على 0.28% من الكتابة البشرية، مقابل 0.45% في Veread 1.0، وذلك عبر سبع لغات، وفي اختبار على بيانات معزولة. ويكتشف 92.2% من المستندات التي تمزج الكتابة البشرية بكتابة الذكاء الاصطناعي (مقابل 87.3%)، ويحدد المقاطع المكتوبة بالذكاء الاصطناعي بدقة 97.2%.
Veread هو نموذج Fileverity الخاص لكشف النصوص المكتوبة بالذكاء الاصطناعي، وكل فحص للنصوص والمستندات في Fileverity يعمل الآن بالإصدار 1.1.
الجديد في Veread 1.1
- تدريب يركّز على الإنجليزية والإسبانية والفرنسية. وتبقى اللغات السبع كلها في نموذج واحد: الإنجليزية والفرنسية والألمانية والإسبانية والصينية والفيتنامية والعربية.
- كتابة بشرية أوسع بكثير. مقالات الطلاب وأعمالهم الدراسية، وأبحاث أكاديمية كاملة، ورسائل وشكاوى، ومراجعات الأفلام والمنتجات، ونقاشات المنتديات، والقصص والنثر الأدبي، والنصوص القانونية والإدارية، والأخبار، والمقالات الموسوعية.
- حالات بشرية صعبة أُدرجت عن قصد. الكتابة البشرية الرسمية أو النمطية أو المصقولة، وهي النوع الذي تخطئ أدوات الكشف في نسبته إلى الذكاء الاصطناعي أكثر من غيره، صارت جزءًا أساسيًا من التدريب.
- أحدث نصوص الذكاء الاصطناعي من تسع عائلات نماذج: OpenAI وAnthropic وGoogle وDeepSeek وAlibaba وMeta وMistral وxAI وZhipu، ومنها نصوص أُعيدت صياغتها أو «أُنسنت» لتفادي الكشف، ونصوص بشرية أعاد الذكاء الاصطناعي كتابتها.
- تعليم على مستوى الجملة. كل جملة كتبها الذكاء الاصطناعي في مستند مختلط تحمل علامة، فيتعلم النموذج بدقة أين تنتهي الكتابة البشرية وأين تبدأ كتابة الذكاء الاصطناعي.
- نصوص تدريب أنظف. حُذفت أسطر الكاتب والإسناد وإشعارات ملفات تعريف الارتباط والاشتراك وعلامات التنسيق وأرقام الحواشي وعدّادات الكلمات، بالحذف وحده. فلا يُغيَّر النص نفسه أبدًا، ويحكم Veread على الكتابة لا على الشكل.
- إزالة النصوص المكررة والمتشابهة تقريبًا بين التدريب والتقييم، فلا يُختبر النموذج على نصوص رآها فعليًا.
- عتبات قرار جديدة مضبوطة على كتابة بشرية معزولة، مع إعادة معايرة تحديد المقاطع وتشابه أسلوب الكتابة مع عائلات النماذج ليلائما النموذج الجديد. ويظهر تشابه الأسلوب الآن في حالات أكثر وبدقة أعلى.
النتائج: Veread 1.1 مقابل Veread 1.0
أُجري التقييم نفسه على الإصدارين: نصوص معزولة من نحو 100 كلمة فأكثر بسبع لغات.
| المقياس | Veread 1.0 | Veread 1.1 |
|---|---|---|
| كتابة بشرية حصلت خطأً على نتيجة ذكاء اصطناعي | 0.45% | 0.28% |
| نصوص مكتوبة كليًا بالذكاء الاصطناعي اكتُشفت | 98.3% | 98.6% |
| جميع النصوص المكتوبة بالذكاء الاصطناعي أو بمساعدته اكتُشفت | 95.4% | 95.9% |
| نصوص بشرية أكملها الذكاء الاصطناعي اكتُشفت | 91.7% | 94.3% |
| مستندات تمزج الكتابة البشرية بكتابة الذكاء الاصطناعي اكتُشفت | 87.3% | 92.2% |
| مقتطفات قصيرة من نحو 100 كلمة اكتُشفت | 92.9% | 94.1% |
| مستندات كاملة اكتُشفت | 96.6% | 96.8% |
| نصوص أعاد الذكاء الاصطناعي صياغتها اكتُشفت | 92.5% | 92.8% |
| قيمة F1 لتحديد المقاطع | 90.3 | 92.9 |
| AUROC على المقتطفات القصيرة | 0.995 | 0.996 |
ويكتشف Veread 1.1 أيضًا 100% من المقاطع التي أدرجها الذكاء الاصطناعي في نص بشري، و97.6% من النصوص التي صقلها الذكاء الاصطناعي، و94.9% من نصوص نماذج ذكاء اصطناعي لم تُستخدم قط في التطوير. وتبلغ قيمة AUROC على المستندات الكاملة 0.999.
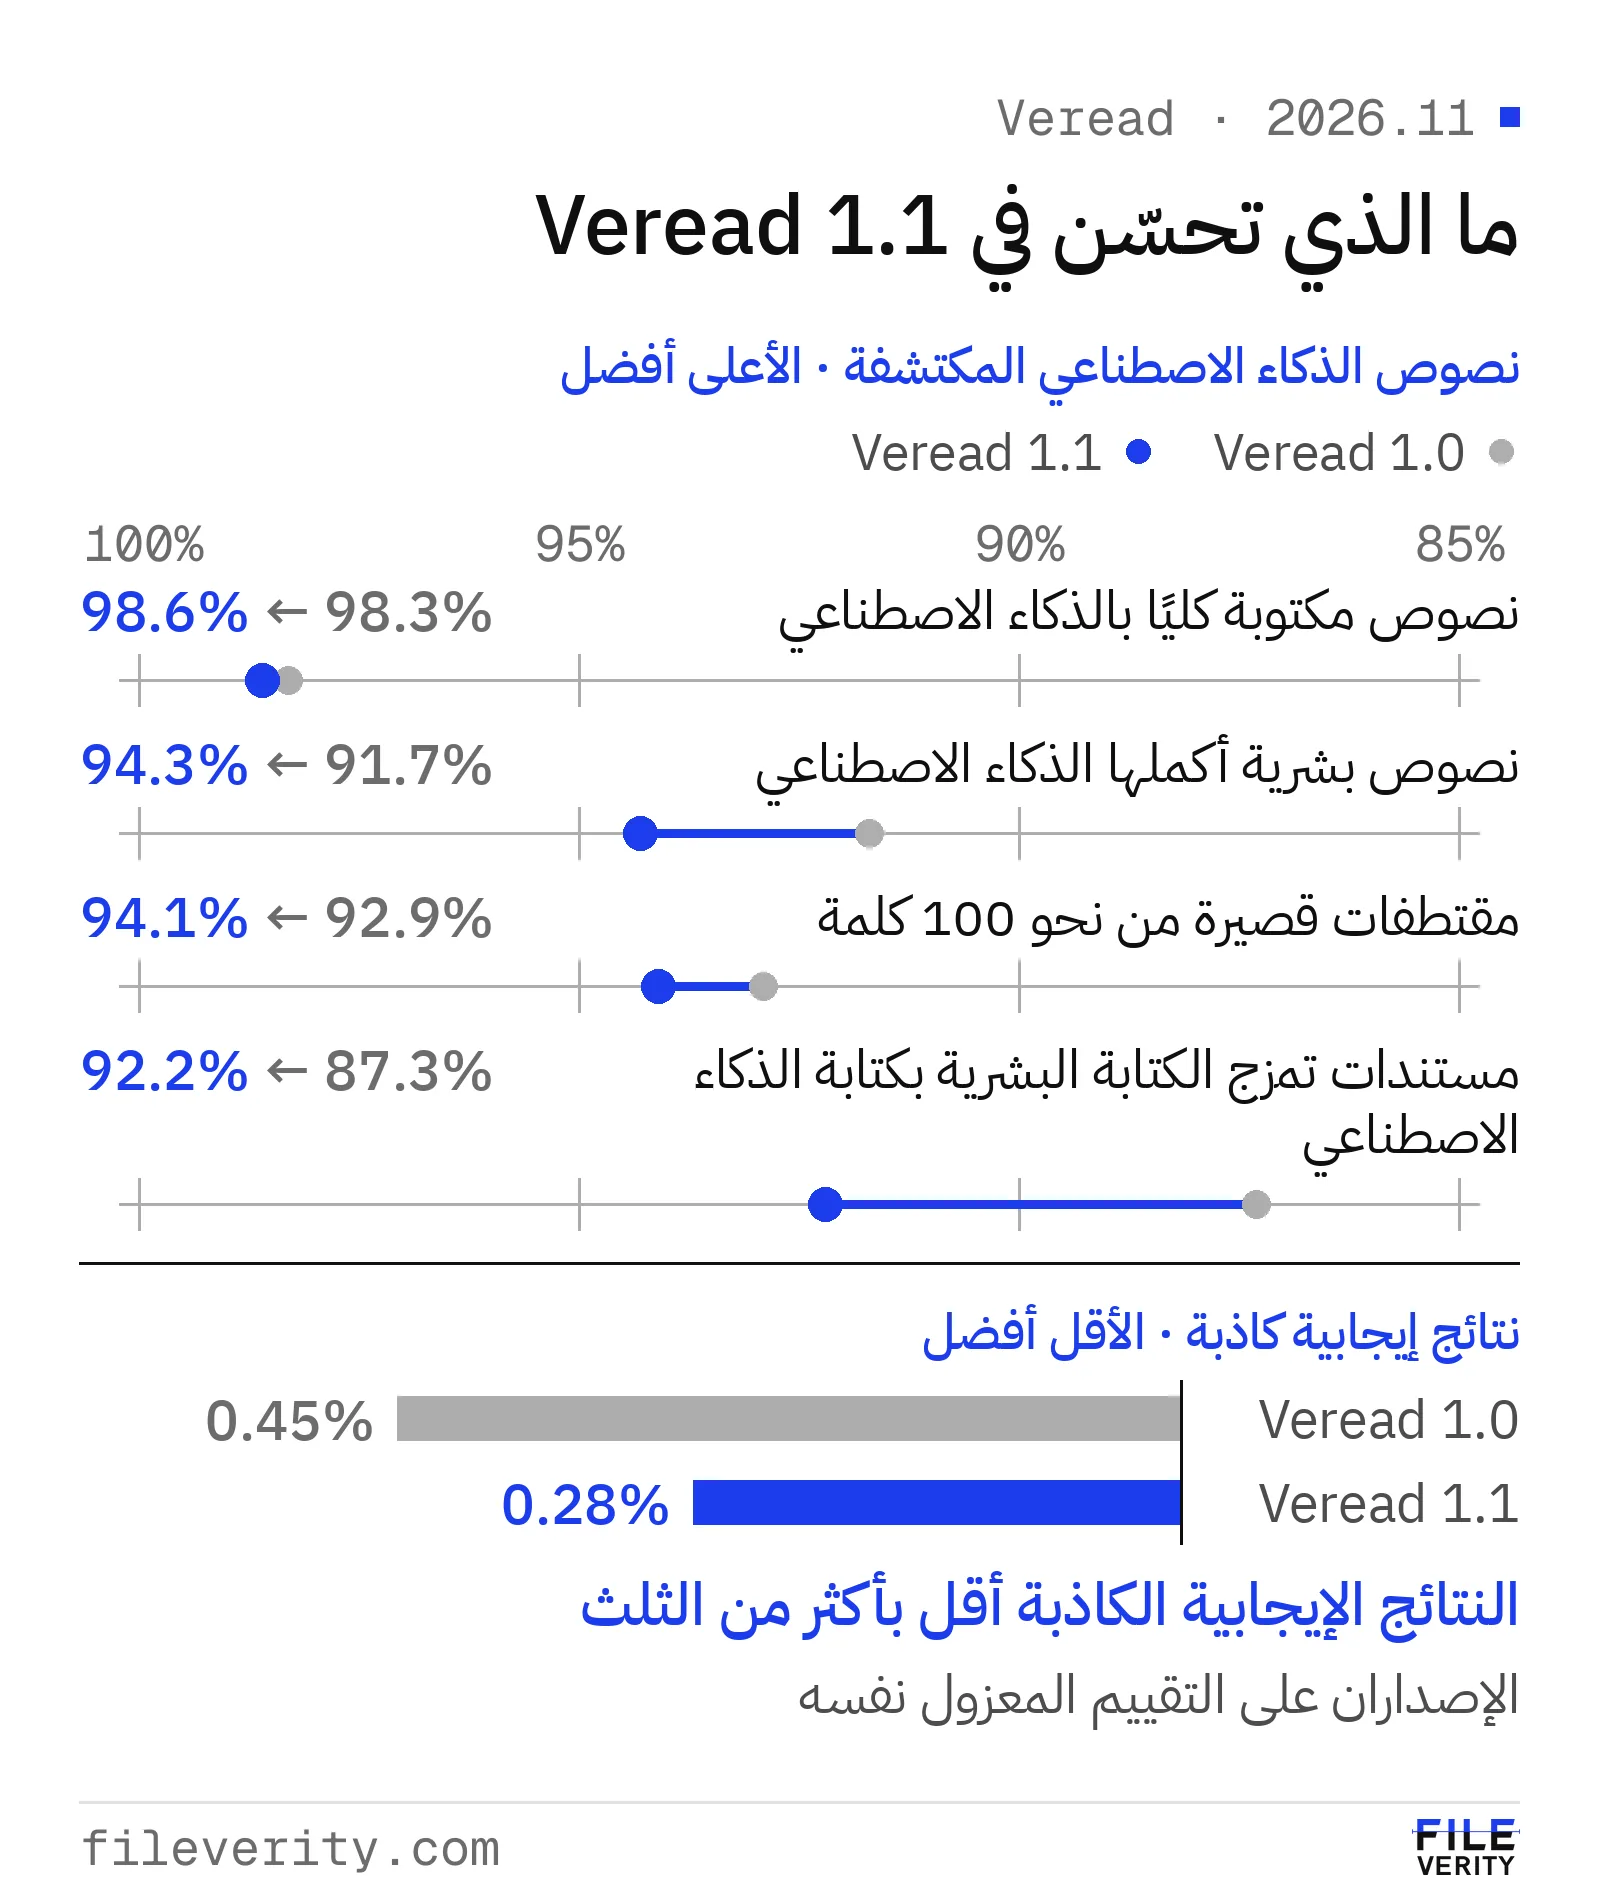
تنخفض النتائج الإيجابية الكاذبة بأكثر من الثلث بينما ترتفع نسبة الكشف في كل المقاييس الرئيسية.
المقاييس بكلمات بسيطة
- معدل النتائج الإيجابية الكاذبة: نسبة النصوص التي كتبها بشر وتحصل على نتيجة ذكاء اصطناعي. وكلما انخفض كان أفضل.
- نسبة الكشف: نسبة النصوص المكتوبة بالذكاء الاصطناعي أو بمساعدته التي يتعرف عليها Veread. وكلما ارتفعت كان أفضل.
- المكتوب بمساعدة الذكاء الاصطناعي: لا يُحتسب النص إلا إذا غيّر الذكاء الاصطناعي صياغته فعلًا، سواء أكمله أو أعاد كتابته أو صقله أو أُدرجت مقاطعه في نص بشري.
- AUROC: مدى وضوح الفصل بين درجات Veread للكتابة البشرية ودرجاتها لكتابة الذكاء الاصطناعي، أيًّا كانت نقطة القرار المختارة. والقيمة 1 تعني فصلًا تامًا.
- قيمة F1 لتحديد المقاطع: درجة واحدة تجمع بين عدد المقاطع المكتوبة بالذكاء الاصطناعي التي يعثر عليها Veread ونسبة المقاطع التي يحددها وهي مكتوبة فعلًا بالذكاء الاصطناعي.
- دقة المقاطع المحددة: نسبة النص المحدد الذي كُتب فعلًا بالذكاء الاصطناعي.
نتائج إيجابية كاذبة أقل على الكتابة البشرية
النتيجة الإيجابية الكاذبة هي عمل شخص حقيقي يُوصَف بأنه من كتابة الآلة. وهي، بالنسبة إلى المعلم أو مكتب القبول أو المحرر، الرقم الذي يحسم صلاحية أداة الكشف للاستخدام على أعمال الناس الحقيقية.
يضع Veread 1.1 علامة على 0.28% من الكتابة البشرية، أي أن النتائج الإيجابية الكاذبة انخفضت بأكثر من الثلث عن Veread 1.0. ويشمل الرقم كل الكتابة البشرية المعزولة، ومنها مجموعات بشرية مستقلة من مصادر لم تُستخدم قط في التدريب. وفي المستندات الكاملة تبلغ النسبة 0.23%.
وفي كل لغة تقل النسبة عن 0.5%. فقد انخفضت في الإنجليزية من 0.43% إلى 0.18%، وفي الإسبانية من 0.77% إلى 0.41%، وفي الفرنسية من 0.76% إلى 0.45%، وتجد القائمة الكاملة في جدول اللغات أدناه. وفي كل نوع من النصوص تقل النسبة عن 1%. فقد انخفضت في الأدب والنثر الأدبي من 0.62% إلى 0.08%، وفي المراجعات والمنتديات من 0.84% إلى 0.38%، وفي كتابة الطلاب ومتعلمي اللغة من 0.51% إلى 0.30%، وفي النصوص الأكاديمية والعلمية من 1.08% إلى 0.77%.
تحديد أدق للمقاطع في المستندات المختلطة
نادرًا ما تكون المستندات الواردة فعليًا مخرجات آلة خالصة. ولأن Veread 1.1 يتعلم من وسوم على مستوى الجملة، فإنه يكتشف 92.2% من المستندات التي تمزج الكتابة البشرية بكتابة الذكاء الاصطناعي (مقابل 87.3%)، ويحدد المقاطع بدقة 97.2%، وتبلغ قيمة F1 لتحديد المقاطع 92.9 (مقابل 90.3). وقد قيست هذه النتائج من البداية إلى النهاية عبر محرك الإنتاج.
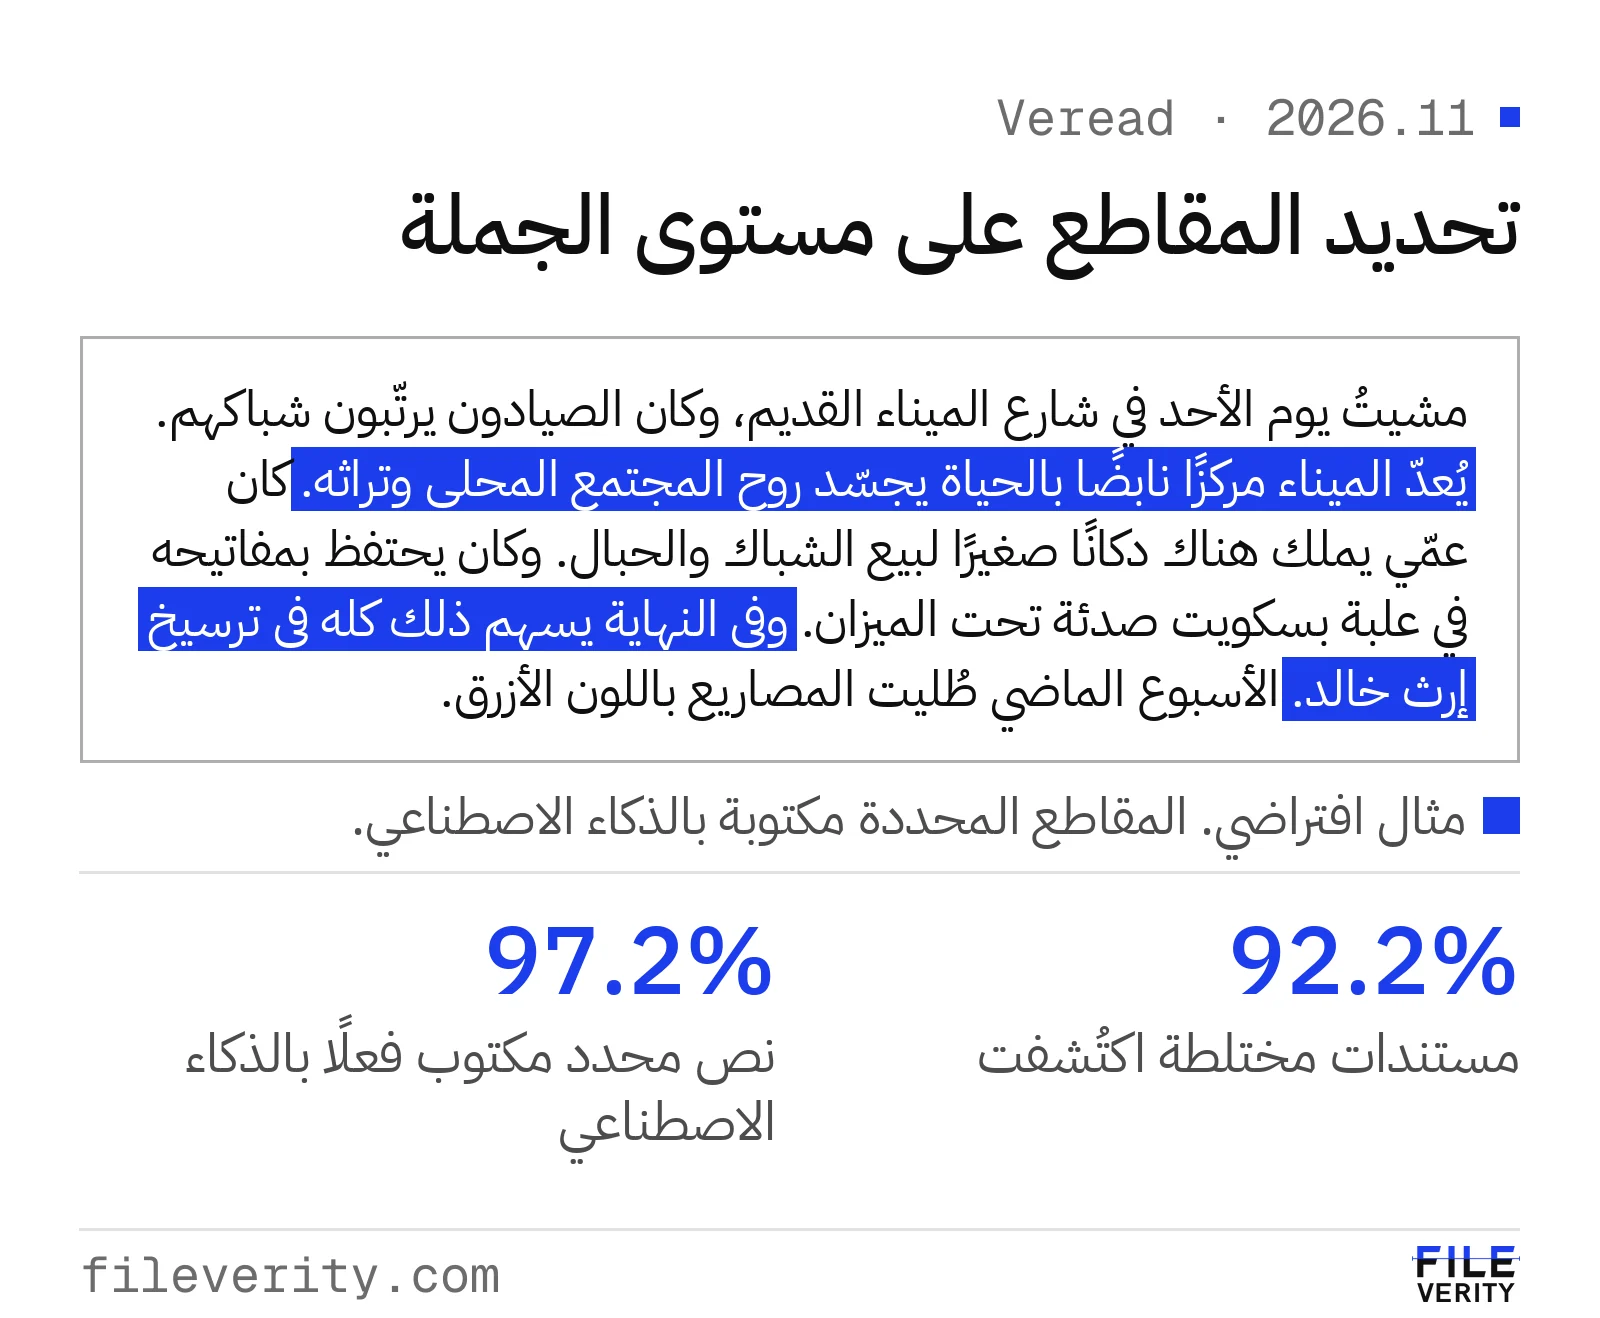
مثال افتراضي. يحدد Veread 1.1 الجمل المكتوبة بالذكاء الاصطناعي داخل مستند يتضمن أيضًا كتابة بشرية.
نتائج في اللغات السبع كلها
يخدم نموذج واحد اللغات السبع، وتُقاس كل لغة على حدة.
| اللغة | كتابة بشرية حصلت خطأً على نتيجة ذكاء اصطناعي | مكتوب بالذكاء الاصطناعي أو بمساعدته اكتُشف | مكتوب كليًا بالذكاء الاصطناعي اكتُشف |
|---|---|---|---|
| الإنجليزية | 0.18% | 94.5% | 95.1% |
| الفرنسية | 0.45% | 96.8% | 99.1% |
| الألمانية | 0.27% | 94.1% | 100% |
| الإسبانية | 0.41% | 96.0% | 100% |
| الصينية | 0.03% | 98.8% | 100% |
| الفيتنامية | 0.48% | 92.8% | 95.5% |
| العربية | 0.13% | 97.5% | 98.5% |
وارتفع كشف النصوص المكتوبة بالذكاء الاصطناعي أو بمساعدته في الإنجليزية (من 93.3%) والألمانية (من 93.2%) والفيتنامية (من 90.7%) والعربية (من 97.2%). وانتقل كشف النصوص الألمانية المكتوبة كليًا بالذكاء الاصطناعي من 99.1% إلى 100%.
وبحسب عائلة النماذج، تُكتشف النصوص المكتوبة كليًا بالذكاء الاصطناعي من OpenAI وAlibaba وMistral وxAI وMeta بنسبة 100% (Meta من 96.8%)، ومن DeepSeek بنسبة 96.3% (من 95.1%)، ومن Google بنسبة 95.9% (من 93.9%).
وبحسب نوع النص، تُكتشف النصوص الأكاديمية والعلمية والرسائل والبريد الإلكتروني والشكاوى المكتوبة بالذكاء الاصطناعي أو بمساعدته بنسبة 100%، وكتابة الطلاب ومتعلمي اللغة بنسبة 99.1% (من 98.1%).
كيف نختبر Veread
لا تكون أداة الكشف موثوقة إلا بقدر موثوقية تقييمها. وقد طُوّر Veread وجرى التحقق منه على بيانات ضخمة حصرية مملوكة لنا ومنتقاة باحتراف، وكل نتيجة في هذا الخبر مصدرها التقييم الموصوف أدناه.
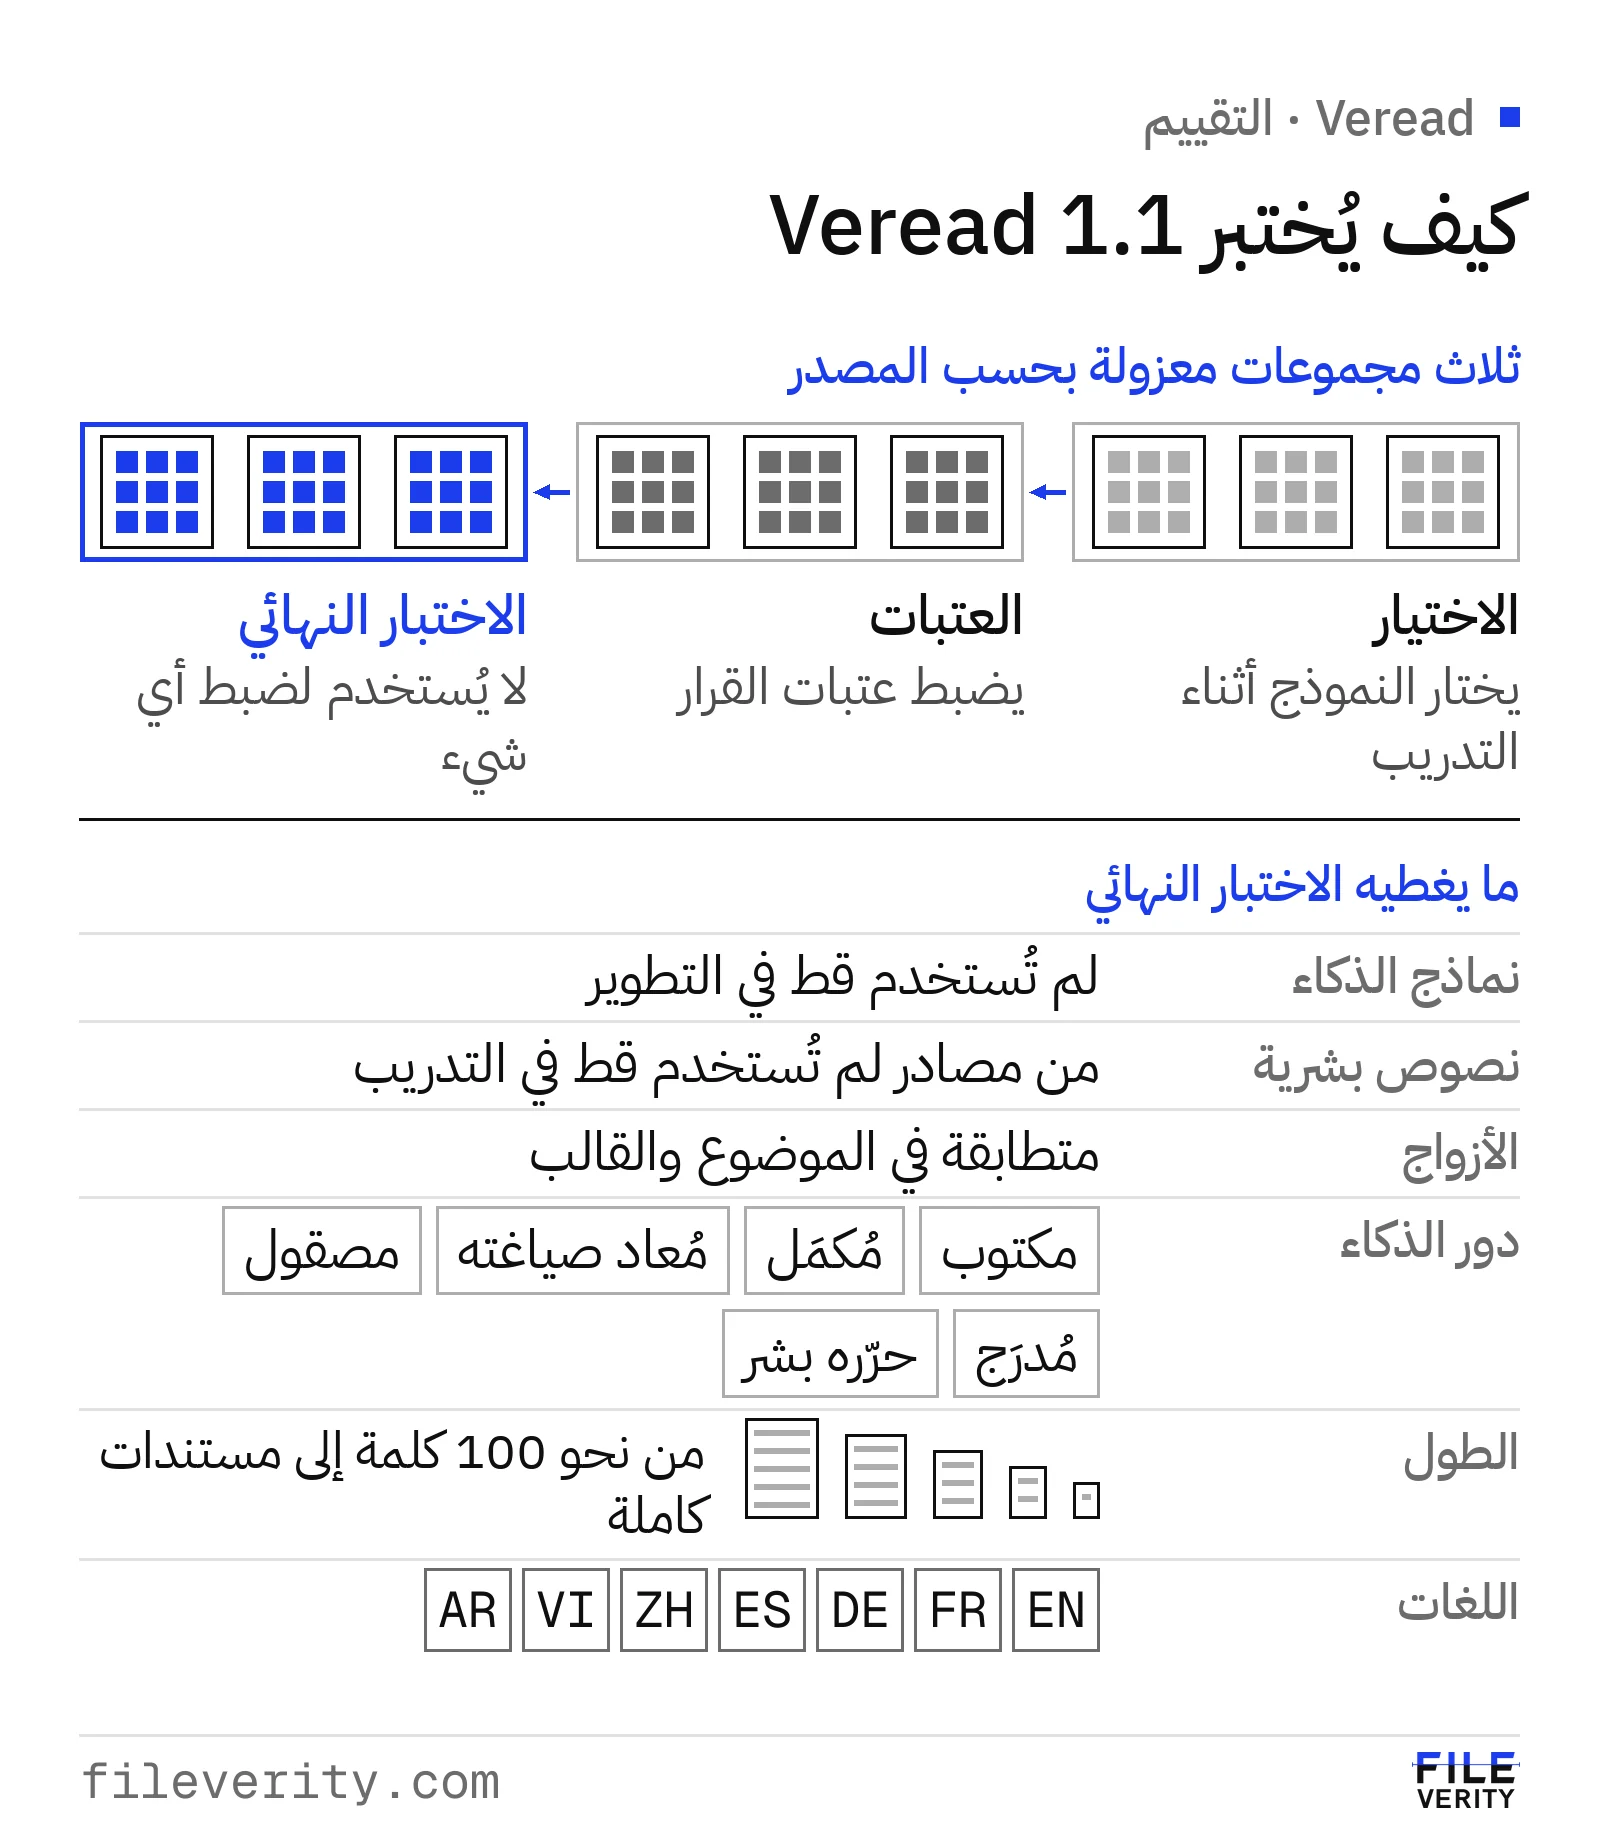
يفصل التقييم بين اختيار النموذج وضبط العتبات والاختبار النهائي، ويقيس المحرك الذي يستخدمه العملاء.
- ثلاث مجموعات معزولة لثلاث مهام. واحدة لاختيار النموذج أثناء التدريب، وواحدة لضبط عتبات القرار، وواحدة للاختبار النهائي. ولا تُستخدم مجموعة الاختبار النهائي في ضبط أي شيء.
- عزل بحسب المصدر. المستندات التي تشترك في مصدر أو مجموعة كتّاب تبقى في الجانب نفسه من التقسيم، فيقيس الاختبار القدرة على التعميم لا الحفظ.
- نماذج ذكاء اصطناعي لم يرَها النموذج. يتضمن الاختبار نصوصًا من نماذج لم تُستخدم في أي مرحلة من التطوير.
- مصادر بشرية لم يرَها النموذج. تقيس مجموعات الكتابة البشرية من مصادر لم تُستخدم قط في التدريب النتائج الإيجابية الكاذبة بالصورة التي يواجهها بها العملاء.
- أزواج متطابقة. تُكتب نصوص الذكاء الاصطناعي في المواضيع والقوالب نفسها التي تُكتب فيها نظيراتها البشرية، فلا تنجح أداة الكشف بالموضوع أو القالب وحدهما.
- كل صور مشاركة الذكاء الاصطناعي. نص كُتب من الصفر، ونص بشري أكمله الذكاء الاصطناعي، ونص أُعيدت صياغته، ونص صقله الذكاء الاصطناعي، ومقاطع أُدرجت في نص بشري، ومسودات للذكاء الاصطناعي حرّرها بشر.
- كتابة الذكاء الاصطناعي الحقيقية فقط. لا يُحتسب النص المحرَّر مكتوبًا بمساعدة الذكاء الاصطناعي إلا إذا غيّر الذكاء الاصطناعي صياغته فعلًا. أما اللمسات الخفيفة التي تُبقي الصياغة البشرية على حالها فتُستبعد.
- نطاق كامل من المدخلات. من مقتطفات في نحو 100 كلمة إلى مستندات كاملة، بسبع لغات، وعبر النصوص القانونية والإدارية، والنثر الأدبي، وكتابة الطلاب، والأبحاث الأكاديمية، والأخبار، ومحتوى الويب، والمراجعات والمنتديات، والمستندات العملية، والرسائل والشكاوى.
- محرك الإنتاج. تُقاس النتائج من البداية إلى النهاية عبر المحرك نفسه الذي يخدم العملاء، لا عبر نسخة مخبرية.
متاح الآن
يعمل Veread 1.1 منذ 18 نوفمبر 2026 دون أي إجراء من جانبك:
- كاشف النصوص المكتوبة بالذكاء الاصطناعي على الويب وفي لوحة التحكم.
- واجهة API، مع بقاء معرّفات النماذج كما هي (
veread-1-textللنصوص وveread-1للمستندات) ولقطة جديدة بتاريخ 2026-11-18. راجع توثيق واجهة API لكشف النصوص. - تقارير المستندات، حيث يفحص Veread النص داخل المستندات. وتعرض صفحة الدقة أبرز القياسات.
- إضافة Chrome والفحص الجماعي لأعمال الصف الواحد لدى المعلمين.
وتجد بطاقة نتائج Veread 1.1 الكاملة، بحسب اللغة ونوع النص وعائلة النماذج، في دليل قياس أداء Veread.
بقلم Yang Zheng