تقييم الكشف
كيف يكتب كل نموذج ذكاء اصطناعي بالعربية؟ عبارات ChatGPT وClaude وGemini وغيرها التي تكشف النص
كيف تعرف أن النص كتبه ChatGPT أو Claude أو Gemini أو Grok أو DeepSeek؟ عبارات كل عائلة بمضاعفاتها، ومحاذير القراءة، وكيف يقرأ Veread أكثر منها.
تاريخ النشر · آخر تحديث · 8 د للقراءة
في هذه الصفحة
لكل عائلة من نماذج الذكاء الاصطناعي عاداتها في الكتابة العربية: عبارات تكررها أكثر بكثير من الكتّاب البشر، وعلامات ترقيم تتجنبها، وإيقاع جمل أكثر انتظامًا. يستعرض هذا الدليل العادات التي رصدناها عند سبع عائلات: ChatGPT من OpenAI، وClaude من Anthropic، وGemini من Google، وGrok من xAI، وDeepSeek، وQwen من Alibaba، وGLM من Zhipu. والأرقام مضاعفات لتكرار العبارة عند العائلة مقارنةً بالكتّاب البشر في اللغة نفسها.
ما تجده هنا إشارات تساعد على المراجعة، لا إثبات على أن نصًا بعينه كتبه نموذج بعينه. فالبشر يستعملون هذه العبارات أيضًا، والتوجيه يغيّر الأسلوب. أما الاستخدام العملي فهو أن تعرف ما الذي تلاحظه حين تقرأ، ولماذا تستطيع أداة مثل Veread أن تقرأ ما هو أبعد من قوائم العبارات.
ما العبارات التي تميّز كل عائلة من نماذج الذكاء الاصطناعي؟
يعرض الشكل الآتي عبارتين لكل عائلة مع مضاعف تكرارها مقارنةً بالكتّاب البشر. اخترنا عبارات تُقرأ كصياغة عادية، ويمكن لأي قارئ أن يبحث عنها في نص، وتختلف قدر الإمكان من عائلة إلى أخرى.
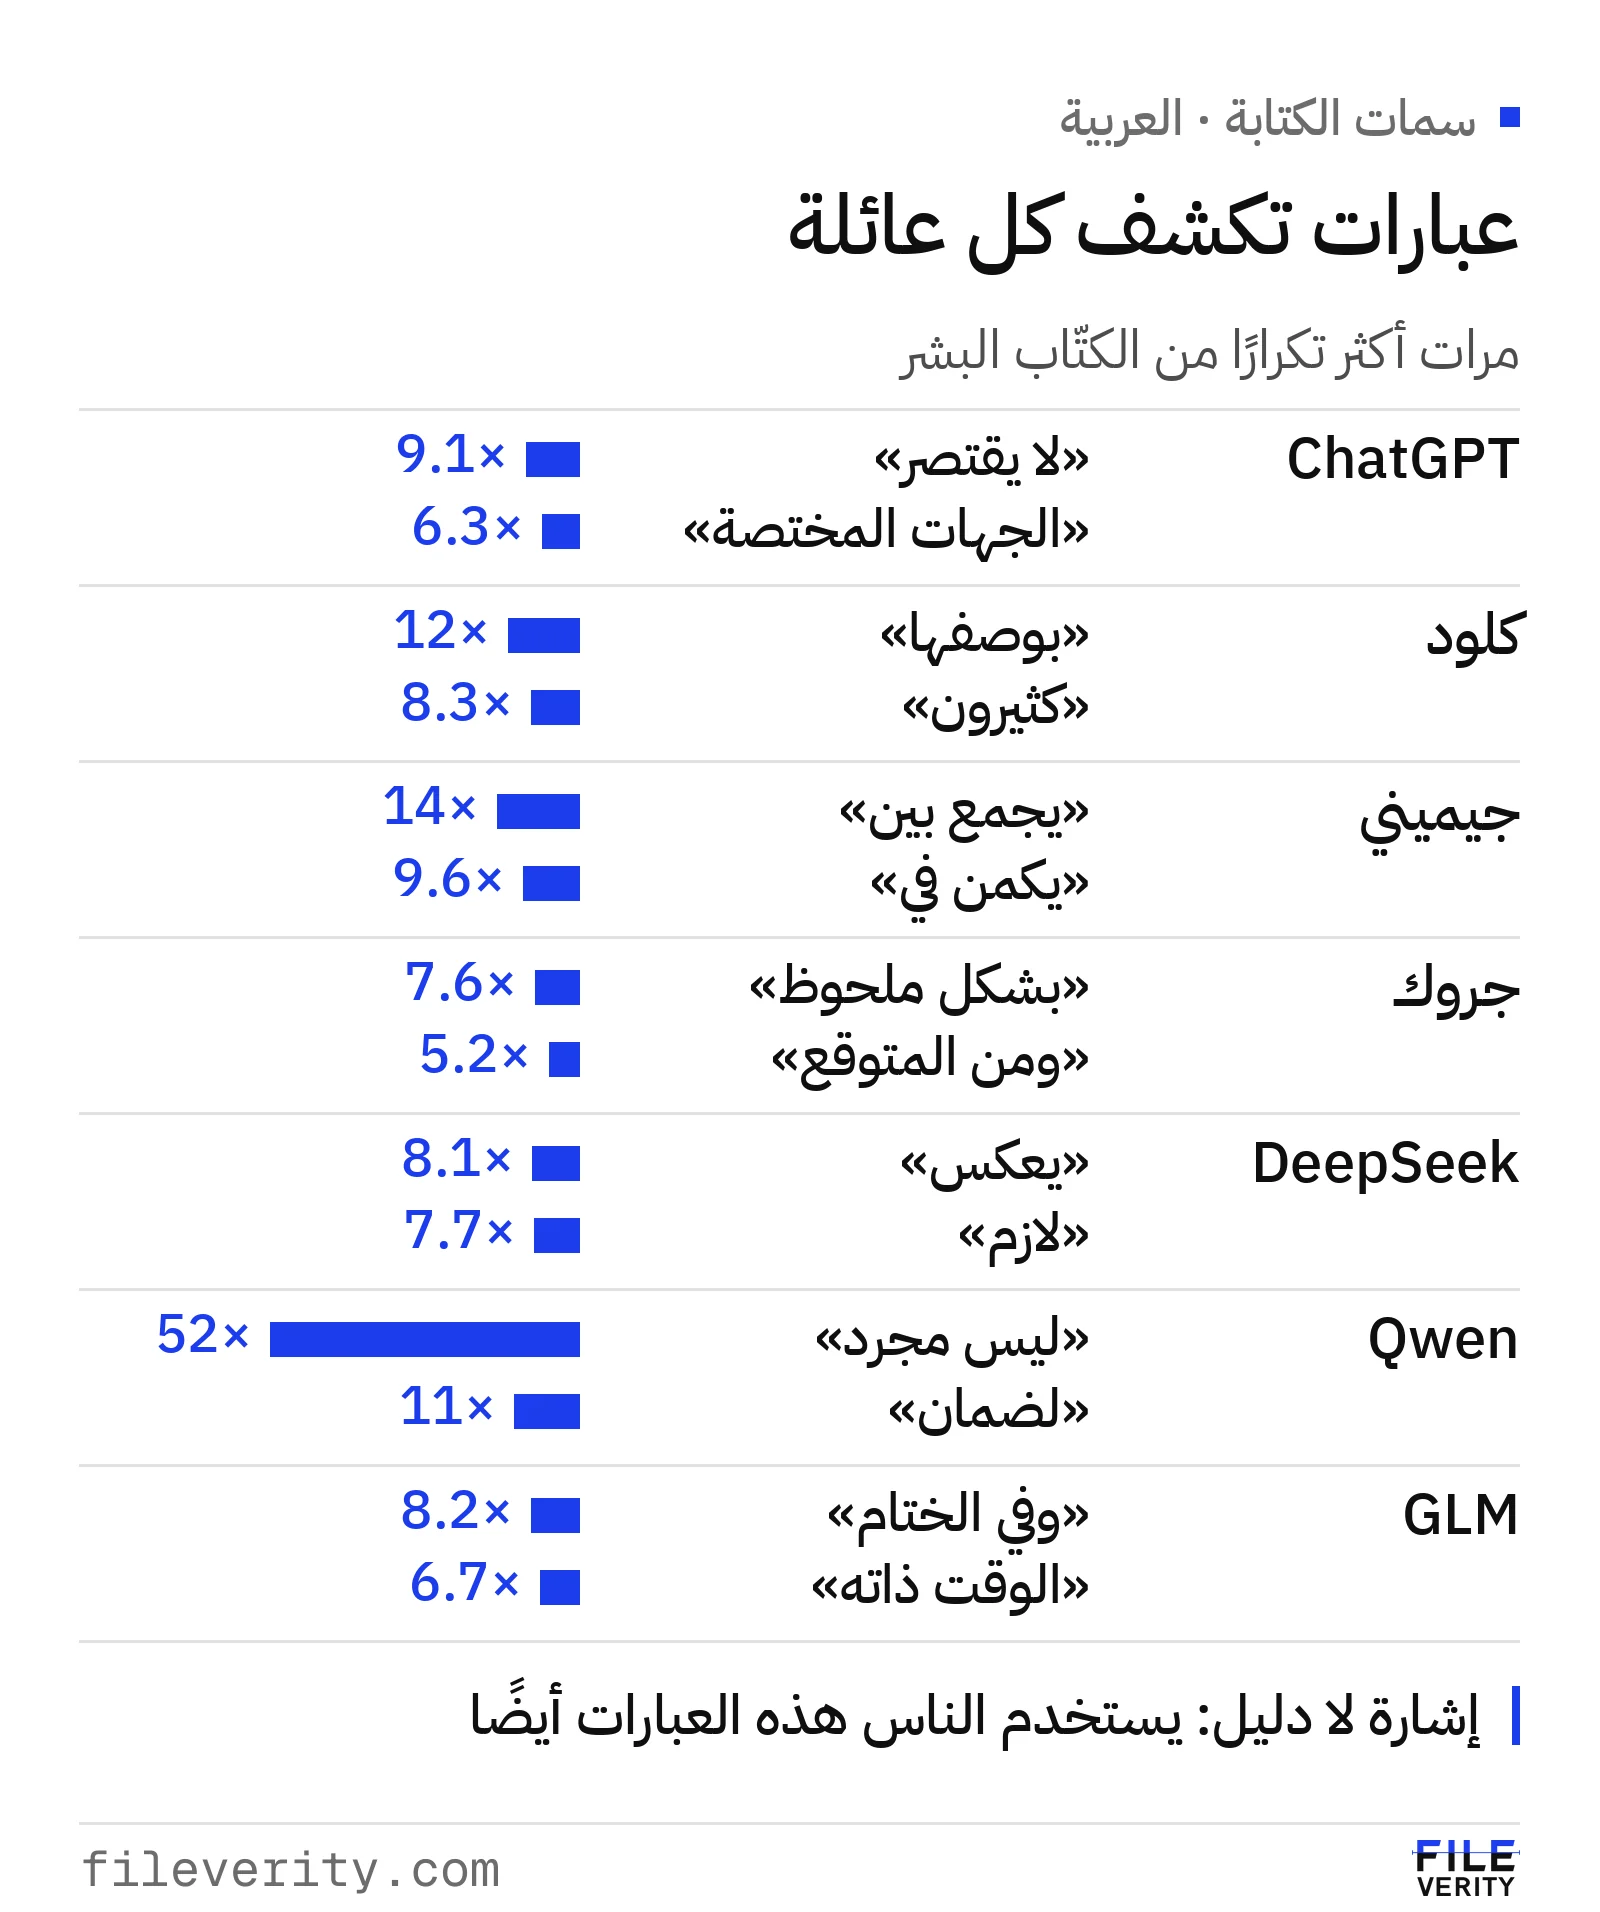
إشارة لا دليل: يستخدم الناس هذه العبارات أيضًا، لكن ليس بهذا التواتر.
تشترك العائلات كلها في كثير من العبارات الرسمية (يجمع بين، وتجمع بين، وليس مجرد، وفي عالم)، ولذلك لا تفيد وحدها في التمييز بين عائلة وأخرى، بل في الاشتباه بالكتابة الآلية عمومًا. أما ما يفرّق بين العائلات فهو العبارات التي ترتفع عند عائلة بعينها مقارنةً بالعائلات الأخرى، وسنذكرها في كل قسم. وتظهر العبارات بالإملاء الموحَّد المعتمد في التحليل، فالألف والياء والهمزة فيها موحَّدة، لذا ترى «علي» بدل «على» في بعضها.
كيف قسنا هذه العلامات؟
قارنّا مستندات مكتوبة بالكامل بالذكاء الاصطناعي من كل عائلة بمستندات بشرية بالعربية. ووازنّا المستندات البشرية بحيث تطابق توزيع المصادر والأنواع في مستندات الذكاء الاصطناعي، فلا يكون الموضوع أو نوع النص هو الذي يصنع الفرق. وأجرينا مقارنة ثانية مع الأصول البشرية التي كُتبت منها النصوص المولَّدة للتأكد من اتجاه النتيجة.
ثم عددنا العبارات المؤلفة من كلمة إلى ثلاث كلمات متتالية، بعد توحيد إملاء الحروف في العربية، وسجّلنا كم مرة تتكرر كل عبارة عند العائلة مقابل الكتّاب البشر. ولم نُبقِ إلا العبارات التي تظهر في مستندات كثيرة من مصادر وأنواع متعددة، وليست أدوات ربط مجردة ولا أرقامًا ولا أسماء أعلام ولا كلمات موضوع، وتتجه في الاتجاه نفسه في نصفين عشوائيين من البيانات يُقسَمان بحسب المستند الأصلي. وتُحسب علامات البنية من النص الخام، ولا تُعتمد إلا حين يتفق اتجاهها في النصفين وفي مهمتي الكتابة وإعادة الكتابة. وكُتبت النصوص المولَّدة نثرًا عاديًا، لذلك لا تقول علامات القوائم والعناوين شيئًا يُذكر عن مخرجات الدردشة الفعلية.
تستند هذه النتائج إلى بيانات ضخمة حصرية مملوكة لنا. وهي ميول إحصائية لعائلة كاملة، يختلف فيها كل نص عن غيره، ويغيّرها التوجيه.
ChatGPT من OpenAI: «لا يقتصر» و«يسهم في»
يميل ChatGPT في العربية إلى التركيب الذي يوسّع الفكرة: «لا يقتصر» بنحو 9.1 أضعاف الكتابة البشرية، و«ولا سيما» بالمعدل نفسه، و«تجمع بين» بنحو 8.8 أضعاف، و«يسهم في» بنحو 8.2 أضعاف، و«الجهات المختصة» بنحو 6.3 أضعاف. وما يميّزه عن العائلات الأخرى «ولا سيما» (4.5 أضعاف معدل العائلات الأخرى) و«لكنه لا» (5.6 أضعاف) و«خصوصًا إذا» (5.3 أضعاف) و«تؤثر في» (6.6 أضعاف).
وفي البنية يكتب جملًا أقصر وأكثر انتظامًا: متوسط طول الجملة 22 كلمة مقابل 41 عند الكتّاب البشر، وفقراته أقصر (49 كلمة مقابل 68). وهو أقل استخدامًا لعلامات الحذف بنحو 5.8 أضعاف، وللأقواس بنحو 3.4 أضعاف، ولعلامات التعجب بنحو 3 أضعاف.
يجمع ChatGPTDetect في صفحة كيف تعرف أن ChatGPT كتب النص هذه العلامات مع أمثلة لتتعرف إليها في قراءتك.
Claude من Anthropic: «بوصفها» و«كثيرون»
يميل Claude إلى صياغات الإسناد والتحوّط: «بوصفها» بنحو 12 ضعفًا، و«كثيرون» بنحو 8.3 أضعاف، و«ولا سيما» بنحو 7.2 أضعاف، و«يسهم في» بنحو 6.7 أضعاف، و«من أبرز» بنحو 6.3 أضعاف، و«ومن هنا» بنحو 5.9 أضعاف. وما يرتفع عنده مقارنةً بالعائلات الأخرى «في الغالب» (7.5 أضعاف) و«ولذلك» (5.5 أضعاف) و«كثيرًا ما» (4.3 أضعاف) و«عددًا من» (4.2 أضعاف). فهو أميل إلى التحوّط: غالبًا، وكثيرًا ما، وعددًا من.
وفي البنية أكثر تراكيب «ليس كذا بل كذا» بنحو 1.8 ضعف، وأقل استخدامًا لعلامات الحذف بنحو 8.4 أضعاف، وللأقواس بنحو 3 أضعاف، ولعلامات التعجب بنحو 2.6 ضعف. ومتوسط جمله 25 كلمة مقابل 36 عند الكتّاب البشر.
تعرض ClaudeDetect في صفحة كيف تعرف أن Claude كتب النص هذه العلامات بالتفصيل.
Gemini من Google: «ليس مجرد» و«يكمن في»
يقدّم Gemini النص بنبرة تحليلية رسمية: «ليس مجرد» بنحو 34 ضعفًا، و«يجمع بين» بنحو 14 ضعفًا، و«يكمن في» بنحو 9.6 أضعاف، و«هذا السياق» بنحو 8 أضعاف، و«وفي المقابل» بنحو 7.7 أضعاف. وما يميّزه عن العائلات الأخرى «يكمن في» (4.2 أضعاف) و«كافة» (4.1 أضعاف) و«التام» (5.4 أضعاف) و«لقد» (2.7 ضعف).
وهو الوحيد بين العائلات الذي ترتفع عنده الفاصلة المنقوطة، بنحو 3.6 أضعاف الكتّاب البشر (2.6 ضعف العائلات الأخرى)، وقوائمه الثلاثية أكثر بنحو 2.1 ضعف. ويكاد لا يستخدم علامات الحذف: أقل بنحو 72 ضعفًا، وعلامات التعجب أقل بنحو 4 أضعاف، وعلامات الاستفهام أقل بنحو 1.8 ضعف.
تجد في GeminiDetect صفحة كيف تعرف أن Gemini كتب النص تفاصيل هذه الإشارات.
Grok من xAI: «مع التركيز علي» وكلمات عامية
يجمع Grok بين الصياغة الرسمية وكلمات من العامية تظهر في نصوصه العربية أكثر مما تظهر عند غيره: «مع التركيز علي» بنحو 12 ضعفًا، و«في تعزيز» بنحو 8.8 أضعاف، و«بشكل ملحوظ» بنحو 7.6 أضعاف، و«ومن المتوقع» بنحو 5.2 أضعاف. وما يميّزه عن العائلات الأخرى «حتى لو» (3 أضعاف) و«بدون ما» (5.8 أضعاف) و«زي» (4.6 أضعاف) و«ده» (3.1 أضعاف) و«حتى الآن» (2.4 ضعف).
وتراكيبه أميل إلى الاستدراك «ليس كذا بل كذا» بنحو ضعفين، وأقل استخدامًا لعلامات الحذف بنحو 6.4 أضعاف، ولعلامات التعجب بنحو 3.9 أضعاف، وللأقواس بنحو 2.2 ضعف. ومتوسط جمله 23 كلمة مقابل 37.
تعرض GrokDetect في صفحة كيف تعرف أن Grok كتب النص أمثلة على هذه الإشارات.
DeepSeek: «ليس مجرد» وعبارات من العامية
عند DeepSeek مزيج من الرسمي والعامي: «ليس مجرد» بنحو 18 ضعفًا، و«ناس» بنحو 11 ضعفًا، و«يعكس» بنحو 8.1 أضعاف، و«لازم» بنحو 7.7 أضعاف، و«تجمع بين» بنحو 7.6 أضعاف، و«كتير» بنحو 7.2 أضعاف. وما يميّزه عن العائلات الأخرى «في ناس» (7.3 أضعاف) و«وده» (3.9 أضعاف) و«وهنا» (3.2 أضعاف) و«كتير» (2.3 ضعف).
وقوائمه الثلاثية أكثر بنحو 1.6 ضعف، وهو أقل استخدامًا لعلامات الحذف بنحو 3.8 أضعاف، ولعلامات التعجب بنحو 3.4 أضعاف، وللأقواس بنحو 2.4 ضعف. ومتوسط جمله 27 كلمة مقابل 37.
تتناول DeepSeekDetect في صفحة كيف تعرف أن DeepSeek كتب النص هذه العلامات وكيف تتداخل مع Qwen وGLM.
Qwen من Alibaba وGLM من Zhipu
يميل Qwen إلى الروابط الرسمية: «ليس مجرد» بنحو 52 ضعفًا (وهو أعلى مضاعف رصدناه)، و«تجمع بين» و«لضمان» بنحو 11 ضعفًا لكل منهما، و«في آن واحد» بنحو 9.2 أضعاف، و«مما يجعل» بنحو 8.1 أضعاف. وما يميّزه عن العائلات الأخرى «مش مجرد» (13 ضعفًا) و«يا جماعة» (5.2 أضعاف) و«مما يعكس» (4.7 أضعاف) و«هذا النهج» (5 أضعاف). ولا نجد عنده علامة بنية ثابتة يزيد استخدامها على الكتّاب البشر، بل يقل استخدامه لعلامات الحذف بنحو 12 ضعفًا، ولعلامات التعجب بنحو 4.8 أضعاف، وللنقطتين الرأسيتين وعلامات الاقتباس بنحو 2.3 و2.1 ضعف.
يميل GLM إلى عبارات الخاتمة والتسلسل: «وفي الختام» بنحو 8.2 أضعاف، و«يبحث عن» بنحو 7.9 أضعاف، و«الوقت ذاته» و«الخطوة الأولى» بنحو 6.7 أضعاف، و«عشان» بنحو 6.3 أضعاف. لكن GLM قريب من العائلات الأخرى في العربية، ولم تجتز إلا ست عبارات كل اختبارات الثبات في ما يميّزه عنها (منها «كافة» و«ذاته» و«التام»)، فاقرأ علاماته بحذر أكبر. وفي البنية أكثر تراكيب «ليس كذا بل كذا» بنحو 1.7 ضعف، وقوائمه الثلاثية بنحو 1.4 ضعف.
وليس لهاتين العائلتين موقع مستقل من مواقعنا، لكن DeepSeekDetect يضع في صفحة العلامات قسمًا عن كيف يختلف Qwen وGLM عن DeepSeek.
علامات الترقيم والبنية: ما تتجنبه النماذج
الأوضح في كل العائلات أن الذكاء الاصطناعي يتجنب ما يميّز الكتابة البشرية الحية: علامات الحذف، والتعجب، والأقواس. ويعرض الشكل الآتي مضاعفات ذلك لكل عائلة، مع القوائم الثلاثية («كذا وكذا وكذا») التي تزيد عند أغلبها.
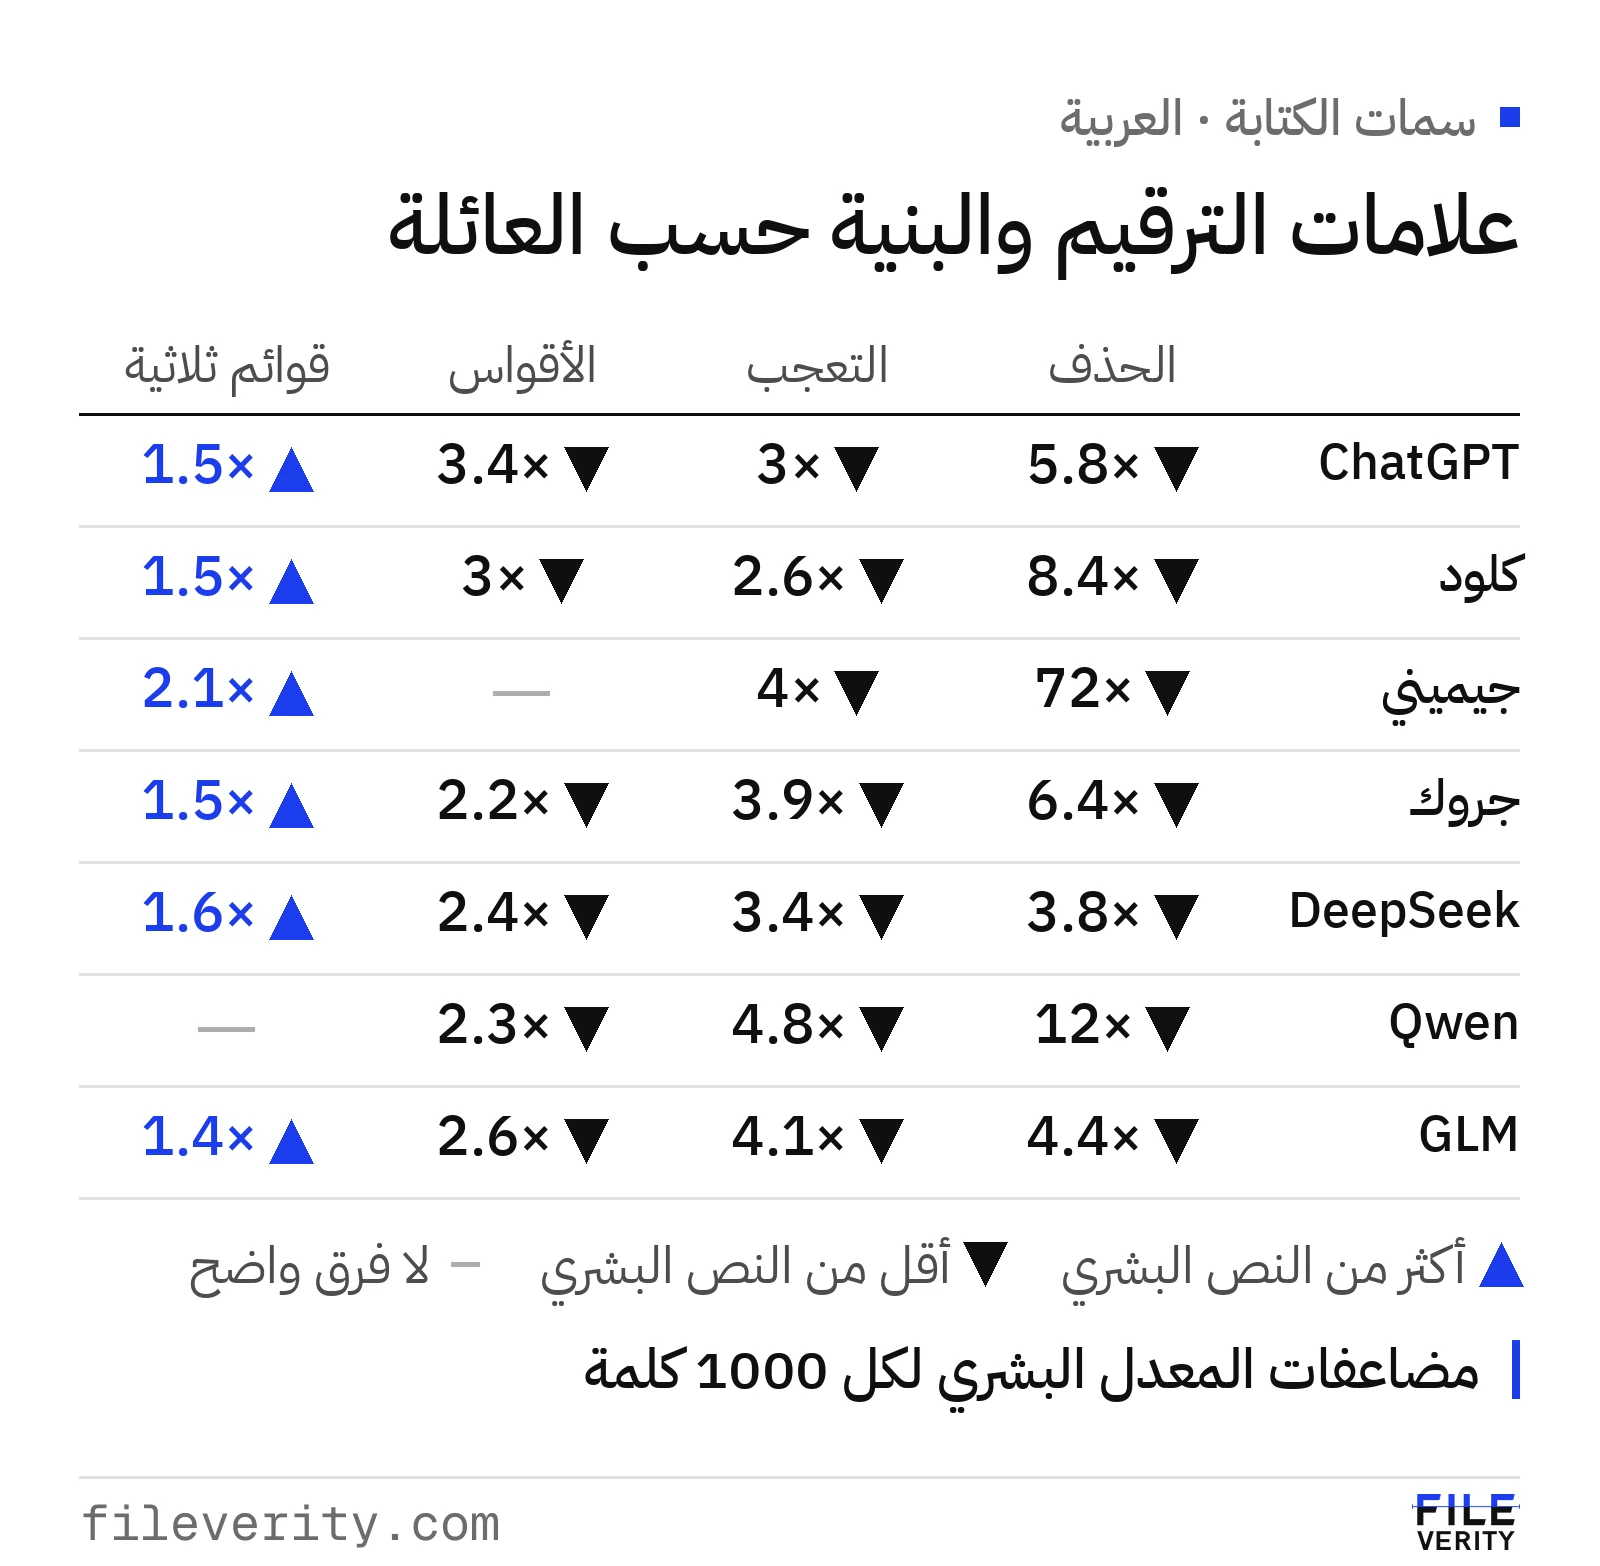
مضاعفات المعدل البشري لكل 1000 كلمة: المثلث الأسود أقل من البشر، والأزرق أكثر، والشرطة بلا فرق واضح.
يظهر في الجدول أن علامات الحذف هي أوضح إشارة بنيوية: أقل عند كل العائلات بين 3.8 و72 ضعفًا، وأقواها عند Gemini. وتقل علامات التعجب عند الجميع، وتقل الأقواس عند ست عائلات، ولا يظهر عند Gemini فرق واضح فيها. والقوائم الثلاثية أكثر قليلًا عند ست عائلات (من 1.4 إلى 2.1 ضعف)، ولا فرق ثابت عند Qwen. ومضاعفات القوائم الثلاثية صغيرة، فلا تحمل وحدها وزنًا كبيرًا. وتُقاس هذه العلامات لكل 1000 كلمة، فلا تظهر في جملة أو جملتين، وإنما في نص طويل.
وأنماط الإيقاع تتفق كذلك: جمل أقصر وأكثر انتظامًا. فمعامل تباين طول الجملة عند الكتّاب البشر بين 0.51 و0.54، وعند العائلات التي قسناه عندها بين 0.34 و0.38.
ما محاذير القراءة بالعين؟
- البشر يستخدمون هذه العبارات. «ليس مجرد» و«يجمع بين» من الصياغات الشائعة في المقالات التحليلية والمراسلات الرسمية. ومن يتعلم الكتابة الرسمية من نماذج أو نصوص معيارية يكررها.
- العامية ليست علامة قاطعة. ظهور «ده» و«زي» و«مش» و«كتير» في نص عربي رسمي أكثر عند بعض العائلات في بياناتنا، لكن أي كاتب مصري يستخدمها.
- التوجيه يغيّر الأسلوب. تعليمات «اكتب بأسلوب محادثة» أو «تجنب الجمل الطويلة» تغيّر العلامات، وتحرير نص مولَّد يزيل بعضها.
- النص القصير لا يكفي. لا تظهر الميول الإحصائية في فقرة أو جملتين.
- عائلة قريبة من أخرى. GLM قريب من العائلات الأخرى، وتتشابه عبارات DeepSeek وQwen وGLM جزئيًا.
لذلك نصف نتيجة الأسلوب بأنها تشابه أسلوبي في الكتابة مع عائلة، لا نسبة لمؤلف. ولا يثبت ذلك شيئًا في حق كاتب بعينه. وإن احتجت قرارًا بشأن شخص فاجمع أدلة أخرى: مسودات النص، وتاريخ التعديل، وما يستطيع الكاتب شرحه عن عمله.
كيف يقرأ Veread أكثر من قوائم العبارات؟
قائمة العبارات تُحصي كلمات. أما Veread، نموذج Fileverity لكشف النصوص المكتوبة بالذكاء الاصطناعي، فيقرأ النص كله بدل عبارات منفردة، وقد تدرّب على بيانات ضخمة حصرية مملوكة لنا في سبع لغات. ولذلك يستطيع أن يلتقط نصًا لا تتضمن عباراته أيًا من القوائم أعلاه، وألا يُخدع بنص بشري يحتوي بعضها.
يعرض كاشف النصوص المكتوبة بالذكاء الاصطناعي المقاطع التي تحمل الإشارة، ومدى التشابه الأسلوبي في الكتابة مع عائلات النماذج. وقد بلغت نسبة النصوص البشرية التي حصلت على نتيجة ذكاء اصطناعي 0.28% عبر سبع لغات، واكتُشفت 98.6% من النصوص المكتوبة كليًا بالذكاء الاصطناعي، و94.9% من نصوص نماذج لم تُستخدم قط في تطويره. والنتيجة مؤشر للمراجعة، والقرار المتعلق بالأشخاص يحتاج إلى مراجعة بشرية. وتجد تفاصيل الأداء في بطاقة نتائج Veread، وكيف يختلف الكشف بالأسلوب عن الكشف بالعلامات المائية في دليل العلامات المائية لنصوص الذكاء الاصطناعي، وما يخص العربية تحديدًا في دليل كاشف الذكاء الاصطناعي للنصوص العربية.
أسئلة شائعة
هل يمكن معرفة أي نموذج كتب نصًا عربيًا بالعين؟
أحيانًا يُشتبه في عائلة من اجتماع إشارات، مثل «ليس مجرد» و«يجمع بين» مع قلة علامات الحذف والتعجب وجمل متقاربة الطول. لكن علامة واحدة لا تكفي، والقراءة بالعين تخطئ، فلا تبنِ عليها قرارًا.
لماذا تتشابه عبارات النماذج المختلفة؟
لأن النماذج الكبيرة تتعلم من نصوص عربية رسمية متشابهة، ولأن الكتابة الآلية تميل إلى الصياغة الآمنة. ولذلك تظهر عبارات مثل «ليس مجرد» و«تجمع بين» عند عدة عائلات، ويكون الفارق بينها في الدرجة وفي العبارات الأقل شيوعًا.
هل العبارات المذكورة دليل على أن النص مولَّد؟
لا. هي ميول إحصائية لعائلة كاملة من النماذج مقارنةً بالكتّاب البشر، لا دليل على نص بعينه. فالبشر يستعملونها، وكل نص يختلف عن المتوسط.
هل تقرأ Fileverity علامة النموذج المائية؟
لا. يقدّر Veread أسلوب النص، ولا يقرأ علامة أي شركة. وإن أردت ما نعرفه عن العلامات المائية فهو في الدليل المخصص لها.
بقلم Yang Zheng