Évaluer les outils de vérification
ChatGPT peut-il reconnaître une image IA ? Comprendre ne suffit pas à identifier la source
Compréhension visuelle et détection d’origine : un principe de théorie de l’information, illustré par la courbe ROC mesurée de FVIMG V2.
Publié le · Mis à jour le · 4 min de lecture
Dans cet article
ChatGPT peut-il reconnaître une image générée par IA ? Il peut relever des indices, mais une bonne description de l’image ne suffit pas à en établir l’origine. Une scène photographiée et une scène synthétique peuvent avoir exactement le même sens. La question décisive devient alors : quelles informations sur leur origine parviennent réellement au système de décision ?
La chaîne de détection de Fileverity ne fait appel à aucun LLM. Elle repose sur l’apprentissage automatique spécialisé et des vérifications techniques. Nous expliquons ici un seul principe public : la différence entre information sur le contenu et information sur la source, sans exposer nos architectures internes.
Deux images, une description juste, une question encore ouverte
Une voiture rouge devant un mur de briques : cette description peut convenir aussi bien à une photographie qu’à une image générée. Un assistant peut même décrire correctement la lumière et la perspective dans les deux cas.
Supposons que le reste de l’analyse ne reçoive que cette phrase. Les deux fichiers deviennent alors indiscernables pour cette étape. Une argumentation plus détaillée sur la même phrase ne rétablit pas les différences qui n’ont pas été transmises.
Ce petit exemple explique pourquoi les anomalies visibles ne constituent pas, à elles seules, une méthode complète. Des mains plausibles ne prouvent pas une prise de vue ; un reflet inhabituel ne prouve pas une génération. La valeur de ces indices dépend de leur relation mesurée avec la source.
Le problème est celui de l’information conservée
Notons Y la catégorie d’origine, X l’image disponible et T une représentation dérivée, par exemple sa description. Dans une chaîne où la décision ne reçoit que T, il faut savoir ce que cette représentation conserve de l’origine.
L’inégalité de traitement des données, présentée dans les cours du MIT, s’écrit ici I(Y ; T) ≤ I(Y ; X) : la transformation ne crée pas d’information supplémentaire sur la source.
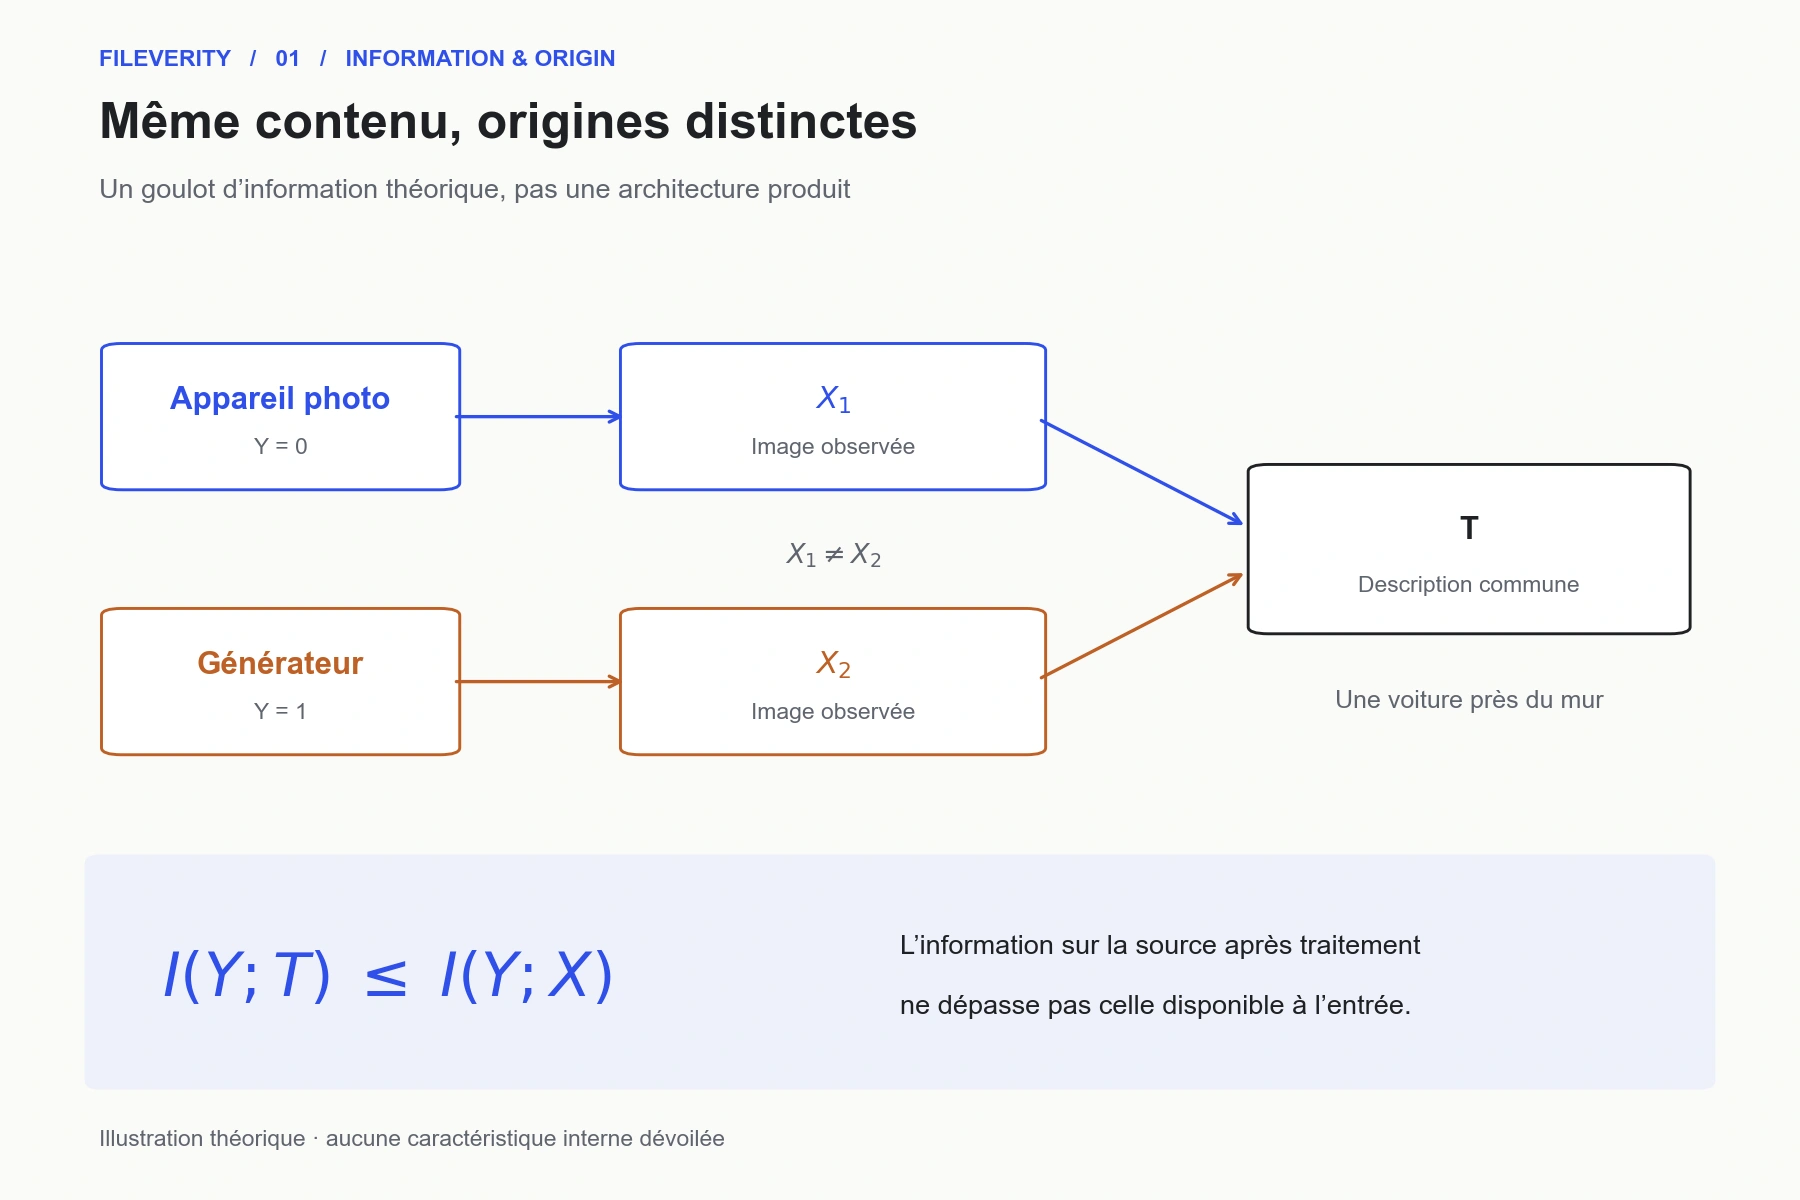
Illustration théorique, sans représentation de l’architecture Fileverity. Y désigne l’origine, X l’image observée et T une représentation dérivée. Aucun choix de caractéristiques internes n’est présenté.
Une transformation n’est pas nécessairement nuisible : une représentation bien choisie peut conserver l’information utile à une tâche. En revanche, son efficacité pour décrire une scène ne garantit pas qu’elle soit suffisante pour en identifier la source. Les deux objectifs ne sont pas interchangeables.
Cela ne démontre pas l’impossibilité de toute détection par un LLM multimodal. Celui-ci peut recevoir des informations visuelles directement, et un entraînement spécialisé peut modifier ses capacités. Le point essentiel est plus précis : la qualité de compréhension générale ne constitue pas une validation de la détection d’origine.
Passer d’un indice à une décision mesurable
Pour une observation abstraite E, on peut comparer sa vraisemblance sous deux hypothèses : image générée ou photographie. Le rapport L(E) = p(E | génération) / p(E | appareil photo) formalise cette question.
Ce rapport décrit un principe statistique, pas notre implémentation. Il compare deux explications possibles d’une observation ; il ne donne pas directement la probabilité que le fichier individuel soit faux. Un score appris peut, lui, être évalué sur des exemples dont la source est connue.
Une fois le seuil fixé, les détections, les omissions et les faux positifs se comptent. En faisant varier ce seuil, on obtient la courbe ROC : elle rend visible le compromis entre détecter davantage d’images générées et signaler davantage de photographies réelles.
La recherche Zero-Shot Detection of AI-Generated Images illustre une démarche fondée sur la prévisibilité statistique des images. Nous la citons comme exemple de question scientifique sur la source, sans revendiquer l’utilisation de cette méthode.
Une courbe calculée sur nos résultats réels
La figure suivante provient des prédictions enregistrées pour l’évaluation de FVIMG V2 du 1er novembre 2026. FVIMG V2 est développé et validé sur de très vastes jeux de données propriétaires et exclusifs, constitués par des spécialistes ; ce test porte sur des images générées de Synthbuster et des photographies RAISE-1k, deux jeux publics, afin que chacun puisse en contrôler la méthode. Il s’agit de mesures, contrairement au schéma théorique précédent.
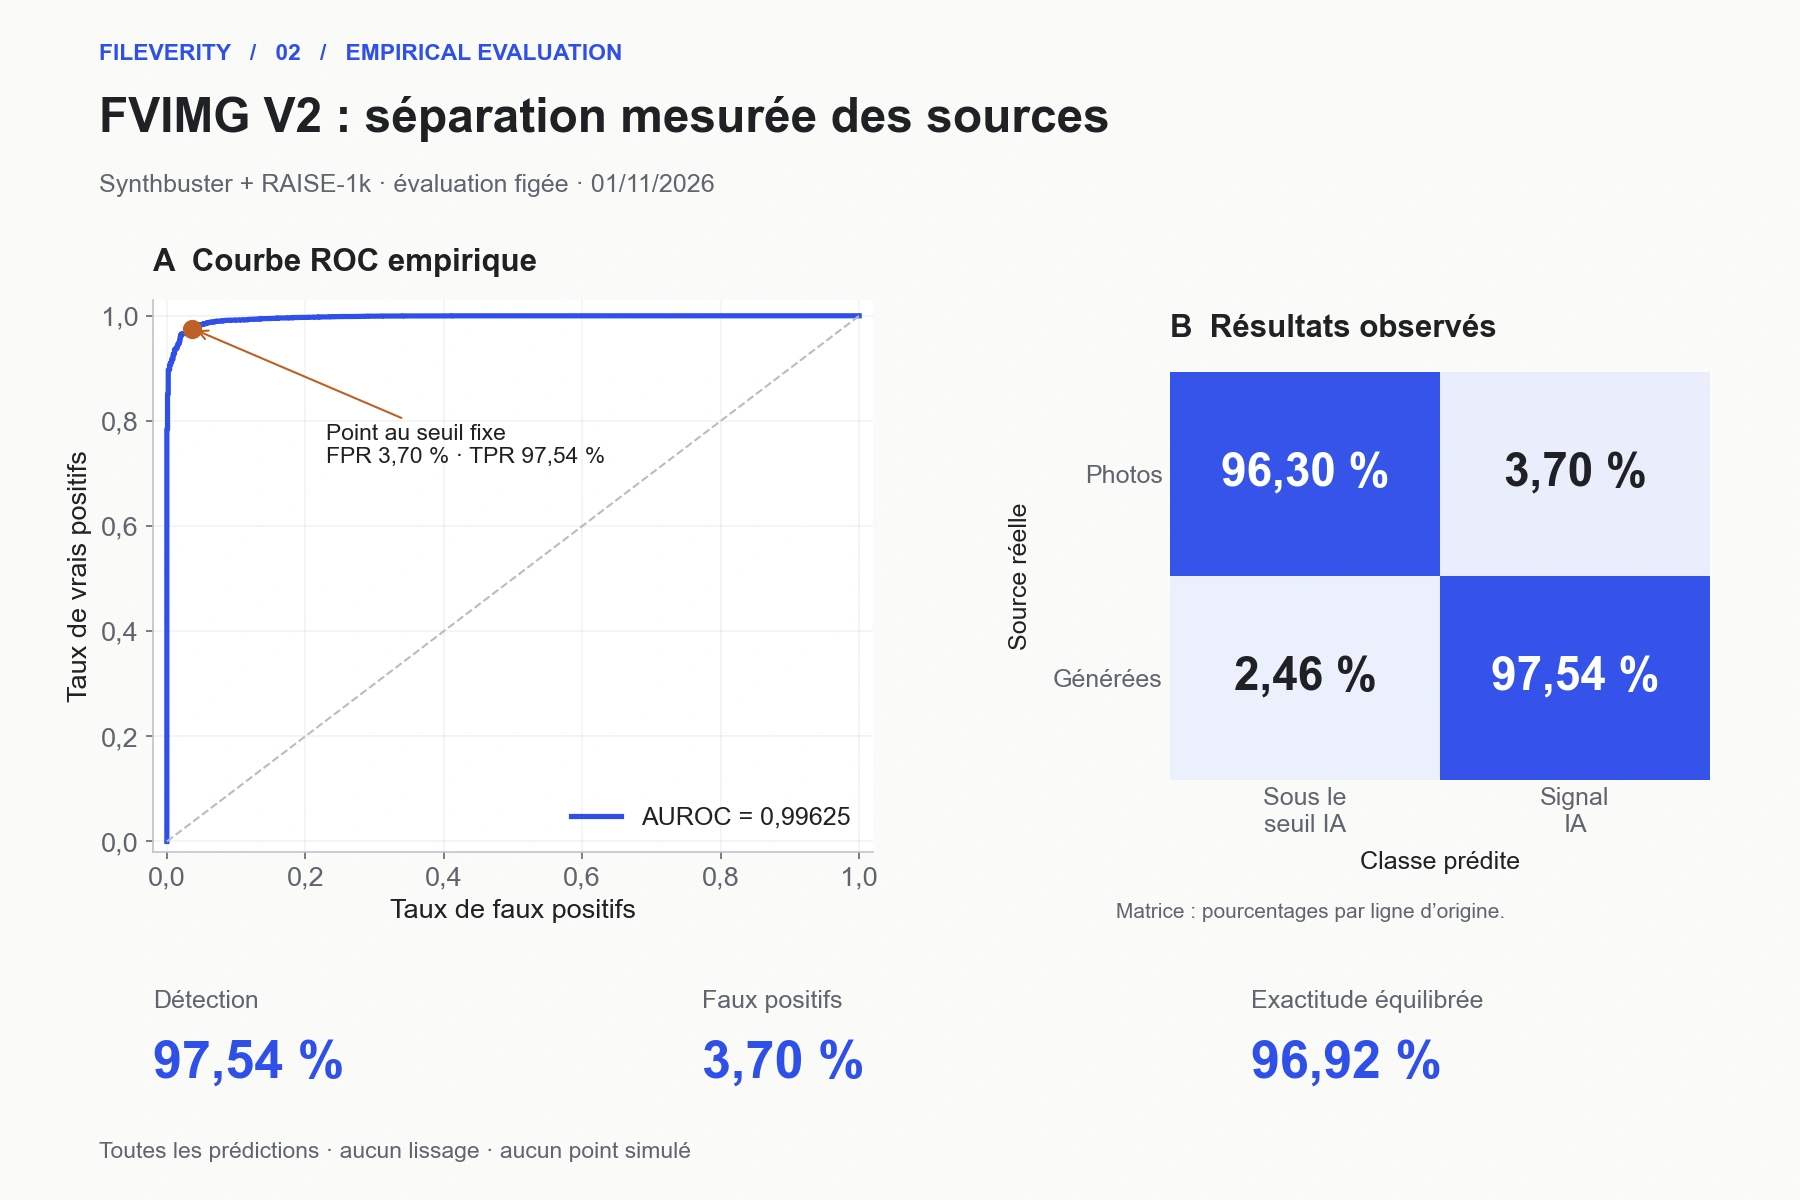
Scores identiques regroupés avant intégration ; point marqué au seuil fixe de l’évaluation. La matrice indique, en pourcentage, la part de chaque ligne d’origine. Ni lissage ni observations simulées.
| Mesure | Résultat FVIMG V2 |
|---|---|
| Images générées détectées | 97,54 % |
| Photographies correctement sous le seuil IA | 96,30 % |
| Exactitude équilibrée | 96,92 % |
| AUROC | 0,99625 |
Les 3,70 % de photographies réelles signalées constituent le taux de faux positifs. L’AUROC décrit la séparation des scores sur différents seuils, pas une probabilité d’authenticité pour chaque fichier.
Le rapport Synthbuster précise le traitement des entrées et le périmètre : le cœur de détection par pixels, sans ajouter les métadonnées ou la provenance au score principal. Aucun LLM n’a été testé comme concurrent dans cette évaluation.
Recouper signifie rechercher une information supplémentaire
Après un premier constat E1, un second constat E2 est utile s’il apporte quelque chose qui n’était pas déjà disponible. Reformuler E1 n’ajoute pas une observation. Examiner une information complémentaire peut, en revanche, aider à départager les hypothèses.
Plusieurs contrôles peuvent partager les mêmes erreurs. Leur nombre n’est donc pas une garantie : c’est le comportement mesuré de l’ensemble qui compte. Ce principe guide la vérification d’images de Fileverity. FVIMG V2 et notre modèle documentaire FVDOC V3 ont chacun une version et un périmètre d’évaluation identifiés, sans qu’il soit nécessaire d’exposer leurs mécanismes internes.
Pour une équipe métier, la bonne question est : « Qu’est-ce qui soutient ce classement, et sur quelles données a-t-il été vérifié ? » Notre guide sur la fiabilité des détecteurs aide à interpréter les réponses. Le parcours Fileverity relie ces mesures à des constats exploitables : préserver l’information pertinente, formuler une décision définie et en documenter les performances. Pour relier un détecteur à vos propres systèmes, Choisir une API de détection d’IA passe en revue dix points d’intégration.
Par Yang Zheng