تقييم الكشف
هل يستطيع ChatGPT معرفة أن الصورة مولَّدة بالذكاء الاصطناعي؟ مبدأ التحليل الجنائي للصور
فهم محتوى الصورة لا يثبت مصدرها: نظرية المعلومات، وكشف المصدر، ونتائج منحنى ROC التجريبية لنموذج FVIMG V2 في تقييم مثبَّت.
تاريخ النشر · آخر تحديث · 6 د للقراءة
في هذه الصفحة
هل يستطيع ChatGPT معرفة أن الصورة مولَّدة بالذكاء الاصطناعي؟ قد يرصد بعض القرائن المفيدة، لكن فهم ما تُظهره الصورة لا يثبت كيف أُنتجت. والمسألة الجوهرية في التحليل الجنائي الرقمي للصور هي حفظ المعلومات المتعلقة بالمنشأ واختبارها، ومنها معلومات قد يغفلها حتى الوصف الدقيق تمامًا.
يخاطب هذا الدليل الفرق التي تراجع صورًا واردة مع المطالبات والطلبات والمستندات، وتتساءل عمّا إذا كان روبوت المحادثة يغني عن كاشف الصور بالذكاء الاصطناعي (AI Image Detector). فإذا قال روبوت محادثة إن صورة واردة «تبدو حقيقية»، فاعتبر ذلك مؤشرًا يستدعي مزيدًا من الفحص، لا دليلًا على المنشأ.
لا يستعين مسار الكشف في Fileverity بنماذج لغوية كبيرة (LLMs)؛ فنحن نستخدم تعلّمًا آليًا متخصصًا وفحوصًا تقنية لتحليل الملفات. ويشرح هذا الدليل مبدأً عامًا واحدًا وراء هذا الاختيار، هو أن المعلومات عن المحتوى لا تساوي المعلومات عن المصدر، دون وصف نماذجنا الداخلية أو طريقة تنفيذها.
وصف صحيح قد يترك سؤال الكشف دون إجابة
تخيّل صورتين لسيارة حمراء بجوار جدار من الطوب. إحداهما التقطتها كاميرا، والأخرى مولَّدة بالذكاء الاصطناعي. يمكن وصف كلتيهما وصفًا صحيحًا بعبارة «سيارة حمراء بجوار جدار من الطوب»، وقد تُوصف الإضاءة والمنظور وهوية الأشياء وصفًا صحيحًا في الحالتين أيضًا.
لقد أدّى الوصف مهمته. ومع ذلك يبقى السؤال «كاميرا أم أداة توليد؟» مفتوحًا. فمتى اختُزلت صورتان في وصف واحد، لم يعد بوسع أي قرار لاحق يستند إلى هذا الوصف وحده أن يميّز بينهما. ولن يستعيد أي استدلال أكثر إحكامًا يُبنى على الجملة نفسها الفروق التي حُذفت.
ولهذا فإن قائمة المظاهر الشاذة المرئية أساس ناقص لكشف الصور المولَّدة بالذكاء الاصطناعي. فاليد المعقولة تشريحيًا لا تثبت أن مصدر الصورة كاميرا، والانعكاس غير المألوف لا يثبت أنها مولَّدة. قد تكون هذه الملاحظات قرائن مفيدة، لكن قيمتها التشخيصية يجب أن تُختبر لا أن تُفترض.
وللاطلاع على خطوات الفحص العملية بالترتيب، راجع دليل كيف تعرف إن كانت الصورة مولَّدة بالذكاء الاصطناعي. أما هنا فنتناول سبب حاجة مهمة الكشف الأساسية إلى أكثر من سرد معقول للمشهد.
عنق الزجاجة المعلوماتي: ما الذي يصل إلى القرار؟
ليكن Y فئة المصدر، وليكن X الصورة المتاحة، وليكن T تمثيلًا مشتقًا من تلك الصورة، مثل وصفها النصي. فإذا لم يتلقَّ القرار اللاحق سوى T، صار السؤال: كم من معلومات المصدر يحتفظ بها T؟
تعطي متباينة معالجة البيانات (Data-Processing Inequality) في ملاحظات نظرية المعلومات لمعهد ماساتشوستس للتقنية (بالإنجليزية) العلاقة I(Y; T) ≤ I(Y; X) في سلسلة المعالجة هذه؛ إذ لا يضيف تحويل المدخل أي معلومات جديدة عن مصدره. ويوضح الشكل الآتي الفكرة نفسها: صورتان مختلفتا المصدر تنتهيان إلى وصف واحد.
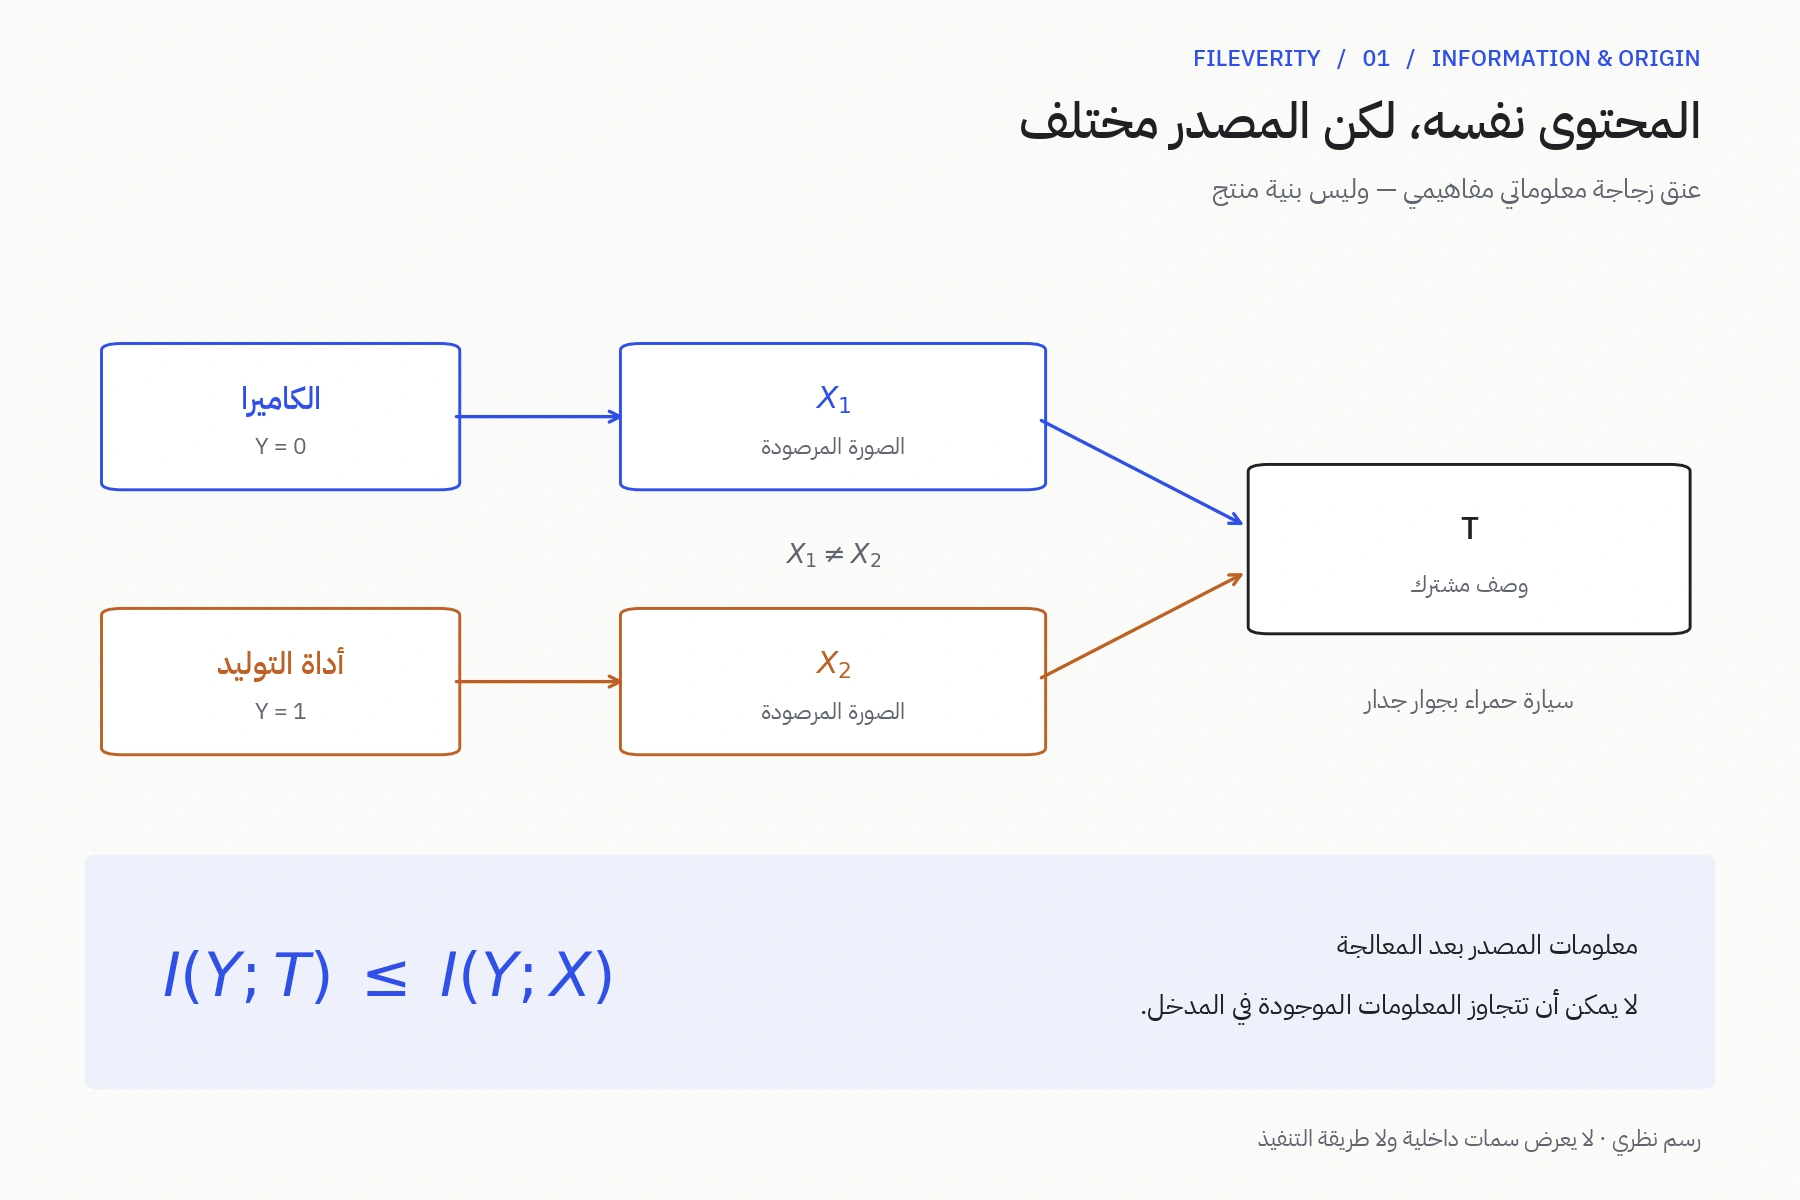
رسم توضيحي مفاهيمي، وليس مخططًا لبنية Fileverity. يرمز X إلى الصورة المرصودة، ويرمز Y إلى فئة المصدر، ويرمز T إلى تمثيل مشتق منها. ولا يعرض الرسم أي سمات خاصة بنموذج بعينه.
والكلمة المهمة هنا هي «قد»؛ فالتمثيل قد يفقد معلومات المصدر، لكنه لا يفقدها بالضرورة، إذ قد يحتفظ تمثيل مختار بعناية بما تحتاجه مهمة الكشف بالضبط. غير أن التمثيل الجيد لوصف المشهد لا يكفي بالضرورة لتصنيف المصدر، فهما هدفان مختلفان للتحسين.
ولا يثبت هذا المبدأ أن كل نموذج لغوي كبير متعدد الوسائط عاجز عن الكشف؛ فقد يتلقى النموذج معلومات الصورة مباشرة، وقد يغيّر تدريب متخصص قدراته. لكنه يثبت أمرًا أضيق نطاقًا وأقوى حجة: القدرة على فهم محتوى الصورة وحدها ليست دليلًا على أداء جرى التحقق منه في كشف المصدر.
وتدعم الملاحظات العملية هذا الحذر. ففي تحليل نشرته منظمة Full Fact (بالإنجليزية) بتاريخ 28 أغسطس 2026، وجّهت هذه المنظمة البريطانية المستقلة المعنية بتدقيق الحقائق أسئلة إلى روبوتات محادثة قائمة على نماذج لغوية كبيرة عن ادعاءات تشمل صورًا ومقاطع مصوّرة مولَّدة أو معدَّلة بالذكاء الاصطناعي، فأخطأت عدة نماذج حين عدّت بعض الصور المولَّدة صورًا حقيقية. وخلصت المنظمة إلى أنه لا يمكن الاعتماد على النماذج اللغوية الكبيرة بوصفها وسيلة مضمونة تمامًا للتحقق من الادعاءات. وهذه ملاحظة عن حالات محددة، وليست قياسًا لأداء كشف المصدر.
كيف يحوّل الكاشف الأدلة إلى قرار قابل للاختبار
لنفترض قياسًا عامًا E. يسأل كاشف المصدر: هل القيمة المرصودة E أكثر دلالة على الصور المولَّدة أم على الصور الملتقطة بالكاميرا؟ ويمكن التعبير عن هذه المقارنة من حيث المفهوم بالصيغة الآتية:
L(E) = p(E | generated) / p(E | camera)
وهذه نسبة أرجحية (Likelihood Ratio) تشير فيها generated إلى الصور المولَّدة وتشير camera إلى الصور الملتقطة بالكاميرا. وهي لا تعني أن Fileverity تنفّذ هذه الصيغة مباشرة، بل تشرح الهدف: التمييز بين أنماط مرتبطة بالمصدر، لا الحكم على ما إذا كان المشهد منطقيًا. وترجّح النسبة المرتفعة أحد التفسيرين على الآخر في ظل التوزيعات المفترضة، ولا تعني بالضرورة احتمالًا لاحقًا بأن ملفًا بعينه مزيّف.
ويمكن تقييم درجة الكشف الصادرة عن نموذج مُدرَّب بالتجربة العملية دون معرفة التوزيعات الحقيقية: تُحدَّد عتبة وتُطبَّق على أمثلة موسومة، ثم تُحصى النتائج. وتغيير العتبة يغيّر المقايضة بين العثور على الصور المولَّدة ووضع علامة بالخطأ على صور حقيقية. ويجعل منحنى ROC، الذي يرسم معدل الكشف مقابل معدل الإيجابيات الكاذبة، هذه المقايضة قابلة للفحص.
وتقدّم الأبحاث المنشورة أمثلة على هذا التمييز. فتدرس الورقة البحثية Zero-Shot Detection of AI-Generated Images (بالإنجليزية) القابلية للتنبؤ الإحصائي في ظل نموذج للصور الحقيقية. ونستشهد بها بوصفها مثالًا على سؤال بحثي يتعلق بمؤشرات المصدر، لا بوصفها إفصاحًا عن طريقة Fileverity.
من النظرية إلى الملاحظات: تقييم واحد مثبَّت
حُسب الشكل الآتي من التنبؤات المحفوظة لكل صورة في تقييم FVIMG V2 المؤرخ في 1 نوفمبر 2026. وخلافًا للرسم المفاهيمي السابق، هذه نتائج مقيسة: صور مولَّدة من مجموعة Synthbuster، وصور ملتقطة بالكاميرا من مجموعة RAISE-1k.
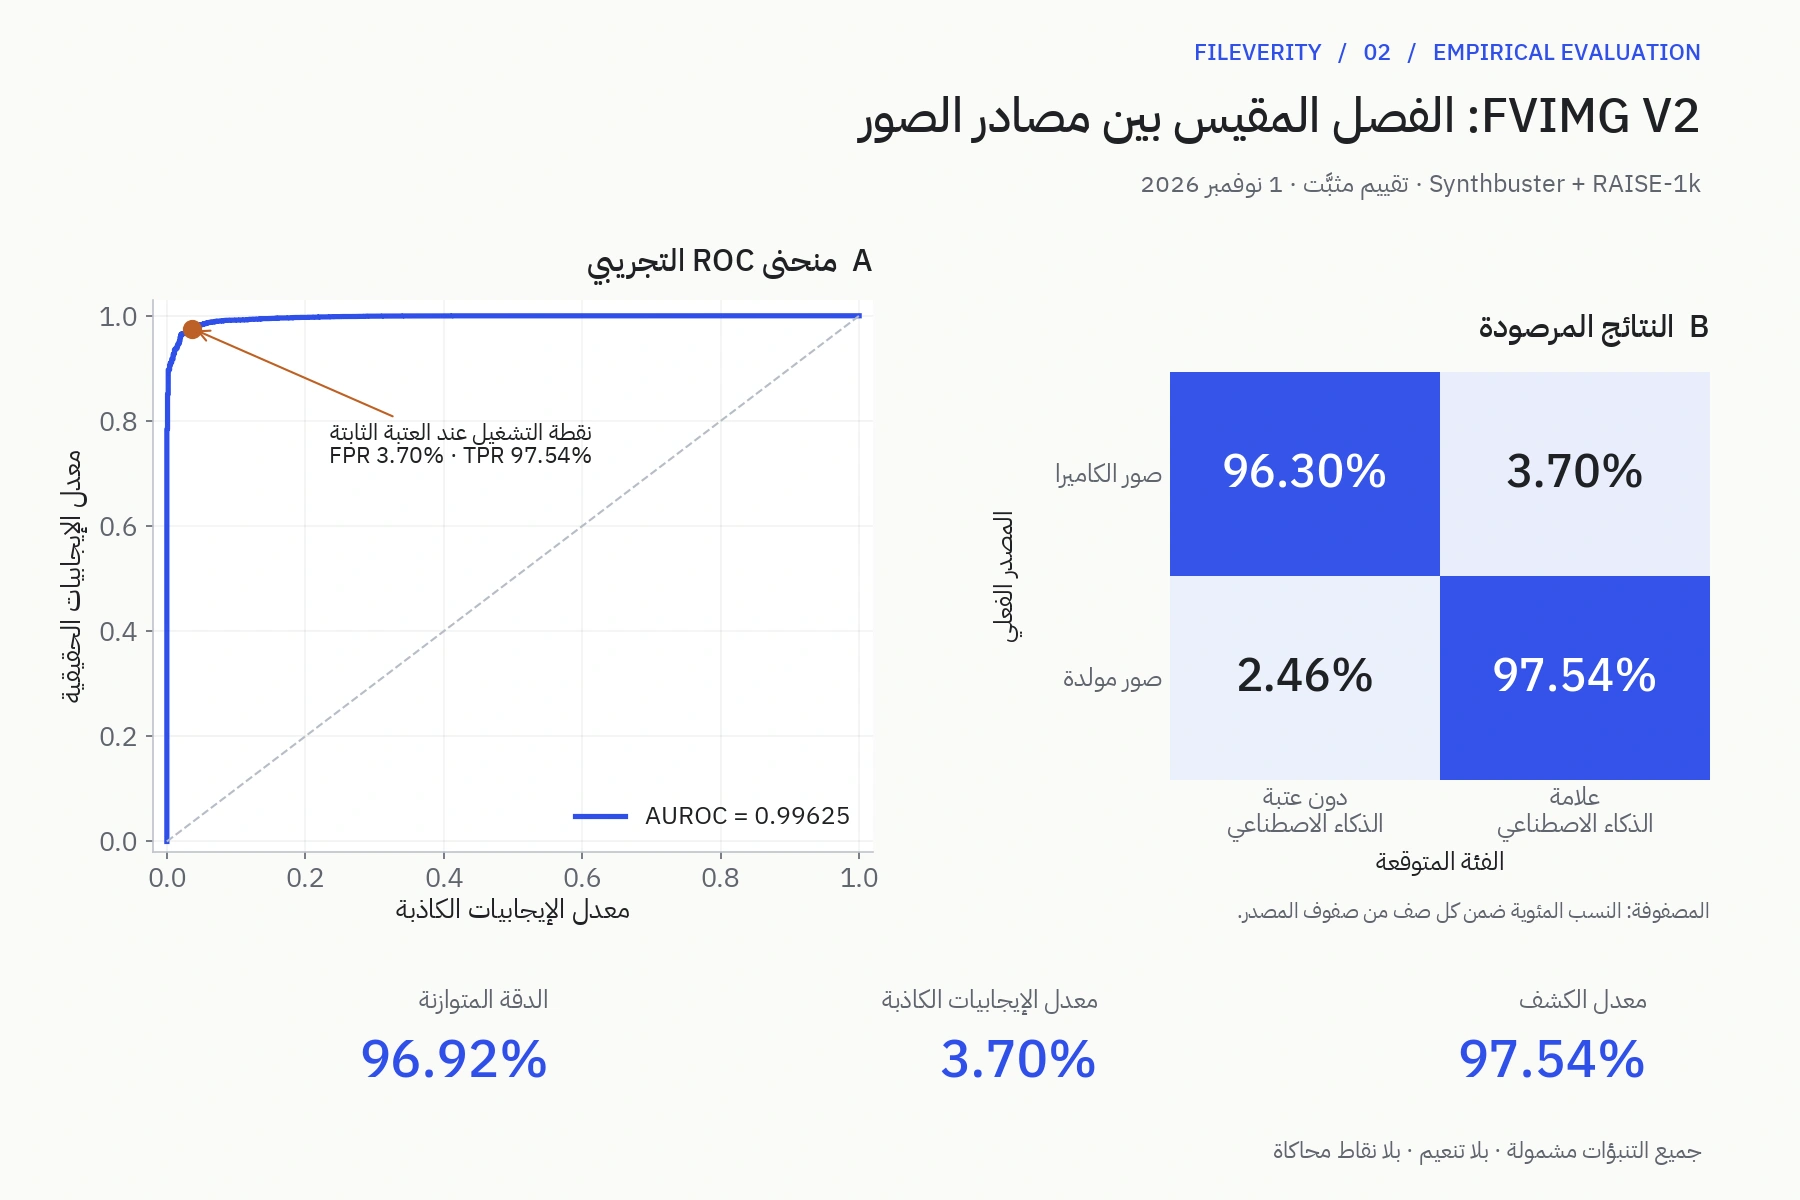
اللوحة A: منحنى ROC تجريبي تُجمَّع فيه الدرجات المتساوية قبل التكامل، وتمثل النقطة المعلَّمة العتبة الثابتة للتقييم. اللوحة B: مصفوفة النتائج المرصودة بحسب مصدر الصورة الفعلي، وكل نسبة فيها محسوبة من مجموع صفها. لم يُستخدم أي تنعيم ولا نقاط بيانات مُحاكاة.
| ما قيس | نتيجة FVIMG V2 |
|---|---|
| الصور المولَّدة المكتشفة | 97.54% |
| الصور الحقيقية المصنفة تصنيفًا صحيحًا دون عتبة الذكاء الاصطناعي | 96.30% |
| الدقة المتوازنة (Balanced Accuracy) | 96.92% |
| المساحة تحت منحنى ROC (AUROC) | 0.99625 |
ويبلغ معدل الإيجابيات الكاذبة 3.70%، وهو نسبة الصور الحقيقية التي وُضعت عليها علامة بالخطأ. ويدعم الفصل بين الدرجات نتيجة كشف محددة في هذا التقييم، لكنه لا يحوّل درجة النموذج إلى احتمال عام لأصالة الملف. ويوثّق التقرير الكامل للاختبار المرجعي طريقة معالجة المدخلات ونطاق التقييم: نواة كشف تعمل على مستوى البكسل، دون إضافة البيانات الوصفية أو منشأ المحتوى إلى النتيجة الرئيسية. ولم تُدرج النماذج اللغوية الكبيرة في الاختبار بوصفها نقطة مقارنة.
لماذا يفيد تعدد الأدلة المتكاملة
يفسّر مبدأ المعلومات نفسه قيمة تعدد الفحوص. فبعد ملاحظة E1، يفيد قياس آخر E2 إذا أخبرنا بشيء إضافي عن المصدر. وتكرار E1 بصياغة مختلفة لا يضيف قياسًا جديدًا، أما ملاحظة متكاملة حقًا فقد تضيفه.
وهذا هو الفرق بين جمع آراء أكثر وفحص أدلة أكثر. فالفحوص المترابطة قد تكرر الخطأ نفسه، وكثرة المكوّنات ليست ضمانًا رياضيًا. والمحك العملي هو ما إذا كان الجمع بينها يحسّن جودة القرارات المقيسة على ملفات ممثِّلة للواقع.
ويظهر هذا المنطق نفسه في إرشادات رسمية سعودية موجَّهة إلى الجمهور. فقد ذكرت صحيفة Arab News (بالإنجليزية) في تقرير نُشر في 9 مايو 2026 أن إرشادات التزييف العميق الصادرة عن الهيئة السعودية للبيانات والذكاء الاصطناعي (سدايا) توصي بنهج من ثلاث خطوات: تقييم مصدر الرسالة وسياقها، ثم تحليل العناصر السمعية والبصرية بحثًا عن علامات التلاعب، ثم التحقق من المحتوى بأدوات كشف قائمة على الذكاء الاصطناعي وبأدوات منشأ المحتوى. وهكذا تضيف كل خطوة نوعًا مختلفًا من الأدلة، وتبقى الأداة المتخصصة خطوة قائمة بذاتها لا تغني عنها قراءة الصورة بالعين. وهذا لإطلاع القارئ على السياق فحسب؛ فلا تُعلن Fileverity امتثالها لهذه الإرشادات. أما حدود العلامات المائية ومنشأ المحتوى بوصفهما دليلًا إضافيًا، فيتناولها دليل C2PA والعلامة المائية الرقمية وكواشف الصور.
تطبّق Fileverity هذا النهج القائم على الأدلة على التحقق من الصور. ولكل من FVIMG V2 ونموذج كشف المستندات FVDOC V3 هوية إصدار ونطاق تقييم مستقلان. وتُطوَّر نماذج Fileverity وتُختبر على بيانات ضخمة خاصة وحصرية أعدّها مختصون بعناية، أما النتائج المعروضة هنا فمستمدة من اختبار علني تستطيع أي جهة فحصه بنفسها. ولا نفصح هنا عن اختيارات السمات الداخلية أو طريقة الجمع بينها؛ فالنتيجة المعلنة تقرير قابل للفحص وسجل أداء مرتبط بمهمة محددة.
كاشف الصور بالذكاء الاصطناعي أم ChatGPT: ماذا تسأل؟
السؤال المفيد ليس «هل يستطيع النظام شرح هذه الصورة؟» بل «ما الأدلة التي تدعم تصنيفه للمصدر، وكيف جرى تقييم هذا التصنيف؟». اطلب اسم الإصدار، ومجموعة اختبار محددة المعالم، وسلوك الإيجابيات الكاذبة إلى جانب معدل الكشف. ويشرح دليل الدقة والإيجابيات الكاذبة في كشف الصور المولَّدة بالذكاء الاصطناعي كيفية تفسير هذه المقاييس.
فهم المشهد أمر قيّم. أما كشف المصدر على المستوى المهني فيضيف شرطًا مختلفًا: الاحتفاظ بالأدلة ذات الصلة، وتحويلها إلى قرار محدد، وإثبات مستوى أداء هذا القرار عند اختباره. وهذا أساس مسار التحقق المتخصص في Fileverity. وإذا كنت تعتزم ربط كاشف بأنظمتك، فإن دليل كيف تختار واجهة API لكشف الذكاء الاصطناعي يتناول عشرة معايير ينبغي فحصها قبل الربط.
بقلم Yang Zheng