Erkennung bewerten
Kann ChatGPT KI-Bilder erkennen? Warum Bildverständnis kein Herkunftsnachweis ist
Was Bildbeschreibung und Herkunftserkennung unterscheidet: Informationstheorie, statistische Prüfung und gemessene FVIMG-V2-Ergebnisse mit ROC-Kurve.
Veröffentlicht · Aktualisiert · 4 Min. Lesezeit
Auf dieser Seite
Kann ChatGPT erkennen, ob ein Bild KI-generiert ist? Es kann Hinweise liefern. Doch ein Bild richtig zu beschreiben und seine Entstehung zu bestimmen, sind unterschiedliche Aufgaben. Für die Herkunftsprüfung zählt, welche Informationen über die Quelle im Entscheidungsprozess erhalten bleiben.
Die Erkennungskette von Fileverity ruft keine LLMs auf. Sie verwendet spezialisiertes maschinelles Lernen und technische Prüfverfahren. Dieser Beitrag erklärt einen öffentlichen theoretischen Grund dafür: Inhaltsinformation ist nicht mit Herkunftsinformation gleichzusetzen. Interne Merkmale, Netzstrukturen und Kombinationen legen wir dabei nicht offen.
Was eine richtige Bildbeschreibung noch nicht beweist
| Aussage | Was daraus folgt |
|---|---|
| „Ein rotes Auto steht vor einer Backsteinwand.“ | Der Bildinhalt wurde beschrieben. |
| „Licht und Perspektive wirken plausibel.“ | Es wurde eine visuelle Einschätzung abgegeben. |
| „Das Bild stammt aus einer Kamera.“ | Eine andere Frage wurde beantwortet: die nach der Quelle. |
Sowohl ein Foto als auch ein generiertes Bild können die ersten beiden Aussagen erfüllen. Wird für die weitere Prüfung nur dieselbe Beschreibung weitergegeben, sind diese beiden Eingaben dort nicht mehr unterscheidbar. Ausführlicheres Nachdenken über denselben Satz holt die ausgelassenen Unterschiede nicht zurück.
Auch sichtbare Fehler sind deshalb kein vollständiger Herkunftsnachweis. Normale Hände beweisen keine Kameraaufnahme; ein merkwürdiger Schatten beweist keine Generierung. Ob ein Hinweis tatsächlich zwischen Quellen unterscheidet, muss geprüft werden.
Der Informationsengpass als theoretischer Kern
Y bezeichnet die Herkunftsklasse, X das verfügbare Bild und T eine daraus abgeleitete Darstellung, etwa einen Beschreibungstext. Wenn die weitere Entscheidung nur T erhält, stellt sich die Frage, wie viel Herkunftsinformation darin steckt.
Die Data-Processing-Ungleichung aus den MIT-Lehrunterlagen lautet für diese Kette I(Y; T) ≤ I(Y; X): Verarbeitung allein erzeugt keine zusätzliche Information über die Quelle.
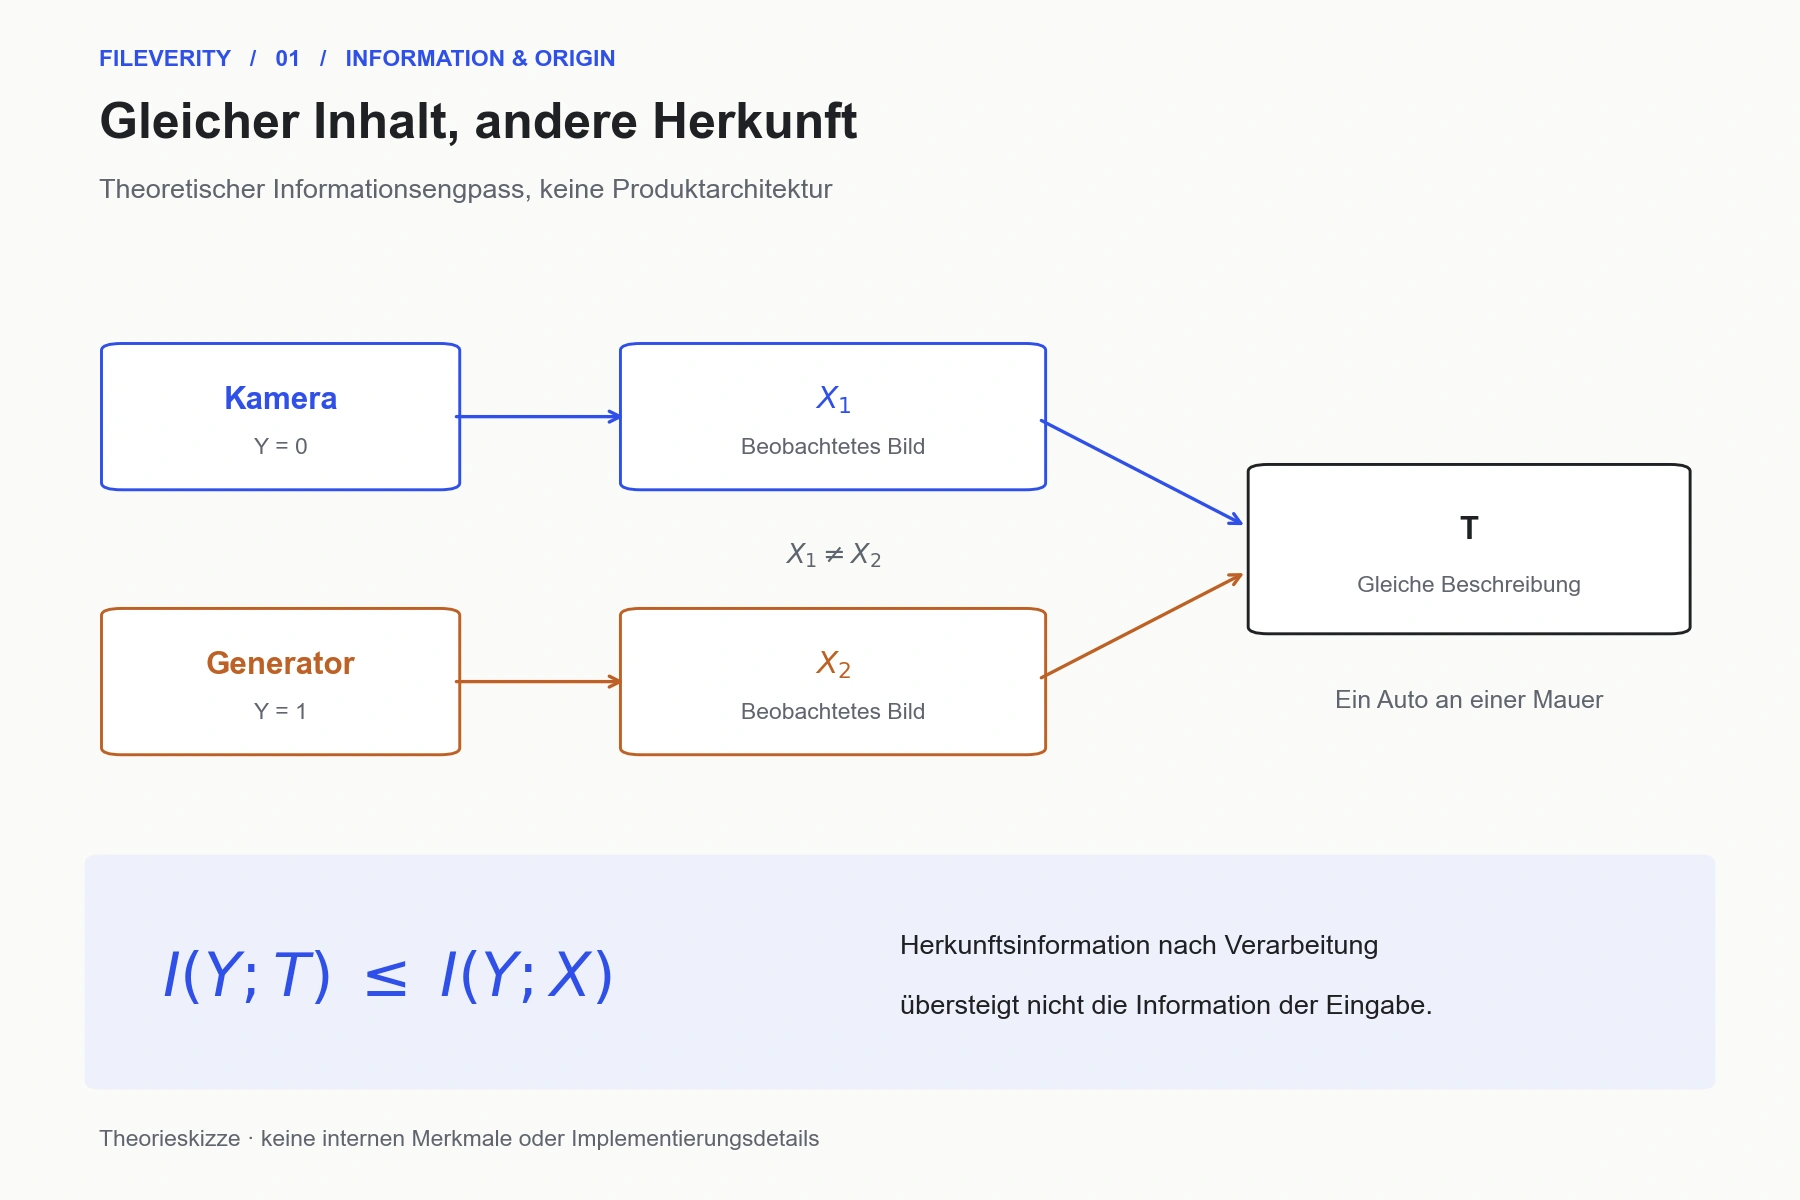
Theorieskizze, keine Darstellung der Fileverity-Architektur. Y steht für die Quelle, X für das beobachtete Bild und T für eine abgeleitete Darstellung. Interne Erkennungsmerkmale werden nicht gezeigt.
Eine geeignete Darstellung kann durchaus die für eine Aufgabe wesentlichen Informationen bewahren. Gute Szenenerkennung garantiert aber nicht, dass zugleich alle für die Herkunftsklassifikation nötigen Informationen erhalten bleiben. Die Zielsetzungen unterscheiden sich.
Das ist kein Unmöglichkeitsbeweis für sämtliche multimodalen LLMs: Sie können Bildinformationen unmittelbar erhalten und für besondere Aufgaben trainiert werden. Die belastbare Schlussfolgerung lautet vielmehr: Allgemeines Bildverständnis belegt noch keine validierte Herkunftserkennung.
Herkunftserkennung als statistische Prüfaufgabe
Für eine abstrakte Beobachtung E lässt sich fragen: Wie typisch ist sie für generierte Bilder im Vergleich zu Kameraaufnahmen? Der allgemeine Likelihood-Quotient beschreibt das als L(E) = p(E | generiert) / p(E | Kamera).
Diese Formel erklärt das Prüfziel; sie beschreibt nicht unsere Implementierung. Sie vergleicht zwei Erklärungen unter angenommenen Verteilungen und ist nicht automatisch eine Fälschungswahrscheinlichkeit für die einzelne Datei.
Ein gelernter Erkennungswert lässt sich empirisch prüfen: Schwelle festlegen, bekannte Beispiele auswerten, Treffer und Fehler zählen. Verschiedene Schwellen ergeben unterschiedliche Kombinationen aus Erkennungs- und Fehlalarmrate. Die ROC-Kurve stellt diese Kombinationen dar.
Eine wissenschaftliche Arbeit wie Zero-Shot Detection of AI-Generated Images untersucht beispielsweise statistische Vorhersagbarkeit als Zugang zur Herkunftserkennung. Sie illustriert die Forschungsrichtung und ist keine Angabe darüber, welche Verfahren Fileverity intern einsetzt.
FVIMG V2: Theorie und tatsächliche Messung getrennt betrachten
Die folgende Abbildung wurde aus den gespeicherten Einzelvorhersagen unserer FVIMG-V2-Auswertung vom 1. November 2026 berechnet. Sie umfasst sämtliche generierten Synthbuster-Bilder und sämtliche realen RAISE-1k-Aufnahmen dieser Auswertung. Beide Datensätze sind öffentlich zugänglich, der Maßstab ist also unabhängig überprüfbar. Fileverity selbst entwickelt und validiert seine Modelle auf umfangreichen, exklusiven und professionell kuratierten eigenen Datenbeständen.
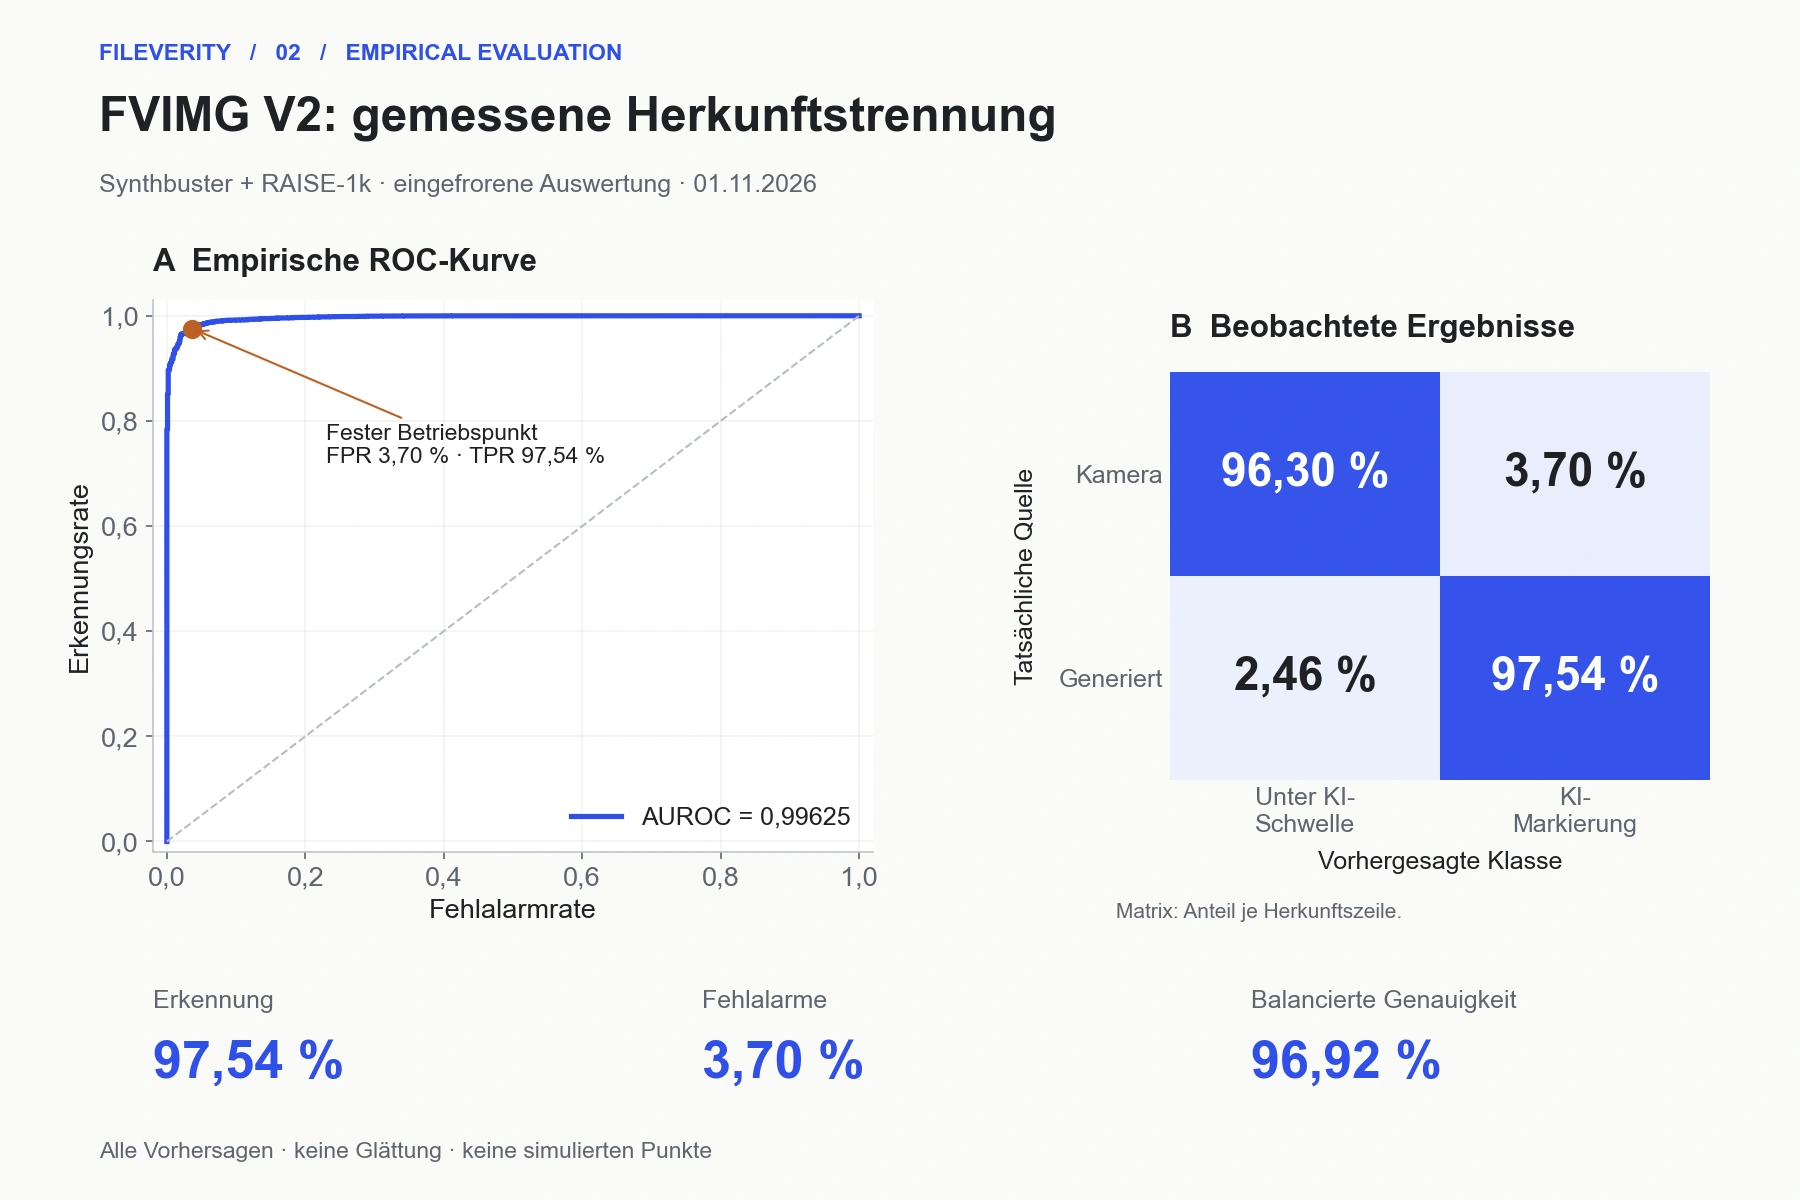
Gleiche Scores werden vor der Integration zusammengefasst. Der markierte Punkt entspricht dem festen Schwellenwert der Auswertung. Die Matrix zeigt den Anteil je Herkunftszeile. Keine Glättung und keine simulierten Beobachtungen.
Die Ergebnisse lassen sich an vier Größen ablesen:
- 97,54 % Erkennungsrate: Anteil der generierten Bilder, die oberhalb der KI-Schwelle lagen.
- 96,30 % Spezifität: Anteil der realen Fotos, die korrekt unter der KI-Schwelle blieben. Die übrigen 3,70 % sind Fehlalarme.
- 96,92 % balancierte Genauigkeit: Beide Herkunftsklassen erhalten das gleiche Gewicht.
- 0,99625 AUROC: Trennleistung über die Schwellen hinweg, keine individuelle Echtheitswahrscheinlichkeit.
Der vollständige Synthbuster-Bericht erläutert die Eingabebehandlung und den Umfang: Gemessen wurde der pixelbasierte Erkennungskern, ohne zusätzliche Metadaten- oder Herkunftsnachweise im Hauptwert. LLMs waren keine Vergleichsteilnehmer dieser Auswertung.
Zusätzliche Belege statt zusätzlicher Meinungen
Liegt bereits die Beobachtung E1 vor, hilft E2 dann, wenn sie darüber hinaus relevante Information enthält. Eine neue Formulierung von E1 ist keine neue Messung. Ein ergänzender Befund kann dagegen zur Unterscheidung der Quellen beitragen.
Mehrere Verfahren können dieselben Fehler machen. Ihre Anzahl allein beweist deshalb keinen Qualitätsgewinn. Entscheidend ist, ob die Kombination auf repräsentativen Dateien messbar bessere Entscheidungen ermöglicht.
Diese Unterscheidung ist für die technische Bildprüfung von Fileverity wesentlich. FVIMG V2 und unser Dokumentmodell FVDOC V3 haben eigene Versionsbezeichnungen und Bewertungsbereiche. Öffentlich nachvollziehbar sind ihre Befunde und Messergebnisse; interne Merkmalsauswahl und Kombinationen bleiben unbeschrieben.
Drei Fragen für die Auswahl einer Prüflösung
- Welche Information stützt die Herkunftseinstufung?
- Für welche Modellversion und welche Testdateien wurde die Leistung gemessen?
- Wie hoch sind Erkennungsrate und Fehlalarmrate an derselben Schwelle?
Unser Leitfaden zur Zuverlässigkeit von KI-Bilddetektoren ordnet diese Kennzahlen ein. Der Fileverity-Prüfablauf verbindet die spezialisierte Analyse mit nachvollziehbaren Ergebnissen. Seine Aufgabe ist, relevante Information zu prüfen und die Leistung zu belegen — nicht nur eine überzeugende Bildbeschreibung zu liefern. Wenn Sie einen Detektor an eigene Systeme anbinden wollen, führt KI-Erkennungs-API auswählen durch zehn Prüfpunkte der Integration.
Von Yang Zheng