Evaluar la verificación
Cómo funciona un detector de plagio: qué encuentra, qué no y cómo leer el resultado
Cómo funciona un detector de plagio web: frases buscadas, fuentes, porcentaje de texto coincidente, lo que no ve y cómo leer el resultado en un ensayo o TFG.
Publicado · 9 min de lectura
En esta página
Un detector de plagio web busca en páginas públicas y en Wikipedia los pasajes de su texto que aparecen en el mismo orden en otras fuentes, los marca y enlaza cada uno con la página de la que procede. Dice cuánto texto coincide y de dónde, pero no dice si hay plagio: eso lo decide una persona que lee cada pasaje en su contexto. Esta guía explica cómo funciona un detector de plagio paso a paso, qué cuenta en el porcentaje de texto coincidente, qué no puede ver y cómo leer un resultado, con un ejemplo, para quienes revisan o presentan un ensayo, un TFG o un TFM.
Está pensada para estudiantes que comprueban su trabajo antes de entregarlo, docentes ante un texto que suena a página copiada y editores que revisan colaboraciones. Si lo que busca es la diferencia entre plagio e IA, y el marco sancionador, empiece por detector de plagio o detector de IA; aquí nos ocupamos de cómo funciona la herramienta y de cómo interpretarla.
Qué hace un detector de plagio web
Un detector de plagio no compara ideas: compara secuencias de palabras. Un detector web, como el detector de plagio de Fileverity, consulta lo que es público: páginas web y Wikipedia en el idioma del texto. Funciona en español, inglés, francés y árabe, necesita al menos 50 palabras y acepta hasta 30 000 caracteres.
De un texto a sus fuentes
El proceso tiene cinco pasos y suele durar entre diez y sesenta segundos.
- Frases distintivas. La herramienta elige del texto frases poco frecuentes, aproximadamente una por cada setenta palabras y hasta veinticuatro, tomadas fuera de las comillas y de la lista de referencias.
- Búsqueda. Cada frase se busca en un índice de búsqueda web público y en Wikipedia, en el idioma del texto. Las páginas que contienen la frase pasan a ser candidatas.
- Lectura de las páginas. Se leen hasta quince páginas candidatas. Se respeta el archivo robots.txt: si una página no permite la lectura automática, solo se compara su fragmento de la búsqueda y la fuente aparece con la etiqueta «Solo fragmento».
- Alineación palabra a palabra. El texto y cada página se alinean. Una serie de siete o más palabras en el mismo orden cuenta como coincidencia. Si la serie es ininterrumpida es una coincidencia exacta; si tiene pequeños saltos, de hasta tres palabras, es una coincidencia aproximada.
- Resultado. Cada pasaje coincidente se marca en el texto y se enlaza con una fuente numerada. La lista de fuentes muestra el título, el sitio y la parte del texto que explica cada una.
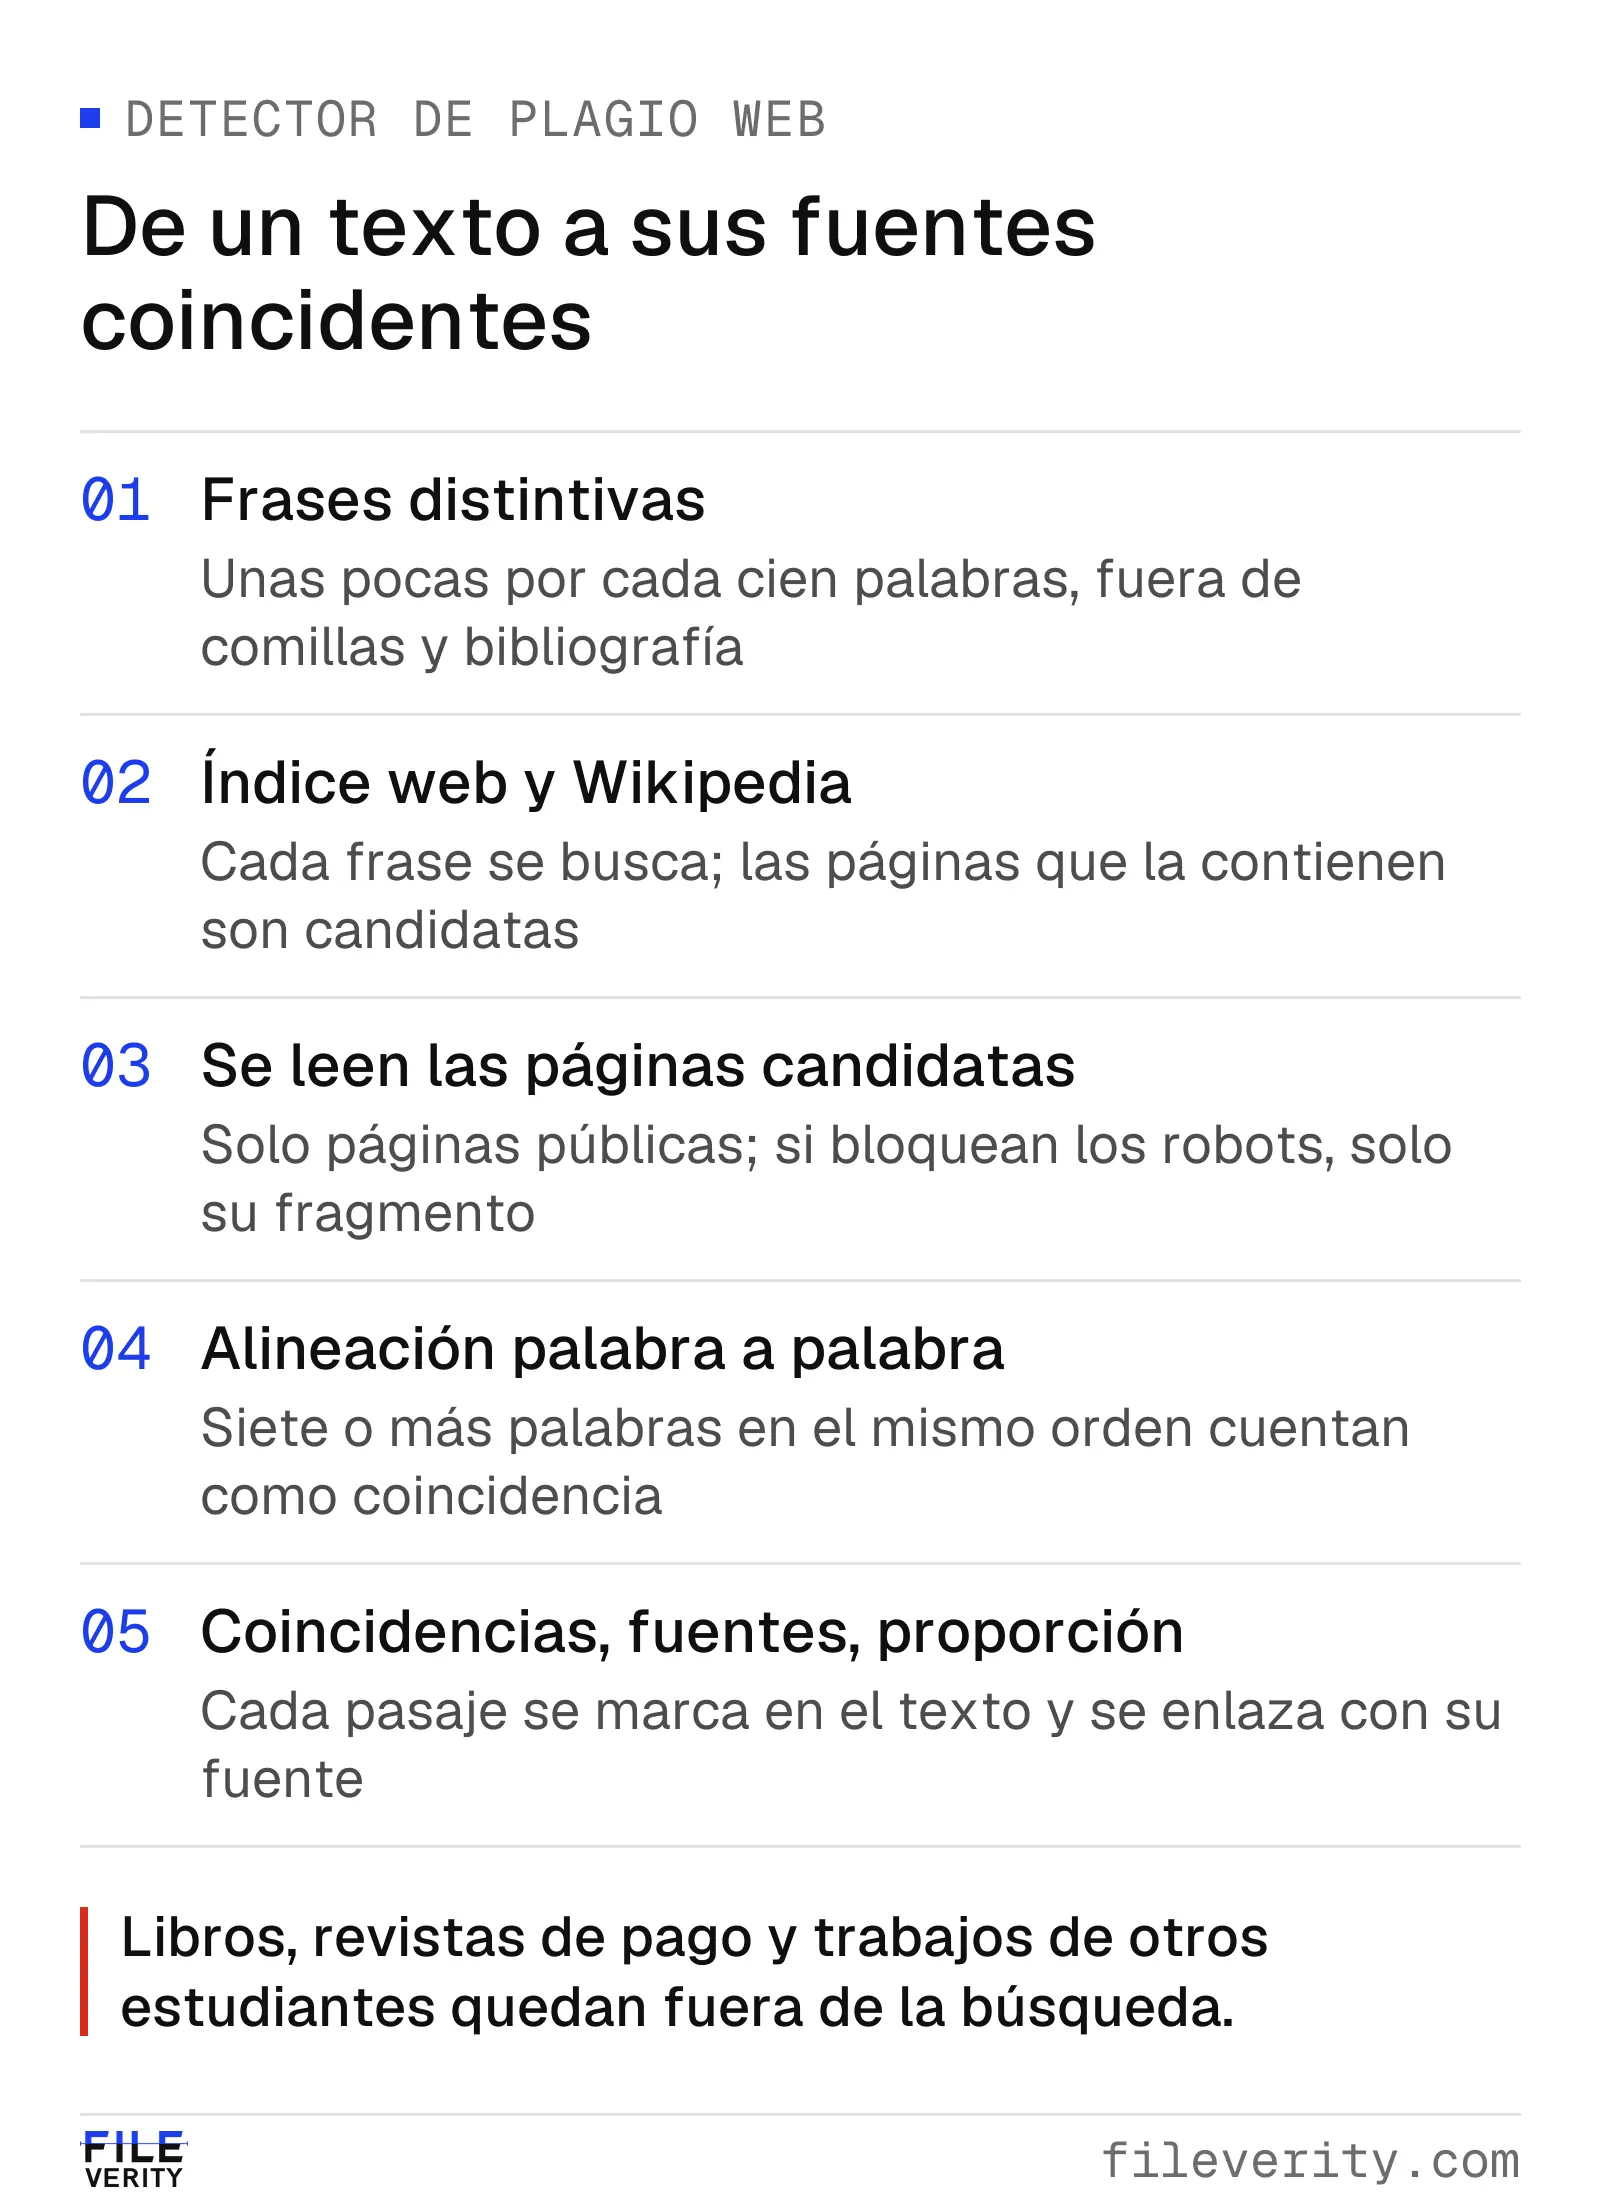
Del texto a sus fuentes: frases distintivas, búsqueda, lectura de páginas, alineación y resultado.
Qué cuenta en el porcentaje y qué no
El porcentaje de texto coincidente es el número de palabras coincidentes dividido entre las palabras que cuentan, una vez aplicadas las exclusiones. Por defecto quedan fuera los pasajes entre comillas y las entradas de la lista de referencias; se marcan como tales, y dos casillas permiten incluirlos en el cálculo.
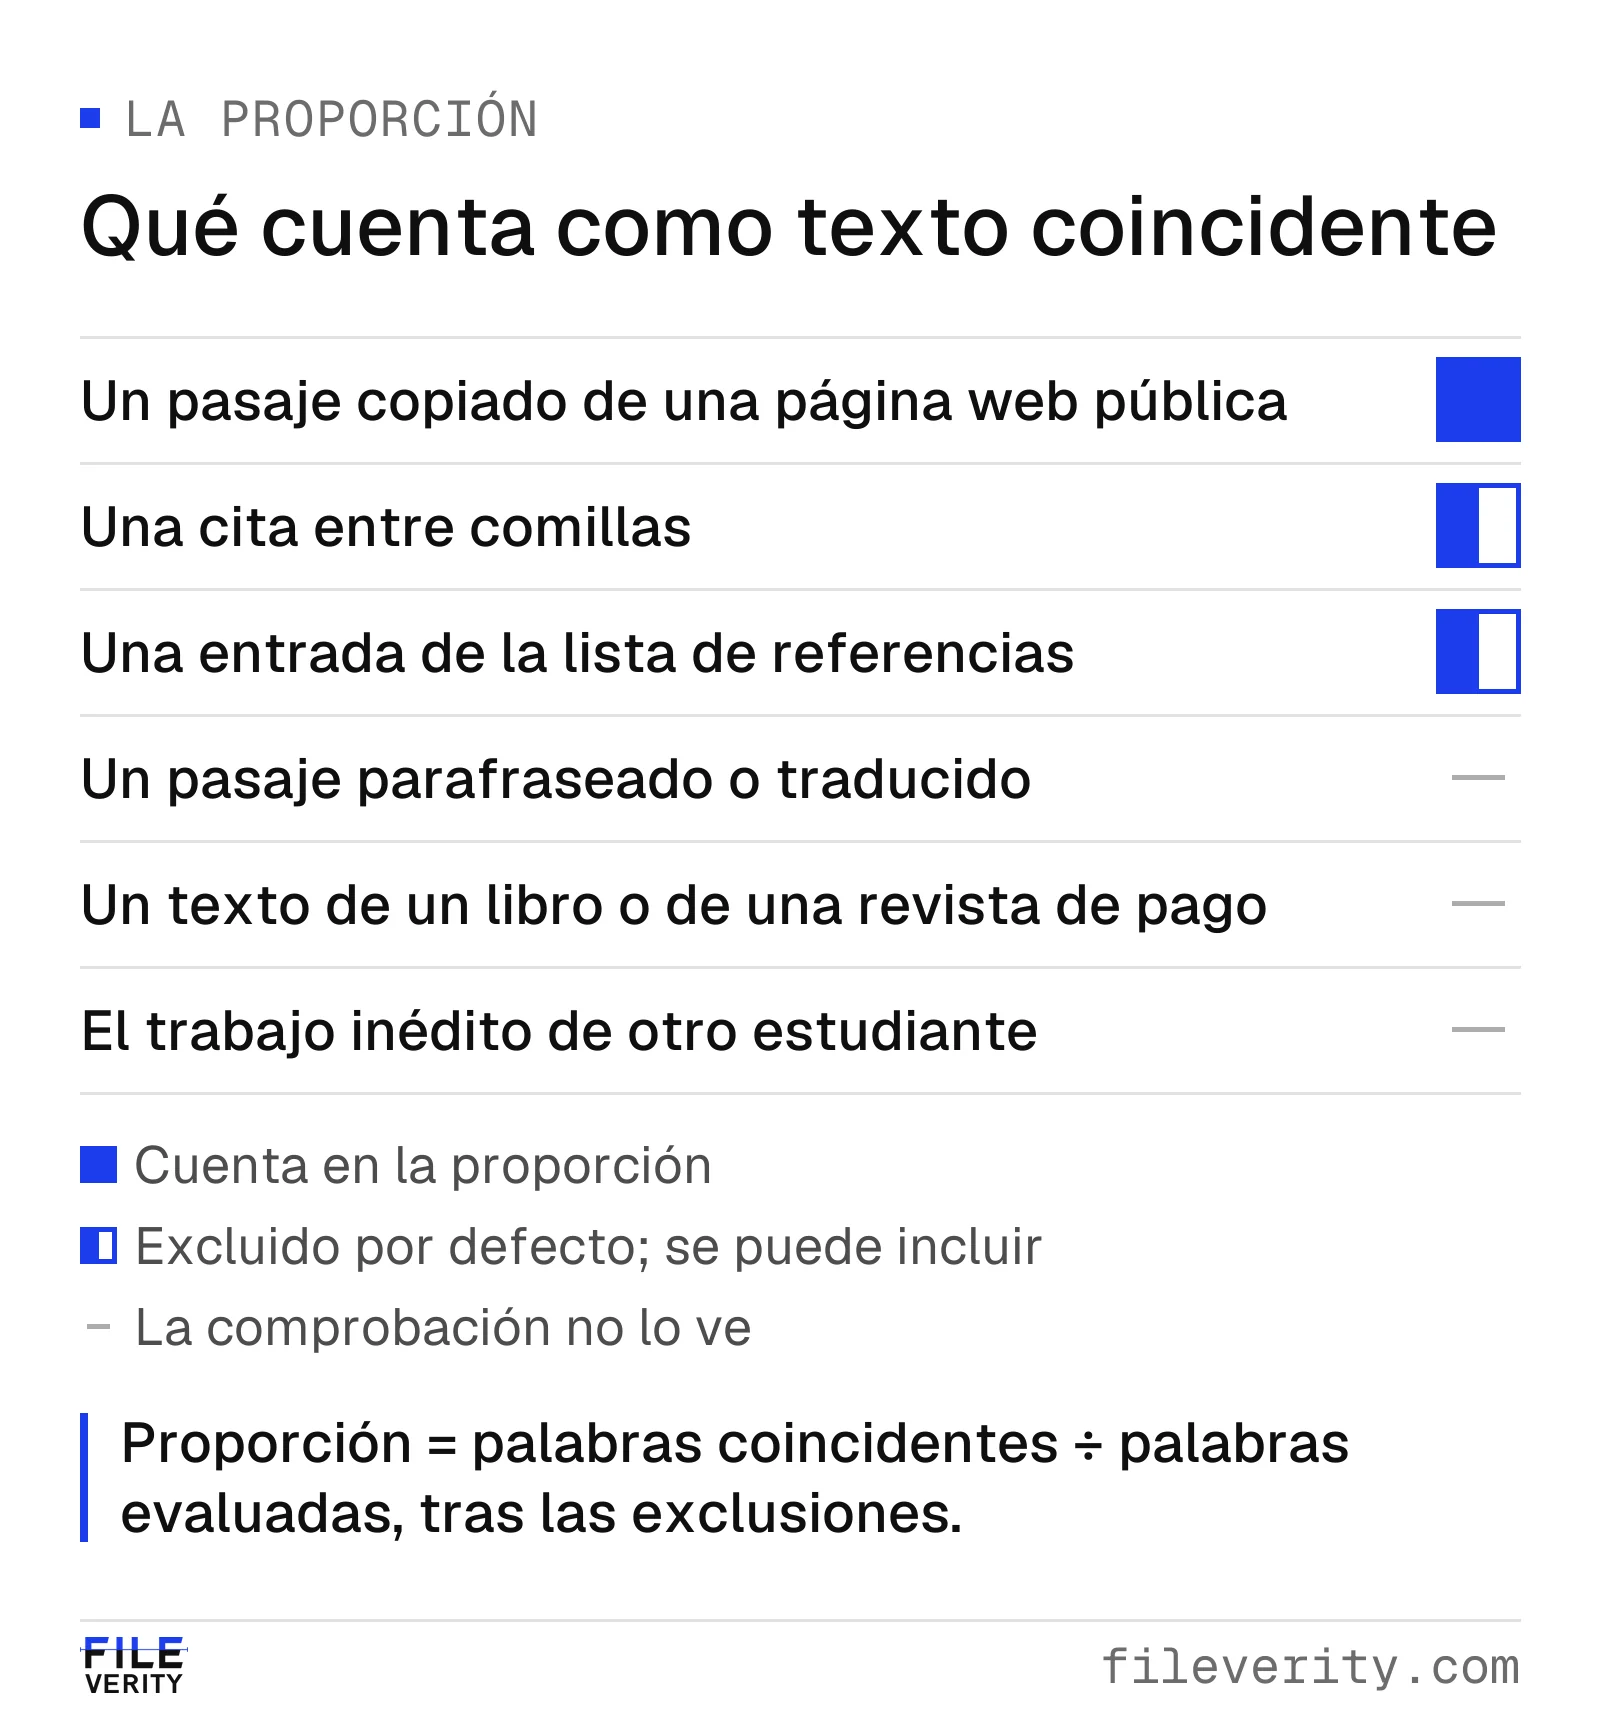
Qué cuenta como texto coincidente y qué queda fuera de la búsqueda.
Lo que el detector no ve es tan importante como lo que ve:
- Paráfrasis. Solo se encuentran series de palabras en el mismo orden. Un pasaje reformulado no se detecta, y eso no lo libra de ser plagio: la guía de la UNED para los trabajos de fin de título incluye en él «la paráfrasis sin citar correctamente la fuente», y la guía de la Universidad Villanueva excluye el parafraseo para evitar el plagio y eludir la atribución de autoría.
- Traducciones. Un texto traducido de otro idioma no se encuentra, porque la búsqueda se hace en el idioma del texto.
- Libros y revistas de pago. Si la fuente no es una página pública, no está en el alcance.
- Trabajos de otros estudiantes y plataformas de entrega. Tampoco se consultan.
- Expresiones comunes y pasajes bien citados. Sí coinciden, aunque no sean un problema.
Un resultado sin texto coincidente significa que no se encontraron coincidencias en la web abierta ni en Wikipedia, no que el texto sea original.
Cómo leer un resultado
El resultado empieza con una de cuatro franjas: «Sin texto coincidente», «Poco texto coincidente», «Algo de texto coincidente» o «Mucho texto coincidente». Después vienen los pasajes y las fuentes. Una lectura ordenada sigue este camino:
- Mire la franja y la proporción, que son un resumen, no una conclusión.
- Recorra las fuentes. Cada una indica su título, su sitio y qué parte del texto explica. Una sola fuente con mucho texto es más llamativa que varias fuentes con una frase cada una.
- Abra cada pasaje en su contexto. Compare su texto con la fuente. Una coincidencia exacta de una definición es distinta de una aproximada con una palabra cambiada.
- Tenga en cuenta la etiqueta «Solo fragmento». Significa que no se pudo leer la página completa; abra el enlace y compruebe usted mismo la coincidencia.
- Clasifique cada pasaje. Puede ser una cita correcta, una expresión habitual, un pasaje que necesita cita o un problema.
El texto coincidente no es un veredicto. Una cita bien señalada, una fórmula de cortesía o un nombre de institución también coinciden.
Un ejemplo inventado
Imagine un ensayo ficticio de Biología de primer curso en el que el detector marca tres pasajes:
- La frase «La fotosíntesis es el proceso mediante el cual las plantas, las algas y algunas bacterias transforman la energía de la luz en energía química», escrita sin comillas ni referencia, coincide de forma exacta con una entrada de una enciclopedia en línea. Es el único pasaje que pide acción: o se reformula con palabras propias y se cita la fuente, o se pone entre comillas con su referencia.
- Una cita entre comillas con su autoría y su año aparece como «Entre comillas» y queda fuera del cálculo. No hace falta cambiar nada, salvo comprobar que la referencia completa esté en la bibliografía.
- Una entrada de la lista de referencias aparece como «En la lista de referencias» y también queda fuera.
Un cuarto párrafo, copiado de un libro y con cambios de redacción, no aparece. El resultado puede ser «Poco texto coincidente» y el ensayo aun así tener un problema. Por eso conviene leer el trabajo además del informe.
Detector de plagio y detector de IA
El detector de plagio pregunta si el texto coincide con otro; el detector de IA, si la redacción se parece a la de un modelo de lenguaje. Un texto generado puede salir limpio en plagio, y un texto copiado de una página puede no mostrar indicios de IA. En Fileverity las tres comprobaciones, detección de IA, corrector gramatical y detector de plagio, comparten una ventana: se pega el texto una vez, se ejecuta la que interesa, se edita y se comprueba de nuevo. Si el detector de IA señala un trabajo, la guía qué hacer cuando un detector señala el trabajo de un alumno explica los siguientes pasos.
Detector web frente a sistemas institucionales
Turnitin y Compilatio son sistemas que contratan las instituciones. Su valor adicional está en las bases de documentos que no son públicas.
- Turnitin. Su guía para estudiantes define el indicador de similitud como el porcentaje del texto que coincide con contenido de Internet, con sus bases de datos o con el trabajo de otra persona, y advierte: «Similitud no significa plagio». También señala que no existe un porcentaje aceptable establecido y que cada institución decide el umbral. Una guía de la Universidad Politécnica de Madrid explica que sus filtros permiten excluir lo entrecomillado y, mediante palabras clave como «Bibliografía» o «Referencias», todo lo que sigue a ese encabezado.
- Compilatio. Según su guía de inicio, Magister compara el documento en tres niveles: páginas, artículos y publicaciones de acceso libre en Internet, los contenidos que los equipos de la institución depositan en el programa y los documentos de otros usuarios de Magister que forman la biblioteca de referencias. El informe da un índice de similitud, la lista de fuentes y permite ignorar fuentes y pasajes, con recálculo del índice.
Un detector web cubre solo la primera parte. Cuando su universidad abre un procedimiento, el informe que cuenta es el del sistema que ella usa. Para una comprobación previa a la entrega, o para una primera lectura de un trabajo que suena a página copiada, la web abierta y Wikipedia son a menudo donde está el texto copiado, y la fuente queda a un clic.
Notas para España y Latinoamérica
En España, la Ley 3/2022 de convivencia universitaria considera falta muy grave plagiar total o parcialmente una obra, o cometer fraude académico, en el Trabajo de Fin de Grado, el de Fin de Máster o la Tesis Doctoral (art. 11.g), y falta grave el fraude académico así definido (art. 12.d). Si su universidad revisa los TFG y los TFM con un sistema propio, el informe de ese sistema es el que cuenta; antes de entregar, una comprobación en la web abierta permite descubrir qué pasajes necesitan una cita. El marco completo, con las garantías del procedimiento, está en la guía de detector de plagio o detector de IA.
En Latinoamérica y en cualquier otro contexto, la norma y el umbral los fija cada institución, de modo que ningún porcentaje general sirve de criterio. Pregunte siempre cuál es el sistema de su institución y cómo se interpreta su informe.
Coste
Solo se envían frases breves del texto a los servicios de búsqueda. El detector de plagio forma parte del plan Pro y cuesta 1 crédito por cada 1000 caracteres de texto, o fracción: un ensayo de 12 000 caracteres usa 12 créditos. Las comprobaciones que no se pueden completar no se cobran. Los docentes verificados tienen el plan Pro gratis durante 12 meses (para docentes, precios). Para integrarlo en otra aplicación existe la API de comprobación de plagio (POST /v1/text/plagiarism, modelo plagiarism-1), para espacios de trabajo que hayan comprado créditos.
Preguntas frecuentes
¿Cuánto texto necesito y cuánto tarda?
Al menos 50 palabras y hasta 30 000 caracteres. La comprobación suele tardar entre diez y sesenta segundos.
¿Por qué no aparece un texto que sé que está copiado?
Porque puede estar en un libro, en una revista de pago, en el trabajo de otra persona o parafraseado o traducido. El detector solo encuentra series de palabras en el mismo orden que estén en páginas públicas o en Wikipedia.
¿Sin coincidencias significa que mi trabajo es original?
No. Significa que no se encontró texto coincidente en las fuentes que se consultan. La originalidad se valora leyendo el trabajo.
¿Las citas bien hechas cuentan como plagio?
No cuentan en el cálculo: el texto entre comillas y las entradas de la bibliografía se marcan y quedan fuera por defecto. Puede incluirlos con las dos casillas si quiere ver el total.
¿Puede sustituir a Turnitin o a Compilatio?
No. Esos sistemas comparan además con bases de documentos que no son públicas. Este detector cubre la web abierta y Wikipedia.
Fuentes
- Turnitin, Comprender el Reporte de Similitud de Turnitin: una nueva experiencia. Guía para el estudiante, 2024.
- Universidad Politécnica de Madrid, servicio GATE (Juan José Moreno López), Interpretación del informe de originalidad (Turnitin), 2020.
- Compilatio, Introducción a Compilatio Magister, febrero de 2023.
- Jefatura del Estado, Ley 3/2022, de 24 de febrero, de convivencia universitaria, BOE núm. 48, 25 de febrero de 2022.
- Universidad Nacional de Educación a Distancia (UNED), Guía para asegurar la integridad académica en el uso de la Inteligencia Artificial Generativa en los Trabajos Fin de Título de la UNED, versión 1.0, 10 de diciembre de 2025.
- Universidad Villanueva, Vicerrectorado de Investigación y Transferencia, Guía de uso responsable, cita y referenciación de herramientas de Inteligencia Artificial Generativa en la Universidad Villanueva, 2025.
Por Yang Zheng · Revisado por Bill Liu