Evaluar la verificación
Precisión de un detector de imágenes generadas con IA: falsos positivos, umbrales y fiabilidad
Exactitud, precisión y falsos positivos de un detector de imágenes generadas con IA: cómo el umbral cambia la carga de revisión, con un ejemplo práctico.
Publicado · Actualizado · 18 min de lectura
En esta página
¿Es fiable un detector de imágenes generadas con IA? Depende de tres cosas: qué tarea se evaluó exactamente, con qué imágenes y con qué umbral se convierte una puntuación en una decisión. Un detector puede acertar en casi todas las imágenes y, aun así, enviar a su cola de revisión más falsas alarmas que detecciones verdaderas. Para juzgar su fiabilidad no basta la exactitud: hay que conocer la precisión, la sensibilidad y la tasa de falsos positivos en el umbral que usted va a aplicar.
Para evaluar un detector, plantee tres preguntas relacionadas: qué detecta, qué errores comete en el umbral previsto y qué ocurre con los archivos que no puede evaluar. Esta guía se dirige a los equipos de compras, riesgos tecnológicos, protección de datos y prevención del fraude que deben valorar una cifra antes de contratar. Los ejemplos numéricos conectan cada respuesta con el trabajo de revisión que recibirá su equipo.
Si solo necesita contrastar una cifra de un proveedor, lea las secciones sobre la matriz de confusión, la prevalencia y el umbral: muestran por qué una exactitud elevada puede convivir con una cola de revisión deficiente. Si dirige una evaluación, continúe con la calibración, la cobertura y el conjunto reservado, y utilice al final la petición de pruebas. Todos los ejemplos numéricos son hipotéticos: no son resultados de Fileverity ni estimaciones de la frecuencia del fraude.
Defina qué cuenta como positivo
Empiece con una frase como esta: «Esta evaluación comprueba si una imagen recibida se generó por completo con IA». Esa definición convierte las imágenes íntegramente generadas en casos positivos y las fotografías de cámara admisibles en casos negativos. No establece ninguna prueba para las ediciones locales con IA, el retoque convencional, los pies de foto engañosos ni las fotografías reutilizadas fuera de contexto.
Si su proceso necesita detectar una generación parcial, evalúela como una tarea distinta, con etiquetas propias. Una fotografía real que contiene una zona regenerada no debe pasar de un grupo a otro según la interpretación que mejore el resultado. Del mismo modo, un uso autorizado de la IA no es necesariamente engañoso. Las etiquetas de detección describen un contenido; su política interna y las demás pruebas determinan su alcance. La guía Cómo saber si una imagen está hecha con IA desarrolla estas distinciones para un archivo concreto.
Defina también la unidad de cómputo. Cinco imágenes de un mismo expediente son cinco decisiones sobre imágenes, pero quizá una sola investigación. La exactitud medida imagen a imagen no predice directamente la carga de revisión por expediente cuando una sola imagen señalada obliga a revisar todo el envío.
Exactitud, precisión y sensibilidad: tres palabras que se confunden
En el español de uso común, precisión y exactitud son casi sinónimos. En la evaluación de un clasificador no lo son, y la diferencia cambia por completo el significado de una cifra comercial:
- Exactitud (accuracy): decisiones correctas divididas por el total de imágenes evaluadas.
- Precisión (precision): verdaderos positivos divididos por todas las imágenes señaladas. Responde a «de lo que el detector marca, ¿cuánto es cierto?».
- Sensibilidad o exhaustividad (recall): verdaderos positivos divididos por todos los positivos reales. Responde a «de lo que había que encontrar, ¿cuánto se encontró?».
Cuando un proveedor anuncie «un 99 % de precisión», pregunte cuál de las tres magnitudes mide, sobre qué denominador y en qué umbral. Muchas fichas comerciales en español usan precisión para referirse a la exactitud. Las dos cifras pueden diferir en decenas de puntos porcentuales, como muestra el ejemplo siguiente.
Lea la matriz de confusión antes que la cifra destacada
Una matriz de confusión compara las decisiones del detector con etiquetas establecidas de forma independiente. Tome 10.000 imágenes hipotéticas: 100 generadas y 9900 no generadas. Con un umbral fijo, el detector señala 90 imágenes generadas y 99 no generadas.
| Etiqueta conocida | Señalada | No señalada | Total |
|---|---|---|---|
| Generada | 90 verdaderos positivos (VP) | 10 falsos negativos (FN) | 100 |
| No generada | 99 falsos positivos (FP) | 9801 verdaderos negativos (VN) | 9900 |
| Total | 189 | 9811 | 10.000 |
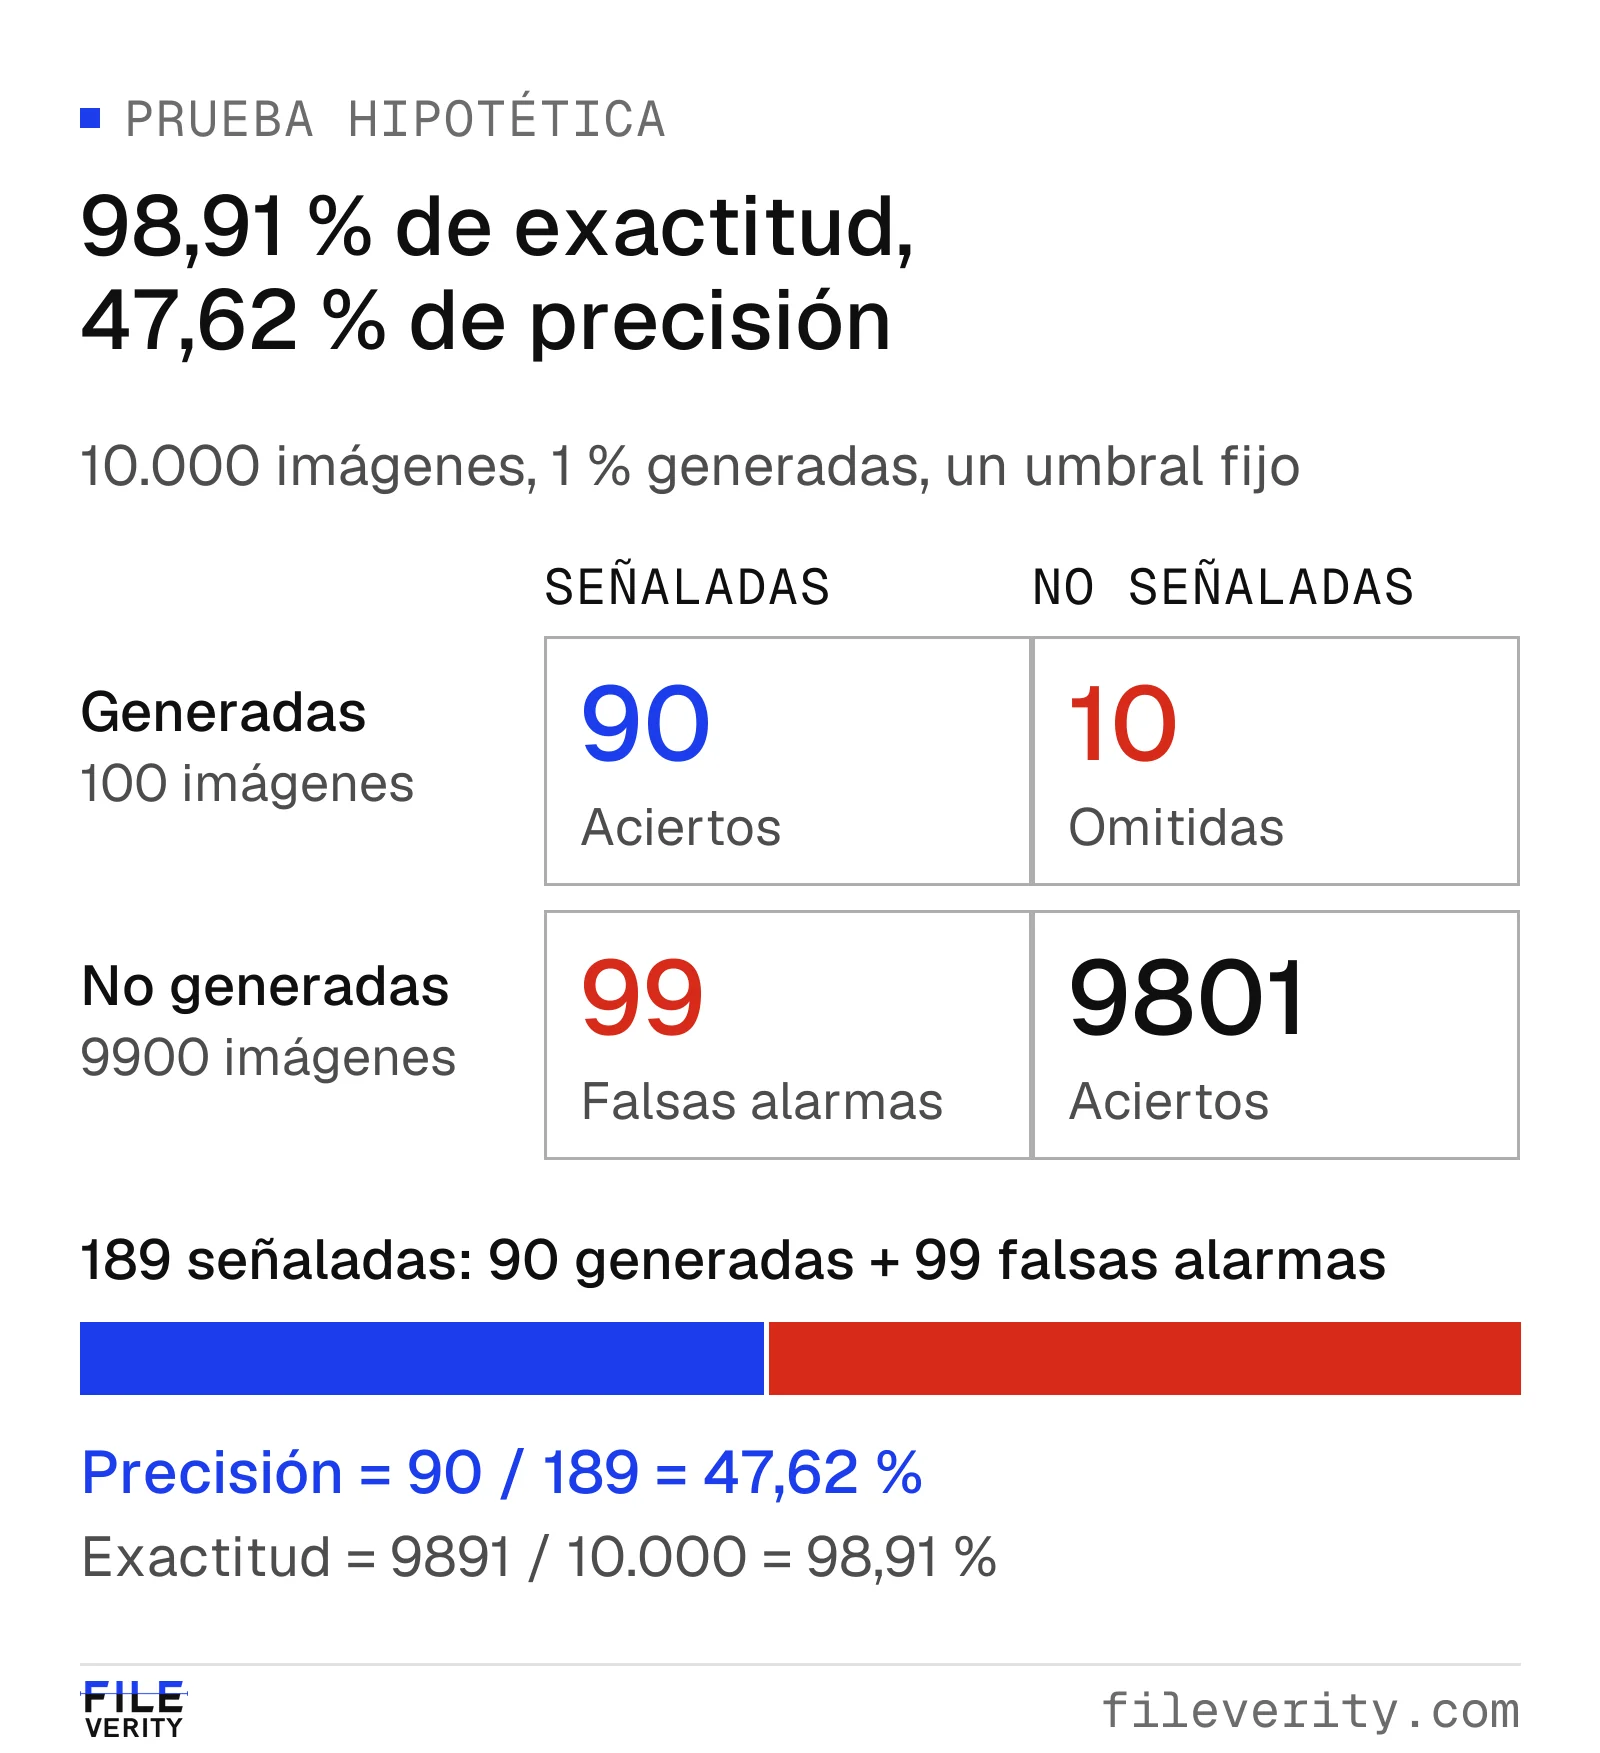
De 189 imágenes señaladas, 90 son aciertos y 99 son falsas alarmas, aunque la exactitud global sea del 98,91 %.
Cada métrica responde a una pregunta distinta:
| Métrica | Cálculo | Resultado | Pregunta que responde |
|---|---|---|---|
| Exactitud | (VP + VN) / todas las imágenes | 98,91 % | ¿Qué parte de las decisiones fue correcta? |
| Sensibilidad o exhaustividad | VP / (VP + FN) | 90 % | ¿Qué parte de las imágenes generadas se encontró? |
| Tasa de falsos negativos | FN / (VP + FN) | 10 % | ¿Qué parte de las imágenes generadas se pasó por alto? |
| Tasa de falsos positivos | FP / (FP + VN) | 1 % | ¿Qué parte de las imágenes no generadas se señaló? |
| Especificidad | VN / (FP + VN) | 99 % | ¿Qué parte de las imágenes no generadas quedó sin señalar? |
| Precisión o valor predictivo positivo (VPP) | VP / (VP + FP) | 47,62 % | ¿Qué parte de las señales fue correcta? |
La precisión se redondea a partir de 90/189. La diferencia entre tasa de falsos positivos y precisión es decisiva: una tasa de falsos positivos del 1 % no significa que solo el 1 % de las imágenes señaladas sean falsas alarmas. Los denominadores son distintos. Aquí, 99/189, es decir, el 52,38 % de las señales, son falsas alarmas. Las definiciones habituales y su relación con la matriz de confusión figuran en la referencia de métricas de clasificación de scikit-learn (en inglés).
Una regla que nunca señalara nada alcanzaría un 99 % de exactitud sobre este mismo conjunto sin encontrar ni una sola imagen generada. No sería un detector útil. El ejemplo muestra por qué comparar detectores solo por su exactitud premia el comportamiento equivocado cuando una de las clases domina.
Calcule el efecto de la prevalencia en la cola de revisión
La prevalencia es la proporción de casos positivos en la población evaluada; en el ejemplo, el 1 %. Si la sensibilidad y la tasa de falsos positivos se mantienen constantes, la precisión esperada sigue esta relación:
VPP = (sensibilidad × prevalencia) / [(sensibilidad × prevalencia) + (tasa de falsos positivos × (1 − prevalencia))]
En proporciones: 0,90 × 0,01 / [(0,90 × 0,01) + (0,01 × 0,99)] = 0,009 / 0,0189 = 47,619… %.
La tabla siguiente usa recuentos esperados: un valor decimal describe una media esperada, no una fracción de imagen observada.
Resultados hipotéticos esperados por cada 10.000 imágenes, con una sensibilidad del 90 % y una tasa de falsos positivos del 1 %.
| Prevalencia hipotética | Señales verdaderas esperadas | Señales falsas esperadas | Precisión esperada |
|---|---|---|---|
| 0,1 % | 9 | 99,9 | 8,26 % |
| 1 % | 90 | 99 | 47,62 % |
| 10 % | 900 | 90 | 90,91 % |
| 50 % | 4500 | 50 | 98,90 % |
Un conjunto de prueba equilibrado puede, por tanto, ofrecer una precisión llamativa que no se traslada a un flujo de entrada en el que las imágenes generadas son escasas. El cálculo supone además que el rendimiento por clase no cambia; en la práctica, otro flujo puede contener imágenes más difíciles, lo que altera la propia sensibilidad y la tasa de falsos positivos.
No estime la prevalencia a partir de la proporción de imágenes señaladas: esa proporción incluye los errores. Utilice una muestra del flujo etiquetada de forma independiente, declare las etiquetas que no se hayan podido resolver y pruebe varios escenarios plausibles si la estimación sigue siendo incierta. Use esos escenarios para dimensionar la capacidad de revisión antes de fijar un umbral.
Elija el umbral según la acción que desencadena
Si una puntuación más alta indica indicios más fuertes de generación, bajar el umbral hace entrar más imágenes en la cola. Sobre el mismo conjunto puntuado, no puede retirar imágenes ya señaladas, de modo que pueden aumentar a la vez las detecciones verdaderas y las falsas alarmas. Subirlo produce el efecto contrario. La precisión no mejora necesariamente en cada escalón: depende de cómo se ordenen las etiquetas reales.
A continuación se compara, sobre la misma población de 10.000 imágenes, el efecto de tres umbrales. No se indican valores de corte reales porque las escalas de puntuación difieren de un sistema a otro.
Comparación hipotética: las mismas 100 imágenes generadas y 9900 no generadas en cada umbral.
| Umbral | Verdaderos positivos | Falsos positivos | Positivos no detectados | Sensibilidad | Tasa de falsos positivos | Precisión | Tamaño de la cola |
|---|---|---|---|---|---|---|---|
| Más bajo | 95 | 297 | 5 | 95 % | 3 % | 24,23 % | 392 |
| Intermedio | 90 | 99 | 10 | 90 % | 1 % | 47,62 % | 189 |
| Más alto | 70 | 20 | 30 | 70 % | 0,202 % | 77,78 % | 90 |
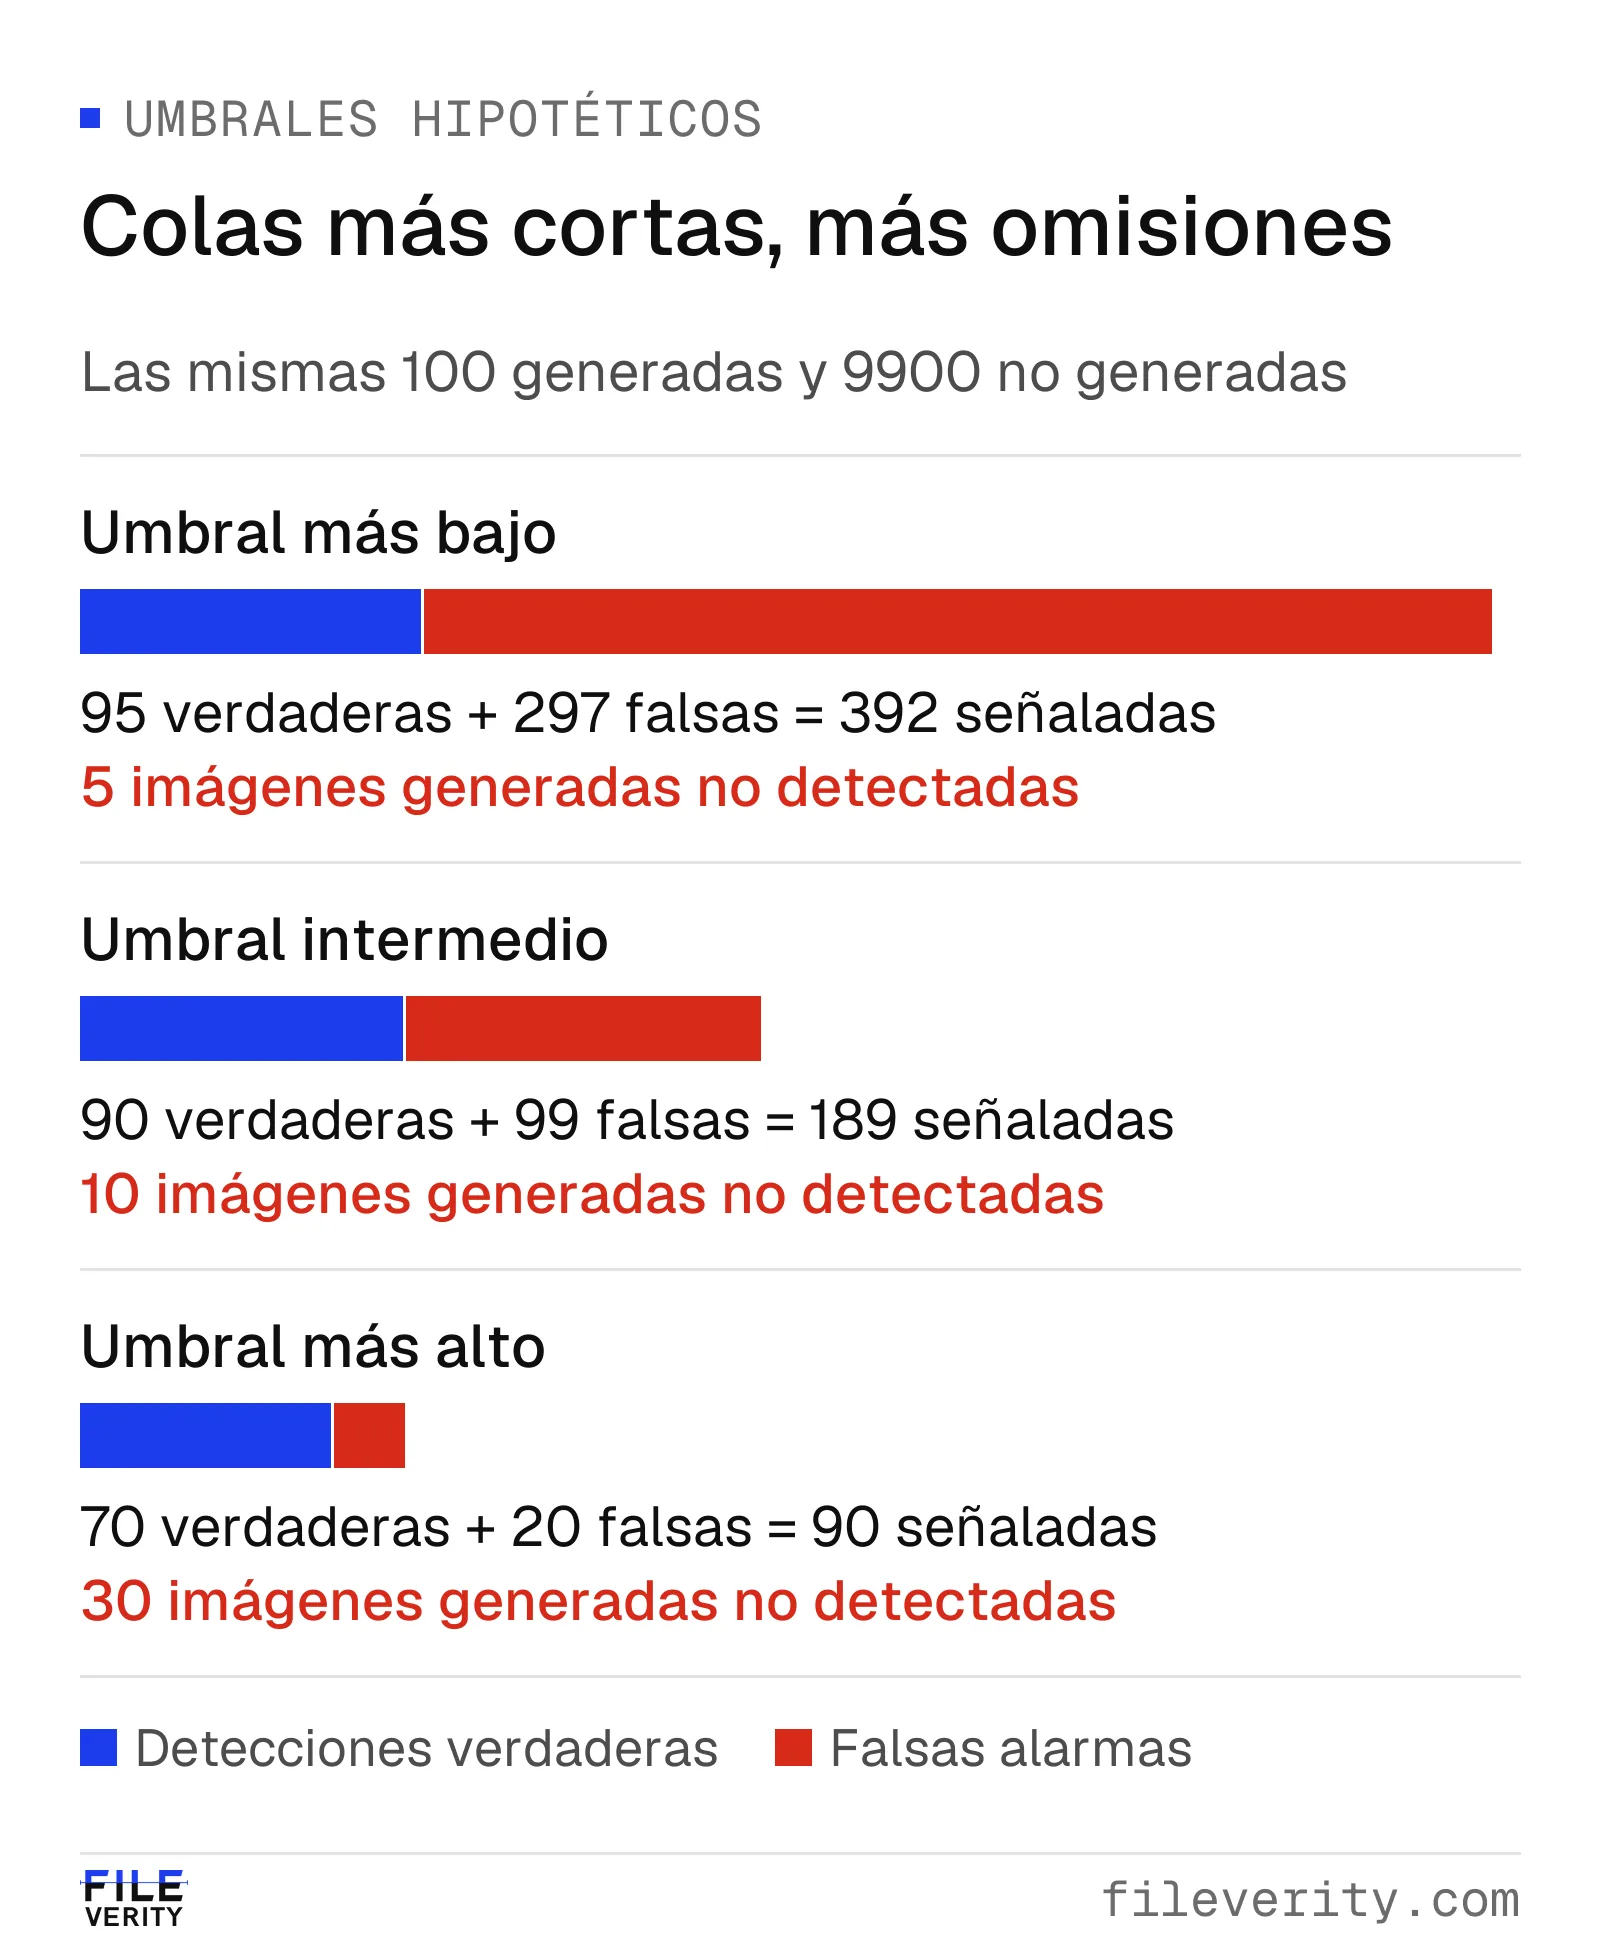
Subir el umbral reduce la cola de 392 a 90 imágenes, pero eleva los positivos no detectados de 5 a 30.
Con un supuesto de seis minutos por imagen señalada, estas colas exigen 39,2, 18,9 y 9 horas de trabajo, respectivamente, antes de cualquier investigación adicional. Elegir la cola más pequeña supone aceptar 30 imágenes no detectadas en lugar de cinco. Ninguna opción es correcta en sí misma: la acción prevista, los revisores disponibles y las consecuencias de cada error determinan qué es aceptable.
Pida el rendimiento en el punto de funcionamiento que va a utilizar. Una curva ROC resume la sensibilidad frente a la tasa de falsos positivos en todos los umbrales; el área bajo la curva no le dice qué sensibilidad obtendrá con su límite de falsas alarmas. El NIST señala que, como un falso positivo puede causar daños graves, algunos estudios prefieren publicar la tasa de verdaderos positivos alcanzada cuando el corte limita los falsos positivos a una probabilidad baja fijada de antemano (TPR@FPR). NIST AI 100-4, apartado 4.2.2 (en inglés)
Distinga la puntuación de confianza de la calibración
Una puntuación de 90 puede ser una señal de ordenación, una salida transformada del modelo o una estimación de probabilidad. No equivale automáticamente a un 90 % de probabilidad de generación ni significa que se hayan editado el 90 % de los píxeles. Obtenga la definición de la puntuación antes de atribuirle un significado.
La calibración pregunta si las probabilidades estimadas coinciden con las frecuencias observadas en casos comparables. La discriminación pregunta si las puntuaciones separan bien las categorías objetivo. Ambas importan y ninguna sustituye a la otra. El ejemplo siguiente muestra cómo examinar una afirmación de probabilidad antes de incorporarla a una política de revisión.
La puntuación en detalle: contraste la calibración con lo observado
Fileverity calibra la puntuación de sus resultados de imagen para que un mismo valor tenga el mismo significado entre imágenes comparables. Para comprobar una afirmación de este tipo, la nuestra o la de cualquier proveedor, use un diagrama de fiabilidad: agrupe las predicciones por intervalos de probabilidad y compare, en cada grupo, la predicción media con la frecuencia observada de positivos.
Para un grupo B, calcule p̄_B = Σp_i/n_B y r_B = Σy_i/n_B, donde p_i es la probabilidad predicha, y_i vale 1 para un positivo establecido de forma independiente y 0 en caso contrario, y n_B es el tamaño del grupo. La concordancia perfecta en ese grupo significa p̄_B = r_B; no significa que cada predicción individual sea segura. Guo y sus coautores estudian la calibración de las redes neuronales modernas y los diagramas de fiabilidad. Guo et al., ICML 2017 (en inglés)
Considere esta evaluación binaria ilustrativa de un sistema mal calibrado (datos hipotéticos; no son resultados de Fileverity):
| Intervalo de probabilidad | Imágenes | Predicción media | Positivos conocidos | Frecuencia positiva observada | Diferencia absoluta |
|---|---|---|---|---|---|
| 0,0 a <0,4 | 100 | 0,20 | 10 | 0,10 | 0,10 |
| 0,4 a <0,7 | 100 | 0,50 | 40 | 0,40 | 0,10 |
| 0,7 a 1,0 | 100 | 0,80 | 60 | 0,60 | 0,20 |
La diferencia absoluta ponderada por el tamaño de cada grupo es Σ(n_B/N) × |p̄_B − r_B|. Aquí vale (0,10 + 0,10 + 0,20) / 3 = 0,1333, unos 13,3 puntos porcentuales. La cifra describe el desacuerdo en estos grupos; no es una tasa de error de clasificación ni afirma que cada puntuación se equivoque en 13,3 puntos. Otra división en intervalos puede ocultar o revelar otras discrepancias, así que conserve los recuentos y el diagrama junto al resumen.
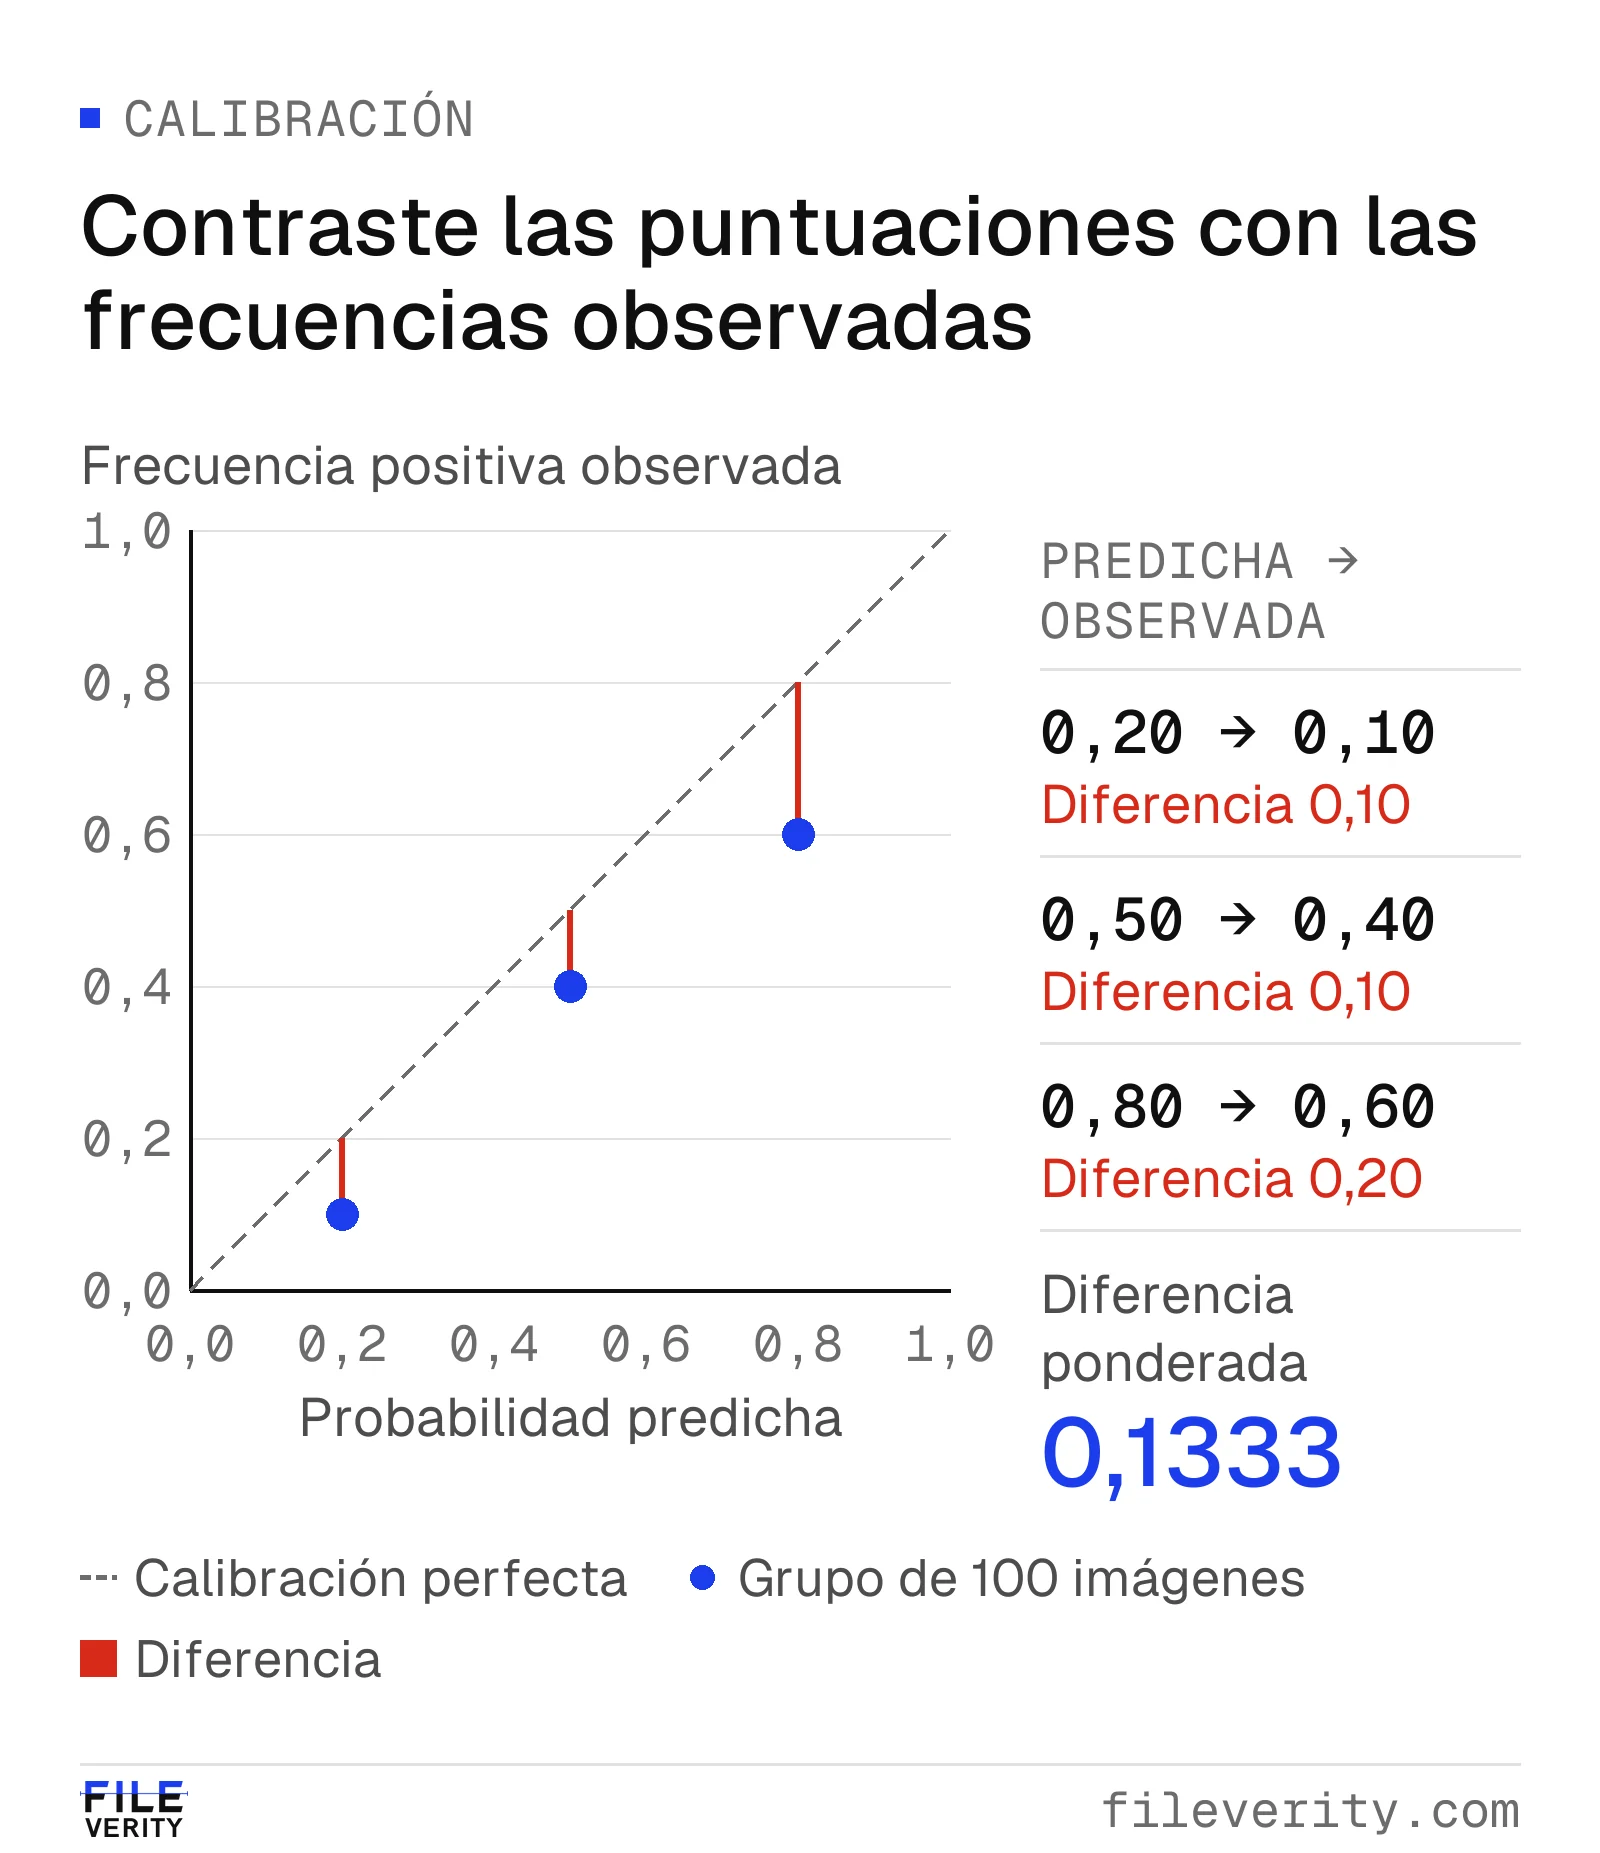
Datos ilustrativos, 100 imágenes por grupo: las predicciones superan las frecuencias observadas en 10, 10 y 20 puntos porcentuales.
¿Por qué puede mejorar la calibración sin que mejore la discriminación? Una transformación estrictamente creciente de las puntuaciones conserva el orden de cada par, de modo que una métrica de ordenación como el área bajo la curva ROC no cambia, mientras que las probabilidades pueden acercarse a las frecuencias observadas. El valor numérico del corte asociado a las mismas decisiones sí puede cambiar. Pida, por tanto, pruebas sobre los errores en el punto de funcionamiento y sobre la interpretación probabilística.
La calibración depende también de la población evaluada. Ovadia y sus coautores muestran que la calibración puede degradarse cuando los datos cambian respecto a los de entrenamiento, y que la calibración a posteriori convencional no basta en esas condiciones. Ovadia et al., NeurIPS 2019 (en inglés) Ajuste cualquier correspondencia de calibración con datos distintos de la muestra de aceptación final y examine por separado cada canal de entrada relevante. En un piloto con Fileverity, incluya sus propios canales en esa comprobación.
Mantenga en el denominador los archivos inciertos y no admitidos
Un detector puede abstenerse, rechazar un formato no admitido, agotar el tiempo de espera o devolver un aviso de calidad insuficiente. Estos resultados deben contarse aparte. Excluirlos puede hacer que un sistema parezca fiable precisamente porque sus casos más difíciles han desaparecido del cálculo.
Considere otro lote hipotético: 1000 envíos, de los que 850 reciben una clasificación utilizable, 100 un resultado incierto y 50 fallan en el procesamiento. La cobertura de clasificación es 850/1000 = 85 %. Si 833 clasificaciones son correctas, la exactitud entre los archivos clasificados es 833/850 = 98 %. Sobre el total de envíos, el 83,3 % recibió una clasificación correcta: es una cifra descriptiva que tiene en cuenta la cobertura, no una exactitud binaria en sentido estricto. Los 150 restantes quedan sin resolver; no son automáticamente erróneos ni negativos.
Publique la exactitud y la cobertura juntas, y desglose la cobertura por etiqueta conocida y por canal de entrada: un sistema puede abstenerse con más frecuencia en los casos positivos. Indique la sensibilidad global con un tratamiento explícito de las abstenciones, junto a la sensibilidad limitada a los casos clasificados, para que se vea qué excluye cada denominador. Prevea una vía alternativa para los archivos sin resolver e inclúyala en la estimación de carga. Las capturas de pantalla y las fotos recomprimidas son una fuente habitual de estos casos; la guía sobre capturas de pantalla y fotos comprimidas explica qué archivo conviene pedir.
En Fileverity, este principio se refleja en los resultados posibles: cuando las pruebas no bastan, el análisis devuelve «Sin determinar» en lugar de forzar una respuesta, y el nivel de riesgo L0 recomienda solicitar el archivo original y volver a comprobarlo. La puntuación de autenticidad, de 0 a 100 y en múltiplos de 5, es más baja cuando el archivo limita las conclusiones posibles, por ejemplo tras una recompresión intensa. La página Cómo funciona describe los seis niveles, de L0 a L5, y la acción asociada a cada uno.
Construya un conjunto reservado representativo e intacto
Una evaluación necesita etiquetas defendibles y un plan de muestreo. Use material autorizado con un origen documentado: ejemplos generados en condiciones controladas, originales de cámara con un historial de captura conocido y, cuando proceda, ediciones etiquetadas por separado. La opinión de otro detector no es una verdad de referencia. Mantenga las etiquetas discutidas como no resueltas y documente la regla de arbitraje.
Reproduzca los archivos tal como los recibe, no solo originales impecables. Incluya los canales, tamaños de imagen, categorías de contenido y manipulaciones habituales que encuentra su proceso. Al dividir los datos, mantenga juntas las variantes de una misma imagen de origen; de lo contrario, la misma escena puede acabar a la vez en los datos de ajuste y en los de evaluación. Si es posible, separe también las sesiones de captura y las colecciones de origen.
Use un conjunto de desarrollo para elegir los umbrales y un conjunto reservado distinto para comprobar una sola vez la política elegida. Si un resultado fallido en el conjunto reservado le lleva a introducir cambios, trátelo como prueba de desarrollo y obtenga un conjunto nuevo e intacto para la política revisada. En servicios propietarios, pregunte por los solapamientos conocidos con conjuntos de prueba públicos y deje constancia de lo que no puede comprobarse sobre los datos de entrenamiento.
Añada, como complemento, un conjunto de casos deliberadamente difíciles. Preséntelo separado de la muestra representativa para que la sobrerrepresentación de casos inusuales no se confunda con la prevalencia normal del flujo. La investigación sobre detección de imágenes generadas contrasta la generalización entre generadores precisamente porque el éxito con una fuente no demuestra una cobertura universal. Wang et al., «CNN-generated images are surprisingly easy to spot… for now», CVPR 2020 (en inglés)
Fije los criterios de aceptación antes de ver los resultados
Redacte un registro de evaluación que vincule cada métrica con la decisión que debe respaldar.
Ejemplo de criterios de aceptación para un proceso que deriva imágenes a revisión humana.
| Elemento | Criterio o registro de ejemplo |
|---|---|
| Uso previsto | Derivar imágenes a revisión humana; ninguna decisión desfavorable automática |
| Configuración congelada | Versión del servicio, umbral, definición de la puntuación y preprocesamiento registrados |
| Falsas alarmas | Límite superior unilateral al 95 % de la tasa de falsos positivos no superior al 1 % |
| Detección | Límite inferior unilateral al 95 % de la sensibilidad no inferior al 85 % |
| Cobertura | Al menos el 95 % clasificado; cada archivo sin resolver tiene una vía alternativa |
| Capacidad | La carga total de revisión y de vía alternativa cabe en una plantilla diaria fijada de antemano |
| Subgrupos | Los canales críticos se informan por separado; las pruebas insuficientes quedan sin resolver |
| Responsable | Un revisor identificado registra la aceptación, el rechazo o un piloto limitado |
La primera fila no es solo una buena práctica. Si el resultado afecta a personas físicas, tenga presente que, a 28 de octubre de 2026, el RGPD reconoce a todo interesado el «derecho a no ser objeto de una decisión basada únicamente en el tratamiento automatizado» que produzca efectos jurídicos en él o le afecte significativamente de modo similar, con las excepciones que el propio artículo establece. RGPD, art. 22.1 (copia del BOE) La aplicación concreta a su proceso corresponde a su delegado de protección de datos o a su asesoría jurídica.
Los límites de confianza evitan que una muestra pequeña y sin errores se tome por una certeza. Con cero falsos positivos entre 300 casos negativos independientes, el límite superior binomial exacto unilateral al 95 % es 1 − 0,05^(1/300), aproximadamente el 0,994 %. Con cero entre 100, es aproximadamente el 2,951 %.
La deducción es breve: si la probabilidad de falso positivo es p, la probabilidad de no observar ninguno en n casos negativos independientes es (1 − p)^n; al igualarla a 0,05 se obtiene el límite superior p = 1 − 0,05^(1/n). Cero errores observados no demuestran, por tanto, una tasa de error nula. Estos cálculos suponen casos independientes y representativos: muchas fotografías casi idénticas no aportan la misma información que envíos independientes.
En el ejemplo del umbral intermedio, la tasa de falsos positivos observada del 1 % no cumpliría un requisito de límite superior no superior al 1 %. Una estimación puntual y un límite de incertidumbre responden a preguntas distintas. Dimensione la muestra en función de la prueba exigida antes de reunir el conjunto de evaluación.
Vigile la deriva y formule las conclusiones con cuidado
Tras la puesta en marcha, siga la tasa de señales, la tasa de archivos sin resolver, la mezcla de canales, el tiempo de revisión y los resultados confirmados de forma independiente. Un aumento de la tasa de señales no permite, por sí solo, distinguir entre más imágenes generadas y más falsas alarmas. Muestree también casos no señalados: revisar solo las señales deja casi invisibles los positivos no detectados. Tenga en cuenta las probabilidades de muestreo cuando estime métricas de todo el flujo a partir de grupos deliberadamente sobrerrepresentados.
Registre los cambios de modelo, de umbral y de proceso de entrada. Vuelva a evaluar después de cualquier cambio relevante y mantenga controles periódicos con casos etiquetados aunque las medias del cuadro de mando parezcan estables. Un generador nuevo, un canal de envío distinto o una nueva categoría de contenido pueden cambiar el rendimiento sin una alerta global evidente.
En el registro de cada expediente, separe la observación de la decisión. «La imagen superó el umbral de revisión» es una observación. «Esto respalda una sospecha de generación» es una inferencia. Un original verificado o un historial de creación documentado aportan corroboración. Solicitar ese material es una acción. Ninguna de estas afirmaciones, por sí sola, establece un fraude ni la veracidad de la escena representada.
Cómo expresa Fileverity sus resultados
Los informes de imagen de Fileverity no se resumen en una cifra global de exactitud: cada informe expone las pruebas en que se basa cada hallazgo y su solidez, porque una cifra sin muestra, versión, umbral ni fecha no permite decidir. Para su flujo, su equipo puede repasar con el nuestro casos reales de su propio proceso y medir la detección con sus archivos en el punto de funcionamiento que defina. El informe expresa los resultados con una de cuatro evaluaciones («Sin indicios de generación por IA ni de edición», «Foto con alteraciones locales», «Generada por IA» y «Sin determinar»), un nivel de riesgo de L0 a L5 con una acción recomendada y una puntuación de autenticidad de 0 a 100. La puntuación de un detector tampoco sustituye a las comprobaciones de procedencia: unas Credenciales de contenido validadas o una marca de agua reconocida son pruebas de otra naturaleza, como explica la guía C2PA, marcas de agua de IA o detector de imágenes.
Para documentos, las tasas medidas del detector FVDOC V3 se publican por idioma, con sus límites, en la página Precisión y falsos positivos. Esas cifras se refieren a texto, no a imágenes, y no deben trasladarse a la detección de imágenes.
Convierta una cifra de precisión en una petición de pruebas
Pida información suficiente para vincular el resultado anunciado con su flujo de entrada y con su siguiente acción. Puede copiar este texto en una conversación con un proveedor:
Necesitamos evaluar [generación de la imagen completa / alteración local / otra tarea definida] en [formatos de archivo, canales y condiciones de calidad]. El resultado desencadenará [acción de revisión], con un volumen aproximado de [imágenes y expedientes diarios]. Nuestra capacidad de revisión es de [horas de trabajo o expedientes al día].
Les rogamos que indiquen la versión del producto evaluada y la definición de la puntuación; el origen de las etiquetas y el número de positivos y negativos; los cuatro recuentos de la matriz de confusión en el punto de funcionamiento propuesto; las estimaciones de incertidumbre; y, por separado, el número de entradas no concluyentes, no admitidas y fallidas. Indiquen qué archivos se excluyen de cada métrica, cómo cambian la cobertura y la sensibilidad cuando se incluyen y si hay imágenes de un mismo origen tanto en los datos de ajuste como en los de evaluación.
Señalen qué pruebas son aplicables a este uso, qué condiciones no se han probado y qué debería establecer un piloto.
Las entidades financieras y aseguradoras suelen tramitar esta petición dentro de una revisión de riesgo de modelos o de contratación de proveedores tecnológicos. La guía Cómo elegir un software de detección de imágenes generadas con IA para su empresa añade los requisitos del RGPD y de DORA, el diseño del piloto y la comparación del coste de revisión.
Siguientes pasos con Fileverity
Fileverity está diseñado para revisar imágenes desde tres ángulos: generación por IA, manipulación y procedencia. Para probar una imagen concreta, el análisis de imágenes incluye una comprobación gratuita por cuenta, y un crédito de imagen desbloquea el informe completo. Para evaluar el servicio con su propio flujo, hable con ventas y proponga un piloto con sus archivos: adjunte la petición de pruebas anterior y pida el alcance y las pruebas que respaldan su punto de funcionamiento.
Por Yang Zheng · Revisado por Bill Liu