Nuevo modelo
Veread 1.1: menos falsos positivos y pasajes mejor marcados
Veread 1.1 detecta el 98,6 % del texto escrito íntegramente con IA, con un 0,28 % de falsos positivos, y el 92,2 % de los documentos mixtos.
Publicado · 8 min de lectura
Datos clave
- Versión
- Veread 1.1
- Publicación
- 18 de noviembre de 2026
- Falsos positivos en escritura humana
- 0,28 % (desde el 0,45 %)
- Texto escrito íntegramente con IA detectado
- 98,6 %
- Documentos mixtos de escritura humana y de IA detectados
- 92,2 % (desde el 87,3 %)
- Textos de modelos de IA no vistos detectados
- 94,9 %
Veread 1.1, disponible desde el 18 de noviembre de 2026, detecta el 98,6 % del texto escrito íntegramente con IA y marca por error solo el 0,28 % de la escritura humana, frente al 0,45 % de Veread 1.0. Los resultados se midieron con datos reservados en siete idiomas. Además, detecta el 92,2 % de los documentos que combinan escritura humana y de IA (frente al 87,3 %) y señala los pasajes escritos con IA con una precisión del 97,2 %.
Veread es el modelo propio de Fileverity para detectar texto escrito con IA, y todas las comprobaciones de texto y de documentos de Fileverity se ejecutan ya con la versión 1.1.
Novedades de Veread 1.1
- Entrenamiento centrado en inglés, español y francés. Los siete idiomas siguen en un único modelo: español, inglés, francés, alemán, chino, vietnamita y árabe.
- Escritura humana mucho más variada. Ensayos y trabajos de estudiantes, artículos académicos completos, cartas y reclamaciones, reseñas de películas y de productos, debates de foros, narrativa y prosa literaria, textos jurídicos y administrativos, noticias y artículos enciclopédicos.
- Casos difíciles de escritura humana, incluidos a propósito. Los textos humanos formales, de estructura fija o muy pulidos, justo los que los detectores confunden con más frecuencia con IA, son ahora una parte central del entrenamiento.
- La escritura de IA más reciente de nueve familias de modelos: OpenAI, Anthropic, Google, DeepSeek, Alibaba, Meta, Mistral, xAI y Zhipu. Incluye textos de IA parafraseados o «humanizados» para esquivar la detección y reescrituras con IA de textos humanos.
- Etiquetas por frase. Cada frase escrita con IA en un documento mixto está etiquetada, de modo que el modelo aprende dónde termina la escritura humana y dónde empieza la de IA.
- Texto de entrenamiento más limpio. Se eliminaron, solo por supresión, firmas de autor, créditos, avisos de cookies y de suscripción, marcado, llamadas de nota al pie y contadores de palabras. La redacción nunca se altera, así que Veread juzga lo escrito y no el formato.
- Control de duplicados exactos y casi idénticos entre el entrenamiento y la evaluación.
- Nuevos umbrales de decisión, calibrados con escritura humana reservada. El marcado de pasajes y el parecido de estilo con una familia de modelos, que ahora aparece más a menudo y acierta más veces, se recalibraron para el nuevo modelo.
Resultados: Veread 1.1 frente a Veread 1.0
Ambas versiones pasaron por la misma evaluación: textos reservados de unas 100 palabras o más en siete idiomas.
| Medida | Veread 1.0 | Veread 1.1 |
|---|---|---|
| Escritura humana marcada por error como IA | 0,45 % | 0,28 % |
| Texto escrito íntegramente con IA detectado | 98,3 % | 98,6 % |
| Texto escrito o asistido con IA de cualquier tipo detectado | 95,4 % | 95,9 % |
| Textos que empezó una persona y continuó la IA, detectados | 91,7 % | 94,3 % |
| Documentos que combinan escritura humana y de IA detectados | 87,3 % | 92,2 % |
| Extractos breves de unas 100 palabras detectados | 92,9 % | 94,1 % |
| Documentos completos escritos o asistidos con IA detectados | 96,6 % | 96,8 % |
| Textos reescritos con IA detectados | 92,5 % | 92,8 % |
| F1 del marcado de pasajes | 90,3 | 92,9 |
| AUROC, extractos breves | 0,995 | 0,996 |
Veread 1.1 detecta también el 100 % de los pasajes de IA insertados en un texto humano, el 97,6 % de los textos pulidos con IA y el 94,9 % de los textos de modelos de IA que nunca se usaron en el desarrollo. El AUROC en documentos completos es 0,999.
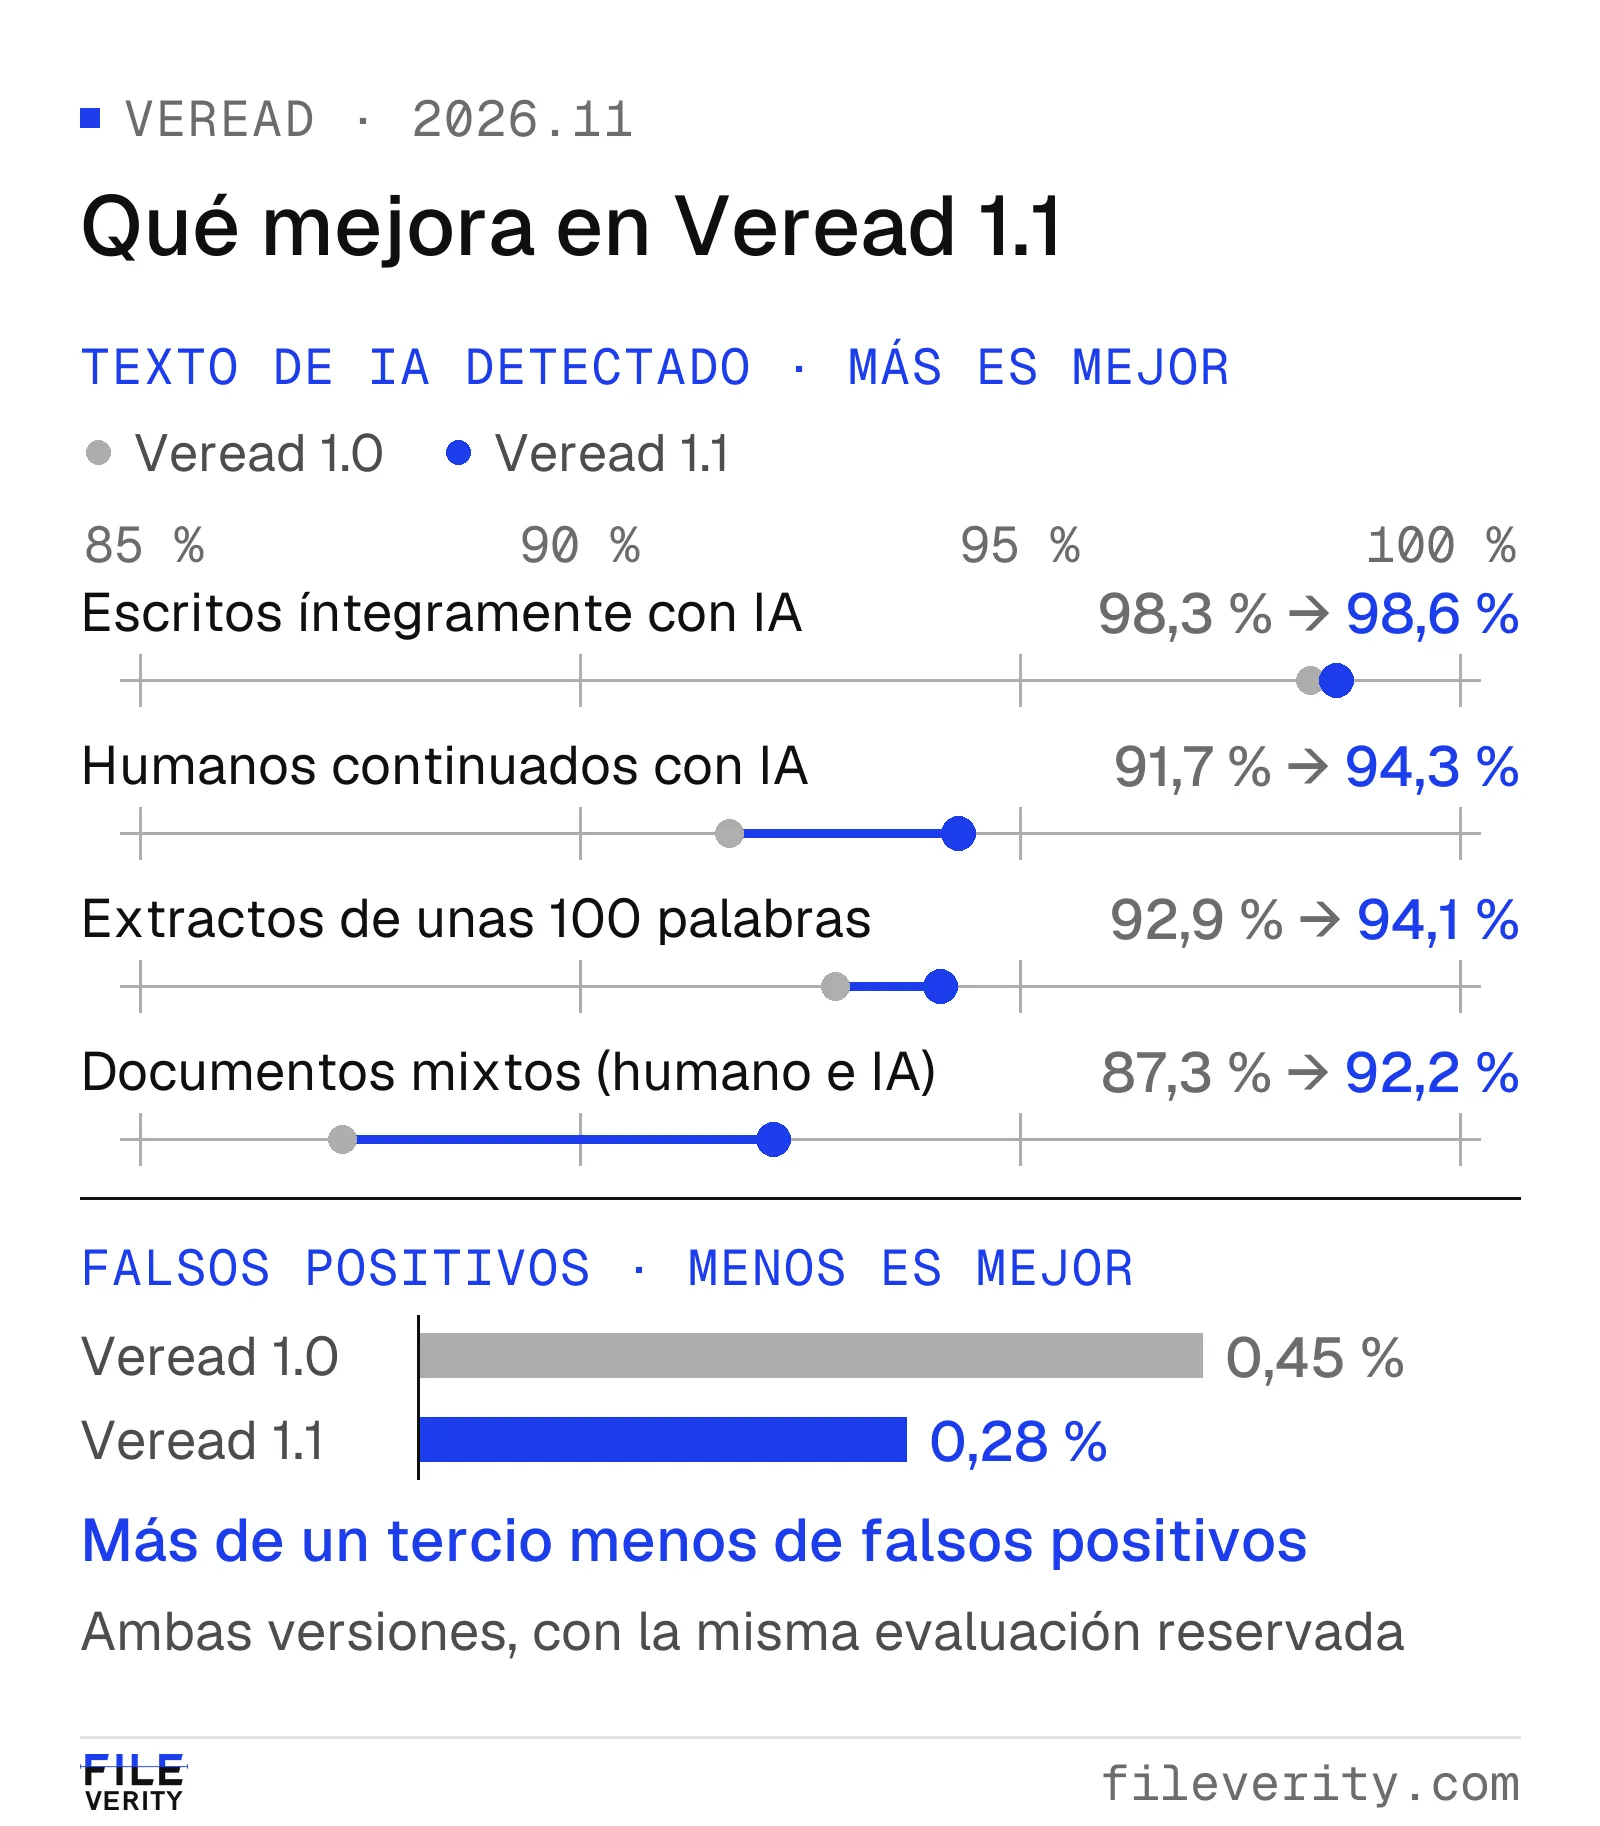
Los falsos positivos bajan en más de un tercio y la detección sube en todas las medidas principales.
Las medidas, en palabras sencillas
- Tasa de falsos positivos: proporción de textos escritos por personas que reciben un hallazgo de IA. Cuanto menor, mejor.
- Tasa de detección: proporción de textos escritos o asistidos con IA que Veread identifica. Cuanto mayor, mejor.
- Asistido con IA: un texto cuenta solo cuando la IA modificó de verdad la redacción, ya sea porque lo continuó, lo reescribió, lo pulió o insertó pasajes en un texto humano.
- AUROC: con qué nitidez las puntuaciones de Veread separan la escritura humana de la de IA, sea cual sea el punto de decisión que se elija. Una puntuación de 1 es una separación perfecta.
- F1 del marcado de pasajes: una sola puntuación que combina cuántos pasajes escritos con IA encuentra Veread y cuántos de los pasajes que marca están realmente escritos con IA.
- Precisión de los pasajes marcados: proporción del texto marcado que está realmente escrito con IA.
Menos falsos positivos en la escritura humana
Un falso positivo es el trabajo de una persona señalado como escrito por una máquina. Para un profesor, una oficina de admisiones o un editor, es la cifra que decide si un detector puede usarse con el trabajo de personas reales.
Veread 1.1 marca el 0,28 % de la escritura humana: más de un tercio menos de falsos positivos que Veread 1.0. La cifra abarca toda la escritura humana reservada, incluidos paneles independientes de textos humanos de fuentes que nunca se usaron en el entrenamiento. En documentos completos, la tasa es del 0,23 %.
Todos los idiomas quedan por debajo del 0,5 %. El inglés pasó del 0,43 % al 0,18 %, el español del 0,77 % al 0,41 % y el francés del 0,76 % al 0,45 %; la lista completa está en la tabla por idiomas. Todos los tipos de texto quedan por debajo del 1 %. La literatura y la prosa literaria pasaron del 0,62 % al 0,08 %, las reseñas y los foros del 0,84 % al 0,38 %, la escritura de estudiantes y de personas que aprenden un idioma del 0,51 % al 0,30 %, y los textos académicos y científicos del 1,08 % al 0,77 %.
Marcado de pasajes más preciso en documentos mixtos
Los envíos reales rara vez son pura salida de máquina. Veread 1.1 aprende con etiquetas por frase, y por eso detecta el 92,2 % de los documentos que combinan escritura humana y de IA (frente al 87,3 %), marca los pasajes con una precisión del 97,2 % y alcanza un F1 de marcado de pasajes de 92,9 (frente a 90,3). Estos resultados se midieron de extremo a extremo con el motor de producción.
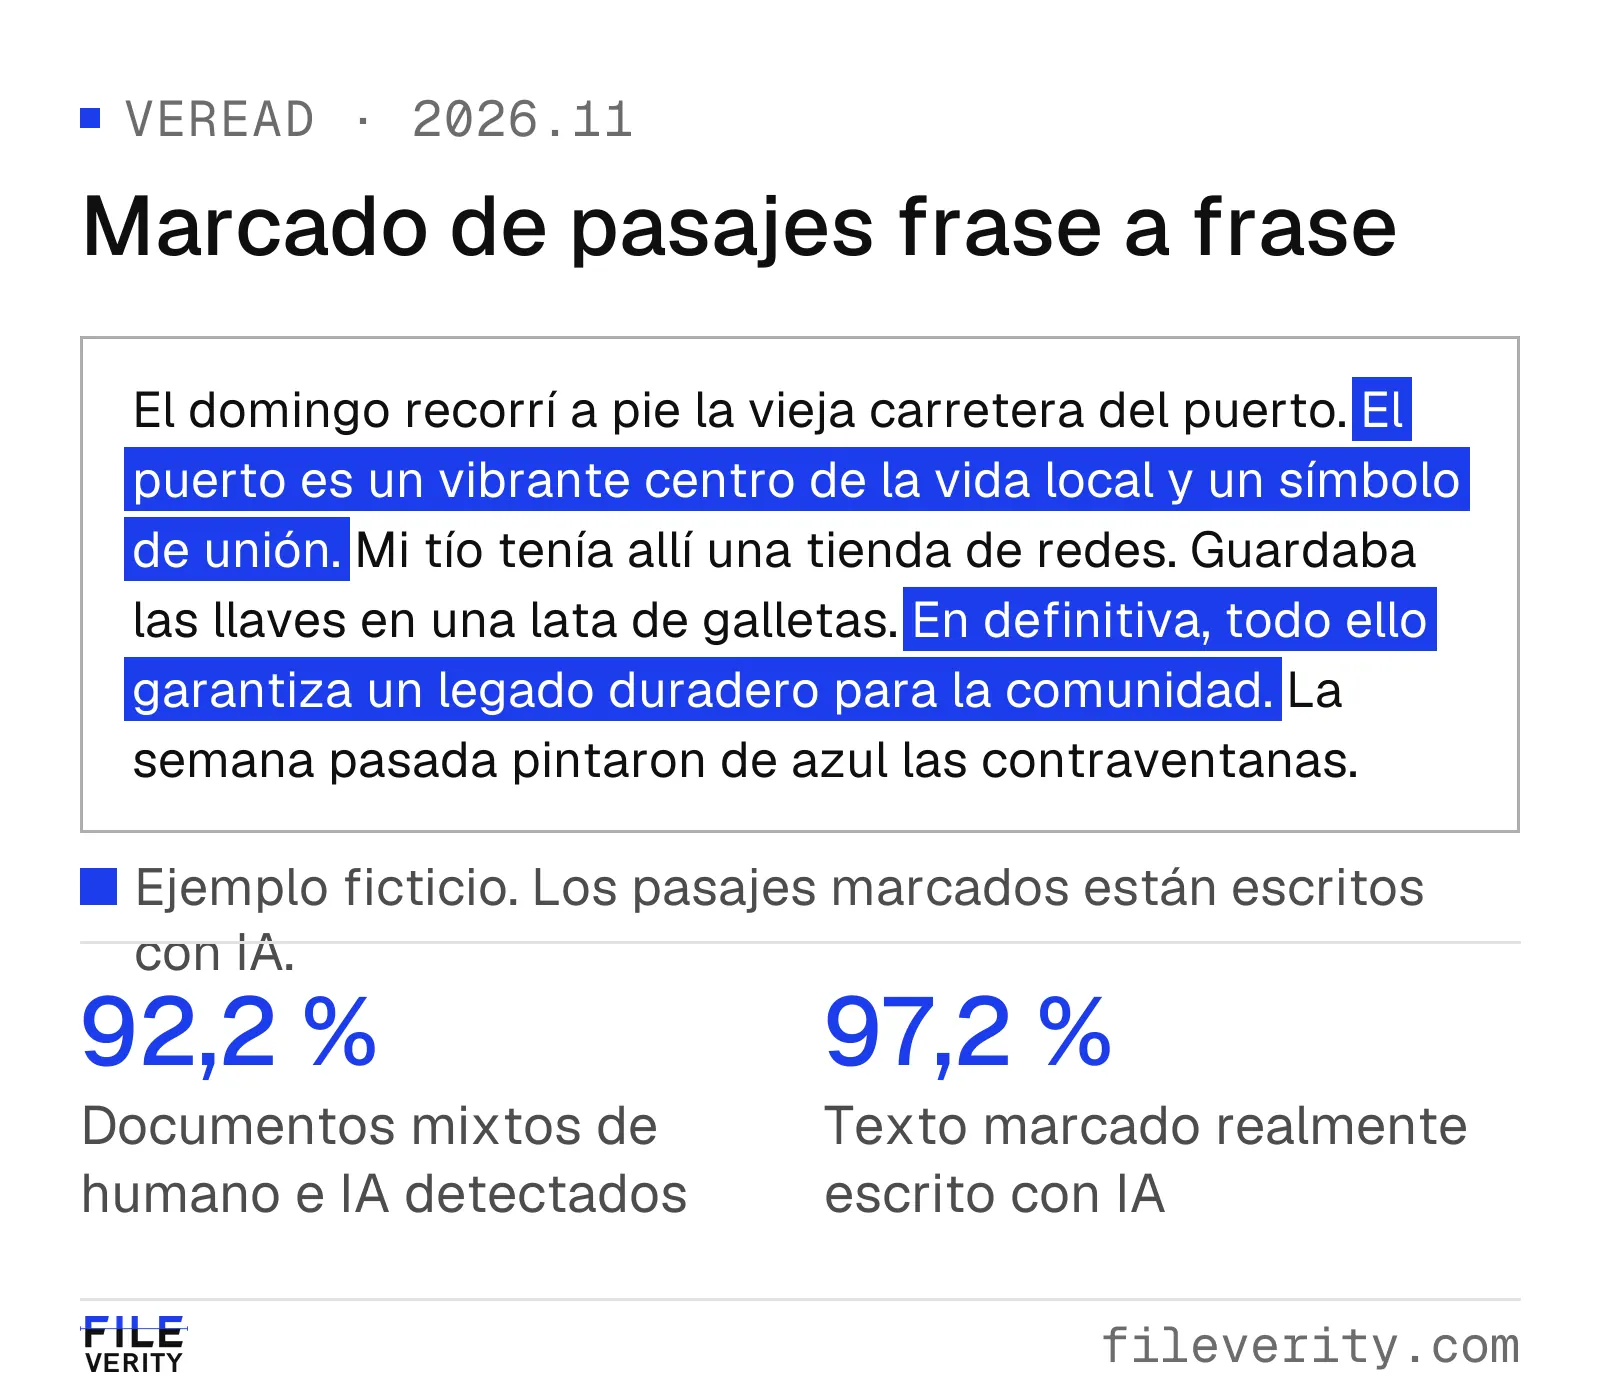
Ejemplo ficticio. Veread 1.1 marca las frases escritas con IA dentro de un documento que también contiene escritura humana.
Resultados sólidos en los siete idiomas
Un solo modelo atiende los siete idiomas, y cada uno se mide por separado.
| Idioma | Escritura humana marcada por error | Texto escrito o asistido con IA detectado | Texto escrito íntegramente con IA detectado |
|---|---|---|---|
| Inglés | 0,18 % | 94,5 % | 95,1 % |
| Francés | 0,45 % | 96,8 % | 99,1 % |
| Alemán | 0,27 % | 94,1 % | 100 % |
| Español | 0,41 % | 96,0 % | 100 % |
| Chino | 0,03 % | 98,8 % | 100 % |
| Vietnamita | 0,48 % | 92,8 % | 95,5 % |
| Árabe | 0,13 % | 97,5 % | 98,5 % |
La detección de texto escrito o asistido con IA subió en inglés (desde el 93,3 %), alemán (desde el 93,2 %), vietnamita (desde el 90,7 %) y árabe (desde el 97,2 %). El texto en alemán escrito íntegramente con IA pasó del 99,1 % al 100 %.
Por familia de modelos, el texto escrito íntegramente con IA de OpenAI, Alibaba, Mistral, xAI y Meta se detecta en un 100 % (Meta, desde el 96,8 %), el de DeepSeek en un 96,3 % (desde el 95,1 %) y el de Google en un 95,9 % (desde el 93,9 %).
Por tipo de texto, el texto académico y científico y el de cartas, correos y reclamaciones escritos o asistidos con IA se detectan en un 100 %, y la escritura de estudiantes y de personas que aprenden un idioma en un 99,1 % (desde el 98,1 %).
Cómo evaluamos Veread
La confianza en un detector depende de cómo se evalúa. Veread se desarrolla y se valida con datos masivos, exclusivos, propios y seleccionados por especialistas, y cada resultado de esta publicación procede de la evaluación que se describe a continuación.
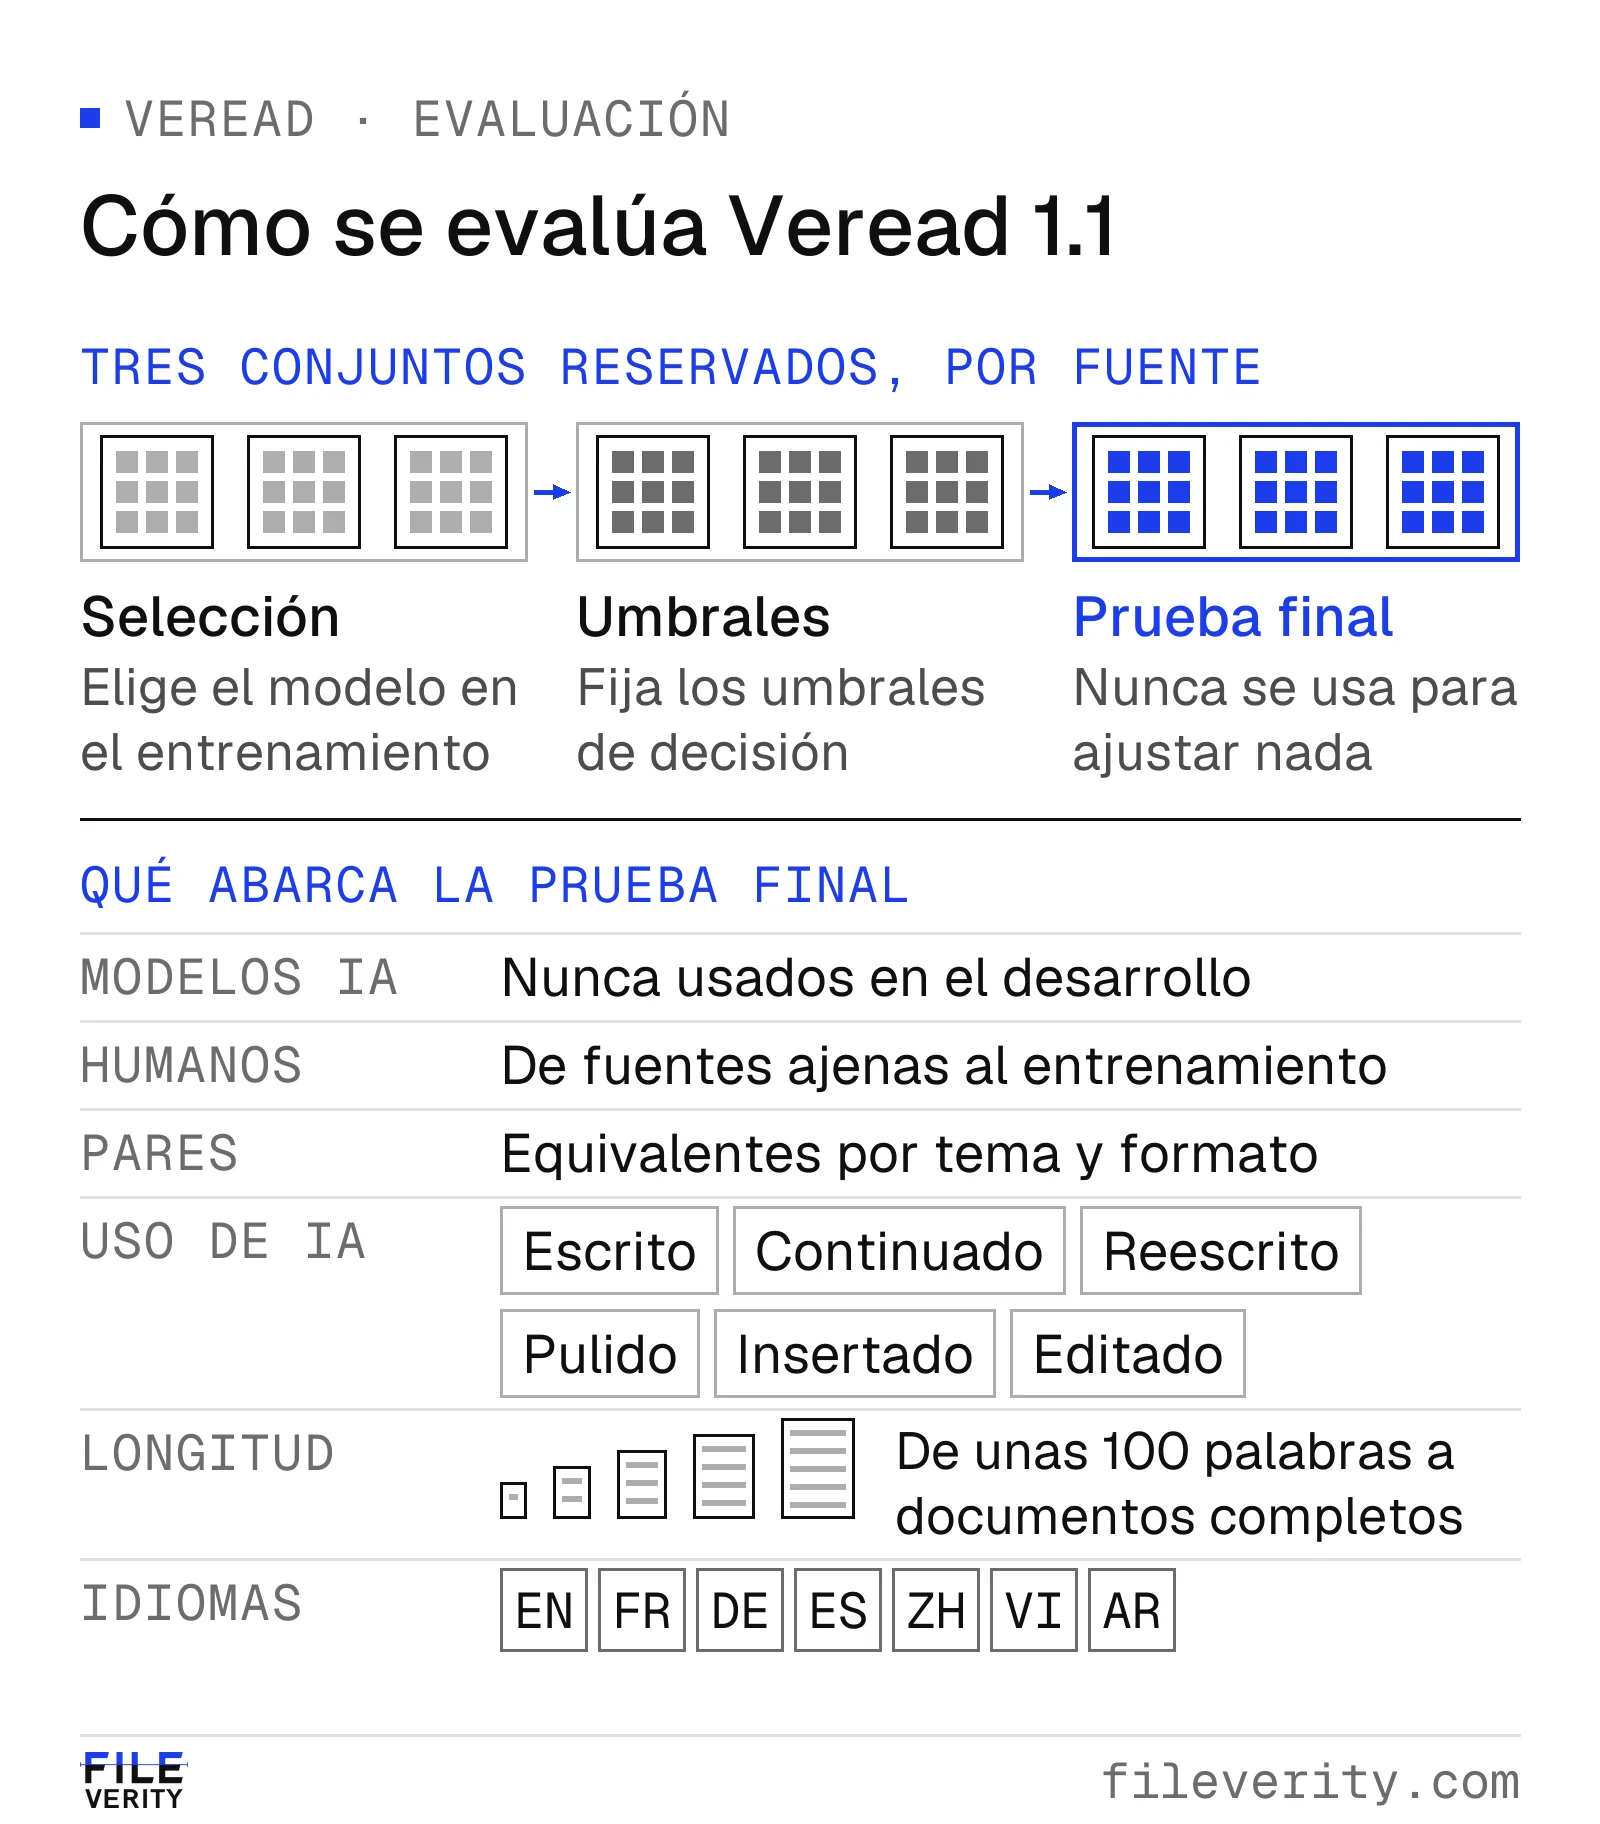
La evaluación separa la elección del modelo, el ajuste de los umbrales y la prueba final, y mide el mismo motor que usan los clientes.
- Tres conjuntos reservados, cada uno con su función. Uno sirve para elegir el modelo durante el entrenamiento, otro para fijar los umbrales de decisión y el tercero es la prueba final. El conjunto de la prueba final no se usa nunca para ajustar nada.
- Reservados por fuente. Los documentos que comparten fuente o grupo de autores quedan siempre en el mismo lado de la división, de modo que la prueba mide la capacidad de generalizar y no la memoria.
- Modelos de IA no vistos. La prueba incluye textos de modelos que nunca se usaron en ninguna fase del desarrollo.
- Fuentes humanas no vistas. Paneles de escritura humana de fuentes que nunca se usaron en el entrenamiento miden los falsos positivos tal como los encuentran los clientes.
- Pares equivalentes. Los textos de IA se escriben sobre los mismos temas y en los mismos formatos que sus equivalentes humanos, de modo que un detector no puede acertar solo por el tema o por el formato.
- Todas las formas de intervención de la IA. Texto escrito desde cero, inicio humano continuado por la IA, reescrito, pulido, pasajes de IA insertados en texto humano y borradores de IA editados por personas.
- Solo escritura de IA real. Un texto editado cuenta como asistido con IA únicamente cuando la IA modificó de verdad la redacción. Los retoques leves que dejan intacta la redacción humana quedan fuera.
- Todo el abanico de entradas. Desde extractos de unas 100 palabras hasta documentos completos, en siete idiomas, con textos jurídicos y administrativos, prosa literaria, escritura de estudiantes, artículos académicos, noticias, contenido web, reseñas y foros, documentos prácticos, y cartas y reclamaciones.
- El motor de producción. Los resultados se miden de extremo a extremo con el mismo motor que atiende a los clientes, no con una copia de laboratorio.
Disponible ahora
Veread 1.1 funciona desde el 18 de noviembre de 2026 y no requiere ninguna acción por su parte. Cada comprobación se ejecuta ya con la nueva versión:
- El detector de texto con IA de la web y la Consola.
- La API, con los mismos identificadores de modelo (
veread-1-textpara texto yveread-1para documentos) y una nueva versión fechada el 2026-11-18. Consulte la documentación de la API de detección de texto. - Los informes de documentos, en los que Veread comprueba el texto de dentro de los documentos. La página de precisión y falsos positivos recoge las mediciones principales.
- La extensión de Chrome y la revisión de trabajos en bloque para profesores.
Los resultados completos de Veread 1.1, por idioma, tipo de texto y familia de modelos, están en la guía de precisión del detector de texto con IA Veread.
Por Yang Zheng