Evaluar la verificación
Cómo saber qué IA escribió un texto: frases y rasgos de cada modelo
Frases y puntuación que distinguen en español a ChatGPT, Claude, Gemini, Grok, DeepSeek, Qwen y GLM de quien escribe a mano, y por qué no son prueba.
Publicado · Actualizado · 10 min de lectura
En esta página
Cada familia de modelos de IA deja en español un rastro estadístico distinto: ChatGPT recurre a «únicamente» y «la comunicación», Claude a «basta con» y «con precisión», Gemini a «la transparencia» y «mecanismos de», Grok a «representa un» y «sin necesidad», DeepSeek a «en definitiva» y «constituye una», Qwen a «no se trata» y «es crucial» y GLM a «exige» y «la integración». Todas esas expresiones aparecen entre 5 y 28 veces más que en los textos de personas, pero ninguna sirve para acusar a nadie: es una pista sobre el estilo, no una prueba de quién escribió el texto. Esta guía explica cómo se midieron, qué rasgos de puntuación y de estructura acompañan a cada familia, qué cautelas conviene tener y por qué un detector que solo busca frases se queda corto.
Sirve a quien quiere saber qué IA ha escrito un texto, a quien revisa trabajos o propuestas y a quien solo siente curiosidad por qué los textos de las máquinas «suenan» parecidos. Los datos proceden del corpus de Fileverity, comparado en español con textos escritos por personas, y se leen como tendencias de una familia de modelos, no como reglas.
Cómo se midieron estos rasgos
Se compararon documentos íntegramente generados por cada familia con documentos de personas del mismo idioma. Para que el tema y el género no explicaran la diferencia, los textos humanos se ponderaron hasta igualar la mezcla de fuentes y géneros de los textos de IA, y se contrastó el signo del resultado con los textos humanos originales a partir de los cuales se habían redactado los de IA.
Las frases son secuencias de una a tres palabras y se puntúan por cuánto más (o menos) aparecen en una familia que en el texto humano. Solo se conservaron las que aparecen en muchos documentos de varias fuentes y géneros, que no son una simple palabra vacía, una cifra, un nombre ni una palabra de tema, y que apuntan en la misma dirección en dos mitades aleatorias de los datos. Los rasgos de estructura se calculan sobre el texto en bruto y solo se mantienen cuando la dirección coincide en ambas mitades y tanto en textos escritos desde cero como en textos reescritos. El multiplicador indica cuántas veces más (o menos) aparece el rasgo respecto al texto humano.
Las frases que delatan a cada familia
La figura reúne, para las siete familias, dos de las expresiones más características en español con su multiplicador. Se eligieron frases que se leen como lenguaje corriente, que se pueden buscar en un texto y que no se repiten entre familias cuando la lista lo permite. Todas las barras comparten la misma escala, así que los valores muy altos de Qwen acortan las demás.
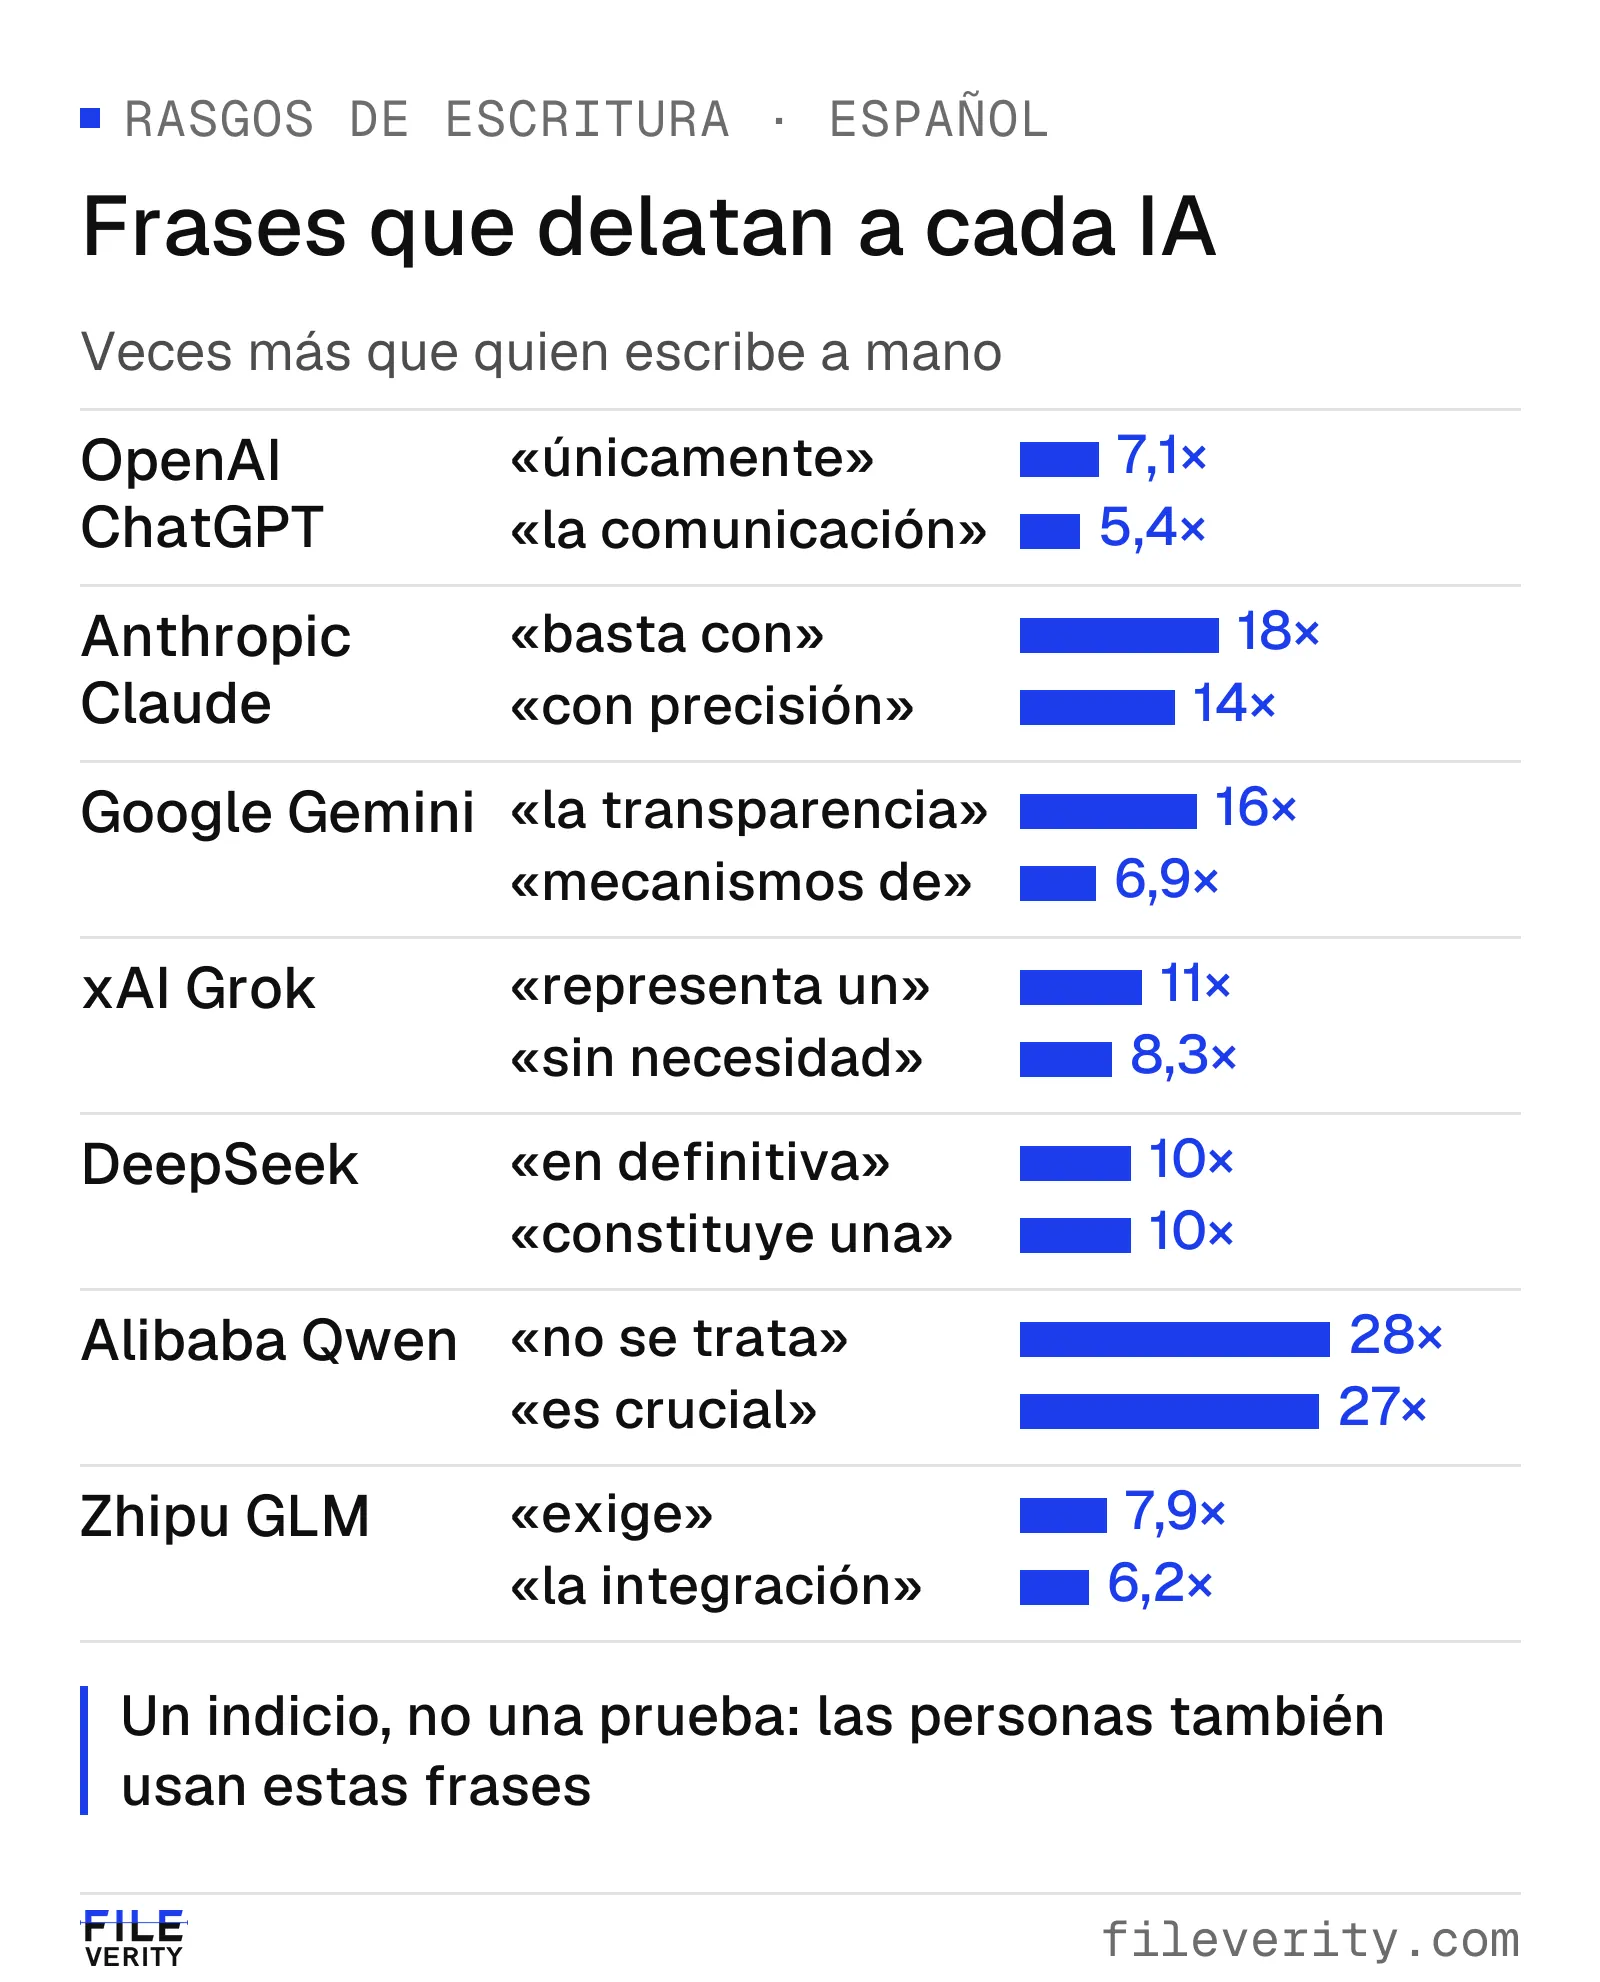
Un indicio, no una prueba: las personas también usan estas frases, solo que con menos frecuencia.
Las cifras de la figura se leen así: «es crucial» aparece 27 veces más en los textos de Qwen que en los de personas; «únicamente» aparece 7,1 veces más en los de ChatGPT. Un multiplicador alto describe a la familia, no a un texto concreto, y una sola frase no basta para atribuir nada.
ChatGPT (OpenAI)
En español, ChatGPT repite expresiones abstractas y de tono institucional. Además de «únicamente» (7,1 veces más que una persona) y «la comunicación» (5,4), destacan «es fundamental» (9), «un entorno» (11), «conviene» (11) y «a quienes» (7,7). Las frases que lo separan de las demás familias son «por sí» (4 veces más que en otros modelos), «hace falta» (3,6) y «contribuir a» (3,9).
En puntuación escribe menos paréntesis (3 veces menos), menos puntos suspensivos (2,8 veces menos) y menos exclamaciones (2,1 veces menos), y usa más contrastes del tipo «no X sino Y» (5,4 veces más), más rayas (2,4) y más enumeraciones de tres elementos (1,6). Sus frases son algo más cortas y más uniformes que las humanas. La página de ChatGPTDetect sobre cómo reconocer un texto de ChatGPT desarrolla estos rasgos.
Claude (Anthropic)
El español de Claude se distingue por conectores y adverbios de manera: «basta con» (18 veces más), «con precisión» (14), «con claridad» (7,9), «con calma» (8,2) y «aun así» (6). Su expresión más marcada, «conviene» (24), la comparte con ChatGPT y DeepSeek. Completan el perfil «de modo que» (4,3 veces más que las personas) y «buena parte» (11). Lo que más lo separa de las demás familias es «modo que» (6,6 veces más que en otros modelos), «en buena» (7,9) y «por último» (4).
No tiene ningún rasgo de estructura «de más» que sea estable en español. Sí escribe menos: seis veces menos puntos suspensivos, 2,7 veces menos paréntesis y 2,6 veces menos comillas angulares o tipográficas, y menos textos con listas. Para el desarrollo, vea la página de ClaudeDetect sobre cómo saber si Claude escribió un texto.
Gemini (Google)
Gemini prefiere sustantivos de valores y de proceso: «la transparencia» (16 veces más), «es fundamental» (12), «no se trata» (12), «el entorno» (9,6), «la estabilidad» (7,5) y «mecanismos de» (6,9). Entre las familias, se separa por «el cual» y «la cual» (2,7 y 2,6 veces más que en otros modelos), «consiste en» (2,4) y «asimismo la» (2,8).
Su rasgo de estructura más claro es el contraste «no X sino Y», 7,3 veces más que en las personas. Usa menos puntos suspensivos (6,4 veces menos), menos paréntesis (2,7) y menos signos de interrogación (1,9). En la página de GeminiDetect sobre cómo saber si Gemini escribió un texto se amplía cada uno.
Grok (xAI)
Grok se inclina por la descripción de cambios y de capacidad: «representa un» (11 veces más), «hace falta» (9,4), «sin necesidad» (8,3), «su capacidad» (7,3), «sigue siendo» (7,4) y «convertido en» (5,4). Lo que lo separa de las demás familias son frases como «que realmente» (3,1 veces más que en otros modelos), «que genera» (3,6) y «en voz» (3,5).
En estructura es la familia con menos puntos suspensivos: doce veces menos que las personas. También usa menos paréntesis (3 veces menos), menos exclamaciones (2,2) y menos preguntas (1,8), y más contrastes «no X sino Y» (5,4) y más rayas (3,7). La página de GrokDetect sobre cómo saber si Grok escribió un texto recoge los matices.
DeepSeek
DeepSeek tiene un tono más narrativo y de cierre: «en definitiva» (10 veces más), «constituye una» (10), «la sensación» (7,6), «sensación de» (5) y «sigue siendo» (5,9). Entre las familias se separa por «modo que» (4,4 veces más que en otros modelos), «con frecuencia» (3,8), «es decir» (3,1) y «la pena» (2,9). Comparte con ChatGPT y Claude «conviene» (22).
Escribe menos puntos suspensivos (3,4 veces menos), menos exclamaciones (2,2) y menos preguntas (1,9), y más contrastes «no X sino Y» (5,8). La página de DeepSeekDetect sobre cómo saber si DeepSeek escribió un texto amplía estos rasgos.
Qwen (Alibaba)
Qwen es la familia con multiplicadores más altos en español: «no se trata» (28 veces más), «es crucial» (27), «fundamental para» (17), «es fundamental» (14), «la estabilidad» (10), «un entorno» (10) y «la confianza» (7,9). Lo que lo separa de las demás es «lo cual» (3 veces más), «reside en» (3,3) y «para comprender» (5).
Tiene el mayor uso del contraste «no X sino Y»: 9,1 veces más que las personas. Escribe menos puntos suspensivos (5,1 veces menos), menos paréntesis (2,1), menos exclamaciones (2,4) y menos preguntas (1,9), y sus frases son más uniformes en longitud. Qwen no tiene página propia en nuestra red de comprobadores.
GLM (Zhipu)
GLM se reconoce por verbos de exigencia y sustantivos de conjunto: «exige» (7,9 veces más), «resulta» (7,4), «fundamental» (6,4), «la integración» (6,2), «constante» (6,2) y «el compromiso» (5,2). En español esta familia se parece mucho a las demás: solo dos frases, «de inmediato» (3,4) e «indispensable» (3), superaron todas las comprobaciones de estabilidad como rasgos propios, por lo que conviene tomar con cautela cualquier atribución a GLM.
Usa más rayas (4 veces más que las personas) y menos comillas angulares o tipográficas (3,4 veces menos), menos puntos suspensivos (2,6) y menos paréntesis (1,9). GLM tampoco tiene página propia en nuestra red de comprobadores.
Puntuación y estructura: lo que las familias tienen en común
Las frases cambian de una familia a otra, pero la puntuación coincide en algo: todos los modelos escriben menos puntos suspensivos que las personas, y casi todos menos paréntesis. La figura muestra cuatro rasgos medidos por cada 1.000 palabras para las siete familias, con el múltiplo de la tasa humana: paréntesis, puntos suspensivos, el contraste «no X sino Y» y los signos de pregunta. Un triángulo hacia arriba indica más que el texto humano, uno hacia abajo menos, y una línea horizontal, que no hay una diferencia clara.
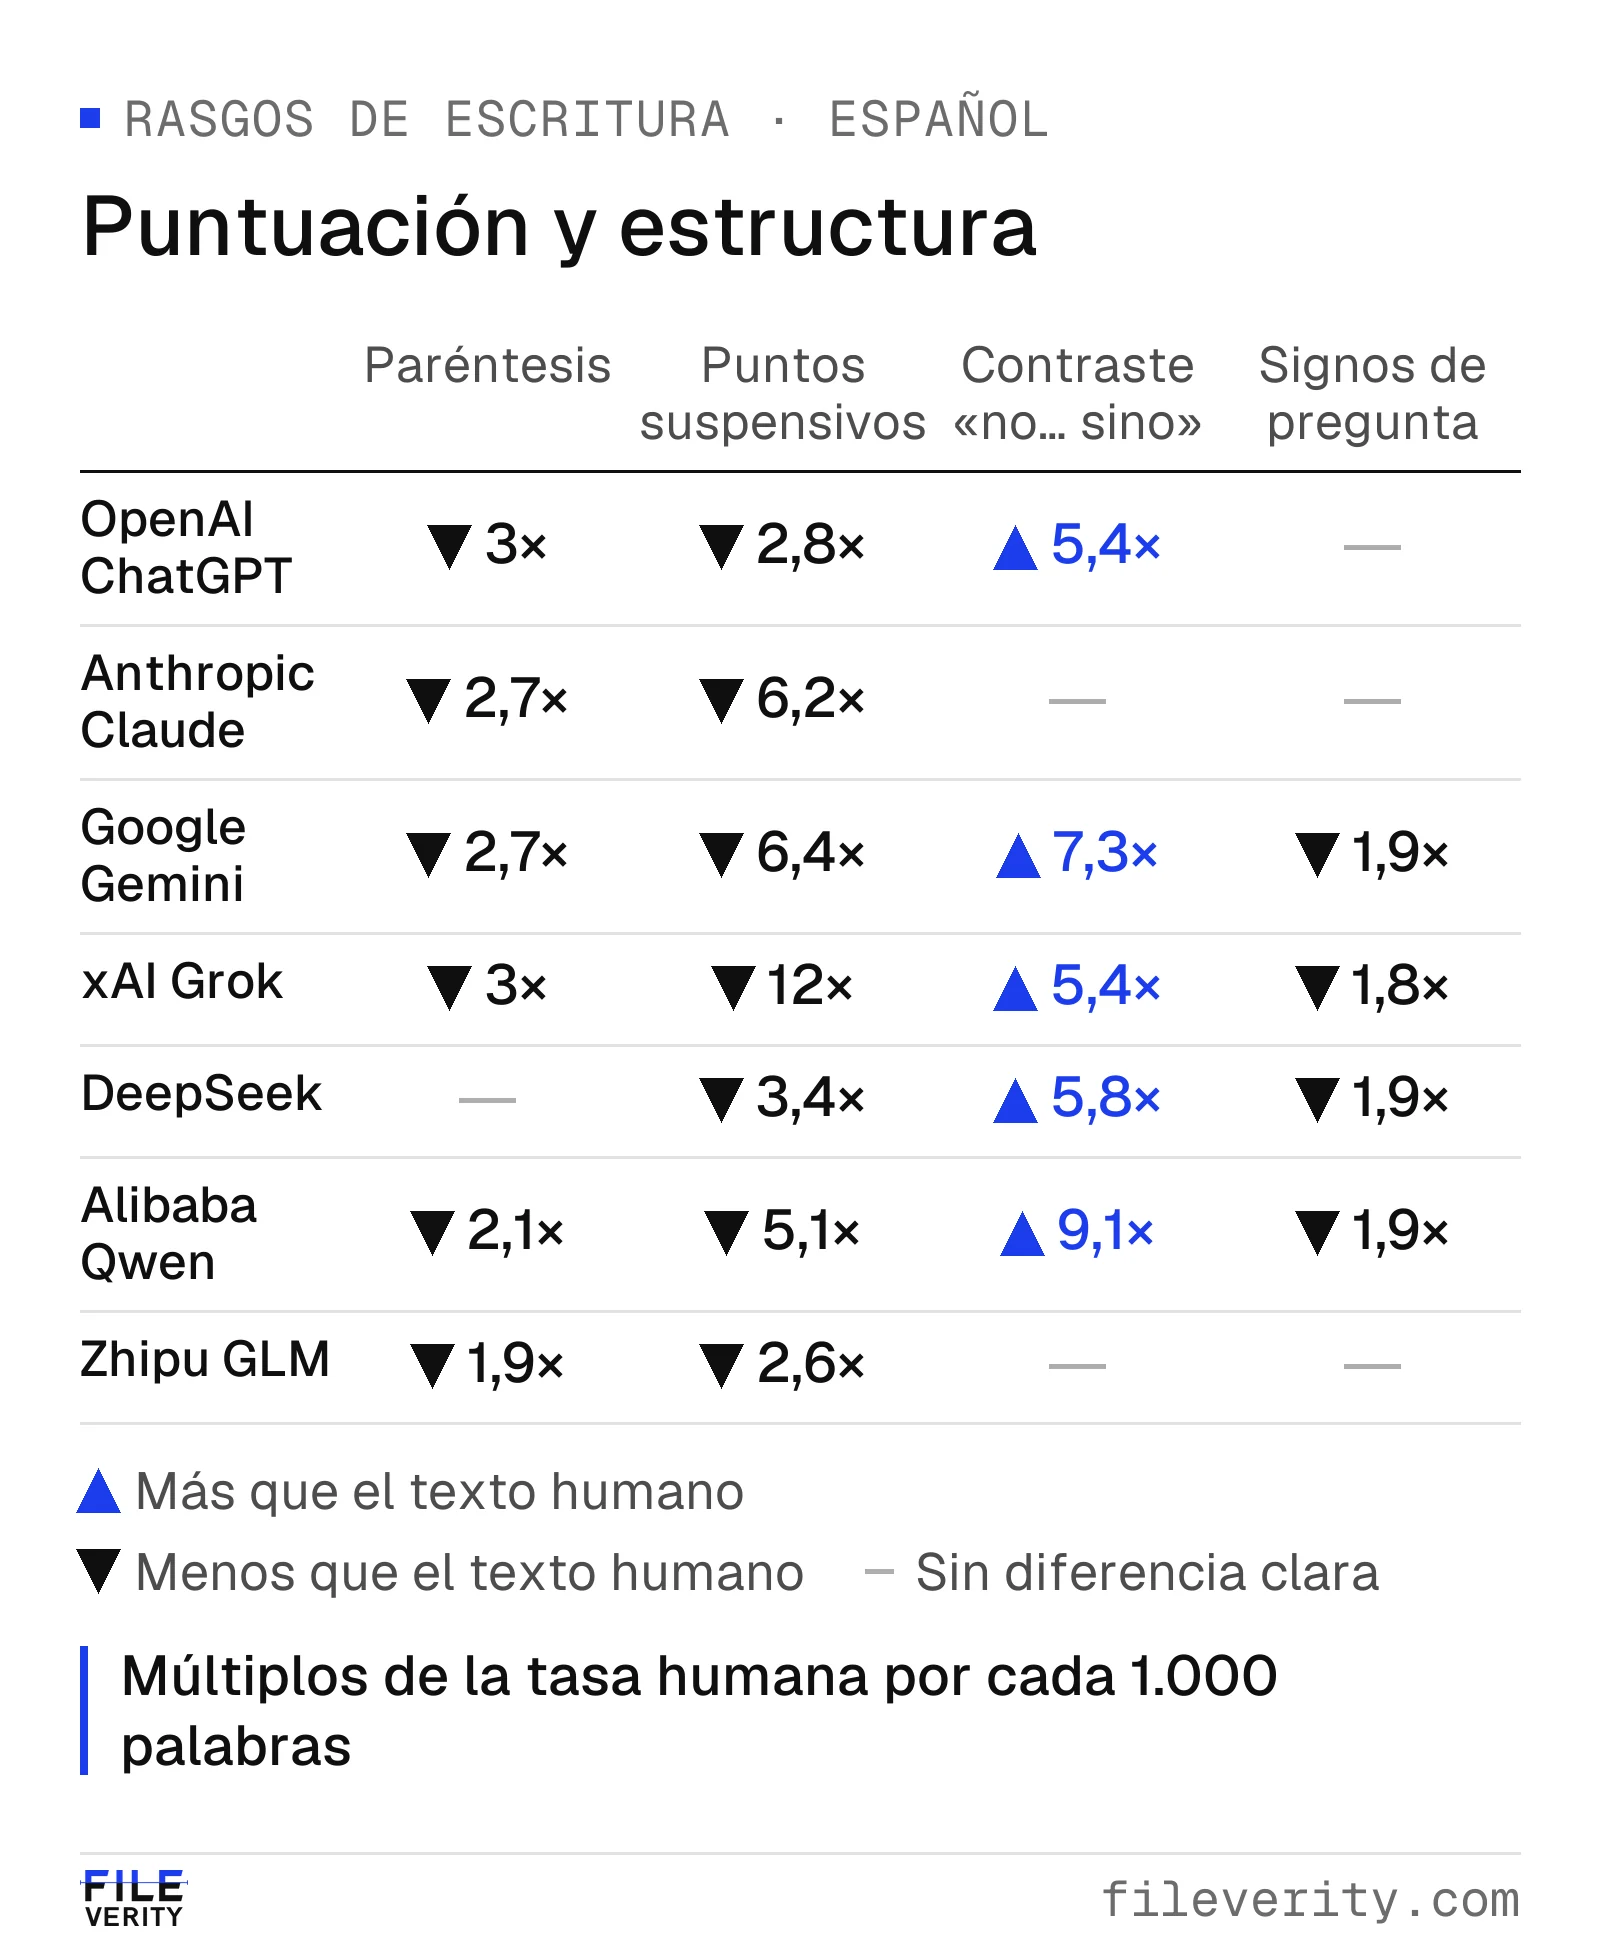
Las cifras son múltiplos de la tasa humana por cada 1.000 palabras: casi todos los modelos escriben menos paréntesis y puntos suspensivos, y cinco familias usan más el contraste «no X sino Y».
Dos precauciones al leer la figura. La primera, que una línea horizontal no significa que la familia no use ese rasgo, sino que no hay una diferencia estable con el texto humano en español. La segunda, que los textos de IA de la comparación son prosa continua, así que las listas y los encabezados dicen poco sobre lo que verá en una conversación real con un chatbot.
Salvedades: por qué un rasgo no es una prueba
- Las personas también escriben así. «Es fundamental» o «conviene» las usa cualquiera; la diferencia es de frecuencia, no de presencia. Una frase aislada no dice nada, y ningún rasgo solo permite atribuir un texto.
- Una instrucción distinta cambia el estilo. Si se pide a un modelo que escriba «con un tono coloquial» o «sin rayas», su rastro cambia. Los rasgos describen el comportamiento habitual, no el que siempre tendrá.
- Los modelos cambian. Cada versión nueva mueve los hábitos de escritura. Estas cifras describen el corpus actual de Fileverity y deben revisarse.
- Un texto editado mezcla estilos. Si una persona reescribe un borrador de IA, desaparece parte del rastro; si una IA pule un texto humano, aparece un poco.
- Los resultados por familia son de similitud. Cuando un detector indica que un texto se parece al de una familia, expresa similitud de escritura, no el modelo que lo produjo.
- Una pista no es una acusación. Conviene no basar una decisión sobre una persona, ni una nota ni una contratación, en una sola señal de estilo.
Por qué Veread lee mucho más que listas de frases
Una lista de frases es fácil de entender, pero frágil: basta pedir al modelo que evite «conviene» para que la señal se debilite, y muchas personas usan esas mismas expresiones. Veread 1.1, el modelo de detección de texto de Fileverity, no cuenta frases sueltas. Lee la redacción completa, del vocabulario al ritmo de las frases, y localiza los pasajes que sustentan su hallazgo. Un solo modelo atiende los siete idiomas.
Su precisión se midió con datos reservados que nunca se usaron en el desarrollo: un 0,28 % de falsos positivos en textos de personas en siete idiomas, el 98,6 % del texto escrito íntegramente con IA detectado y el 94,9 % en textos de modelos que no se usaron en su desarrollo. Los resultados completos están en la página de precisión y falsos positivos. Para probarlo con un texto concreto, utilice la detección de texto con IA de Fileverity, que indica cuánto se parece la escritura a la de cada familia como similitud de escritura. Para saber si el proveedor marca sus textos de forma verificable, consulte la guía marca de agua en textos de IA.
Preguntas frecuentes
¿Cómo saber qué IA ha escrito un texto?
Con una combinación de señales: las frases y los rasgos de puntuación típicos de cada familia, el resultado de un detector de estilo y el contexto del documento. Ninguna prueba por sí sola qué modelo lo escribió, y las marcas de agua de los proveedores solo las pueden leer ellos y unas organizaciones aprobadas.
¿Hay frases que delaten a ChatGPT en español?
Hay expresiones que aparecen mucho más que en los textos de personas, como «únicamente», «la comunicación», «es fundamental», «un entorno» o «conviene». Su frecuencia es mayor, pero las personas también las usan, así que solo sirven como indicio.
¿Escribe Claude de forma distinta a ChatGPT?
Sí, en tendencia. Claude usa mucho «basta con», «con precisión», «con claridad» y «de modo que», y casi no emplea puntos suspensivos; ChatGPT, en cambio, recurre más a las rayas y a los contrastes «no X sino Y».
¿Se puede distinguir DeepSeek, Qwen o GLM de las demás IA?
Parcialmente. DeepSeek y Qwen tienen frases propias («en definitiva», «constituye una», «no se trata», «es crucial»). GLM se parece tanto a las demás familias en español que solo dos frases superaron todas las comprobaciones, por lo que su atribución es la menos fiable.
¿Es fiable detectar IA por las frases típicas?
No como único método. Es una señal estadística de una familia: los modelos cambian, los avisos modifican el estilo y las personas usan esas mismas frases. Un detector que lee toda la redacción es más robusto que una lista de expresiones.
Por Yang Zheng