Nouveau modèle
Veread 1.1 : moins de faux positifs, un marquage plus précis
Veread 1.1 détecte 98,6 % des textes entièrement rédigés par IA, avec 0,28 % de faux positifs, et 92,2 % des documents mixtes. Depuis le 18 novembre 2026.
Publié le · 8 min de lecture
L’essentiel
- Version
- Veread 1.1
- Date de sortie
- 18 novembre 2026
- Faux positifs sur l’écriture humaine
- 0,28 % (contre 0,45 %)
- Textes entièrement rédigés par IA détectés
- 98,6 %
- Documents mêlant écriture humaine et IA détectés
- 92,2 % (contre 87,3 %)
- Textes de modèles d’IA inédits détectés
- 94,9 %
Veread 1.1, publié le 18 novembre 2026, détecte 98,6 % des textes entièrement rédigés par IA et ne signale à tort que 0,28 % des textes écrits par des personnes, contre 0,45 % pour Veread 1.0, sur des textes réservés en sept langues. Il détecte 92,2 % des documents qui mêlent écriture humaine et écriture IA (contre 87,3 %) et repère les passages rédigés par IA avec une précision de 97,2 %.
Veread est le modèle de détection de texte IA développé par Fileverity. Toutes les vérifications de texte et de documents sur Fileverity s’appuient désormais sur la version 1.1.
Ce que change Veread 1.1
- Un entraînement centré sur l’anglais, l’espagnol et le français. Les sept langues restent dans un seul modèle : anglais, français, allemand, espagnol, chinois, vietnamien et arabe.
- Une écriture humaine beaucoup plus variée. Dissertations et devoirs d’étudiants, articles scientifiques complets (introduction, développement et conclusion, pas seulement les résumés), lettres et réclamations, critiques de films et avis sur des produits, discussions de forums, fiction et écriture littéraire, textes juridiques et administratifs, actualités et articles encyclopédiques.
- Des cas humains difficiles, choisis volontairement. Les textes humains formels, standardisés ou très soignés, ceux qu’un détecteur confond le plus souvent avec de l’IA, occupent désormais une place centrale dans l’entraînement.
- Les écrits d’IA les plus récents, issus de neuf familles de modèles : OpenAI, Anthropic, Google, DeepSeek, Alibaba, Meta, Mistral, xAI et Zhipu. Y compris des textes IA reformulés ou « humanisés » pour échapper aux détecteurs, et des réécritures IA de textes humains.
- Des étiquettes au niveau de la phrase. Chaque phrase rédigée par IA dans un document mixte est étiquetée : le modèle apprend ainsi précisément où s’arrête l’écriture humaine et où commence l’écriture IA.
- Des textes d’entraînement nettoyés. Mentions d’auteur, crédits, bandeaux de cookies et d’abonnement, balisage, appels de note et nombres de mots ont été retirés par simple suppression. L’écriture elle-même n’est jamais modifiée : Veread juge le texte, pas la mise en forme.
- Un contrôle des doublons exacts et approchés entre l’entraînement et l’évaluation.
- De nouveaux seuils de décision, calibrés sur des textes humains réservés. Le marquage des passages et l’indication de proximité de style avec une famille de modèles, qui apparaît plus souvent et se révèle plus juste, ont été recalibrés pour le nouveau modèle.
Résultats : Veread 1.1 face à Veread 1.0
Les deux versions ont passé la même évaluation : des textes réservés d’environ 100 mots ou plus, dans sept langues.
| Mesure | Veread 1.0 | Veread 1.1 |
|---|---|---|
| Textes humains signalés à tort comme IA | 0,45 % | 0,28 % |
| Textes entièrement rédigés par IA détectés | 98,3 % | 98,6 % |
| Textes rédigés ou assistés par IA, toutes formes confondues, détectés | 95,4 % | 95,9 % |
| Textes humains prolongés par IA détectés | 91,7 % | 94,3 % |
| Documents mêlant écriture humaine et écriture IA détectés | 87,3 % | 92,2 % |
| Extraits courts d’environ 100 mots détectés | 92,9 % | 94,1 % |
| Documents complets détectés | 96,6 % | 96,8 % |
| Textes réécrits par IA détectés | 92,5 % | 92,8 % |
| F1 du marquage des passages | 90,3 | 92,9 |
| AUROC, extraits courts | 0,995 | 0,996 |
Veread 1.1 détecte aussi 100 % des passages IA insérés dans un texte humain, 97,6 % des textes retouchés par IA et 94,9 % des textes issus de modèles d’IA jamais utilisés pendant le développement. L’AUROC sur les documents complets atteint 0,999.
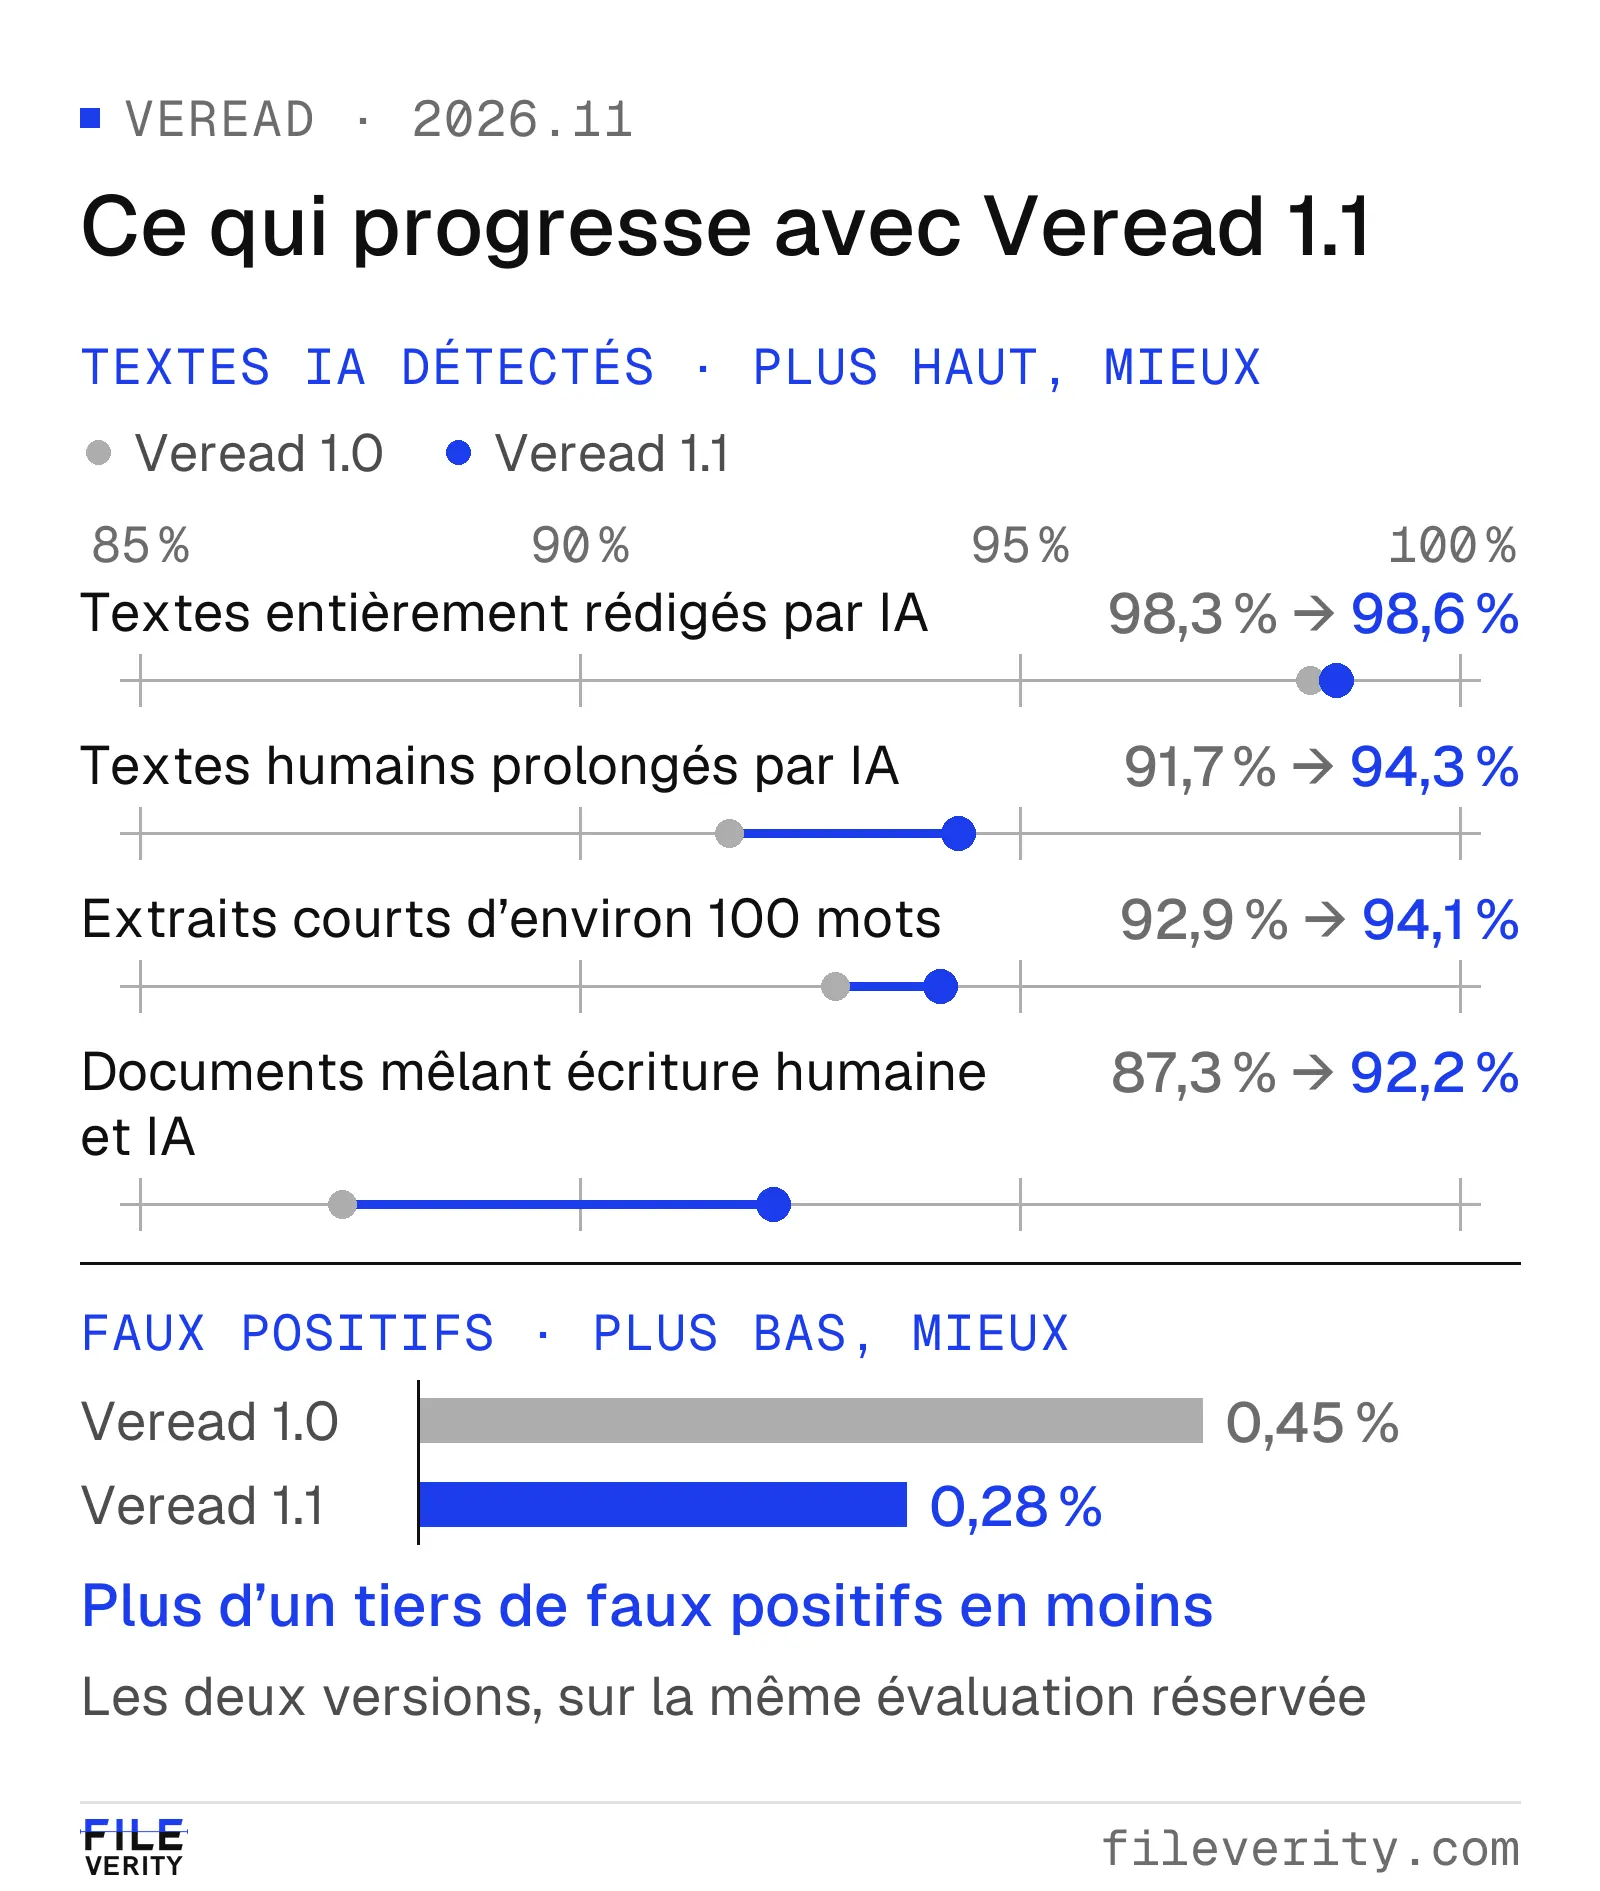
Les faux positifs reculent de plus d’un tiers, et la détection progresse sur chacune des mesures principales.
Les mesures en clair
- Taux de faux positifs : part des textes rédigés par des personnes qui reçoivent un constat IA. Plus il est bas, mieux c’est.
- Taux de détection : part des textes rédigés ou assistés par IA que Veread identifie. Plus il est haut, mieux c’est.
- Assisté par IA : un texte n’est compté que si l’IA a réellement modifié la formulation, qu’elle ait prolongé le texte, l’ait réécrit ou retouché, ou que ses passages aient été insérés dans un texte humain.
- AUROC : capacité des scores de Veread à séparer nettement écriture humaine et écriture IA, quel que soit le point de décision retenu. Un score de 1 correspond à une séparation parfaite.
- F1 du marquage des passages : un score unique qui combine la part des passages rédigés par IA que Veread retrouve et la part des passages marqués qui sont bien rédigés par IA.
- Précision des passages marqués : part du texte marqué qui est réellement rédigé par IA.
Moins de faux positifs sur l’écriture humaine
Un faux positif, c’est le travail d’une personne pris pour celui d’une machine. Pour un enseignant, un service des admissions ou un éditeur, c’est ce taux qui détermine si un détecteur est utilisable sur le travail de vraies personnes.
Veread 1.1 signale 0,28 % des textes humains, soit plus d’un tiers de faux positifs en moins qu’avec Veread 1.0. Ce chiffre porte sur l’ensemble des textes humains réservés, y compris des panels indépendants de textes issus de sources jamais utilisées pendant l’entraînement. Sur les documents complets, il descend à 0,23 %.
Chaque langue reste sous 0,5 %. En anglais, le taux passe de 0,43 % à 0,18 %, en espagnol de 0,77 % à 0,41 % et en français de 0,76 % à 0,45 % ; le détail figure dans le tableau par langue plus bas. Chaque type de texte reste sous 1 %. La littérature et l’écriture littéraire passent de 0,62 % à 0,08 %, les avis et forums de 0,84 % à 0,38 %, les rédactions d’étudiants et d’apprenants de 0,51 % à 0,30 %, et les textes universitaires et scientifiques de 1,08 % à 0,77 %.
Un marquage des passages plus précis dans les documents mixtes
Les dossiers réels sont rarement de la pure production machine. Veread 1.1 apprend à partir d’étiquettes posées phrase par phrase : il détecte ainsi 92,2 % des documents qui mêlent écriture humaine et écriture IA (contre 87,3 %), marque les passages avec une précision de 97,2 % et atteint un F1 de marquage des passages de 92,9 (contre 90,3). Ces résultats sont mesurés de bout en bout, sur le moteur de production.
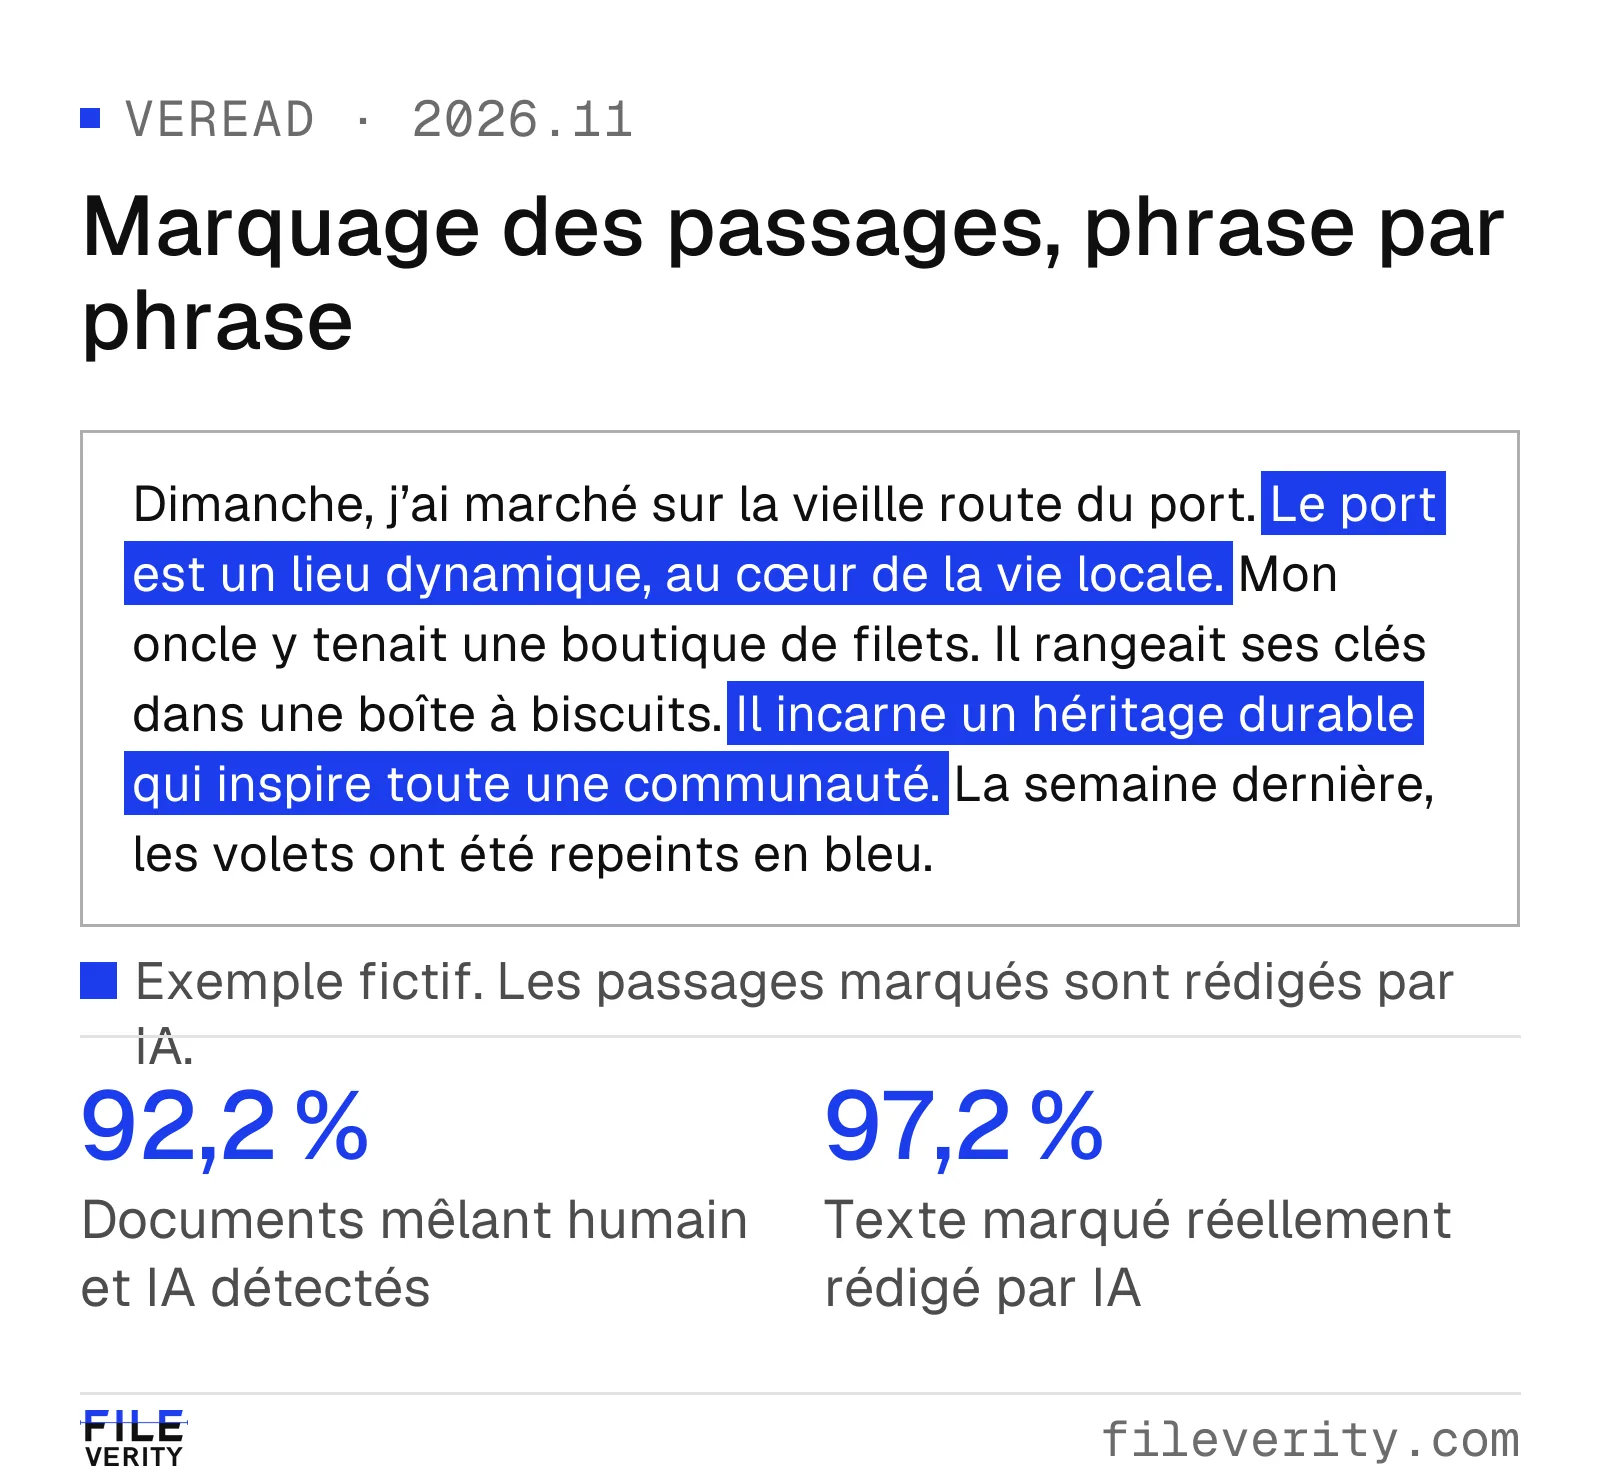
Exemple fictif. Veread 1.1 marque les phrases rédigées par IA dans un document qui contient aussi de l’écriture humaine.
De solides résultats dans les sept langues
Un seul modèle sert les sept langues, et chacune est mesurée séparément.
| Langue | Textes humains signalés à tort | Textes rédigés ou assistés par IA détectés | Textes entièrement rédigés par IA détectés |
|---|---|---|---|
| Anglais | 0,18 % | 94,5 % | 95,1 % |
| Français | 0,45 % | 96,8 % | 99,1 % |
| Allemand | 0,27 % | 94,1 % | 100 % |
| Espagnol | 0,41 % | 96,0 % | 100 % |
| Chinois | 0,03 % | 98,8 % | 100 % |
| Vietnamien | 0,48 % | 92,8 % | 95,5 % |
| Arabe | 0,13 % | 97,5 % | 98,5 % |
La détection des textes rédigés ou assistés par IA progresse en anglais (de 93,3 % à 94,5 %), en allemand (de 93,2 % à 94,1 %), en vietnamien (de 90,7 % à 92,8 %) et en arabe (de 97,2 % à 97,5 %). Pour les textes entièrement rédigés par IA en allemand, elle passe de 99,1 % à 100 %.
Par famille de modèles, les textes entièrement rédigés par IA sont détectés à 100 % pour OpenAI, Alibaba, Mistral, xAI et Meta (Meta contre 96,8 %), à 96,3 % pour DeepSeek (contre 95,1 %) et à 95,9 % pour Google (contre 93,9 %).
Par type de texte, la détection des textes rédigés ou assistés par IA atteint 100 % pour les textes universitaires et scientifiques ainsi que pour les lettres, courriels et réclamations, et 99,1 % pour les rédactions d’étudiants et d’apprenants (contre 98,1 %).
Comment nous évaluons Veread
La valeur d’un détecteur tient à la rigueur de son évaluation. Veread est développé et validé sur des données massives, exclusives, propriétaires et sélectionnées par des professionnels, et chaque résultat de cet article provient de l’évaluation décrite ci-dessous.
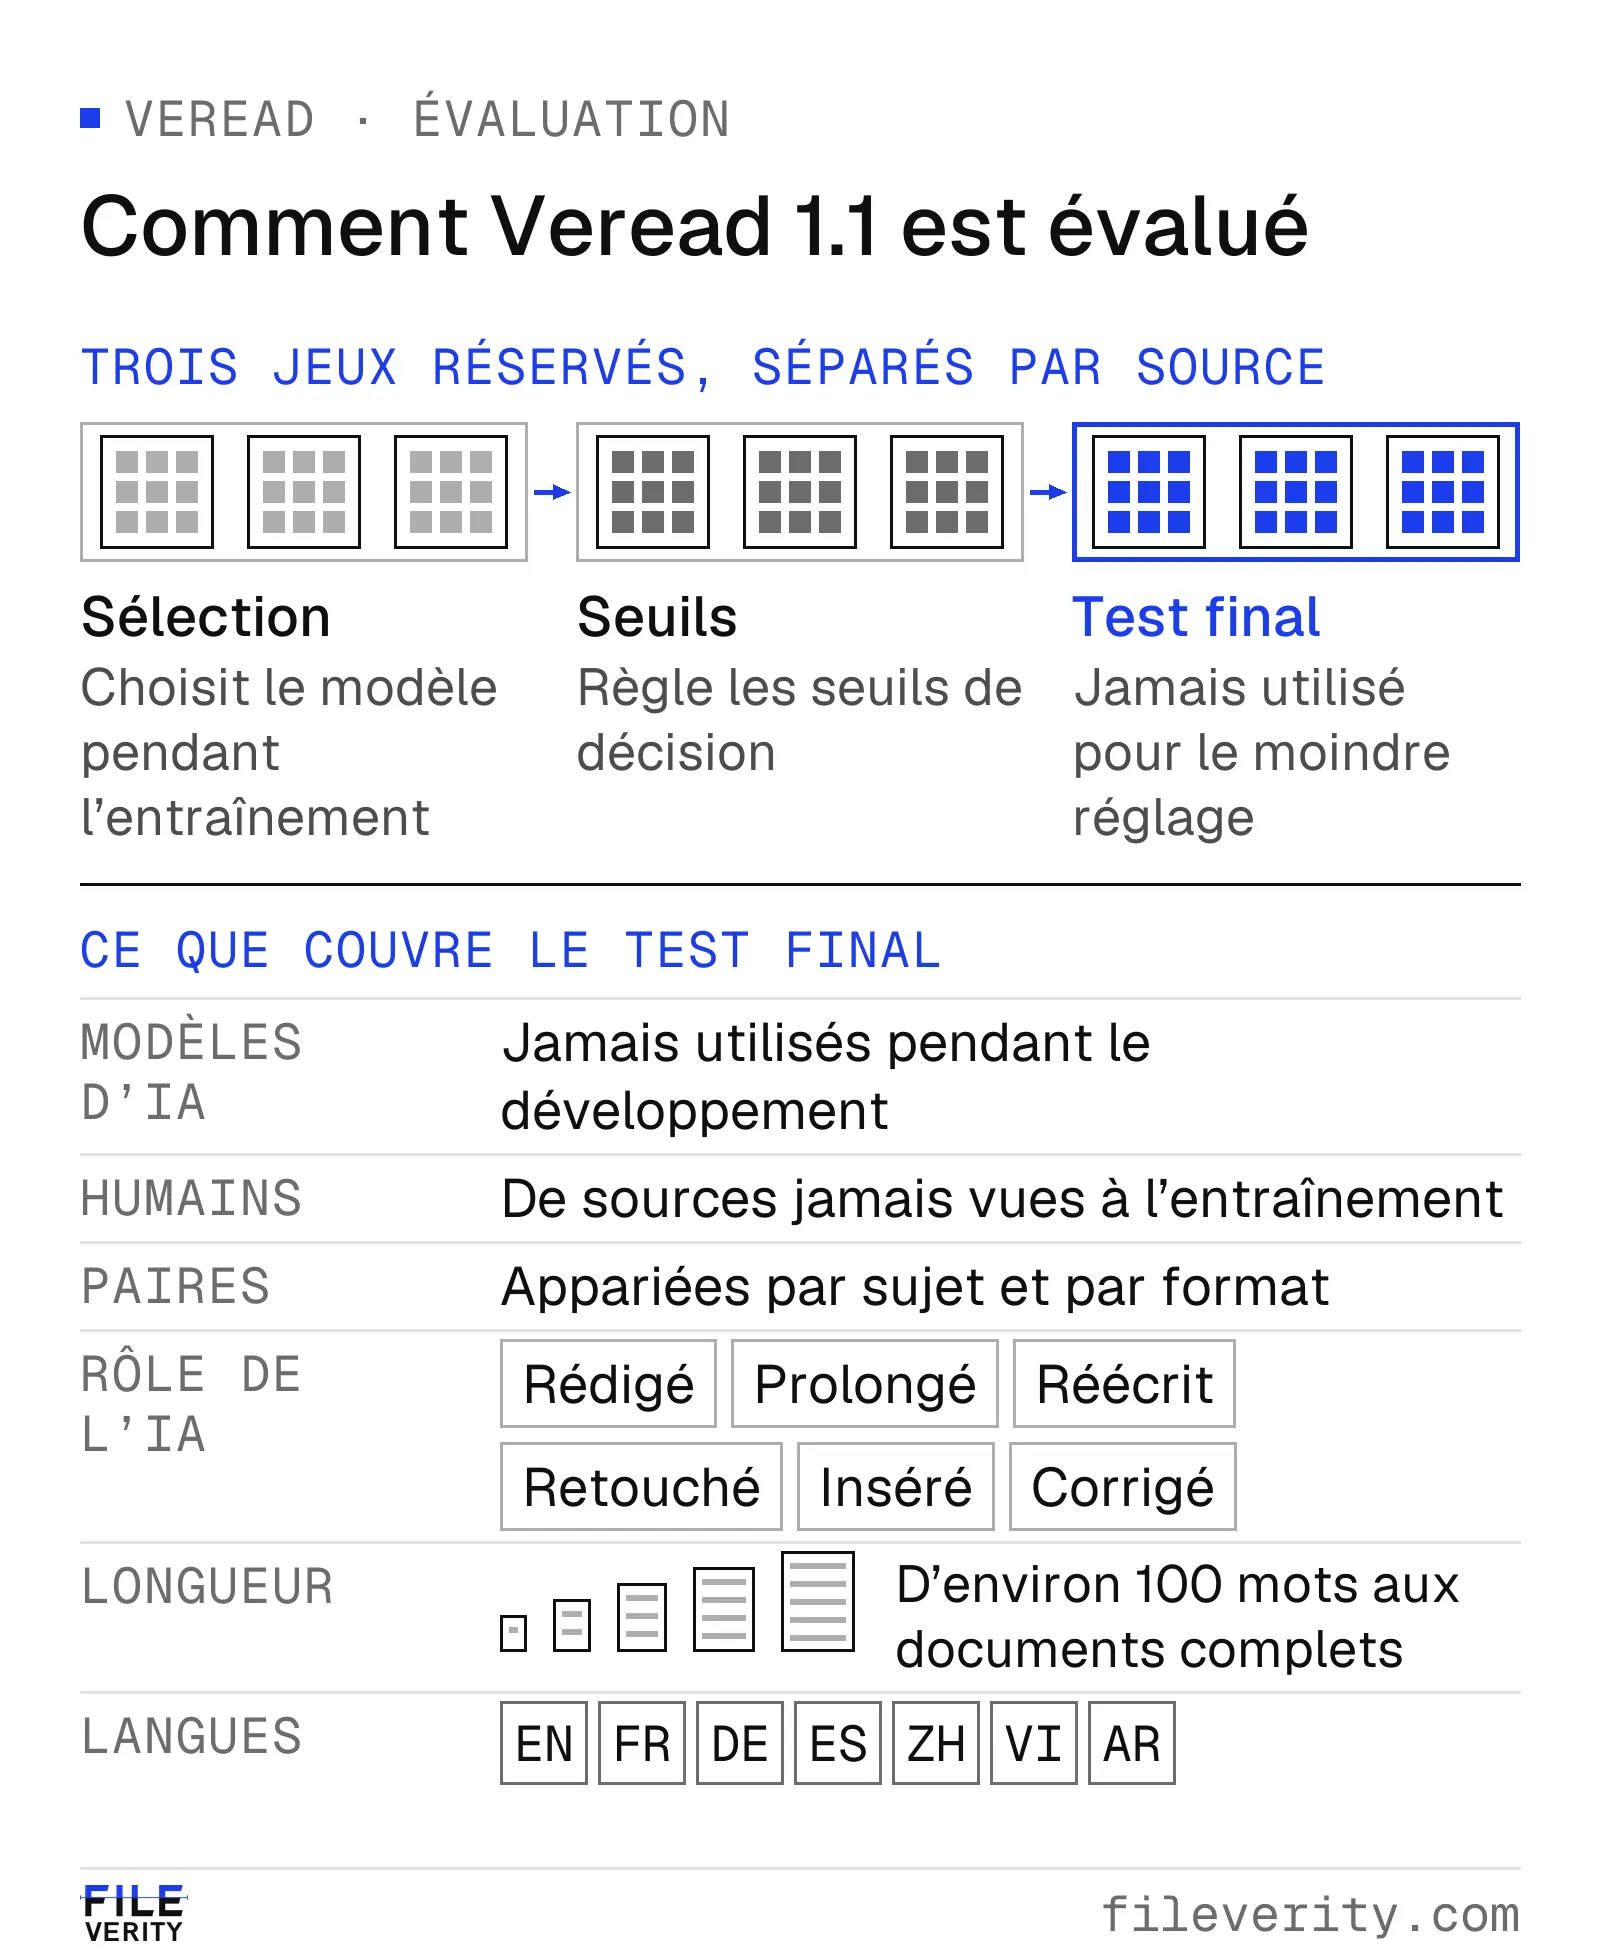
L’évaluation sépare le choix du modèle, le réglage des seuils et le test final, et mesure le moteur que vos équipes utilisent.
- Trois jeux réservés, trois rôles. Le premier sert à choisir le modèle pendant l’entraînement, le deuxième à régler les seuils de décision, le troisième au test final. Ce dernier n’est jamais utilisé pour ajuster quoi que ce soit.
- Une séparation par source. Les documents qui partagent une même source ou un même groupe d’auteurs restent du même côté de la séparation : le test mesure la capacité de généralisation, pas la mémoire.
- Des modèles d’IA inédits. Le test comprend des textes issus de modèles qui n’ont été utilisés nulle part pendant le développement.
- Des sources humaines inédites. Des panels de textes humains issus de sources jamais utilisées pendant l’entraînement mesurent les faux positifs tels que vos équipes les rencontrent.
- Des paires appariées. Les textes IA sont rédigés sur les mêmes sujets et dans les mêmes formats que leurs équivalents humains : un détecteur ne peut donc pas réussir grâce au seul sujet ou au seul format.
- Toutes les formes d’intervention de l’IA. Texte rédigé de zéro, début humain prolongé par IA, texte réécrit, texte retouché, passages IA insérés dans un texte humain, et brouillons d’IA corrigés par des personnes.
- De la vraie écriture IA uniquement. Un texte modifié n’est compté comme assisté par IA que si l’IA a réellement changé la formulation. Les retouches légères qui laissent intacte l’écriture humaine sont exclues.
- Toute la diversité des textes. Des extraits d’environ 100 mots jusqu’aux documents complets, en sept langues, et des textes de toute nature : juridiques et administratifs, littéraires, rédactions d’étudiants, textes universitaires, actualités, contenus web, avis et forums, documents pratiques, lettres et réclamations.
- Le moteur de production. Les résultats sont mesurés de bout en bout sur le moteur qui sert les clients, pas sur une copie de laboratoire.
Disponible dès maintenant
Veread 1.1 est en service depuis le 18 novembre 2026, sans aucune action de votre part :
- Le détecteur de texte IA du site et la Console.
- L’API, avec des identifiants de modèle inchangés (
veread-1-textpour le texte,veread-1pour les documents) et un nouvel instantané daté du 2026-11-18. Consultez la documentation de l’API de détection de texte. - Les rapports documentaires, dans lesquels Veread analyse le texte contenu dans les documents. La page sur la fiabilité présente les principales mesures.
- L’extension Chrome et la vérification de classes entières pour les enseignants.
Le tableau de bord complet de Veread 1.1, par langue, type de texte et famille de modèles, figure dans le guide sur la fiabilité de Veread.
Par Yang Zheng