Évaluer les outils de vérification
Quelle IA a écrit ce texte ? Les tournures de ChatGPT, Claude, Gemini, Grok et DeepSeek
Les tournures et la ponctuation qui distinguent ChatGPT, Claude, Gemini, Grok, DeepSeek, Qwen et GLM en français, mesurées face aux auteurs humains.
Publié le · Mis à jour le · 8 min de lecture
Dans cet article
Chaque famille de modèles a ses habitudes d’écriture : en français, ChatGPT affectionne « contribue à », Gemini « réside dans », Qwen « offre une ». Pris isolément, ces mots n’ont rien de suspect, mais mesurée sur de grands corpus, leur fréquence s’écarte nettement de celle des auteurs humains. Ce guide présente, pour sept familles, les tournures qui ressortent le plus, la ponctuation qui les distingue et la façon dont nous les avons établies, avec les limites d’une telle lecture.
Si vous vous demandez quelle IA a écrit un texte, gardez la règle de départ : ces tournures sont un indice de style, jamais une preuve. Des personnes les emploient aussi, et une consigne de rédaction change le style d’un modèle. Le détecteur de texte IA de Fileverity ne se contente pas de listes de mots, comme le montre la dernière section.
Les tournures qui trahissent chaque famille
Le graphique retient deux expressions par famille, avec le nombre de fois où elles apparaissent plus souvent que chez des auteurs humains écrivant en français. Les échelles ne se comparent pas d’une famille à l’autre : chaque barre mesure l’écart avec les textes humains, pas la qualité d’un modèle.
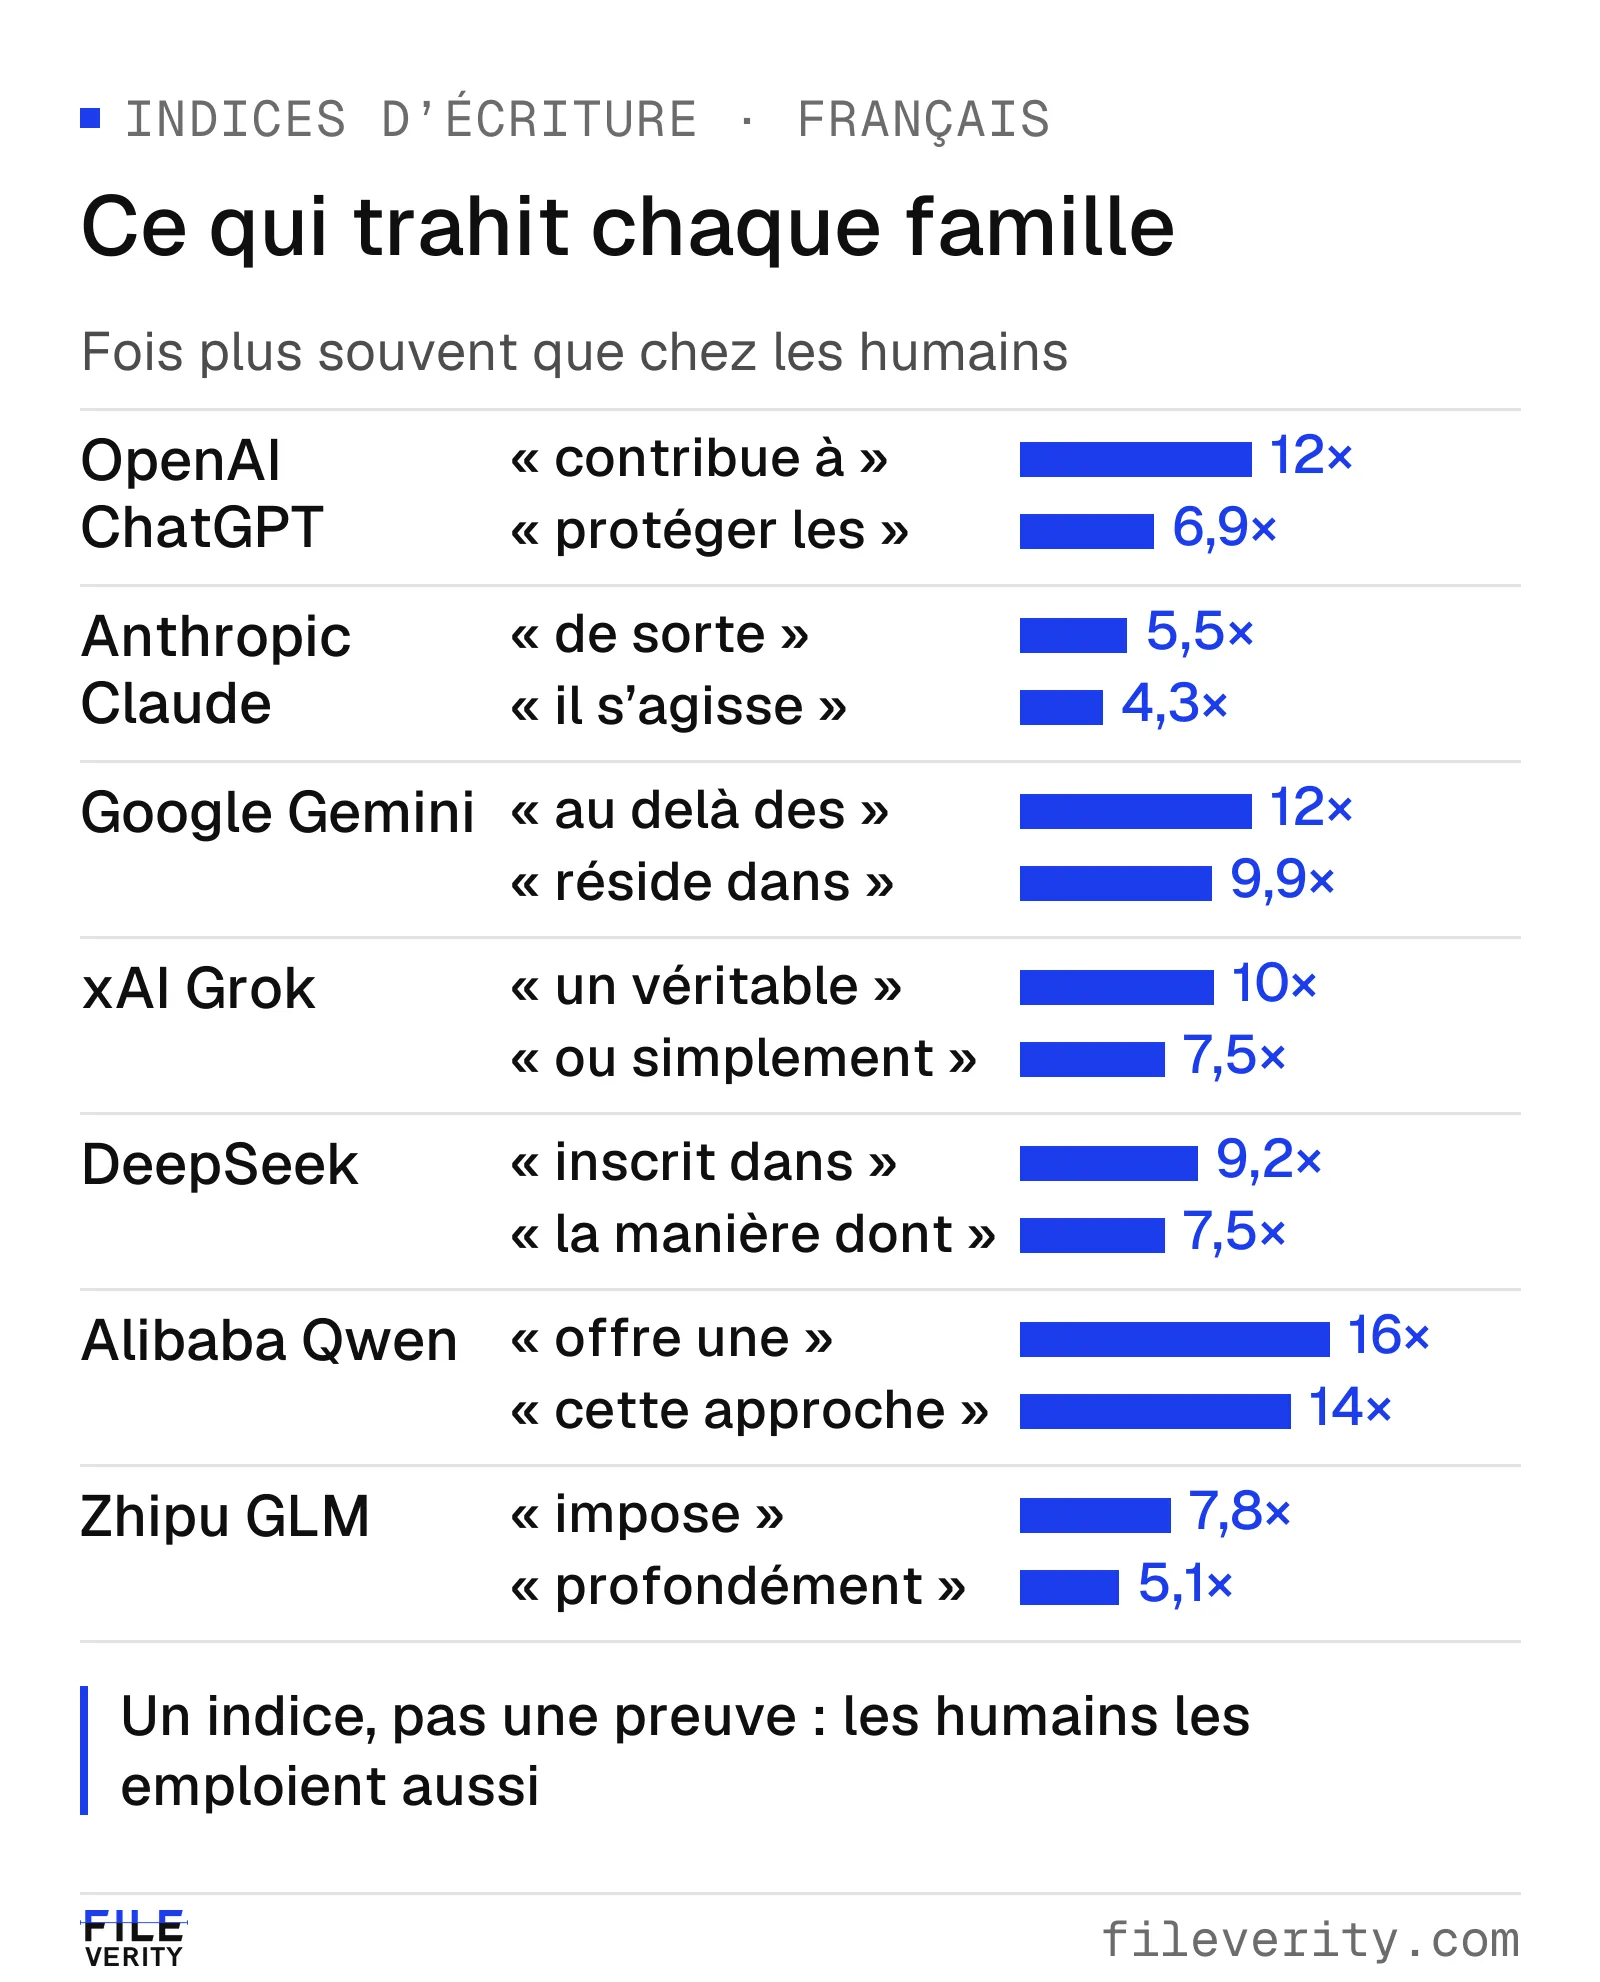
Un indice, pas une preuve : ces tournures reviennent bien plus souvent dans les textes d’IA, mais des personnes les écrivent aussi.
Comment ces tournures ont été établies
Nous avons comparé des documents entièrement rédigés par chaque famille à des documents humains dans la même langue. Les textes humains ont été pondérés pour reproduire les mêmes sources et le même mélange de genres que les textes d’IA : le sujet et le genre ne pèsent donc pas sur le résultat. Une seconde comparaison, avec les textes humains dont les textes d’IA étaient issus, a servi de contrôle.
Les expressions sont des suites d’un à trois mots, notées selon l’écart entre leur fréquence chez la famille et chez les humains. Une expression n’est retenue que si elle apparaît dans de nombreux documents de plusieurs sources et genres, si elle n’est pas un simple mot-outil, un nombre, un nom propre ou un mot de sujet, et si elle va dans le même sens sur deux moitiés tirées au hasard des données. La ponctuation est comptée sur le texte brut et gardée seulement quand le sens de l’écart se confirme, pour la rédaction comme pour la réécriture. Ce sont des tendances statistiques d’une famille : un texte isolé peut s’en écarter, et les consignes données au modèle changent son style.
Un mot sur « repose sur » : toutes les familles l’emploient bien plus que les auteurs humains, de 7 fois pour Claude à 16 fois pour Gemini. Pour reconnaître une famille, il faut donc regarder les tournures qui la séparent des autres, citées dans chaque section.
ChatGPT (OpenAI) : « contribue à » et la ponctuation réduite
Les tournures les plus nettes sont « contribue à » (12 fois plus souvent que chez les humains), « ne suffit » (10 fois), « repose sur » (7,5 fois), « protéger les » (6,9 fois) et « est essentiel » (6,8 fois). Ce qui le sépare des autres familles : « un avenir » (4,5 fois plus souvent que chez les autres modèles), « limiter les » (4,4 fois) et « tenir compte » (4 fois).
Côté structure, ChatGPT écrit près de neuf fois plus de tirets cadratins que les humains (8,6 fois) et un peu plus de listes de trois éléments (1,7 fois). Il écrit en revanche bien moins de parenthèses (3,6 fois moins) et de points de suspension (3,4 fois moins). Le détail se trouve sur ChatGPTDetect : reconnaître un texte écrit par ChatGPT.
Claude (Anthropic) : proche des autres, mais des phrases longues
Claude est la famille la plus proche des autres en français : seules quatre expressions la séparent de façon stable, dont « lorsque l’ », « lorsque la » et « lorsque le » (environ 3 fois plus souvent que chez les autres modèles). Face aux humains, on relève « repose sur » (7,3 fois), « de sorte » (5,5 fois), « demeure » (5 fois), « il s’agisse » (4,3 fois) et « ne saurait » (4,1 fois).
Sa signature est dans le rythme et le point-virgule : environ 35 mots par phrase en moyenne contre 25 pour les autres familles, et 2,5 fois plus de points-virgules que les autres modèles. Il écrit moins de points de suspension (3,7 fois moins) et de parenthèses (3,2 fois moins) que les humains. Le détail se trouve sur ClaudeDetect : reconnaître un texte de Claude.
Gemini (Google) : « repose sur » à 16 fois
Gemini a les écarts les plus marqués avec les humains : « repose sur » (16 fois), « fil des » (13 fois), « au delà des » (12 fois), « démarche » (11 fois), « réside dans » (9,9 fois) et « capacité à » (8,6 fois). Ce qui le sépare des autres familles : « s’avère » (3,2 fois plus souvent que chez les autres modèles), « indispensable » et « auprès des » (2,8 fois chacun).
Il écrit nettement moins de points de suspension (4,5 fois moins), de points d’exclamation (4,1 fois moins) et de points-virgules (2,7 fois moins) que les humains, et utilise 1,9 fois plus de tirets cadratins que les autres modèles. Le détail se trouve sur GeminiDetect : reconnaître un texte Gemini.
Grok (xAI) : « un véritable », « ou simplement »
Grok se reconnaît à « un véritable » (10 fois plus souvent que chez les humains), « constitue un » (8,9 fois), « ou simplement » (7,5 fois), « une simple » (7 fois) et « un simple » (6,3 fois). Face aux autres familles, il ressort par « lorsque l’ » (3,7 fois), « le plaisir » (3,5 fois), « la première fois » (3,2 fois) et « et surtout » (2,5 fois).
Il écrit deux fois plus de listes de trois éléments que les humains, davantage de guillemets (1,6 fois) et introduit plus souvent des listes par deux-points (27 % des textes contre 17 %). Il utilise beaucoup moins de points d’exclamation (4,6 fois moins) et de points de suspension (3,8 fois moins). Le détail se trouve sur GrokDetect : reconnaître un texte Grok.
DeepSeek : « constitue un », « la manière dont »
DeepSeek se reconnaît à « repose sur » (14 fois plus souvent que chez les humains), « fil des » (13 fois), « constitue un » (11 fois), « inscrit dans » (9,2 fois), « au quotidien » (8 fois) et « la manière dont » (7,5 fois). Ce qui le sépare des autres familles : « résulte » (3,2 fois), « manière dont » (3 fois) et « ne saurait » (2,6 fois).
Côté structure, il introduit des listes par deux-points dans 29 % des textes contre 18 % chez les humains, écrit moins de parenthèses (2,5 fois moins) et très peu de listes à puces (2 % des textes contre 8 %). Ses phrases sont plus régulières, avec une variation de longueur de 0,43 contre 0,59. Le détail se trouve sur DeepSeekDetect : reconnaître un texte DeepSeek.
Qwen (Alibaba) : « offre une », « cette approche »
Qwen affiche des multiplicateurs très élevés : « offre une » (16 fois plus souvent que chez les humains), « une simple » et « cette approche » (14 fois chacune), « cœur de » (8,9 fois) et « est essentiel » (6,6 fois). Ce qui le sépare des autres familles : « pas simplement » (7,3 fois), « est impératif » (4,3 fois) et « est crucial » (2,6 fois). Il construit aussi plus de contrastes du type « il ne s’agit pas de X mais de Y », 2,3 fois plus que les autres modèles.
Il écrit beaucoup moins de points d’exclamation (3,7 fois moins) et de points de suspension (3,5 fois moins). DeepSeekDetect compare DeepSeek à Qwen, GLM, ChatGPT et d’autres familles.
GLM (Zhipu) : peu de tournures qui le séparent des autres
GLM est proche des autres familles en français : seules cinq expressions le séparent de façon stable, comme « fortement » (3,8 fois plus souvent que chez les autres modèles), « totalement » (3 fois) et « de nos » (2,6 fois). Face aux humains, on relève « une simple » (13 fois), « cœur de » (8,2 fois), « impose » (7,8 fois) et « profondément » (5,1 fois).
Ses phrases sont plus courtes que celles des humains (22 mots contre 28 en moyenne), avec moins de parenthèses (2,3 fois moins) et de points-virgules (1,7 fois moins). Cette famille se reconnaît donc moins par ses mots que par son rythme.
La ponctuation et la structure par famille
Les tournures ne sont qu’une moitié du signal : la ponctuation en est une autre. La matrice compare, pour quatre marques, chaque famille aux auteurs humains. Une flèche vers le haut signale un usage plus fréquent, une flèche vers le bas un usage plus rare, et le tiret l’absence de différence stable.
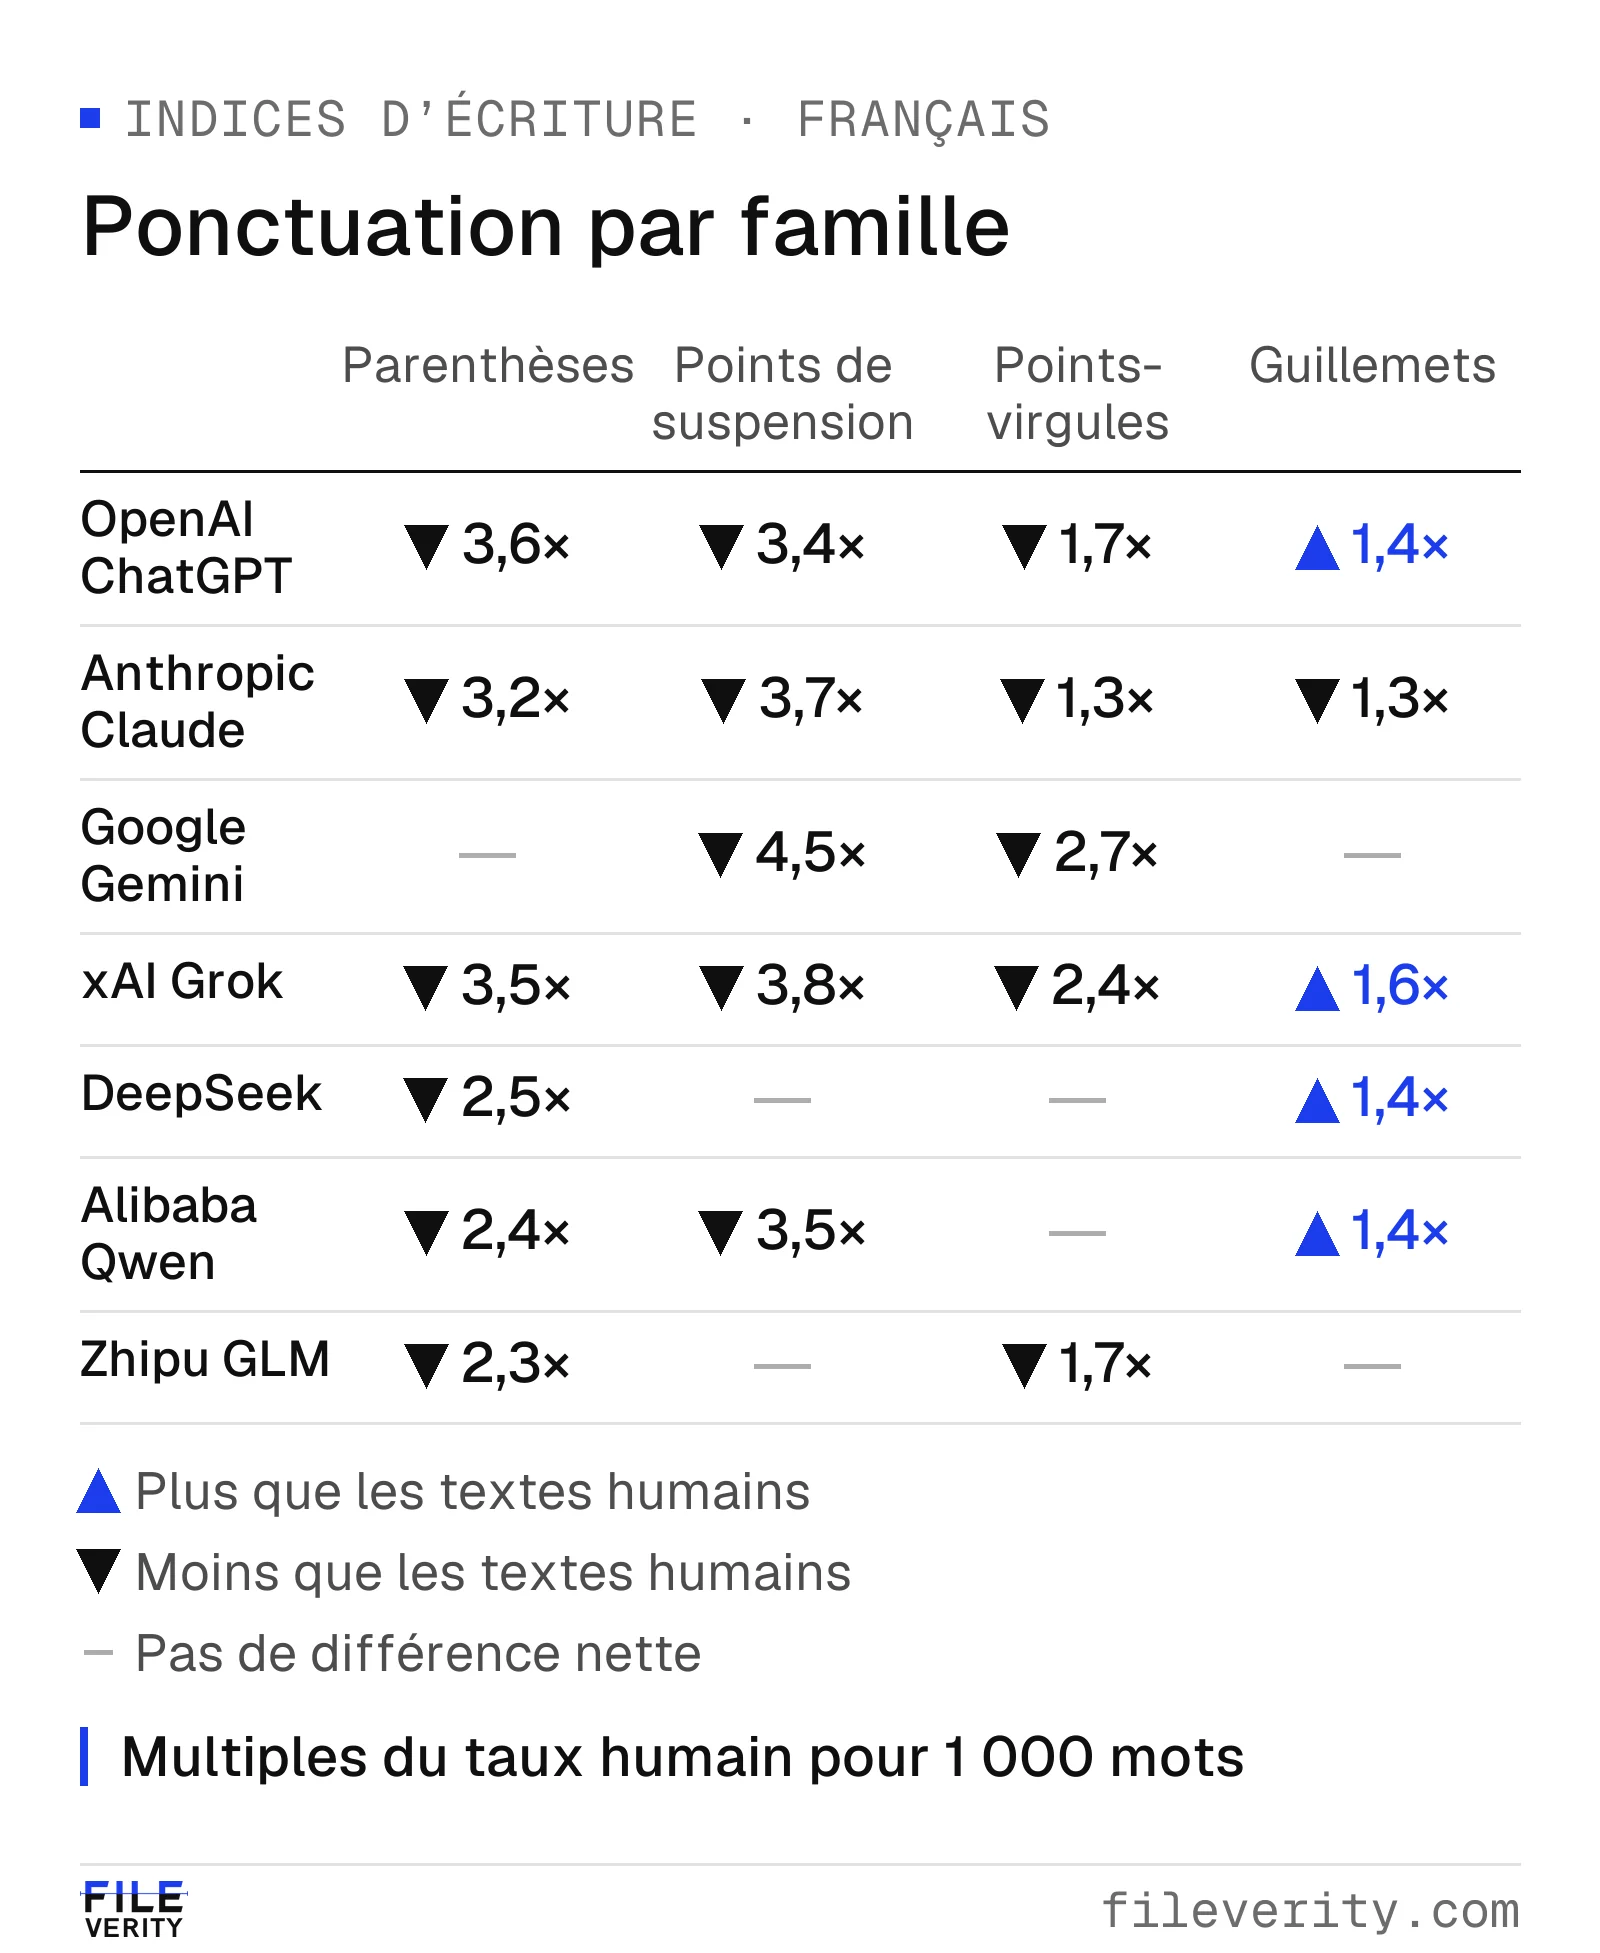
Presque toutes les familles écrivent moins de parenthèses et de points de suspension que les humains ; seuls les guillemets montent, chez quatre d’entre elles.
Le constat le plus régulier est une ponctuation plus sobre : moins de parenthèses et de points de suspension que dans l’écriture humaine, souvent moins de points d’exclamation, et des phrases plus uniformes. Les guillemets vont dans le sens inverse chez ChatGPT, Grok, DeepSeek et Qwen. Les tirets cadratins, très nets chez ChatGPT, ne ressortent de façon stable face aux humains que chez ChatGPT.
Ce que ces indices ne disent pas
Retenez quatre limites :
- une tournure isolée ne prouve rien : « repose sur » ou « au cœur de » figurent aussi dans des textes humains soignés ;
- une consigne de rédaction, une réécriture ou un mélange de modèles brouille ces habitudes ;
- ces écarts décrivent des familles, pas des versions précises, et ils évoluent à chaque génération de modèles ;
- la liste n’est pas un détecteur : compter les expressions d’un texte ne donne ni son origine ni un taux d’erreur connu.
Pourquoi Veread lit bien plus que des listes d’expressions
Veread 1.1, le modèle de détection de texte de Fileverity, n’applique pas de liste de mots. Il apprend, sur de très vastes jeux de données propriétaires et exclusifs, sélectionnés par des professionnels, comment les modèles écrivent dans leur ensemble : construction des phrases, rythme, enchaînement des idées, ponctuation et passages précis du texte. Un même modèle sert les sept langues.
Les chiffres de la page de fiabilité reposent sur cette lecture globale : 0,28 % de faux positifs sur des textes humains en sept langues, 98,6 % des textes entièrement rédigés par IA détectés et 94,9 % sur des modèles jamais vus pendant son développement. Les résultats par famille s’expriment en similarité de style d’écriture : ils indiquent de quelle famille le texte se rapproche, sans désigner son auteur. Pour savoir pourquoi aucune marque cachée ne remplace cette lecture, voyez Filigrane de texte IA : qui marque ses textes en 2026 ; pour les résultats détaillés, Détecteur de texte IA fiable : Veread.
Par Yang Zheng