Évaluer les outils de vérification
Filigrane de texte IA : qui marque ses textes en 2026 et ce que SynthID permet de vérifier
OpenAI, Anthropic, Google, xAI, DeepSeek : qui filigrane le texte IA, qui peut le vérifier, ce que dit l’article 50 de l’AI Act et ce qu’un filigrane prouve.
Publié le · Mis à jour le · 7 min de lecture
Dans cet article
Le 10 novembre 2026, aucun grand éditeur d’IA ne propose de vérificateur public de filigrane pour le texte. Plusieurs marquent pourtant leurs sorties, chacun avec sa clé, son périmètre et son cercle de vérificateurs agréés. Ce suivi, daté et sourcé, dit qui marque quoi, ce qu’un filigrane statistique prouve, ce qu’il ne prouve pas, et pourquoi la lecture du style reste la seule vérification ouverte à tous.
Si vous cherchez « quelle IA a écrit ce texte », retenez ceci : l’absence de filigrane détecté ne prouve jamais qu’un texte est humain, et sa présence ne se vérifie que chez l’éditeur. Pour un texte reçu, il faut un contrôle qui ne dépende d’aucune clé. Le détecteur de texte IA de Fileverity en est un : sur des textes humains en sept langues, 0,28 % ont été signalés à tort, et 98,6 % des textes entièrement rédigés par IA ont été détectés.
Qui marque les textes IA en novembre 2026
Le tableau compare les cinq éditeurs suivis par les détecteurs satellites de Fileverity. Chaque ligne est vraie au 10 novembre 2026 et renvoie, plus bas, à la page détaillée du site consacré à l’éditeur.
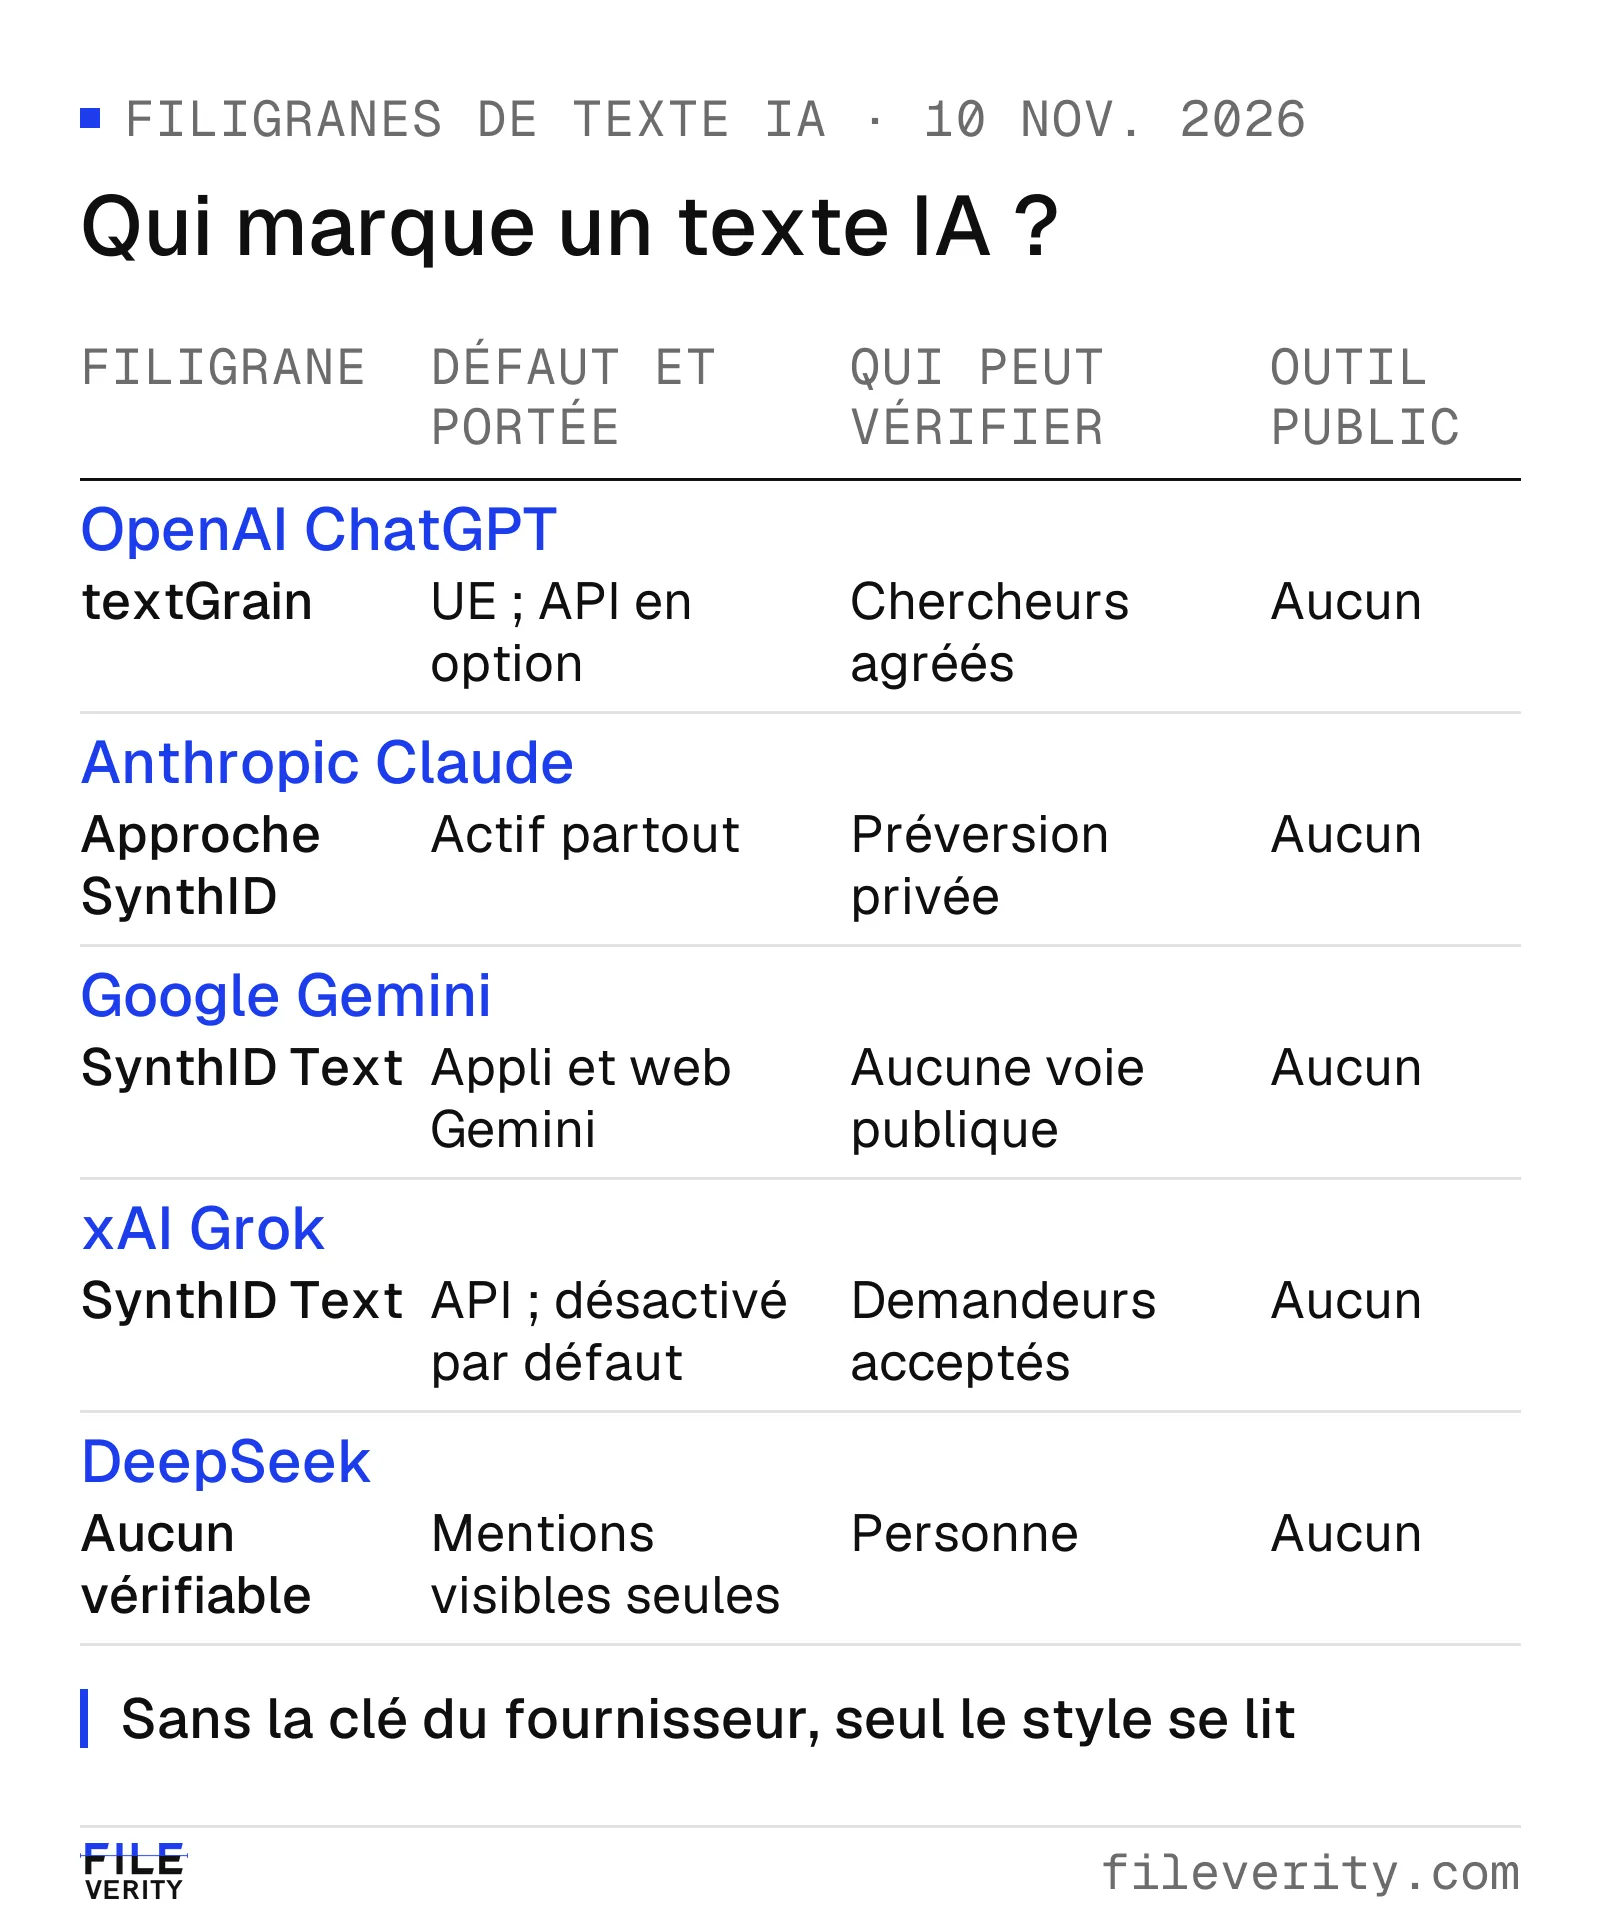
Aucun des cinq éditeurs ne propose d’outil public pour vérifier un texte : seul le style se lit sans leur clé.
OpenAI : textGrain, dans l’UE d’abord
OpenAI a annoncé textGrain le 5 octobre 2026. C’est un signal statistique invisible, glissé dans le choix des mots : le texte se lit de la même façon. Il est ajouté aux textes éligibles de ChatGPT et de Codex dans l’Union européenne, sur tous les abonnements, sans date de début précise publiée. Les clients de l’API peuvent l’activer, partout dans le monde, mais il reste désactivé par défaut. OpenAI a écrit qu’elle ne fait pas du filigrane de texte un réglage mondial par défaut au lancement : un texte ChatGPT produit hors de l’UE doit donc être considéré comme non marqué.
Le détecteur n’est pas public. L’accès se décide au cas par cas, d’abord pour des chercheurs agréés et des organisations expertes ; le contrôle de travaux d’étudiants est hors du champ du programme. Détail sur ChatGPTDetect : le filigrane de ChatGPT.
Anthropic : un filigrane de type SynthID-Text, dans le monde entier
Anthropic a publié son explication le 14 août 2026 et l’a mise à jour le 1er septembre. Le filigrane repose sur l’approche SynthID-Text, avec la clé propre d’Anthropic : rien n’est ajouté au texte, ni caractère caché ni jeton supplémentaire. L’éditeur l’applique dans le monde entier : les modèles lancés à partir du 2 août 2026 portent la marque dès leur sortie, et son tableau de couverture y ajoute désormais des modèles plus anciens. Il a signé en juillet 2026 le code de bonnes pratiques européen sur la transparence des contenus générés par IA.
La détection passe par une API en préversion privée, réservée à des organisations éligibles. Un particulier ne peut pas vérifier un texte, et Anthropic n’a publié ni taux d’erreur ni longueur minimale. L’éditeur précise lui-même qu’une marque détectée n’est pas totalement concluante et qu’elle ne distingue pas « Claude a écrit ceci » de « Claude a fortement retouché ceci ». Détail sur ClaudeDetect : le filigrane de Claude.
Google : SynthID Text dans Gemini, mais un détecteur public pour les médias seulement
Le 14 mai 2024, Google a annoncé que SynthID filigranerait le texte généré dans l’application et l’expérience web Gemini. Le SynthID Detector, ouvert à tous en anglais le 7 octobre 2026, vérifie des images, des vidéos et de l’audio : l’annonce ne mentionne pas le texte. SynthID Text existe aussi en open source, mais vérifier un texte exige la clé de celui qui l’a filigrané. Un développeur peut donc contrôler les textes de son propre modèle, pas ceux de Gemini.
Google reconnaît que le filigrane de texte est moins efficace sur les réponses à des questions factuelles et que les scores de confiance peuvent chuter après une réécriture importante ou une traduction. Détail sur GeminiDetect : SynthID et texte Gemini.
xAI : désactivé par défaut, activé par les administrateurs
D’après la documentation du fournisseur, mise à jour le 9 novembre 2026, le filigrane de texte de Grok est désactivé par défaut. Les administrateurs d’équipe l’activent modèle par modèle dans la Console ; il couvre le texte renvoyé par l’API, seule surface que la page décrit. Une réponse filigranée porte l’en-tête x-watermark: true. La détection est statistique, répond « filigrané », « non filigrané » ou « incertain », et n’est ouverte que sur demande.
La valeur par défaut a changé en quelques jours : des articles annonçaient une activation par défaut au 7 novembre, puis The New Stack a rapporté le 10 novembre un retour à « désactivé ». Toute affirmation « Grok filigrane tout » est périmée. Détail sur GrokDetect : le filigrane de Grok.
DeepSeek, Qwen et GLM : des mentions visibles, pas de filigrane vérifiable
DeepSeek n’a publié ni filigrane textuel invisible ni outil de vérification. Ses conditions d’utilisation (clause 5.3, page datée du 5 septembre 2025) indiquent qu’il ajoute dans sa plateforme des mentions rappelant que le contenu est généré par IA, et interdisent de les retirer. Les mesures chinoises de marquage des contenus générés par IA s’appliquent depuis le 1er septembre 2025, avec la norme nationale GB 45438-2025. Ces dates viennent de sources secondaires, et le texte officiel d’origine n’a pas été relu. Pour Qwen et GLM, aucune déclaration d’éditeur sur un filigrane n’a été trouvée au 10 novembre 2026.
Ces mentions entourent le texte ou vivent dans le fichier : copier du texte brut hors d’une fenêtre de chat les laisse derrière. Détail sur DeepSeekDetect : le filigrane de DeepSeek.
Ce que l’article 50 du règlement européen sur l’IA change
L’article 50 du règlement européen sur l’IA impose aux fournisseurs de systèmes qui génèrent du texte de marquer leurs sorties dans un format lisible par machine. Le code de bonnes pratiques sur la transparence des contenus générés par IA précise la mise en œuvre. C’est ce cadre qu’invoquent les éditeurs : l’aide d’OpenAI rattache textGrain au règlement et au code de bonnes pratiques, et Anthropic applique son filigrane dans le monde entier pour s’y conformer.
Le résultat est une obligation de marquer, pas un droit de vérifier : le règlement ne crée aucun détecteur public. Un enseignant, un recruteur ou une rédaction qui reçoit un texte n’a donc pas plus de moyens qu’avant, et l’absence de marque ne dit rien sur l’auteur.
Comment fonctionne un filigrane statistique de texte
Un modèle de langage choisit chaque mot parmi des milliers de candidats. Le filigrane dérive de la clé secrète et des mots précédents un score pour chaque candidat, puis infléchit légèrement le tirage vers les mieux notés. Le texte se lit normalement. Celui qui détient la clé recalcule ces scores sur un texte : si les mots choisis sont trop souvent bien notés, c’est un signe de marquage. Le résultat est une probabilité, pas un verdict.
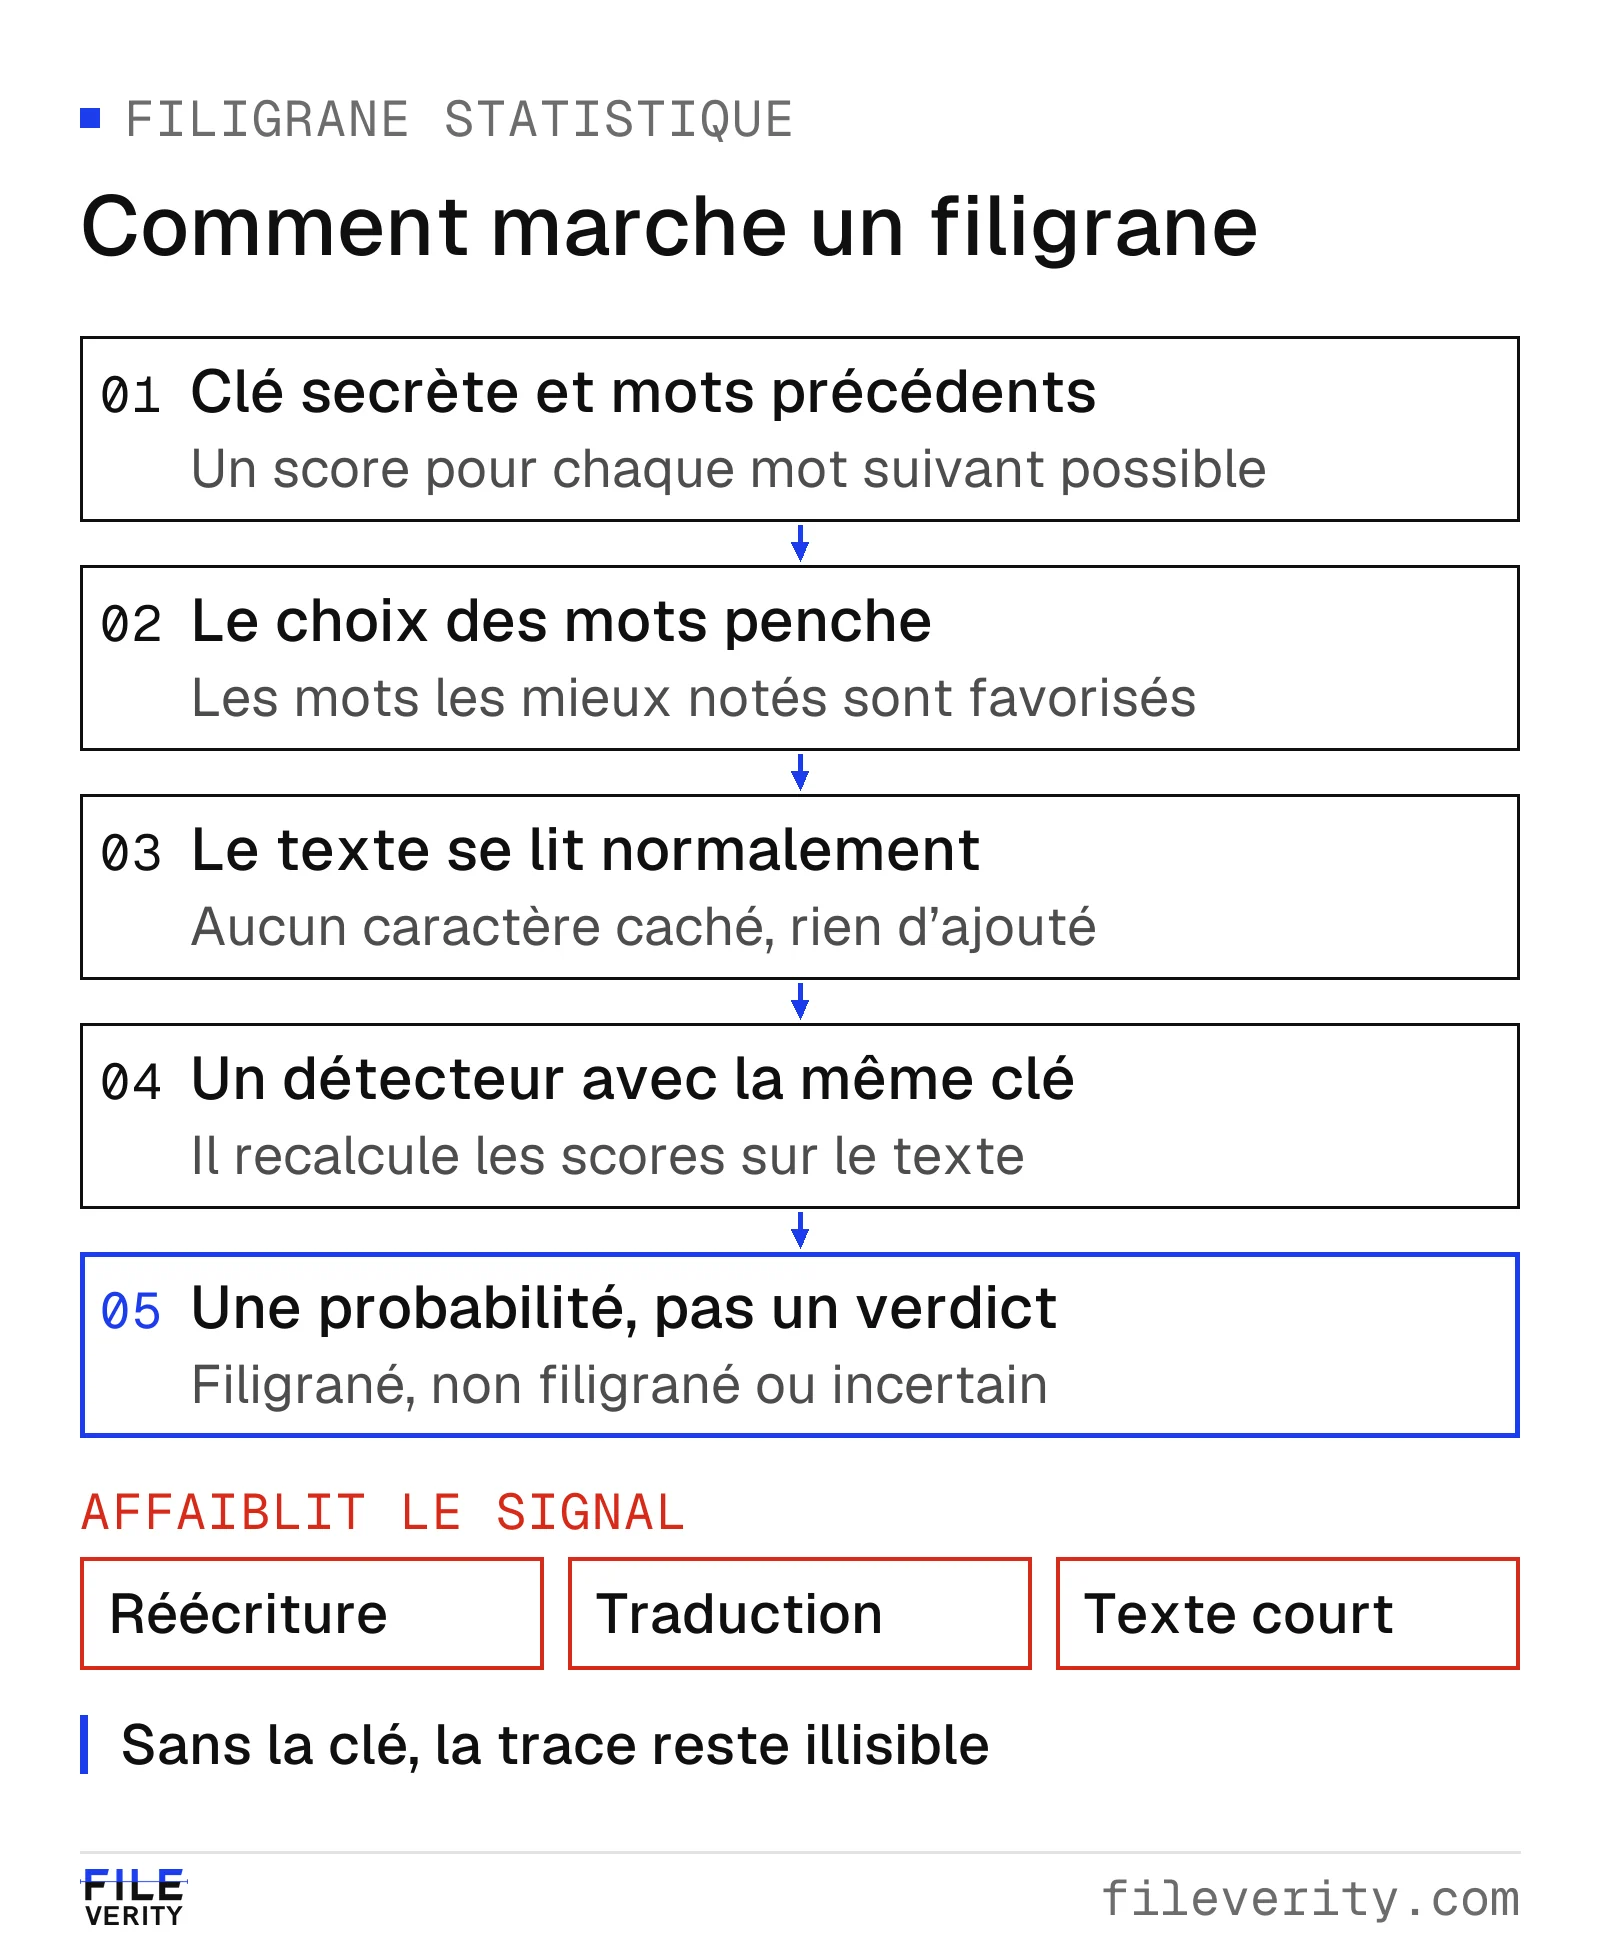
Sans la clé, la trace reste illisible : le filigrane se calcule, il ne se voit pas.
La réécriture, la traduction et la brièveté affaiblissent le signal : il y a moins de choix de mots à compter, ou ils ont changé. C’est ce que reconnaissent Google pour les réécritures importantes et les traductions, et Anthropic pour les échantillons courts.
Ce qu’un filigrane peut et ne peut pas prouver
Un filigrane détecté indique qu’un système donné a produit ou fortement retouché le texte. Il ne prouve ni l’intention ni la part de l’outil dans le texte, et aucun éditeur ne le présente comme une preuve à lui seul. L’absence de filigrane est encore plus faible : elle est compatible avec un texte humain, avec un modèle qui ne marque pas, avec une version de l’outil sans marquage, avec un texte réécrit ou retapé.
Retenez trois conséquences pratiques :
- un texte sans marque ne se classe pas « humain » pour autant ;
- un texte marqué ne se vérifie que par l’éditeur ou un organisme agréé ;
- un texte copié depuis une conversation perd souvent les mentions visibles qui l’entouraient.
Pourquoi le style reste le seul contrôle ouvert à tous
Un détecteur fondé sur le style n’a besoin d’aucune clé : il lit la manière dont le texte est écrit et estime s’il ressemble à une rédaction par IA. Anthropic lui-même présente cette méthode comme fondamentalement différente d’une vérification de filigrane. Elle fonctionne sur un texte collé, que le moindre marquage ait survécu ou non. L’extension Chrome de Fileverity applique la même lecture au texte d’une page web ou d’un document Google Docs, sans copier-coller.
C’est le rôle de Veread 1.1, le modèle de Fileverity : 0,28 % de faux positifs sur des textes humains en sept langues et 98,6 % des textes entièrement rédigés par IA détectés, dont 94,9 % sur des modèles jamais vus pendant son développement. Le résultat reste un indice, jamais une preuve de qui a écrit le texte : il dit où regarder et quoi confirmer auprès de l’auteur. Pour voir sur quoi s’appuie le style de chaque famille de modèles, lisez Quelle IA a écrit ce texte ? Les tournures de ChatGPT, Claude, Gemini, Grok et DeepSeek, et pour la fiabilité détaillée, Détecteur de texte IA fiable : Veread.
Par Yang Zheng