Évaluer les outils de vérification
Détecteur de texte IA fiable : Veread 1.1, 98,6 % détectés et 0,28 % de faux positifs
Veread 1.1 détecte 98,6 % des textes entièrement rédigés par IA pour 0,28 % de faux positifs. Résultats par langue, type de texte et modèle, en sept langues.
Publié le · Mis à jour le · 10 min de lecture
Dans cet article
Veread 1.1, le détecteur de texte IA de Fileverity, a détecté 98,6 % des textes entièrement rédigés par IA avec 0,28 % de faux positifs : seuls 0,28 % des textes rédigés par des personnes ont reçu un constat IA, sur sept langues. Sur des textes issus de modèles d’IA jamais utilisés pendant son développement, il en détecte tout de même 94,9 %, et son AUROC atteint 0,999 sur les documents complets.
Pour les équipes qui cherchent un détecteur de texte IA fiable, ce rapport donne le tableau de bord complet : faux positifs par langue et par type de texte, détection par langue, par type de texte et par famille de modèles, résultats sur les documents prolongés ou réécrits par IA, et résultats sur les extraits courts. La détection est mesurée sur un jeu de test réservé ; les faux positifs, sur toute l’écriture humaine réservée, panels humains indépendants compris.
Version du modèle : Veread 1.1, release 2026.11. Veread est le modèle de détection de texte développé par Fileverity. Il est développé et validé sur des données massives, exclusives, propriétaires et sélectionnées par des professionnels, et un seul modèle sert les sept langues. Les résultats ci-dessous sont ceux de Veread 1.1, en production depuis le 18 novembre 2026 ; l’annonce de la version en présente le détail.
Détecteur de texte IA fiable : le tableau de bord complet
| Mesure | Résultat | Ce qu’elle vous apprend |
|---|---|---|
| Textes rédigés par des personnes recevant un constat IA | 0,28 % | Le taux de faux positifs sur les sept langues |
| Textes entièrement rédigés par IA détectés | 98,6 % | Part des textes écrits de bout en bout par un modèle d’IA que Veread a identifiés |
| Tous les textes rédigés ou assistés par IA détectés | 95,9 % | Textes entièrement rédigés, prolongés, réécrits et retouchés, pris ensemble |
| Textes issus de modèles d’IA jamais utilisés pendant le développement | 94,9 % | Détection sur des modèles que Veread n’avait jamais vus |
| AUROC, documents complets | 0,999 | À quel point textes humains et textes IA se séparent, quel que soit le point de décision |
| AUROC, extraits courts | 0,996 | La même séparation pour des extraits d’environ 100 mots |
Les mesures de détection ont été prises sur un jeu de test réservé, jamais utilisé pour l’entraînement, le choix du modèle ni les réglages de décision. Les faux positifs sont mesurés sur toute l’écriture humaine réservée : ce jeu de test et des panels humains indépendants, issus de sources jamais utilisées pour l’entraînement. Les textes font environ 100 mots ou plus, et Veread a été exécuté avec ses réglages de production. L’AUROC est une autre mesure que la part de textes bien classés : elle indique dans quelle mesure les scores séparent l’écriture humaine de l’écriture IA, quel que soit le point de décision retenu.
Faux positifs d’un détecteur IA : moins de 0,5 % dans les sept langues
Un faux positif est un texte rédigé par une personne qui reçoit un constat IA. Pour une école, un éditeur ou un service sinistres, ce taux est un critère important pour évaluer un détecteur. Veread affiche 0,28 % au global et 0,23 % sur les documents complets, et chacune des sept langues reste sous 0,5 %.
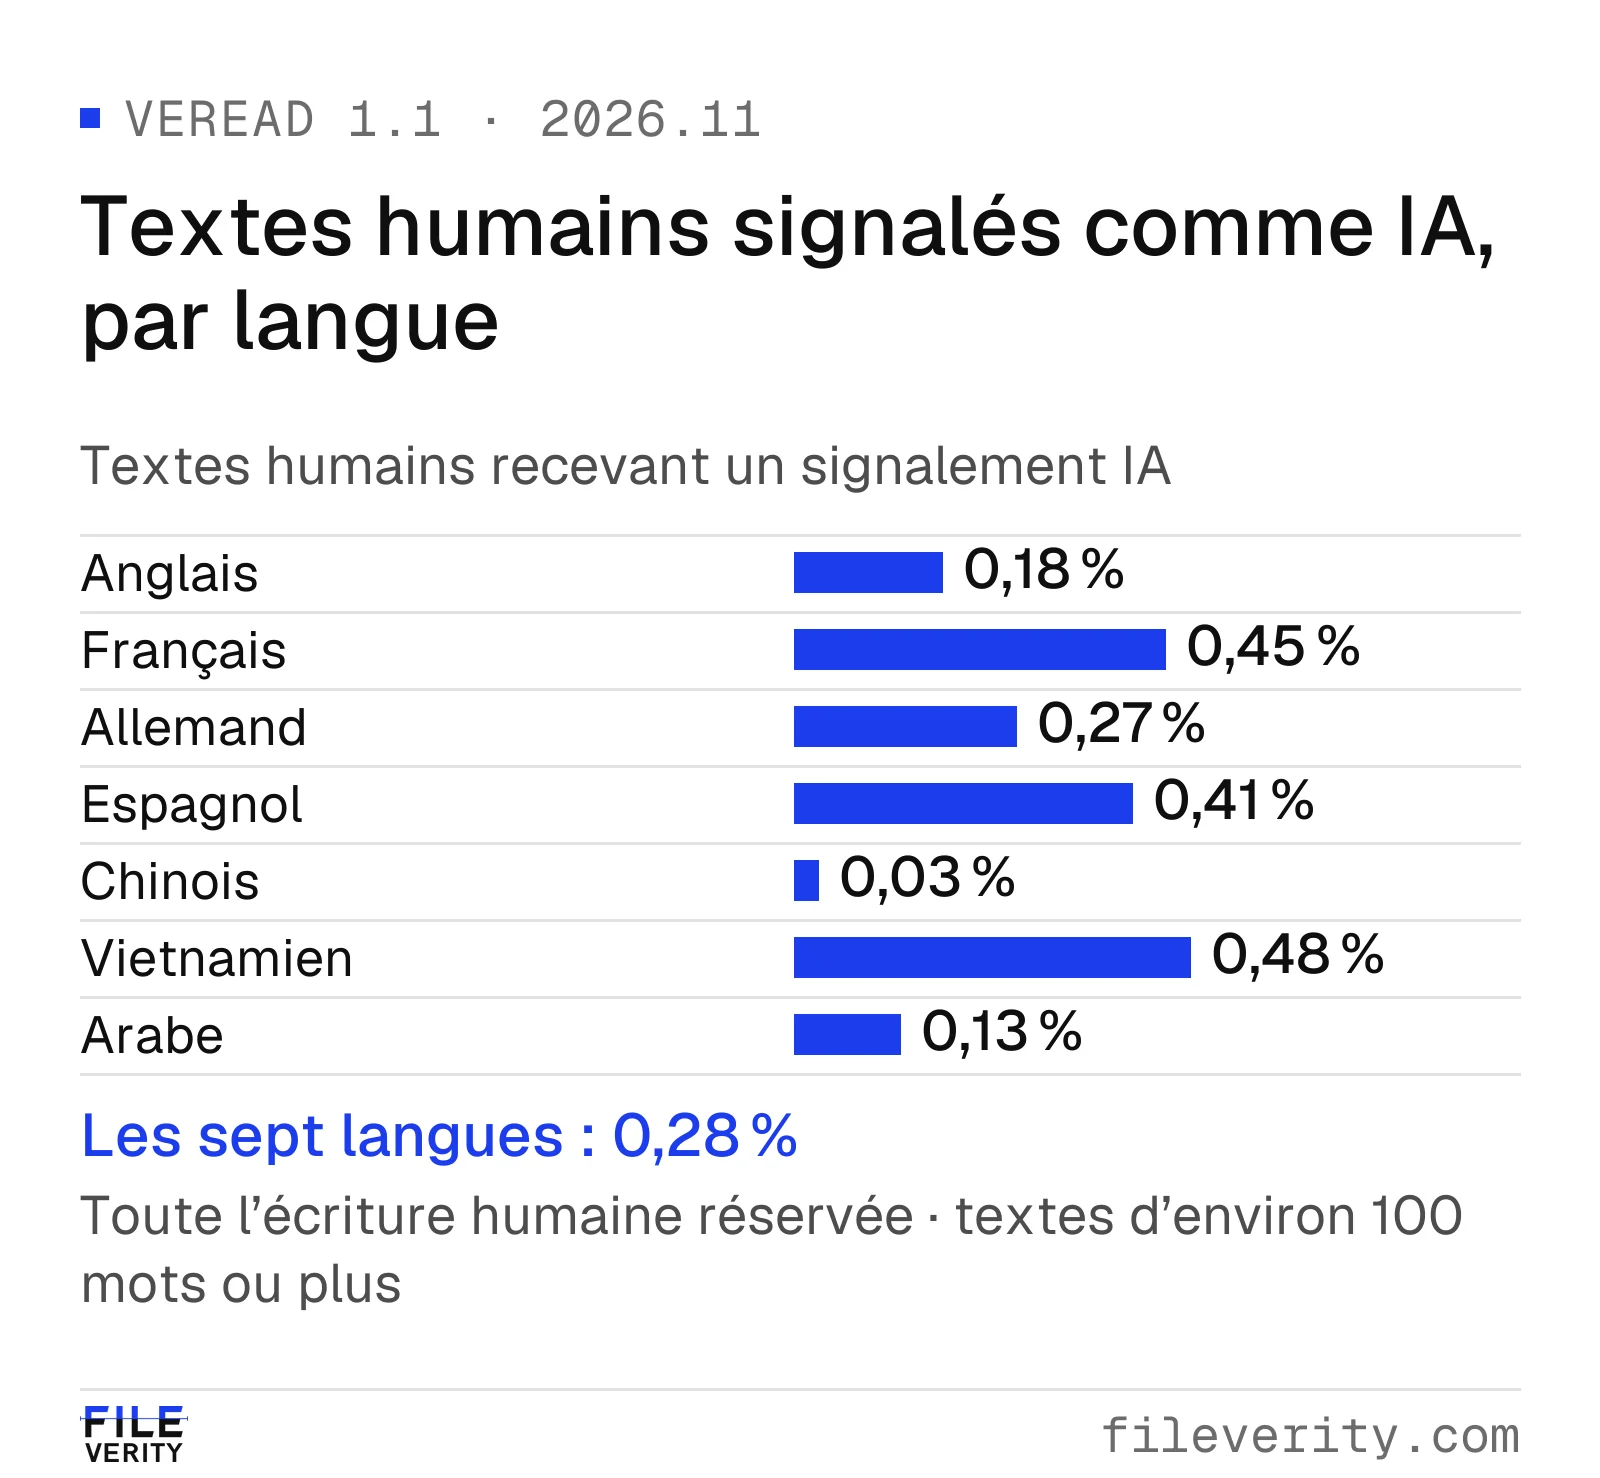
Textes rédigés par des personnes, d’environ 100 mots ou plus. Évaluation Fileverity · toute l’écriture humaine réservée, panels indépendants compris · Veread 1.1 · 2026.11.
| Langue | Texte humain avec constat IA | Texte entièrement rédigé par IA détecté | Tous textes rédigés ou assistés par IA détectés | AUROC |
|---|---|---|---|---|
| Anglais | 0,18 % | 95,1 % | 94,5 % | 0,9998 |
| Français | 0,45 % | 99,1 % | 96,8 % | 0,9991 |
| Allemand | 0,27 % | 100 % | 94,1 % | 0,9995 |
| Espagnol | 0,41 % | 100 % | 96,0 % | 0,9995 |
| Chinois | 0,03 % | 100 % | 98,8 % | 1,000 |
| Vietnamien | 0,48 % | 95,5 % | 92,8 % | 0,9919 |
| Arabe | 0,13 % | 98,5 % | 97,5 % | 0,9999 |
Une détection élevée dans chaque langue
Les faux positifs vont de 0,03 % à 0,48 % selon la langue. Côté détection, l’allemand, l’espagnol et le chinois atteignent 100 % des textes entièrement rédigés par IA, le français 99,1 % et l’arabe 98,5 %. Chaque langue dépasse 95 %. Si votre équipe examine des textes dans plusieurs langues, vous disposez d’un seul modèle et d’un seul jeu de résultats mesurés, au lieu d’un outil distinct par marché.
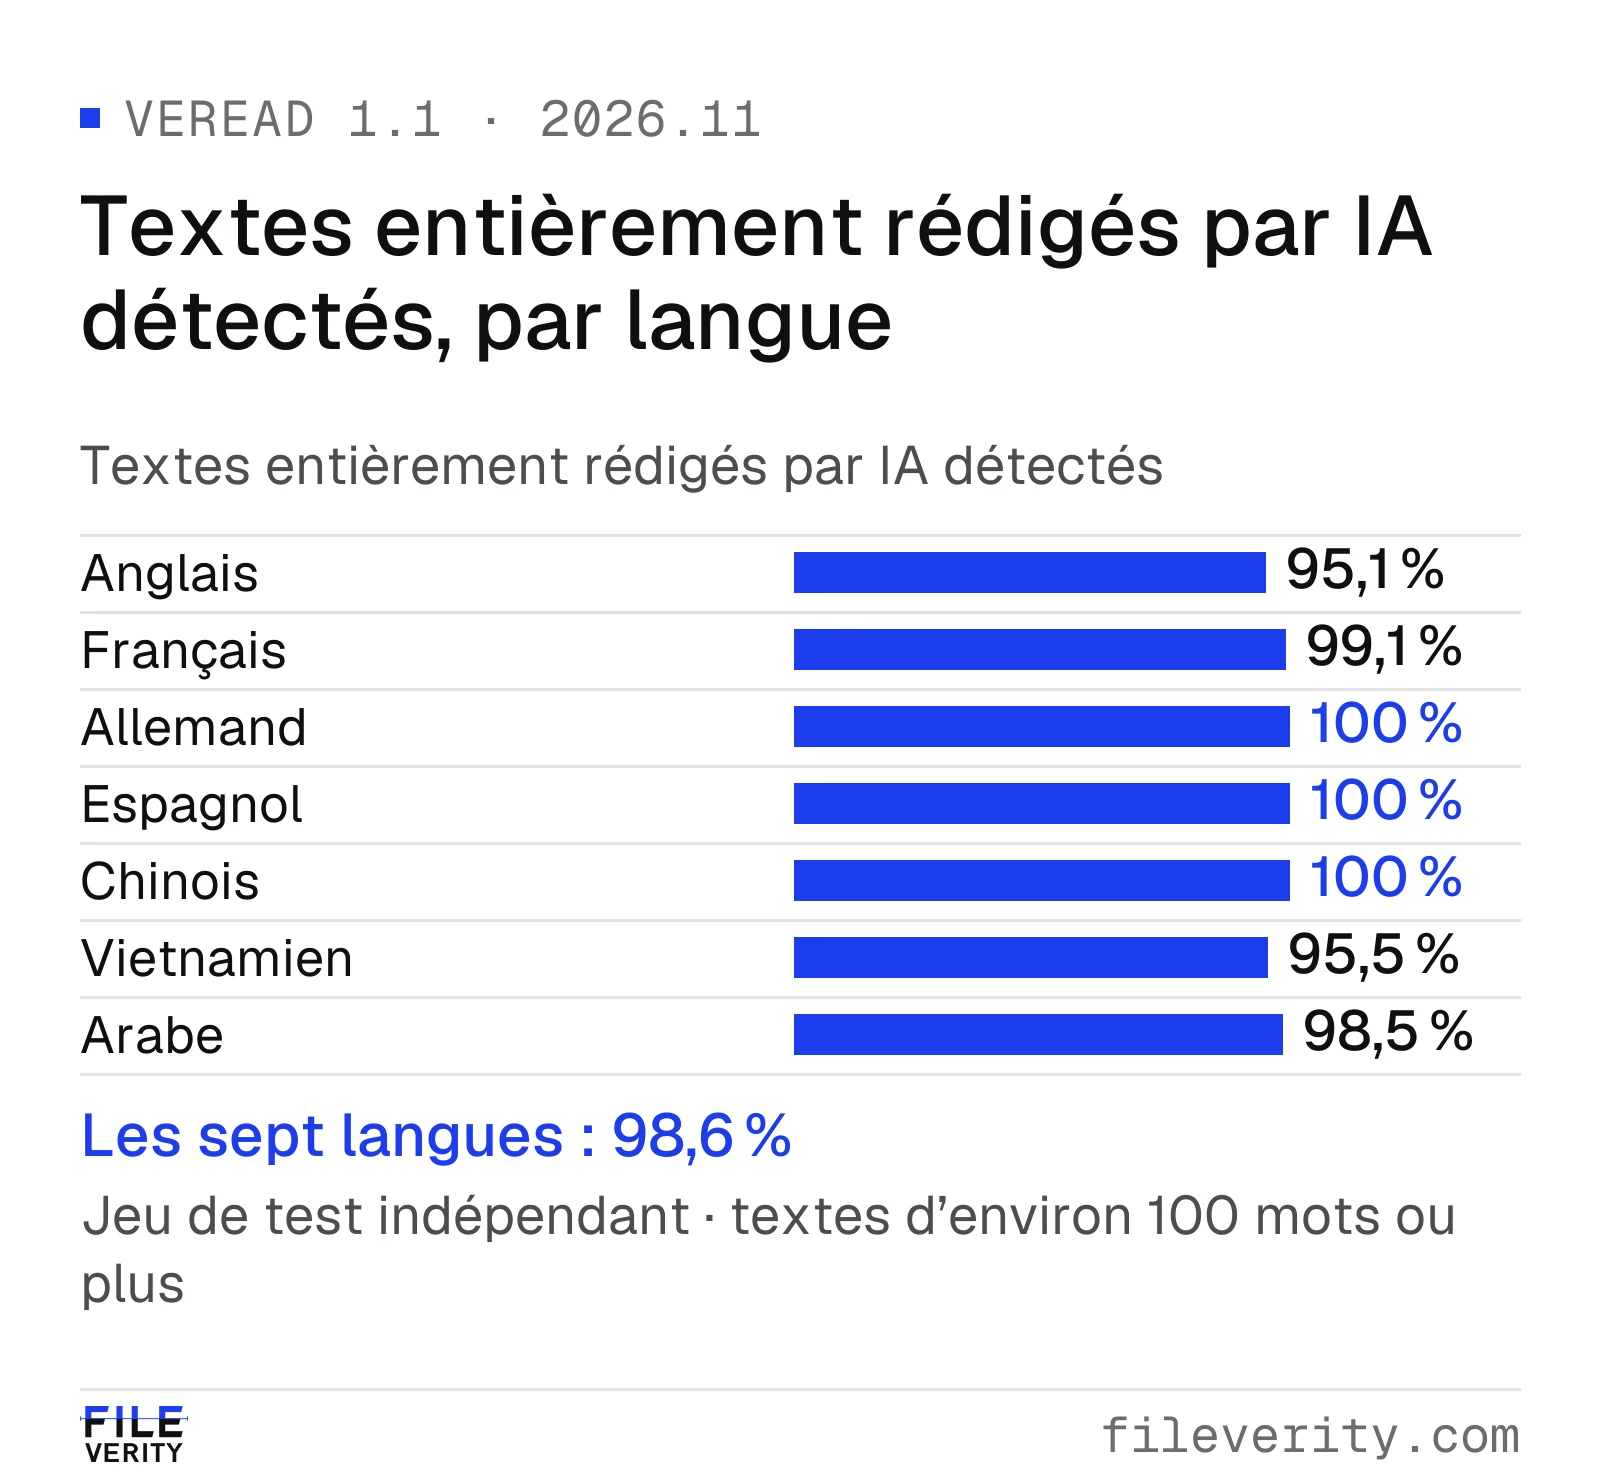
Textes entièrement rédigés par IA. Toutes langues confondues : 98,6 %. Évaluation Fileverity · jeu de test réservé · Veread 1.1 · 2026.11.
Faux positifs du détecteur IA par type de texte
Le style d’écriture change le comportement des détecteurs : nous avons donc mesuré chaque type de texte séparément. Chaque type de texte reste sous 1 % de faux positifs, et les textes encyclopédiques (0,04 %) comme la littérature et l’écriture créative (0,08 %) affichent les taux les plus bas.
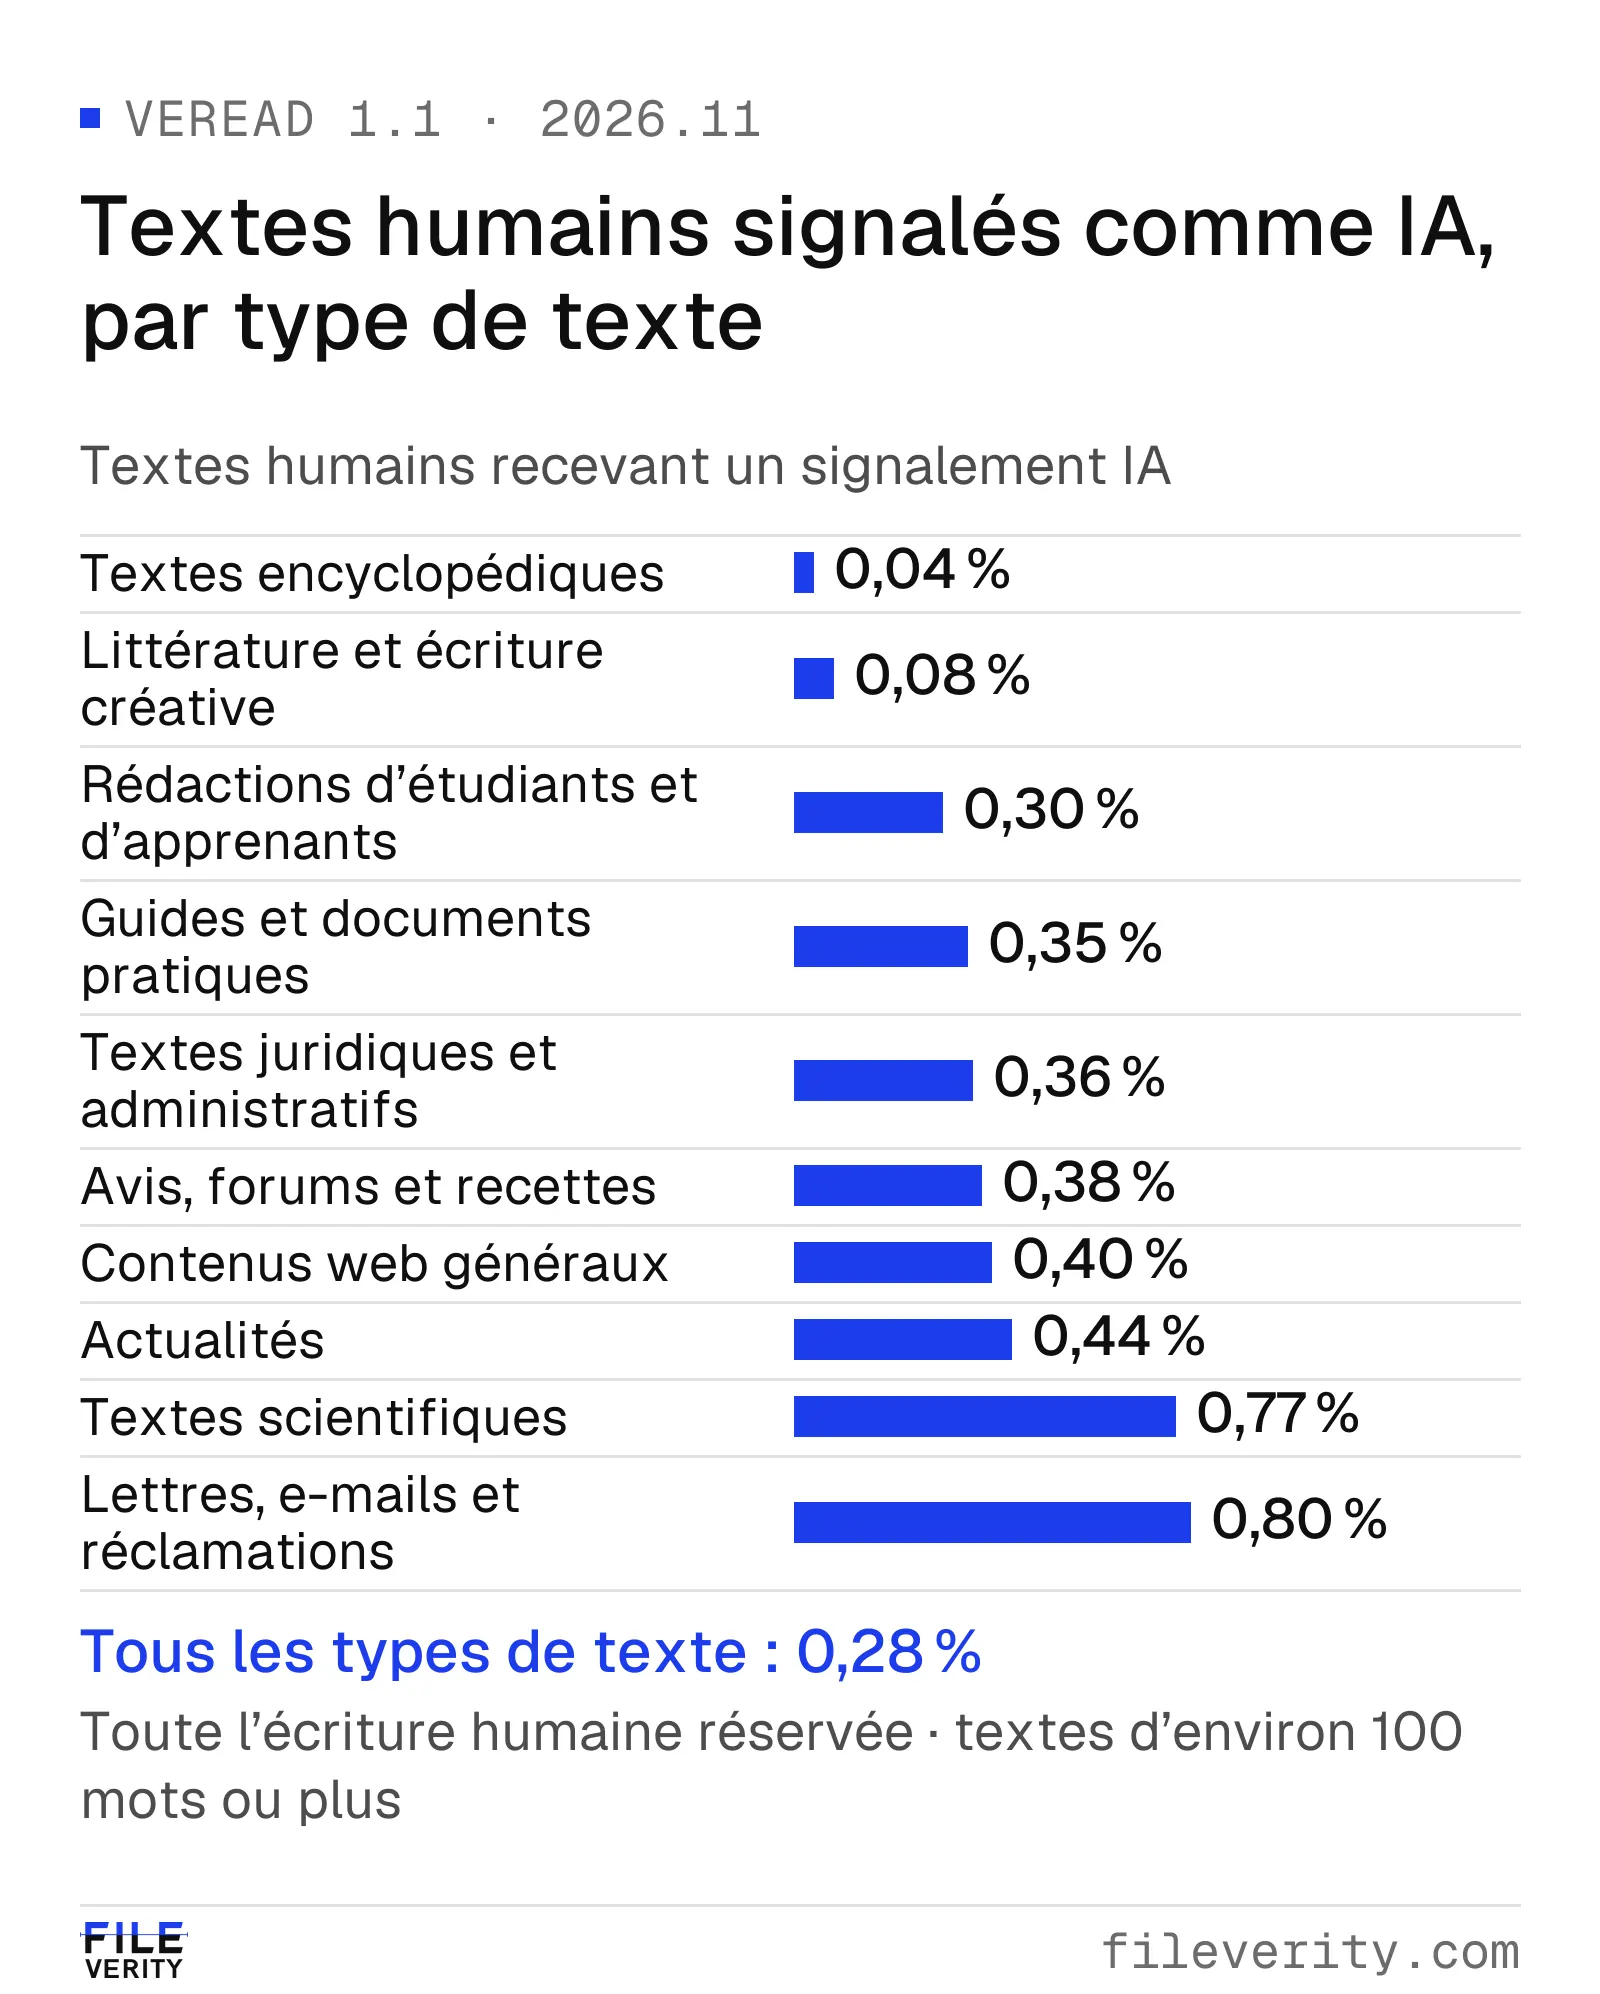
Ensemble des types de texte : 0,28 %. Évaluation Fileverity · toute l’écriture humaine réservée, panels indépendants compris · Veread 1.1 · 2026.11.
| Type de texte | Texte humain avec constat IA | Tous textes rédigés ou assistés par IA détectés |
|---|---|---|
| Textes encyclopédiques | 0,04 % | 95,3 % |
| Littérature et écriture créative | 0,08 % | 93,9 % |
| Rédactions d’étudiants et d’apprenants en langue | 0,30 % | 99,1 % |
| Tutoriels et documents pratiques | 0,35 % | 97,3 % |
| Textes juridiques et administratifs | 0,36 % | 92,3 % |
| Avis, forums et recettes | 0,38 % | 95,1 % |
| Contenus web généralistes | 0,40 % | 97,4 % |
| Actualités | 0,44 % | 94,9 % |
| Textes universitaires et scientifiques | 0,77 % | 100 % |
| Lettres, courriels et réclamations | 0,80 % | 100 % |
Détection par type de texte
Pour les textes rédigés ou assistés par IA, la détection atteint 100 % sur les textes universitaires et scientifiques ainsi que sur les lettres, courriels et réclamations. Chaque type de texte reste à 92,3 % ou plus.
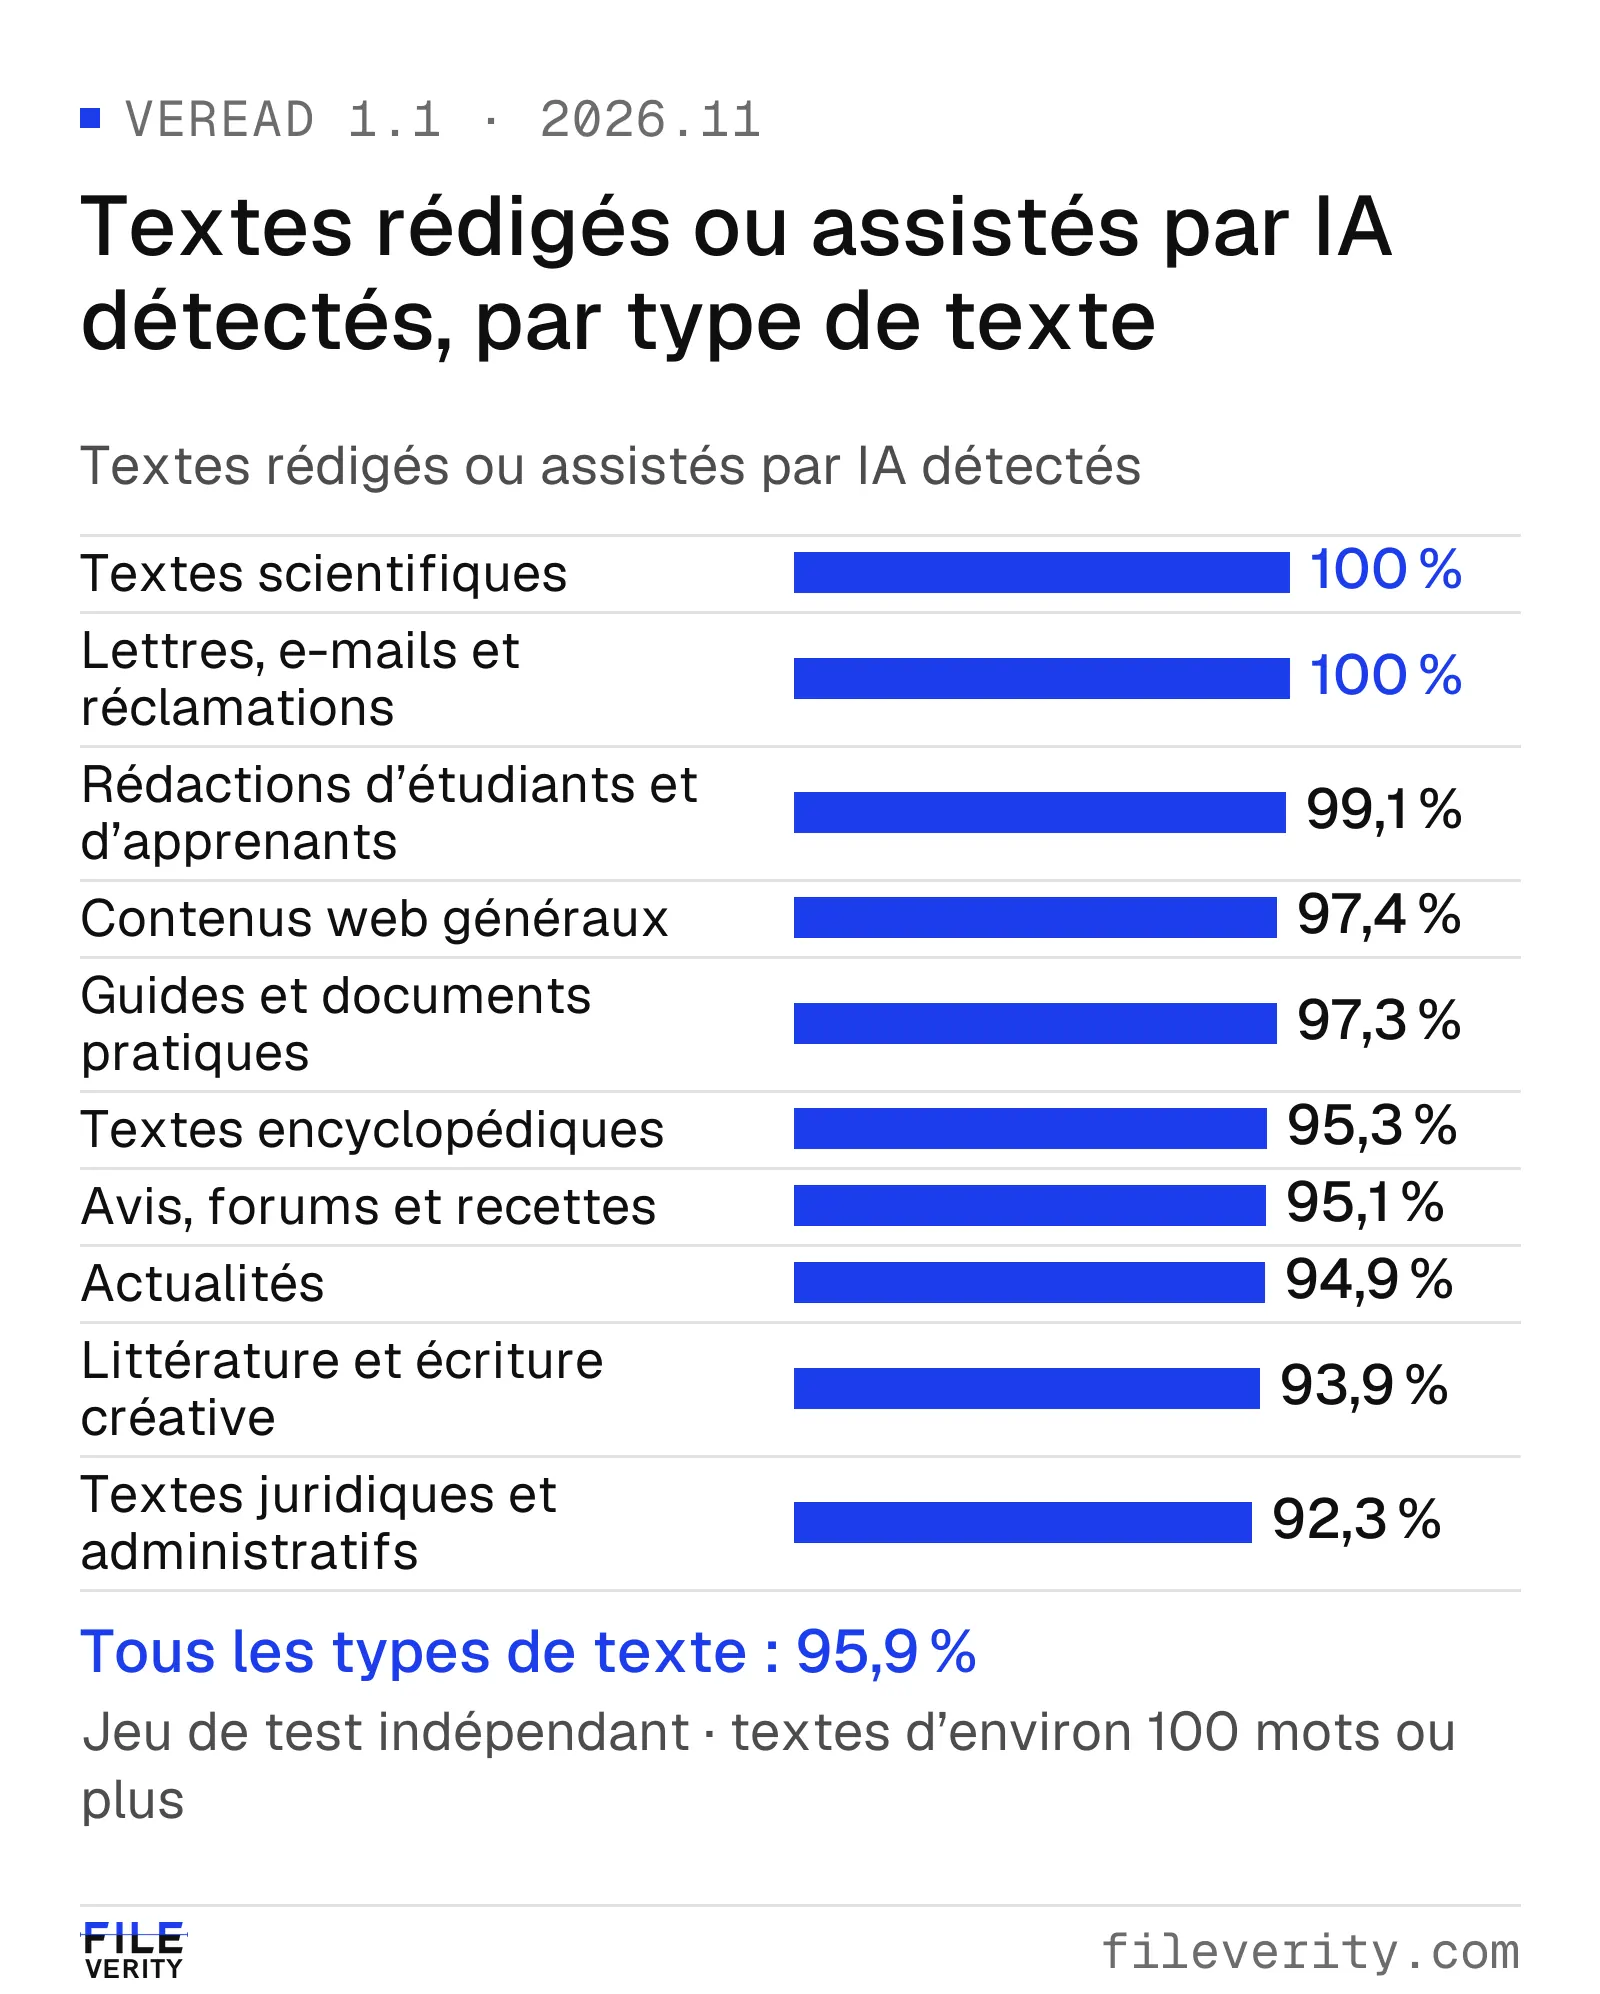
Textes entièrement rédigés, prolongés, réécrits et retouchés par IA. Ensemble des types de texte : 95,9 %. Évaluation Fileverity · jeu de test réservé · Veread 1.1 · 2026.11.
L’écriture des étudiants et des apprenants en langue
Les étudiants et les rédacteurs non natifs écrivent souvent dans un style simple et régulier, et l’équité envers eux compte pour toute école, université ou entreprise qui contrôle des dossiers. Dans cette évaluation, les rédactions d’étudiants et d’apprenants en langue ont reçu 0,30 % de faux positifs, tout en affichant une détection de 99,1 % des textes rédigés ou assistés par IA.
Détection par famille de modèles
Veread a été évalué sur des textes issus des grands développeurs d’IA, modèles actuels compris. Les modèles d’OpenAI, d’Alibaba, de Meta, de Mistral et de xAI sont détectés à 100 %, Anthropic à 97,9 %.
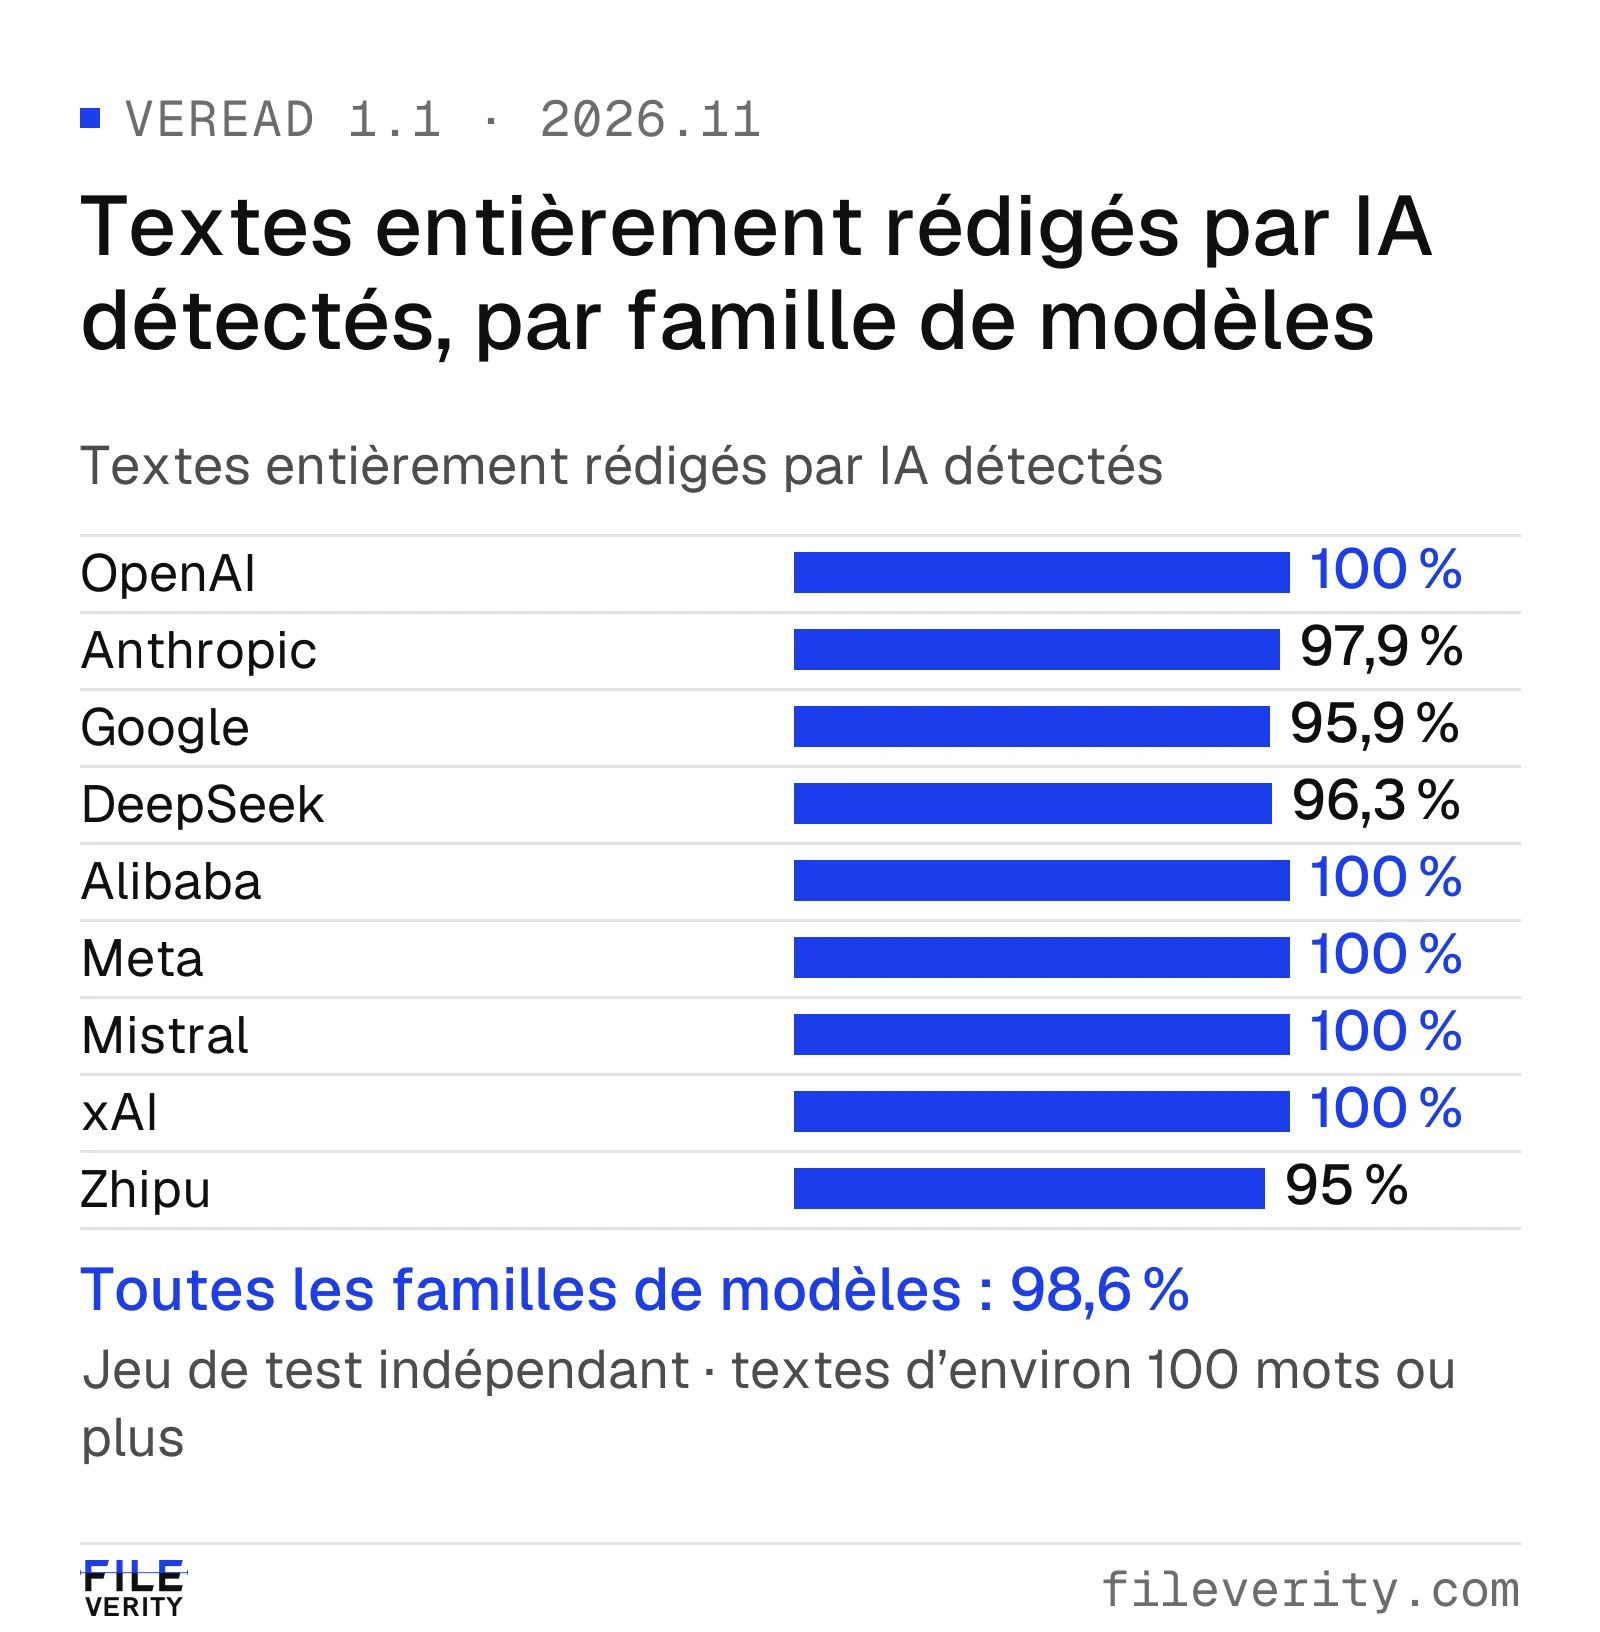
Textes entièrement rédigés par IA. Toutes familles confondues : 98,6 %. Évaluation Fileverity · jeu de test réservé · Veread 1.1 · 2026.11.
| Famille de modèles | Texte entièrement rédigé par IA détecté |
|---|---|
| OpenAI (GPT) | 100 % |
| Anthropic (Claude) | 97,9 % |
| Google (Gemini) | 95,9 % |
| DeepSeek | 96,3 % |
| Alibaba | 100 % |
| Meta | 100 % |
| Mistral | 100 % |
| xAI (Grok) | 100 % |
| Zhipu (GLM) | 95,0 % |
Les développeurs plus récents, comme Moonshot (Kimi), ByteDance, Tencent et MiniMax, entrent eux aussi dans le périmètre de couverture continue de Fileverity. Le résultat d’ensemble se maintient sur des modèles que Veread n’avait jamais vus pendant son développement : 94,9 % de leurs textes ont été détectés, la mesure à regarder lorsque de nouveaux modèles apparaissent plus vite que les détecteurs ne sont mis à jour.
Documents prolongés ou réécrits par IA
Les dossiers réels sont rarement de la pure sortie machine. Un rédacteur peut laisser une IA prolonger un brouillon, ou lui demander de réécrire un paragraphe humain.
| Type de document | Détectés |
|---|---|
| Documents rédigés par des personnes et prolongés par IA | 94,3 % |
| Documents rédigés par des personnes et réécrits par IA | 92,8 % |
| Tous les textes rédigés ou assistés par IA : entièrement rédigés, prolongés, réécrits et retouchés | 95,9 % |
Veread détecte l’intervention de l’IA sur toute cette étendue, et pas seulement sur les textes produits d’un seul jet ; son rapport de document indique quels passages portent le constat.
Extraits courts et documents complets
Veread lit les textes à partir d’environ 100 mots et répond en quelques secondes.
| Entrée | Texte humain avec constat IA | Texte rédigé ou assisté par IA détecté | AUROC |
|---|---|---|---|
| Documents complets | 0,23 % | 96,8 % | 0,999 |
| Extraits courts d’environ 100 mots | 1,4 % | 94,1 % | 0,996 |
Sur des documents complets, les faux positifs tombent à 0,23 %. Les textes courts tiennent aussi : dès environ 100 mots, 94,1 % des textes rédigés ou assistés par IA sont détectés, avec un AUROC de 0,996. Un simple paragraphe collé donne déjà un signal exploitable.
Ce qui a été testé
- Un jeu de test réservé, jamais utilisé pour l’entraînement, le choix du modèle ni les réglages de décision, pour la détection.
- Pour les faux positifs, toute l’écriture humaine réservée : ce jeu de test et des panels humains indépendants, issus de sources jamais utilisées pour l’entraînement.
- Sept langues : français, anglais, allemand, espagnol, chinois, vietnamien et arabe.
- De nombreux types de textes, des lettres et textes juridiques aux actualités, à l’écriture universitaire et aux contenus web généralistes.
- Des textes entièrement rédigés, prolongés, réécrits et retouchés par IA, issus des grands développeurs d’IA, modèles actuels et modèles jamais utilisés pendant le développement compris.
- Les réglages de décision de production de Veread, ceux qu’emploie un client, fixés avant l’évaluation.
Veread est développé sur des données massives, exclusives, propriétaires et sélectionnées par des professionnels.
Comment utiliser ces résultats
Partez du chiffre qui correspond à votre risque. Une école ou une équipe RH regardera d’abord les faux positifs sur l’écriture humaine et sur les rédactions d’apprenants. Un éditeur ou une équipe de confiance et sécurité regardera la détection par famille de modèles et sur les modèles inconnus. Une équipe qui traite des documents mixtes regardera les résultats sur les textes prolongés et réécrits.
Un résultat Veread est un indice à soumettre à une relecture humaine, qui n’établit pas qui a rédigé le texte ; toute décision concernant une personne exige une revue humaine. Utilisez le détecteur de texte IA pour contrôler un texte, ou lancez un rapport de document complet lorsque vous avez aussi besoin des métadonnées, des révisions et des signatures. Pour un texte que vous lisez en ligne ou dans Google Docs, l’extension Chrome de Fileverity utilise le même modèle Veread et affiche les passages signalés dans le panneau latéral. La page de fiabilité de l’analyse documentaire liste les mesures principales, et Choisir une API de détection d’IA traite de l’intégration.
Questions sur les résultats
Quelle est la fiabilité du détecteur de texte IA Veread ?
Veread 1.1 a détecté 98,6 % des textes entièrement rédigés par IA et 95,9 % de tous les textes rédigés ou assistés par IA sur un jeu de test réservé, tandis que 0,28 % des textes rédigés par des personnes ont reçu un constat IA, mesurés sur toute l’écriture humaine réservée. L’AUROC atteint 0,999 sur les documents complets et 0,996 sur les extraits courts.
Quel est le taux de faux positifs de ce détecteur d’IA ?
Sur sept langues, 0,28 % des textes rédigés par des personnes ont reçu un constat IA, et 0,23 % sur les documents complets. Selon la langue, le taux va de 0,03 % à 0,48 %, et chaque type de texte reste sous 1 %.
Veread fonctionne-t-il pour la détection de texte IA multilingue ?
Oui. Un seul modèle couvre le français, l’anglais, l’allemand, l’espagnol, le chinois, le vietnamien et l’arabe, et chaque langue a été mesurée séparément. La détection des textes entièrement rédigés par IA atteint 100 % en allemand, en espagnol et en chinois, 99,1 % en français et 98,5 % en arabe.
Détecte-t-il les textes des modèles d’IA récents ?
Veread a détecté 94,9 % des textes issus de modèles d’IA jamais utilisés pendant son développement, et sa couverture comprend les modèles OpenAI, Anthropic, Google, DeepSeek, Alibaba, Meta, Mistral, xAI et Zhipu.
Détecte-t-il les textes réécrits ou prolongés par IA ?
Oui. Veread a détecté 92,8 % des documents rédigés par des personnes puis réécrits par IA, et 94,3 % de ceux prolongés par IA.
Signale-t-il les étudiants et les rédacteurs non natifs ?
Dans cette évaluation, les rédactions d’étudiants et d’apprenants en langue ont reçu 0,30 % de faux positifs, et 99,1 % des rédactions rédigées ou assistées par IA ont été détectées.
Par Yang Zheng