Évaluer les outils de vérification
Comment fonctionne un détecteur de plagiat : ce qu’il trouve, ce qu’il ne voit pas et comment lire le résultat
Recherche sur le web et Wikipédia, alignement mot à mot, part de texte correspondant : ce qu’un détecteur de plagiat trouve, ce qu’il rate et comment le lire.
Publié le · 9 min de lecture
Dans cet article
Un détecteur de plagiat qui travaille sur le web cherche dans votre texte les passages qui figurent aussi, dans le même ordre, sur des pages publiques ou sur Wikipédia. Il relie chaque passage à sa source et calcule la part de texte correspondant. Il ne dit pas s’il y a plagiat : une citation entre guillemets, une formule courante ou un passage correctement référencé correspondent aussi. Il ne voit pas non plus les livres, les revues payantes ni les travaux d’autres étudiants, et il ne retrouve pas une idée reformulée ou traduite.
Ce guide s’adresse aux étudiants qui relisent un mémoire ou un devoir avant de le rendre, aux enseignants qui ont un doute sur une copie et aux rédacteurs qui contrôlent un texte avant publication. Il montre comment fonctionne un détecteur de plagiat, ce qui entre dans la part affichée, comment lire un résultat, en quoi il diffère d’une détection d’IA et d’un système d’établissement comme Compilatio ou Turnitin. Les pages citées ont été consultées le 16 novembre 2026.
Comment fonctionne un détecteur de plagiat sur le web
La vérification suit cinq étapes et dure en général moins d’une minute.
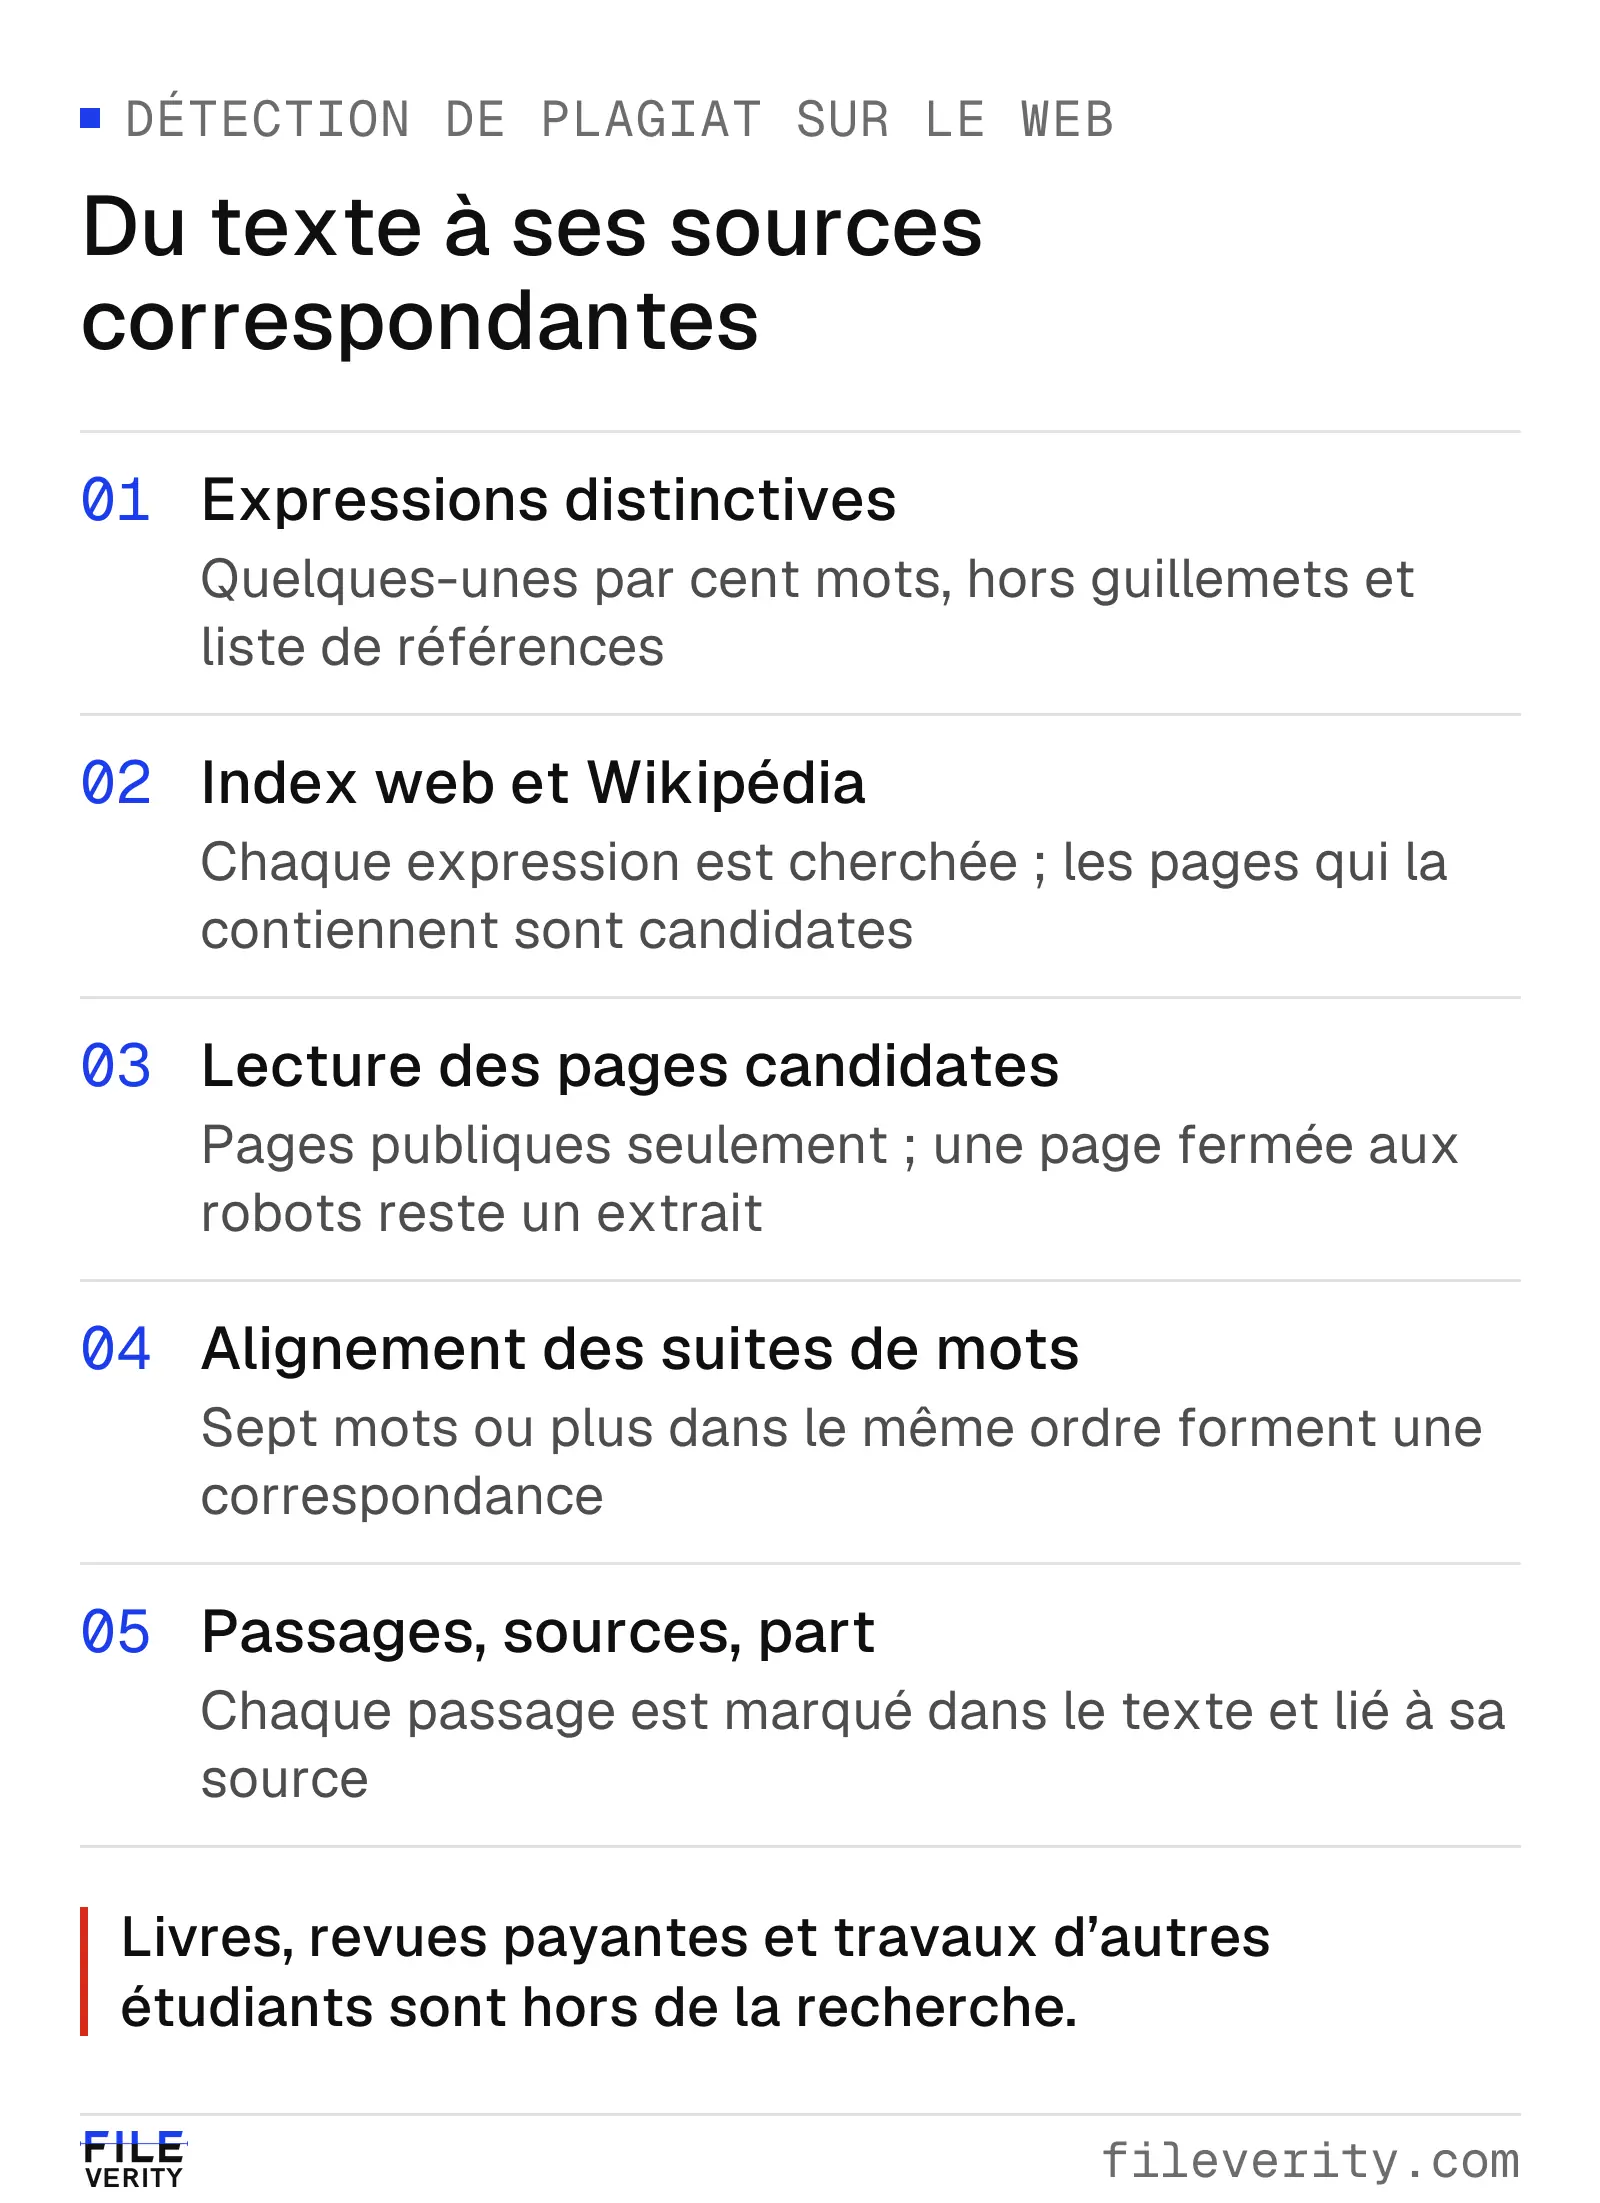
Du texte aux sources : l’outil cherche des expressions, lit les pages candidates, puis compare mot à mot.
- Des expressions distinctives. L’outil choisit dans le texte des expressions peu courantes, environ une par tranche de soixante-dix mots, jusqu’à vingt-quatre. Il les prend hors des guillemets et hors de la liste de références.
- Une recherche dans l’index web et dans Wikipédia. Chaque expression est cherchée dans un index de recherche public et dans Wikipédia, dans la langue du texte : une dissertation en français est comparée à des pages en français.
- La lecture des pages candidates. Jusqu’à quinze pages candidates sont ouvertes et lues, en respectant le fichier robots.txt. Une page qui ne peut pas être lue est comparée à partir de son extrait de recherche seulement, et la source porte alors la mention « Extrait seulement ».
- L’alignement mot à mot. Le texte et chaque page sont alignés. Une suite de sept mots ou plus dans le même ordre compte comme une correspondance. Sans interruption, c’est une correspondance exacte ; avec de petits écarts (jusqu’à trois mots), une correspondance proche.
- Les passages, les sources, la part. Chaque passage est marqué dans le texte et lié à une source numérotée. La liste des sources indique le titre, l’hôte et la part du texte que chacune explique.
Le texte reste modifiable dans la même fenêtre : vous pouvez réécrire un passage, le mettre entre guillemets avec sa référence, puis relancer la vérification.
Ce qui compte dans la part de texte correspondant
La part est le nombre de mots correspondants divisé par le nombre de mots pris en compte, après exclusions. Par défaut, les passages entre guillemets et les entrées de la liste de références sont signalés et exclus ; deux cases à cocher permettent de les inclure. Le résultat affiche un bandeau : « Aucun texte correspondant », « Peu de texte correspondant », « Du texte correspondant » ou « Beaucoup de texte correspondant ».
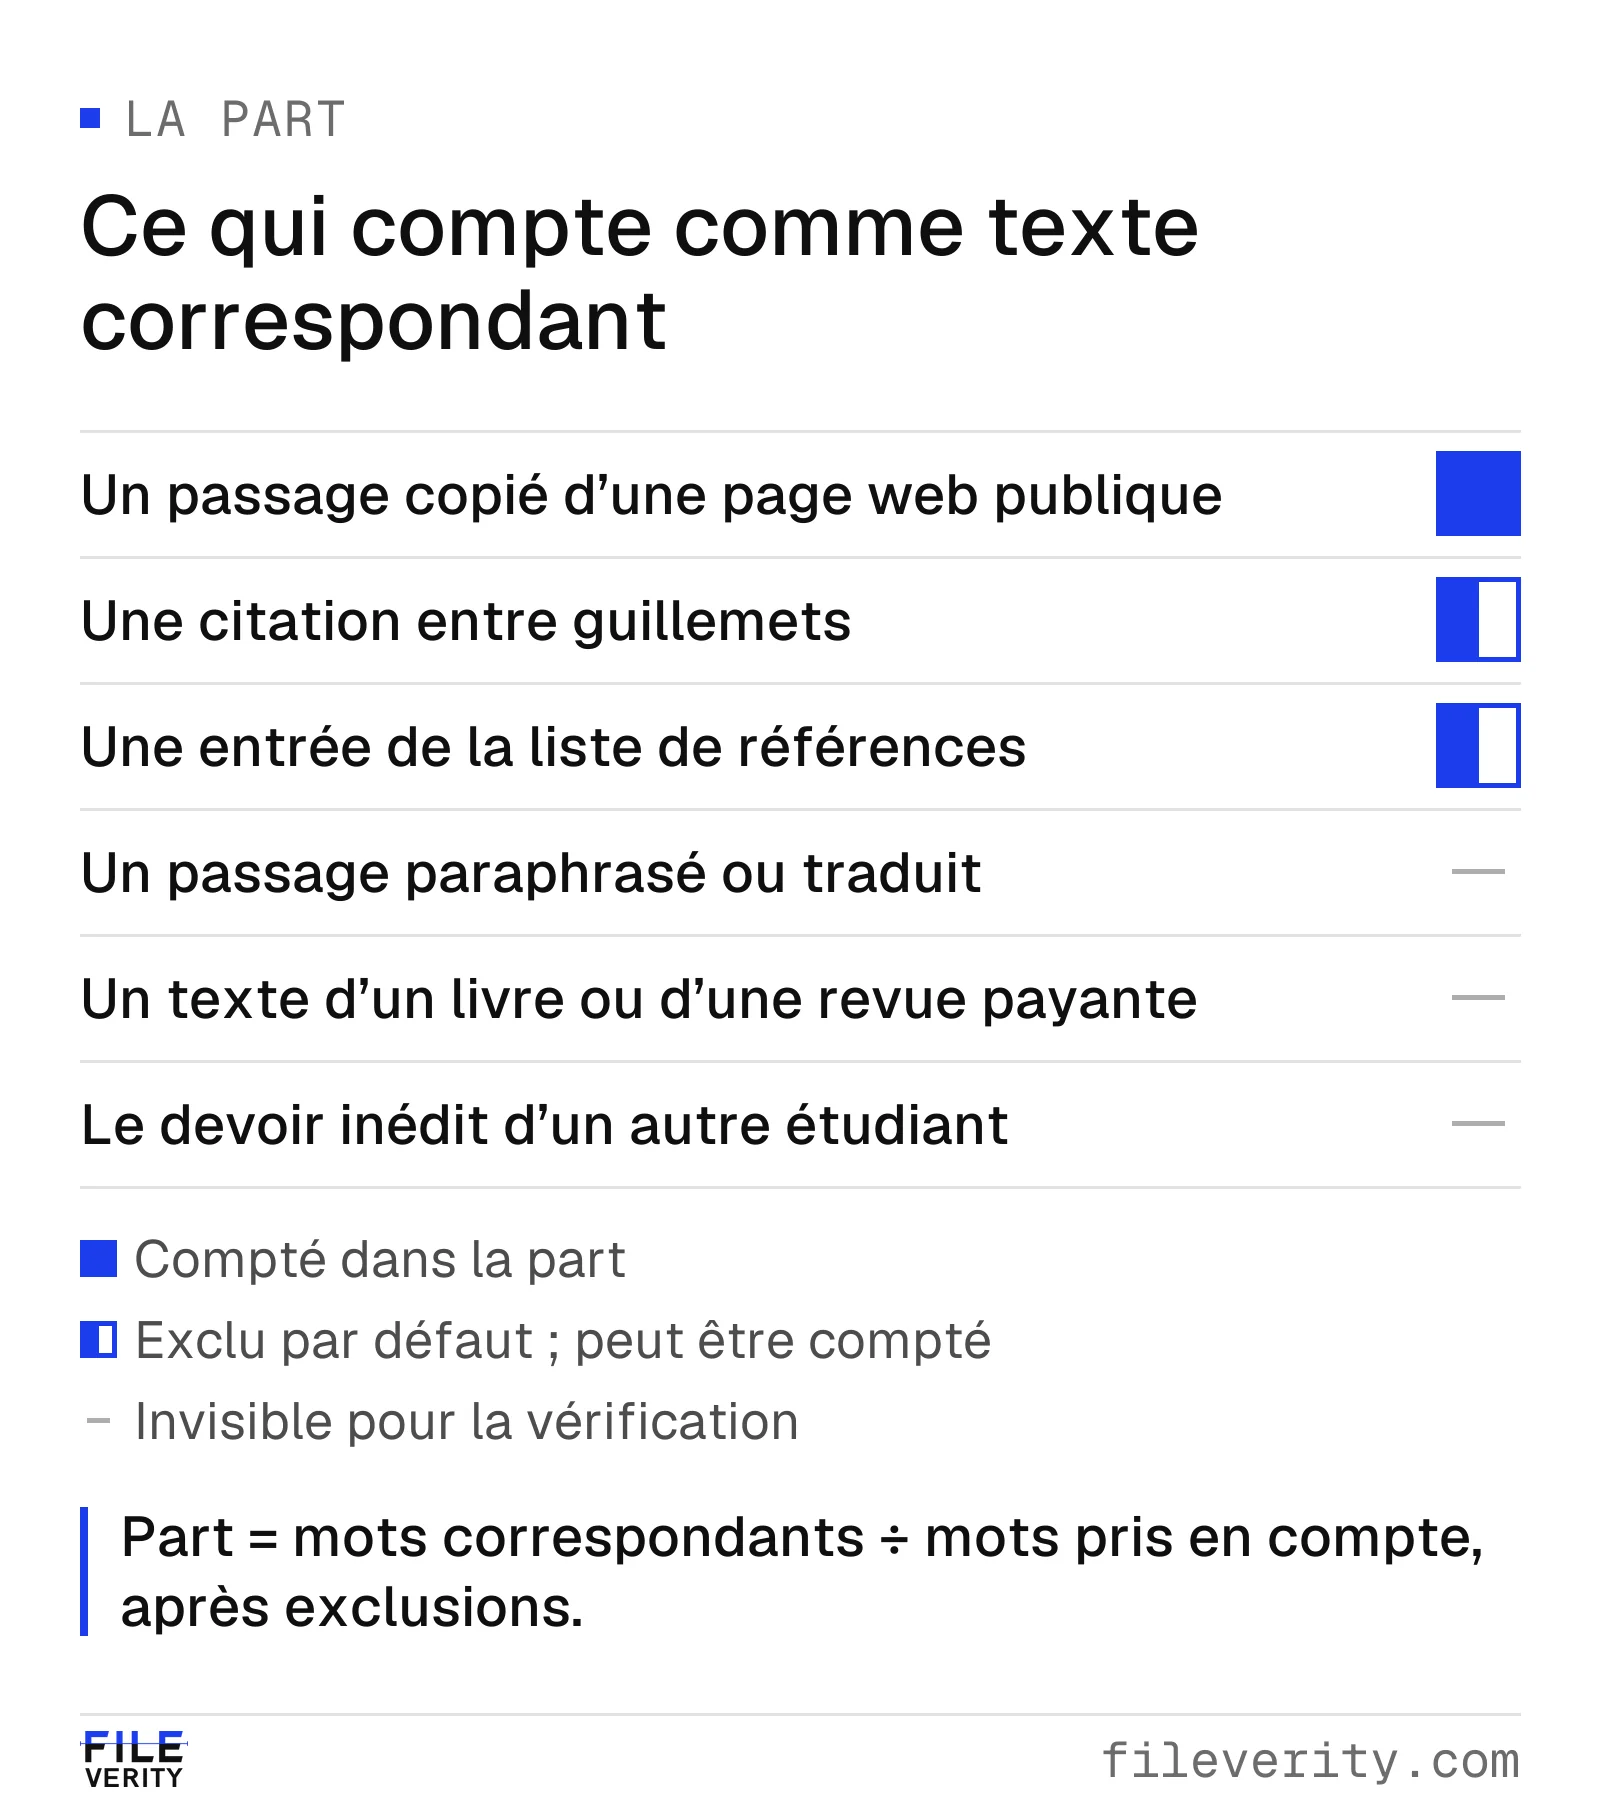
Trois catégories : ce qui est compté, ce qui est exclu par défaut et ce que la vérification ne voit pas.
Ce que la vérification ne voit pas compte autant que ce qu’elle trouve :
- Les paraphrases et les traductions. Seules les suites de mots dans le même ordre sont retrouvées. Une idée reprise avec d’autres mots, ou traduite d’une langue à l’autre, n’est pas signalée, alors qu’elle exige une référence comme le reste : c’est ce que rappelle la fiche sur le plagiat de Bordeaux INP.
- Les livres et les revues payantes. Ils ne sont pas dans la recherche.
- Les travaux d’autres étudiants et les dépôts de plateformes pédagogiques. Ils ne sont pas accessibles non plus, comme les bases de données privées.
- Les citations sans guillemets. Seuls les passages entre guillemets sont traités comme des citations : un bloc cité en retrait, sans guillemets, entre dans la part.
Lire un résultat : un exemple pas à pas
Voici un cas inventé. Une étudiante de master rend un mémoire sur le télétravail ; elle colle son introduction de 600 mots dans le détecteur. Le résultat affiche « Peu de texte correspondant » et quatre passages marqués. Chacun appelle une décision différente.
| Passage | Ce qu’indique la source | Décision |
|---|---|---|
| Une définition de dix-huit mots, sans guillemets | Correspondance exacte avec un article de Wikipédia | Mettre entre guillemets et référencer, ou reformuler en citant |
| Une phrase entre guillemets, avec sa référence | Exclue par défaut de la part | Rien, sauf à vérifier que la référence est complète |
| Une phrase avec un mot différent et un mot supprimé | Correspondance proche avec un blog | Comparer : une reformulation superficielle d’une phrase reste à citer |
| « Il convient de souligner que » | Correspondance avec de nombreuses pages | Formule courante : ne rien changer |
Une des sources porte la mention « Extrait seulement » : la page n’a pas pu être lue, et seul son extrait de recherche a été comparé. Ouvrez-la avant de conclure, car la correspondance a pu être plus longue.
Le principe tient en une phrase : un texte correspondant n’est pas un verdict. Lisez chaque passage dans son contexte, ouvrez la source, puis décidez si c’est une citation, une formule courante ou un emprunt à corriger.
Plagiat et détection d’IA : deux questions
Un détecteur de plagiat demande : ce texte existe-t-il ailleurs ? Une détection d’IA demande : l’écriture présente-t-elle des indices de rédaction par un modèle ? Les deux réponses sont indépendantes. Un texte généré par un modèle peut être inédit et ne correspondre à aucune page. Un passage recopié d’un site, écrit par une personne, ne porte aucun indice d’IA.
Les deux vérifications s’exécutent donc sur le même texte, dans la même fenêtre, et se complètent. Pour la seconde, voir le détecteur de texte IA. Un enseignant qui fait face à un devoir douteux trouvera la marche à suivre dans le guide Un devoir maison semble écrit par l’IA, et la fiabilité du modèle dans le benchmark Veread.
Détecteur web et systèmes d’établissement
Les services que les universités déploient comparent à d’autres corpus, dont certains ne sont pas publics.
| Service | Ce qu’il compare | Source |
|---|---|---|
| Compilatio | Pages web, y compris des archives, publications scientifiques ; avec Magister, les travaux d’autres établissements du réseau | Compilatio ; université de Lille |
| Turnitin | Travaux d’étudiants, publications, contenu internet | Turnitin |
| Ce détecteur | Index de recherche public et Wikipédia, dans la langue du texte | Fileverity |
Selon sa propre page, Compilatio compare aussi les documents à plus d’un milliard de documents académiques, mais la comparaison avec les travaux d’autres établissements ne concerne que l’offre Magister, jamais Studium. À l’université de Lille, le guide de 2019 explique que la « bibliothèque de référence » de Compilatio est constituée des documents déposés par ses usagers et par d’autres établissements, et que les enseignants y accèdent depuis l’ENT ou depuis Moodle. Le rapport donne un pourcentage de similarité, un texte annoté et une liste de sources classées en « très probables », « peu probables », « accidentelles » et « ignorées ».
Un détecteur web suffit quand vous voulez repérer, avant de rendre un texte, les passages qui ressemblent encore à leur source, ou quand un enseignant soupçonne une page copiée dans une seule copie. Il ne suffit pas quand l’établissement exige son propre rapport, ou quand il faut comparer avec des travaux déposés : seule la base d’un service d’établissement le permet. Le détecteur web ne remplace donc ni Compilatio ni Turnitin ; il couvre le web ouvert et Wikipédia, où l’on trouve souvent l’origine d’un texte recopié.
La même page ajoute qu’aucun pourcentage n’est acceptable en soi : chaque établissement fixe ses propres repères, et la nature des passages signalés compte plus que le chiffre.
En France : mémoire, charte et discipline
Dans l’enseignement supérieur, les règles viennent de l’établissement. La fiche « Le plagiat » de Bordeaux INP reprend la définition du Petit Robert, « s’approprier les mots ou les idées de quelqu’un d’autre et de les présenter comme siens », et précise que, dans un travail évalué, le plagiat est une fraude qui peut entraîner un zéro, une exclusion de l’établissement ou, au maximum, l’exclusion définitive de tout établissement d’enseignement supérieur français ; la fraude relève de la section disciplinaire. La fiche rappelle aussi que le texte cité doit être placé entre guillemets avec sa source, et que le texte résumé, paraphrasé, reformulé ou traduit doit lui aussi être référencé.
Pour un mémoire, la charte de l’UFR LLASIC de l’université Grenoble Alpes demande un travail « strictement original » et précise que les sources, « quelles qu’elles soient », doivent être « intégralement citées ». Bordeaux INP et cette UFR renvoient chacun à une charte anti-plagiat : repérez celle de votre établissement avant de choisir vos outils.
Quelques réflexes pour un mémoire : gardez vos notes de lecture avec la page de chaque emprunt, mettez entre guillemets toute reprise littérale au moment où vous la copiez, et vérifiez chapitre par chapitre plutôt qu’à la veille du dépôt.
Confidentialité et coût
Seules de courtes expressions du texte sont envoyées aux services de recherche. La détection de plagiat fait partie de la formule Pro et utilise 1 crédit par tranche entamée de 1 000 caractères, pris sur les crédits que la formule ajoute chaque mois. Il faut au moins 50 mots et au plus 30 000 caractères par vérification : pour un mémoire, procédez par chapitre. Une vérification qui ne peut pas aboutir n’est pas facturée. Les enseignants vérifiés reçoivent la formule Pro gratuitement pendant 12 mois : voir la page pour les enseignants et les tarifs.
L’API propose POST /v1/text/plagiarism (modèle plagiarism-1, réponse immédiate), pour les espaces de travail qui ont acheté des crédits : voir la documentation. Pour essayer, ouvrez la page détecteur de plagiat ; pour corriger la langue du même texte, le correcteur grammatical.
Questions fréquentes
Un détecteur web remplace-t-il Compilatio ?
Non. Ces services comparent aussi à des travaux déposés et à des publications que le web ouvert ne contient pas. Un détecteur web couvre les pages publiques et Wikipédia, utile avant le dépôt, mais pas pour une comparaison entre copies.
Quelle part de texte correspondant est acceptable ?
Aucun seuil ne vaut partout : chaque établissement fixe ses propres repères, et la nature des passages compte plus que le chiffre. Un pourcentage élevé peut venir de citations correctes, un pourcentage faible d’un passage central recopié. Lisez les passages.
Un texte paraphrasé ou traduit est-il retrouvé ?
Non, seules les suites d’au moins sept mots dans le même ordre sont retrouvées. Une reformulation fidèle d’une source reste pourtant à citer.
Pourquoi une citation correcte apparaît-elle ?
Parce qu’elle reprend les mots de la source. Les passages entre guillemets sont signalés et exclus de la part par défaut ; si vos citations sont en retrait sans guillemets, elles sont comptées.
Peut-on vérifier un mémoire entier ?
Une vérification accepte 30 000 caractères au plus. Découpez le mémoire par chapitre et lancez une vérification par partie.
Sources
Pages consultées le 16 novembre 2026.
- Université de Lille, Direction de l’innovation pédagogique, Utiliser l’outil d’aide à la détection du plagiat Compilatio, guide, décembre 2019.
- Compilatio, Plagiarism Detector Online, page produit en anglais (la page ne porte pas de date).
- Turnitin, Turnitin Similarity, page produit (la page ne porte pas de date).
- Bordeaux INP, Le plagiat, fiche d’information (le document ne porte pas de date).
- Université Grenoble Alpes, UFR LLASIC, Charte relative à l’usage de l’IA générative, mise à jour de mars 2026.
Par Yang Zheng · Relu par Bill Liu