Modellversion
Veread 1.1: weniger Fehlalarme, präzisere Passagenmarkierung
Veread 1.1 erkennt 98,6 % der vollständig KI-geschriebenen Texte bei 0,28 % Fehlalarmen und findet 92,2 % der gemischten Dokumente. Seit dem 18. November 2026.
Veröffentlicht · 6 Min. Lesezeit
Eckdaten
- Version
- Veread 1.1
- Veröffentlicht
- 18. November 2026
- Fehlalarme bei von Menschen verfassten Texten
- 0,28 % (zuvor 0,45 %)
- Vollständig KI-geschriebene Texte erkannt
- 98,6 %
- Gemischte Dokumente aus menschlichem und KI-Schreiben erkannt
- 92,2 % (zuvor 87,3 %)
- Texte unbekannter KI-Modelle erkannt
- 94,9 %
Veread 1.1, seit dem 18. November 2026 im Einsatz, erkennt 98,6 % der vollständig KI-geschriebenen Texte und stuft nur 0,28 % der von Menschen verfassten Texte fälschlich als KI-Text ein (Veread 1.0: 0,45 %). Gemessen wurde an zurückgehaltenen Testdaten in sieben Sprachen. Gemischte Dokumente, in denen sich menschliches und KI-Schreiben abwechseln, erkennt es zu 92,2 % (zuvor 87,3 %) und markiert die KI-geschriebenen Passagen mit 97,2 % Präzision.
Veread ist das Textmodell zur Erkennung von KI-Texten, das Fileverity selbst entwickelt hat. Jede Text- und Dokumentprüfung bei Fileverity läuft jetzt auf Version 1.1.
Das ist neu in Veread 1.1
- Schwerpunkt Englisch, Spanisch und Französisch. Alle sieben Sprachen bleiben in einem Modell: Englisch, Französisch, Deutsch, Spanisch, Chinesisch, Vietnamesisch und Arabisch.
- Eine deutlich breitere Basis menschlicher Texte. Aufsätze und Hausarbeiten von Studierenden, vollständige wissenschaftliche Arbeiten, Briefe und Beschwerden, Film- und Produktbewertungen, Forendiskussionen, Erzählprosa und literarische Texte, Rechts- und Verwaltungstexte, Nachrichten und enzyklopädische Artikel.
- Gezielt schwierige menschliche Texte. Förmliches, formelhaftes oder geschliffenes menschliches Schreiben, das Detektoren am ehesten für KI halten, gehört jetzt fest zum Training.
- KI-Texte der neuesten Generation aus neun Modellfamilien: OpenAI, Anthropic, Google, DeepSeek, Alibaba, Meta, Mistral, xAI und Zhipu. Dazu zählen KI-Texte, die paraphrasiert oder „humanisiert“ wurden, um Detektoren zu umgehen, sowie KI-Umschreibungen menschlicher Texte.
- Markierungen auf Satzebene. Jeder KI-geschriebene Satz in einem gemischten Dokument ist gekennzeichnet, sodass das Modell genau lernt, wo menschliches Schreiben endet und KI-Schreiben beginnt.
- Bereinigte Trainingstexte. Autorenzeilen, Bildnachweise, Cookie- und Abo-Hinweise, Markup, Fußnotenzeichen und Wortzähler wurden ausschließlich durch Löschen entfernt. Der Text selbst wird nie verändert, damit Veread das Schreiben beurteilt und nicht die Formatierung.
- Abgleich auf Duplikate. Exakt oder nahezu identische Texte tauchen nie sowohl im Training als auch in der Auswertung auf, sodass Veread nie an Texten getestet wird, die es praktisch schon kennt.
- Neue Entscheidungsschwellen, kalibriert an zurückgehaltenen menschlichen Texten. Auch die Passagenmarkierung und die Schreibstil-Ähnlichkeit wurden für das neue Modell neu kalibriert. Die Ähnlichkeit wird jetzt öfter angezeigt und trifft öfter zu.
Ergebnisse: Veread 1.1 im Vergleich zu Veread 1.0
Beide Versionen durchliefen dieselbe Auswertung: zurückgehaltene Texte ab etwa 100 Wörtern in sieben Sprachen.
| Kennzahl | Veread 1.0 | Veread 1.1 |
|---|---|---|
| Von Menschen verfasste Texte fälschlich als KI markiert | 0,45 % | 0,28 % |
| Vollständig KI-geschriebene Texte erkannt | 98,3 % | 98,6 % |
| Alle KI-geschriebenen und KI-unterstützten Texte erkannt | 95,4 % | 95,9 % |
| Von KI fortgeführte menschliche Texte erkannt | 91,7 % | 94,3 % |
| Gemischte Dokumente aus menschlichem und KI-Schreiben erkannt | 87,3 % | 92,2 % |
| Kurze Auszüge von etwa 100 Wörtern erkannt | 92,9 % | 94,1 % |
| Vollständige Dokumente erkannt | 96,6 % | 96,8 % |
| Von KI umgeschriebene Texte erkannt | 92,5 % | 92,8 % |
| F1 der Passagenmarkierung | 90,3 | 92,9 |
| AUROC, kurze Auszüge | 0,995 | 0,996 |
Außerdem erkennt Veread 1.1 100 % der in menschlichen Text eingefügten KI-Passagen, 97,6 % der von KI überarbeiteten Texte und 94,9 % der Texte von KI-Modellen, die in der Entwicklung nie verwendet wurden. Der AUROC für vollständige Dokumente liegt bei 0,999.
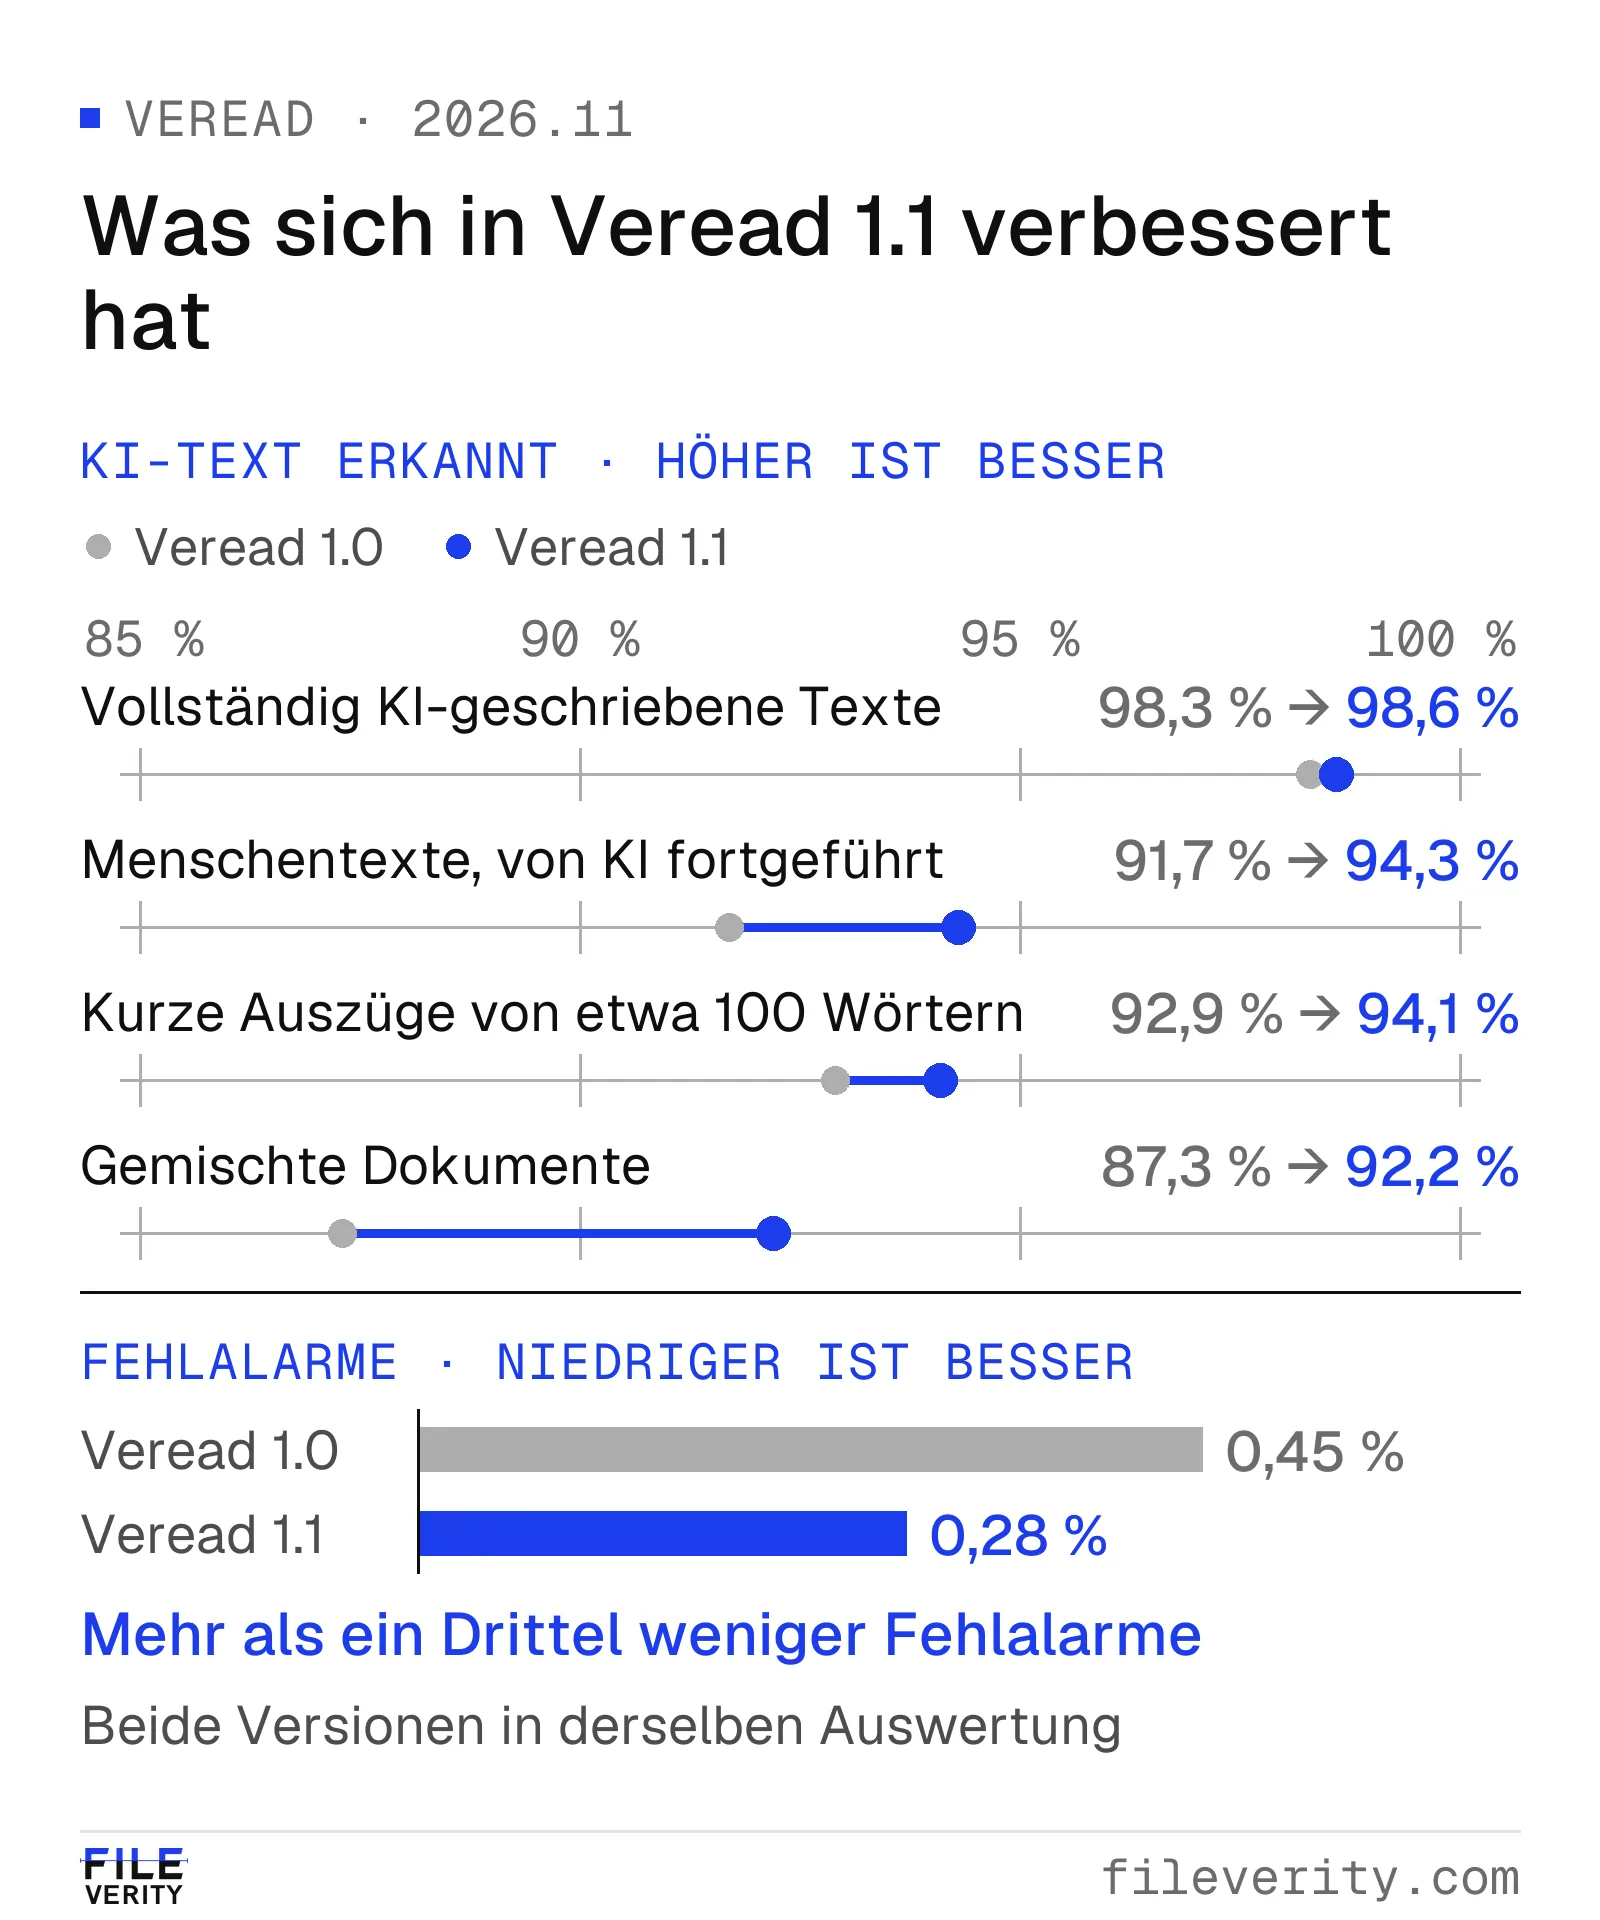
Die Fehlalarme sinken um mehr als ein Drittel, während die Erkennung bei allen zentralen Kennzahlen steigt.
Die Kennzahlen in einfachen Worten
- Fehlalarmquote: der Anteil der von Menschen verfassten Texte, die einen KI-Befund erhalten. Niedriger ist besser.
- Erkennungsrate: der Anteil der KI-geschriebenen oder KI-unterstützten Texte, die Veread erkennt. Höher ist besser.
- KI-unterstützt: Ein Text zählt nur dann, wenn die KI den Wortlaut tatsächlich verändert hat, sei es durch Fortführen, Umschreiben, Überarbeiten oder durch eingefügte Passagen in menschlichem Text.
- AUROC: wie sauber die Werte von Veread menschliches und KI-Schreiben trennen, unabhängig davon, welchen Entscheidungspunkt Sie wählen. Ein Wert von 1 bedeutet perfekte Trennung.
- F1 der Passagenmarkierung: eine einzige Zahl dafür, wie viele der KI-geschriebenen Passagen Veread findet und wie viele der markierten Passagen tatsächlich KI-geschrieben sind.
- Präzision markierter Passagen: der Anteil des markierten Textes, der tatsächlich KI-geschrieben ist.
Weniger Fehlalarme bei von Menschen verfassten Texten
Ein Fehlalarm ist die eigene Arbeit eines Menschen, die als maschinengeschrieben markiert wird. Für Lehrkräfte, Hochschulen und Redaktionen entscheidet das darüber, ob sich ein Detektor bei den Texten echter Menschen verantwortbar einsetzen lässt.
Veread 1.1 markiert 0,28 % der von Menschen verfassten Texte, mehr als ein Drittel weniger Fehlalarme als Veread 1.0. Die Zahl umfasst alle zurückgehaltenen menschlichen Texte, einschließlich unabhängiger menschlicher Vergleichsgruppen aus Quellen, die nie im Training verwendet wurden. Bei vollständigen Dokumenten liegt sie bei 0,23 %.
In jeder Sprache liegt die Fehlalarmquote unter 0,5 %. Englisch sank von 0,43 % auf 0,18 %, Spanisch von 0,77 % auf 0,41 % und Französisch von 0,76 % auf 0,45 %; alle Sprachen finden Sie in der Tabelle weiter unten. Jede Textart liegt unter 1 %. Literatur und kreatives Schreiben sanken von 0,62 % auf 0,08 %, Bewertungen und Foren von 0,84 % auf 0,38 %, Aufsätze von Studierenden und Sprachlernenden von 0,51 % auf 0,30 % und akademische und wissenschaftliche Texte von 1,08 % auf 0,77 %.
Präzisere Passagenmarkierung in gemischten Dokumenten
Echte Einreichungen sind selten reine Maschinenausgabe. Veread 1.1 lernt aus Markierungen auf Satzebene und erkennt deshalb 92,2 % der gemischten Dokumente (zuvor 87,3 %), markiert Passagen mit 97,2 % Präzision und erreicht einen F1-Wert der Passagenmarkierung von 92,9 (zuvor 90,3). Alle Werte sind durchgängig über die Produktions-Engine gemessen.
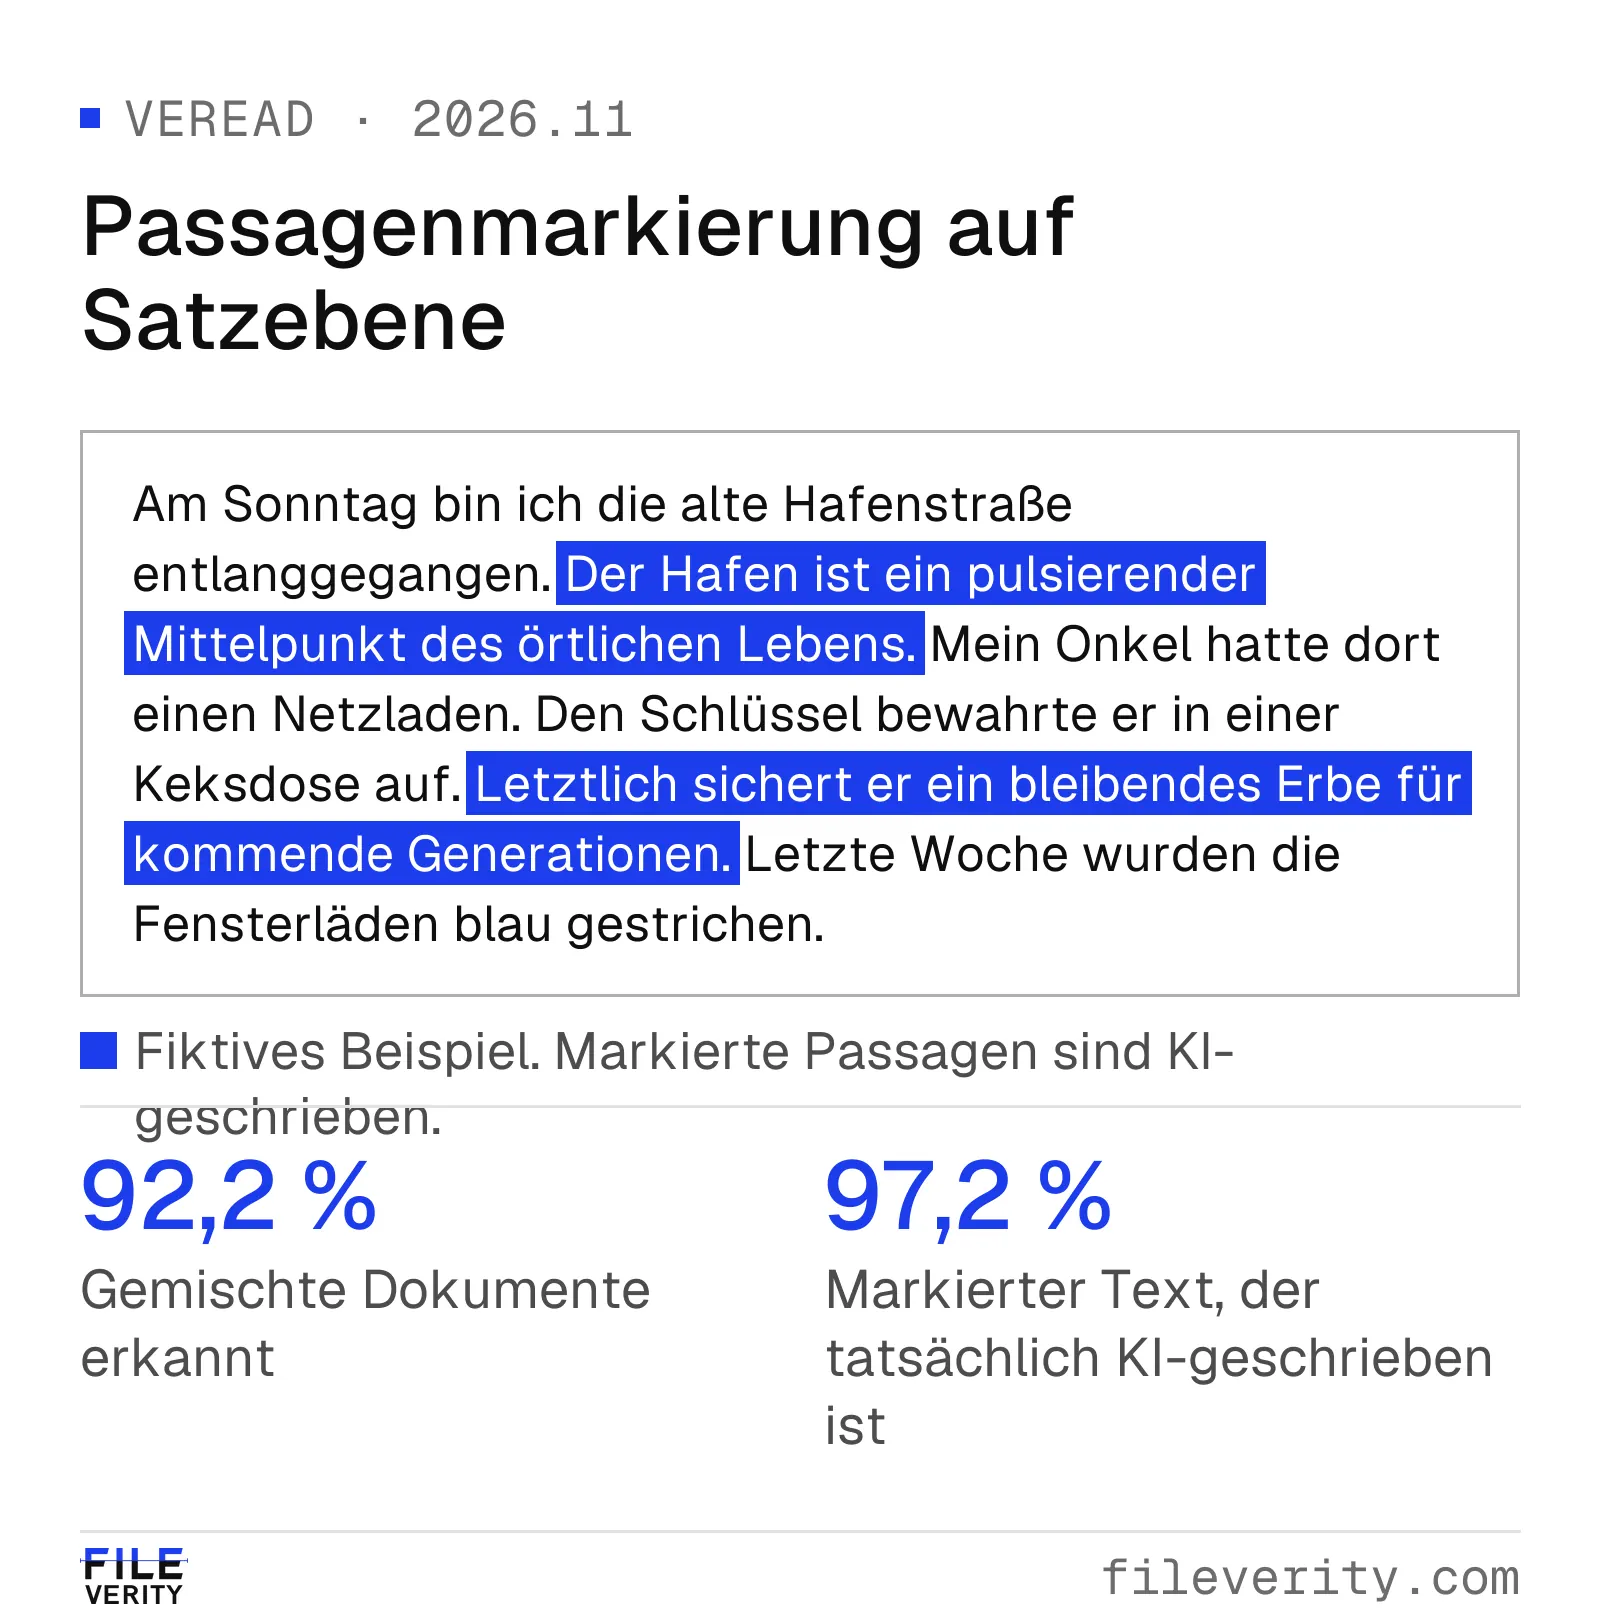
Fiktives Beispiel. Veread 1.1 markiert die KI-geschriebenen Sätze in einem Dokument, das auch menschliches Schreiben enthält.
Ergebnisse in allen sieben Sprachen
Ein Modell deckt alle sieben Sprachen ab, und jede Sprache wird einzeln gemessen.
| Sprache | Menschliche Texte fälschlich markiert | KI-geschriebene und KI-unterstützte Texte erkannt | Vollständig KI-geschriebene Texte erkannt |
|---|---|---|---|
| Englisch | 0,18 % | 94,5 % | 95,1 % |
| Französisch | 0,45 % | 96,8 % | 99,1 % |
| Deutsch | 0,27 % | 94,1 % | 100 % |
| Spanisch | 0,41 % | 96,0 % | 100 % |
| Chinesisch | 0,03 % | 98,8 % | 100 % |
| Vietnamesisch | 0,48 % | 92,8 % | 95,5 % |
| Arabisch | 0,13 % | 97,5 % | 98,5 % |
Die Erkennung KI-geschriebener und KI-unterstützter Texte stieg bei Englisch (zuvor 93,3 %), Deutsch (zuvor 93,2 %), Vietnamesisch (zuvor 90,7 %) und Arabisch (zuvor 97,2 %). Bei vollständig KI-geschriebenen deutschen Texten stieg sie von 99,1 % auf 100 %.
Nach Modellfamilie werden vollständig KI-geschriebene Texte von OpenAI, Alibaba, Mistral, xAI und Meta zu 100 % erkannt (Meta zuvor 96,8 %), von DeepSeek zu 96,3 % (zuvor 95,1 %) und von Google zu 95,9 % (zuvor 93,9 %).
Nach Textart werden KI-geschriebene und KI-unterstützte akademische und wissenschaftliche Texte sowie Briefe, E-Mails und Beschwerden zu 100 % erkannt, Aufsätze von Studierenden und Sprachlernenden zu 99,1 % (zuvor 98,1 %).
So testen wir Veread
Ein Detektor ist nur so glaubwürdig wie seine Auswertung. Veread wird auf umfangreichen, exklusiven, professionell aufbereiteten eigenen Daten entwickelt und validiert. Jedes Ergebnis in diesem Beitrag stammt aus der folgenden Auswertung.
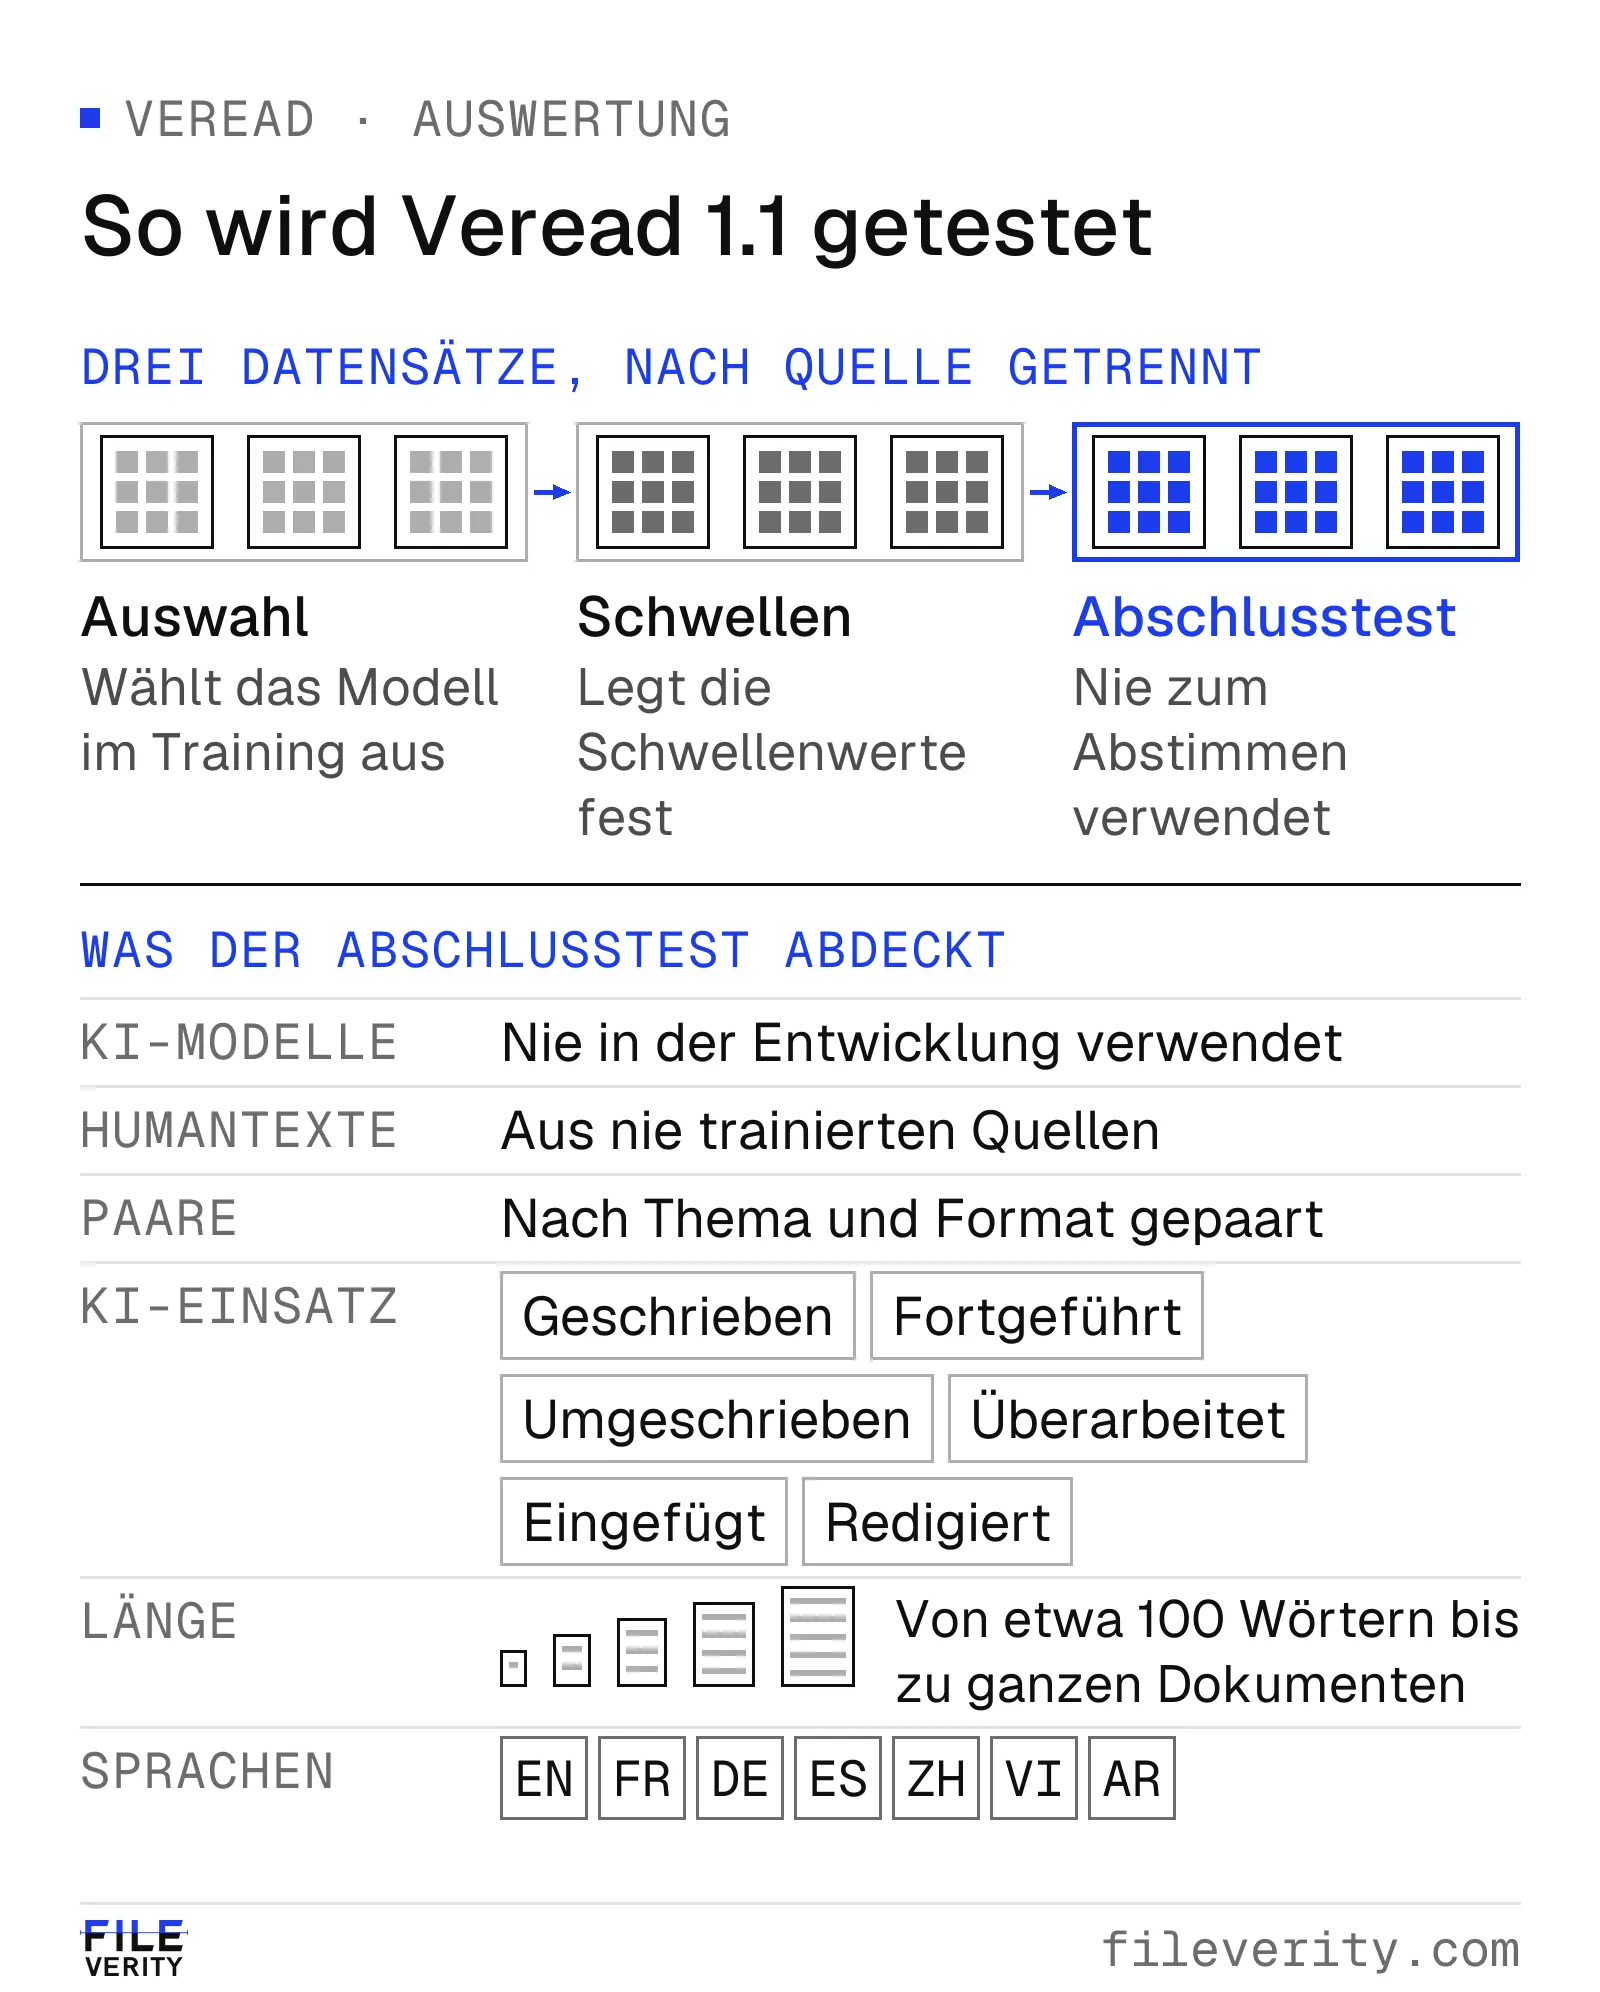
Die Auswertung trennt Modellauswahl, Schwelleneinstellung und Abschlusstest und misst die Engine, die Kundinnen und Kunden tatsächlich nutzen.
- Drei zurückgehaltene Datensätze mit drei Aufgaben. Einer dient der Modellauswahl im Training, einer der Einstellung der Entscheidungsschwellen, einer ist der Abschlusstest. Der Abschlusstest wird nie zum Abstimmen verwendet.
- Getrennt nach Quelle. Dokumente derselben Quelle oder Autorengruppe liegen immer auf derselben Seite der Aufteilung, sodass der Test die Verallgemeinerung misst und nicht das Auswendiglernen.
- Unbekannte KI-Modelle. Der Test enthält Texte von Modellen, die in der gesamten Entwicklung nie verwendet wurden.
- Unbekannte menschliche Quellen. Menschliche Vergleichsgruppen aus Quellen, die nie im Training vorkamen, messen Fehlalarme so, wie Kundinnen und Kunden ihnen begegnen.
- Gepaarte Texte. KI-Texte entstehen zu denselben Themen und in denselben Formaten wie ihre menschlichen Gegenstücke, sodass ein Detektor nicht allein über Thema oder Format punkten kann.
- Jede Form von KI-Beteiligung. Von Grund auf geschrieben, von Menschen begonnen und von KI fortgeführt, umgeschrieben, überarbeitet, KI-Passagen in menschlichem Text und von Menschen bearbeitete KI-Entwürfe.
- Nur echtes KI-Schreiben. Ein bearbeiteter Text gilt nur dann als KI-unterstützt, wenn die KI den Wortlaut tatsächlich verändert hat. Kleine Korrekturen, die den menschlichen Wortlaut unberührt lassen, sind ausgeschlossen.
- Vom Auszug bis zum Dokument. Von Auszügen mit etwa 100 Wörtern bis zu vollständigen Dokumenten, in sieben Sprachen und über Textarten von Rechts- und Verwaltungstexten über literarische Prosa, Studierendentexte, wissenschaftliche Arbeiten, Nachrichten und Webtexte bis zu Bewertungen, Foren, Gebrauchsdokumenten sowie Briefen und Beschwerden.
- Die Produktions-Engine. Die Ergebnisse werden durchgängig über dieselbe Engine gemessen, die für Kundinnen und Kunden läuft, nicht an einer Laborkopie.
Jetzt verfügbar
Veread 1.1 ist seit dem 18. November 2026 aktiv, ohne dass Sie etwas tun müssen:
- Die KI-Erkennung für Texte im Web und in der Konsole.
- Die API mit unveränderten Modell-IDs (
veread-1-textfür Text,veread-1für Dokumente) und einem neuen Snapshot vom 2026-11-18. Siehe die Dokumentation der Text-API. - Dokumentenberichte, in denen Veread den Text im Dokument prüft. Die Seite zur Zuverlässigkeit nennt die zentralen Messwerte.
- Die Chrome-Erweiterung und Klassensatzprüfungen für Lehrkräfte.
Die vollständige Übersicht zu Veread 1.1 nach Sprache, Textart und Modellfamilie steht im Ratgeber zur Veread-Auswertung.
Von Yang Zheng