Erkennung bewerten
Woran erkennt man, welche KI einen Text geschrieben hat? Die Schreibmerkmale von ChatGPT, Claude, Gemini und Co.
Typische Formulierungen und Satzzeichen von ChatGPT, Claude, Gemini, Grok, DeepSeek, Qwen und GLM auf Deutsch, mit Faktoren und Grenzen.
Veröffentlicht · Aktualisiert · 7 Min. Lesezeit
Auf dieser Seite
Jede Modellfamilie schreibt Deutsch mit eigenen Vorlieben. In deutschen Texten von ChatGPT stehen „entscheidend ist“ rund 27-mal und „von bedeutung“ rund 9,5-mal so oft wie bei menschlichen Autorinnen und Autoren. Claude schreibt „weist darauf hin“ rund 22-mal so häufig, Qwen „weit über“ rund 27-mal. Das sind Tendenzen einer ganzen Familie, gemessen an vielen Texten, und kein Beweis für einen einzelnen Text, aber sie erklären, warum KI-Text oft schon beim Lesen auffällt.
Dieser Leitfaden zeigt die Schreibmerkmale der sieben Familien ChatGPT/OpenAI, Claude/Anthropic, Gemini/Google, Grok/xAI, DeepSeek, Qwen/Alibaba und GLM/Zhipu auf Deutsch: welche Formulierungen und Satzzeichen sie von menschlichem Schreiben abheben, welche Familien sich voneinander unterscheiden, wie die Zahlen entstanden sind und warum Sie sie nur als Indiz nutzen sollten. Alle Werte stammen aus dem deutschen Korpus von Fileverity, Stand 10. November 2026. Familien-Ergebnisse nennen wir Schreibstil-Ähnlichkeit: Sie sagen, wie sehr ein Text dem Stil einer Familie gleicht, nicht, wer ihn tatsächlich erzeugt hat.
Typische Formulierungen je Modellfamilie
Die Abbildung zeigt je Familie die zwei Formulierungen, die in deutschen KI-Texten besonders deutlich häufiger vorkommen als in Texten von Menschen. Gewählt sind Wendungen, die wie gewöhnliche Sprache lesen, sich in einem Text suchen lassen und sich möglichst von den anderen Familien unterscheiden. Wendungen, die fast alle Familien teilen, etwa „im alltag“ mit dem Zehn- bis Dreizehnfachen, sind bewusst weggelassen: Sie verraten die KI im Allgemeinen, aber keine Familie im Besonderen.
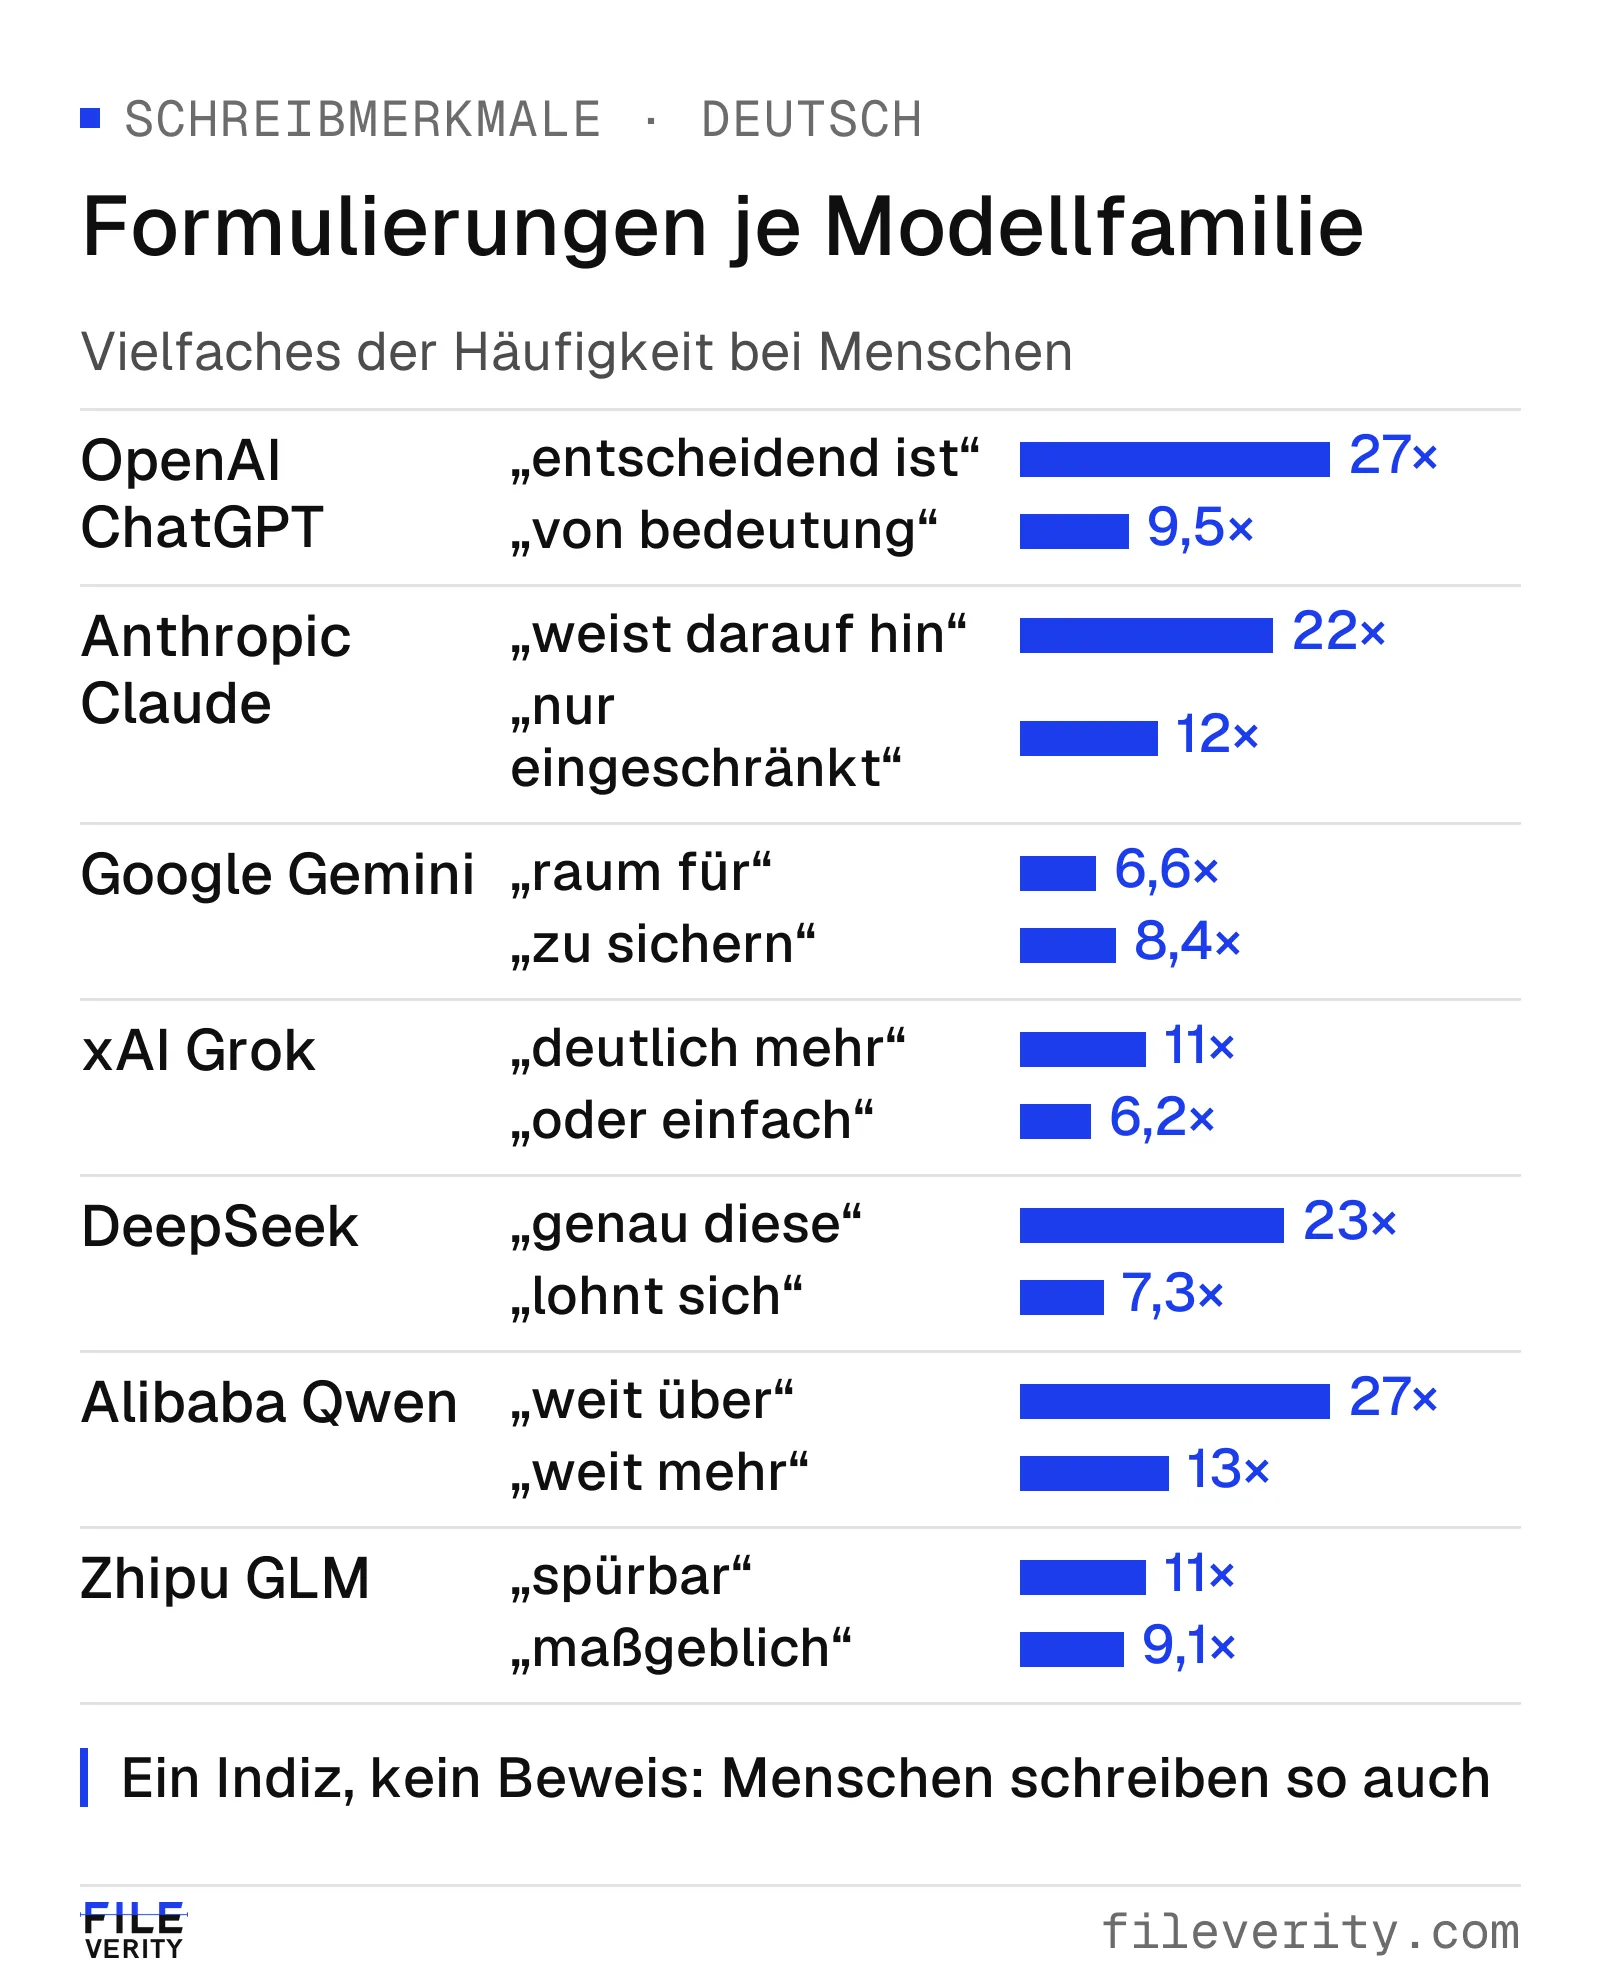
Ein Indiz, kein Beweis: Menschen verwenden diese Wendungen auch, nur deutlich seltener.
Alle Balken stehen auf derselben Skala. Sehr große Werte wie 27 verkürzen deshalb die übrigen. Die Faktoren sagen, wie viel häufiger eine Wendung vorkommt, nicht, dass sie in jedem KI-Text auftaucht: Die meisten Texte enthalten nur wenige davon.
Die sieben Familien im Einzelnen
ChatGPT und OpenAI
ChatGPT schreibt abwägend und gliedernd. Gegenüber Menschen fallen „entscheidend ist“ (27-mal so häufig), „von bedeutung“ (9,5-mal), „deshalb nicht“ (7,4-mal) und „unter druck“ (7,9-mal) auf. Von den anderen KI-Familien hebt sich ChatGPT vor allem durch „ohne weiteres“ (7,6-mal so häufig wie bei den übrigen KI-Modellen), „deshalb nicht“ (4,5-mal) und „entscheidend ist“ (3,9-mal) ab. Strukturell fällt die Gegenüberstellung „nicht X, sondern Y“ auf, die rund 3,9-mal so oft vorkommt wie bei Menschen. Die zugehörige Seite von ChatGPTDetect ordnet die Merkmale ein.
Claude und Anthropic
Claude formuliert vorsichtig und verweisend: „weist darauf hin“ (22-mal so häufig wie bei Menschen), „hinzu kommt“ (12-mal), „nur eingeschränkt“ (12-mal) und „frage nach“ (6,2-mal). Gegenüber anderen KI-Familien setzen „nur eingeschränkt“ (4,8-mal), „nach angaben“ (3,6-mal) und „und zwar“ (3,4-mal) Claude ab. Die Gegenüberstellung „nicht X, sondern Y“ nutzt Claude weniger als die anderen Familien, nämlich rund halb so oft, Fragezeichen dagegen etwas häufiger als sie. Details bei ClaudeDetect.
Gemini und Google
Gemini schreibt von Räumen und Absicherung: „raum für“ (6,6-mal), „zu sichern“ (8,4-mal), „zu gewährleisten“ (4,5-mal), „den blick“ (6,1-mal). Gegenüber den anderen KI-Familien stechen „um diesen“ (7,7-mal), „keineswegs“ (5,9-mal), „bezüglich“ (4,8-mal) und „hierbei“ (2,4-mal) hervor. Die Gegenüberstellung „nicht X, sondern Y“ kommt rund vierfach so oft vor wie bei Menschen. Die Seite GeminiDetect beschreibt Formulierungen und Satzzeichen.
Grok und xAI
Grok schreibt umgangsnäher und zugespitzter: „genau das“ (14-mal), „deutlich mehr“ (11-mal), „oder einfach“ (6,2-mal), „fühlt sich“ (3,2-mal). Gegenüber den anderen KI-Familien sind „deutlich zu“ (6,7-mal), „trotz aller“ (5-mal), „den großen“ (4,9-mal), „deutlich mehr“ (4,4-mal) und „plötzlich“ (3-mal) charakteristisch. Auffällig ist der Umgang mit Satzzeichen: Semikolons setzt Grok gut dreimal seltener ein als Menschen und auch dreimal seltener als die anderen Familien. Mehr bei GrokDetect.
DeepSeek
DeepSeek schreibt direkt ansprechend: „genau diese“ (23-mal so häufig wie bei Menschen), „und genau“ (13-mal), „wer die“ (12-mal), „lohnt sich“ (7,3-mal). Von den anderen KI-Familien unterscheiden es „genau diese“ (4-mal), „wer die“ (3,5-mal), „zuverlässig“ (3,4-mal) und „vielleicht“ (1,9-mal). Außerdem teilen sich DeepSeek-Texte seltener in mehrere Absätze als menschliche Texte. Die Seite DeepSeekDetect führt die Merkmale aus.
Qwen und Alibaba
Qwen schreibt wertend und steigernd: „weit über“ (27-mal), „weit mehr“ (13-mal), „im zentrum“ (7,8-mal), „ist daher“ (8,8-mal), „erfordert“ (10-mal). Gegenüber den anderen KI-Familien zeigen sich „sondern vielmehr“ (6,6-mal), „daher ist“ (5,9-mal), „das fundament“ (5,2-mal) und „bedeutet dies“ (3,9-mal). Die Gegenüberstellung „nicht X, sondern Y“ kommt rund 6,8-mal so oft vor wie bei Menschen und damit am häufigsten aller sieben Familien; Auslassungspunkte setzt Qwen rund achtmal seltener ein als Menschen.
GLM und Zhipu
Bei GLM ist die Beleglage auf Deutsch dünner: Nur wenige Wendungen haben alle Stabilitätsprüfungen bestanden. Gegenüber Menschen fallen „spürbar“ (11-mal so häufig), „vorgaben“ (12-mal), „maßgeblich“ (9,1-mal) und „extrem“ (4,2-mal) auf. Von den übrigen KI-Familien setzen sich nur „zwingend“ (5-mal) und „völlig“ (2,9-mal) ab. Verlassen Sie sich bei GLM deshalb weniger auf einzelne Wendungen als bei den anderen Familien.
Satzzeichen und Struktur
Neben den Formulierungen unterscheiden sich KI-Texte von menschlichen in der Zeichensetzung und im Bau. Die Abbildung zeigt vier Merkmale, die für fast alle sieben Familien eine Zahl liefern: die Gegenüberstellung „nicht X, sondern Y“, Klammern, Fragezeichen und Auslassungspunkte, jeweils als Vielfaches der Menschenrate je 1.000 Wörter.
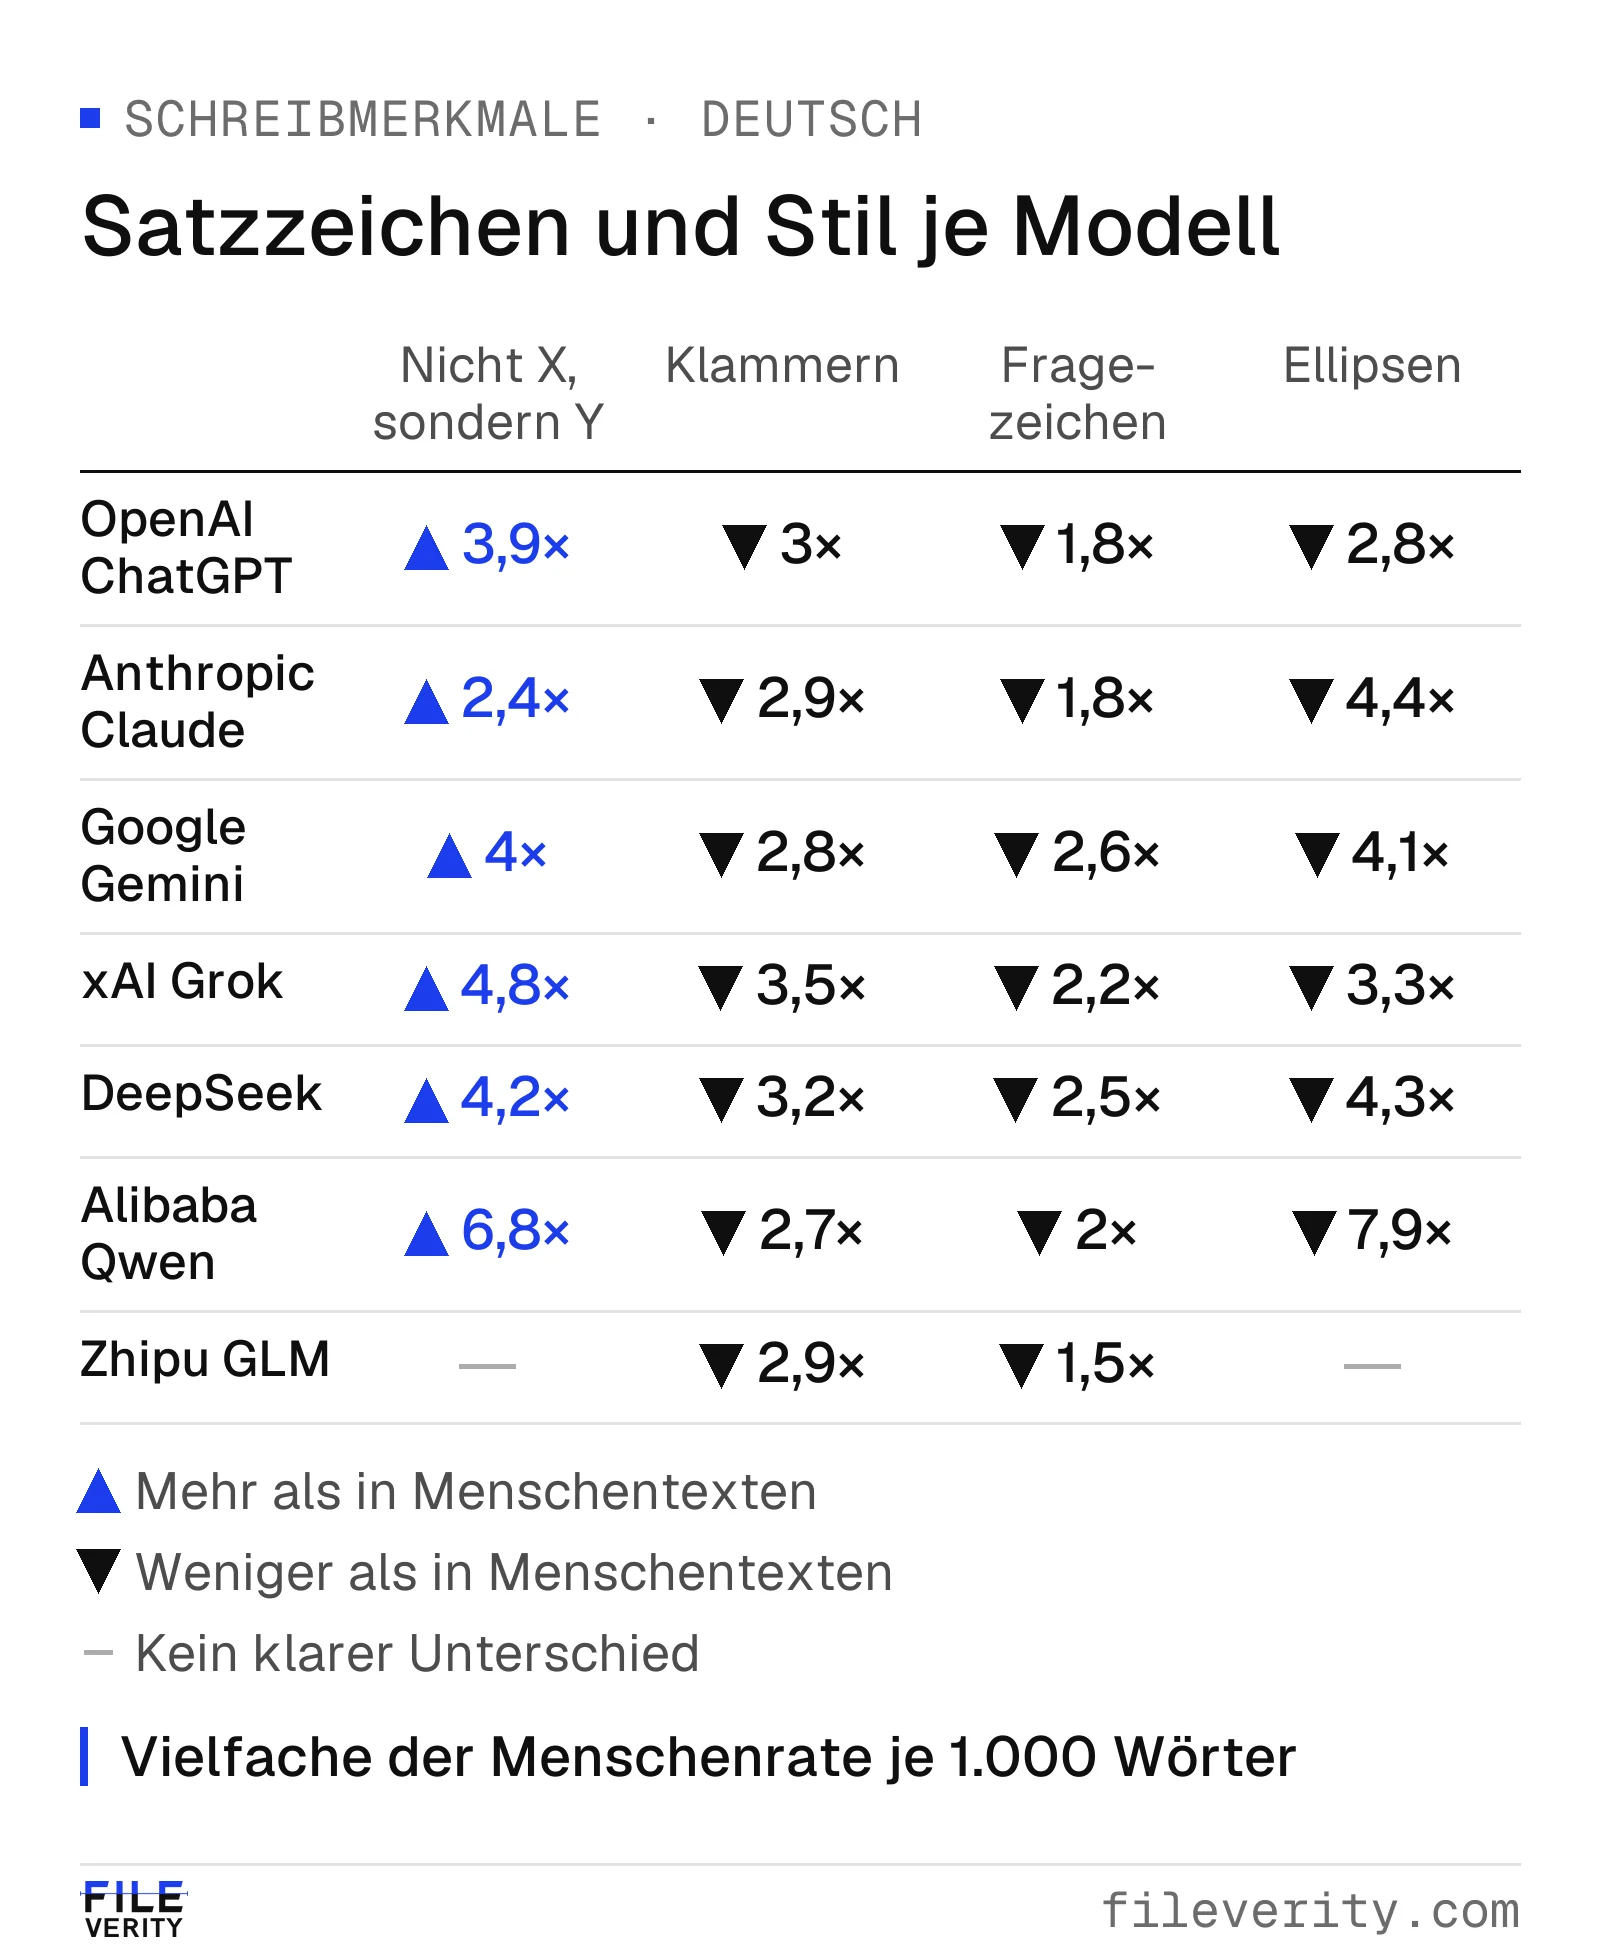
Die Zahlen sind Vielfache der Menschenrate je 1.000 Wörter: KI-Text klammert, fragt und zögert seltener und setzt Gegenüberstellungen häufiger.
Das Muster ist über die Familien hinweg erstaunlich gleichförmig. Alle sieben schreiben mit rund einem Drittel der menschlichen Klammern und deutlich weniger Fragezeichen. Auslassungspunkte, bei Menschen ein Mittel für Zögern und Nachsatz, setzen sechs Familien zwischen 2,8- und 7,9-mal seltener ein, Qwen am seltensten. Gegensätzlich ist die Gegenüberstellung „nicht X, sondern Y“: Sie ist bei sechs Familien deutlich häufiger, bei Claude am wenigsten, bei Qwen am stärksten. Bei GLM ist für diese beiden Merkmale kein klarer Unterschied belegt. Hinzu kommen Merkmale, die sich nicht als Vielfaches ausdrücken lassen: gleichmäßigere Satzlängen bei ChatGPT, Gemini, DeepSeek, Qwen und GLM, weniger Ausrufezeichen bei sechs Familien. Aufzählungszeilen sind in der Aufstellung nur eingeschränkt aussagekräftig, weil die KI-Texte als einfache Fließtexte erzeugt wurden.
So sind die Zahlen entstanden
Für jede Familie wurden vollständig erzeugte Texte mit menschlichen Texten derselben Sprache verglichen. Die menschlichen Texte wurden so gewichtet, dass sie dieselbe Mischung aus Quellen und Textsorten haben wie die KI-Texte; Thema und Genre treiben das Ergebnis also nicht. Ein zweiter Vergleich mit den menschlichen Originalen, aus denen die KI-Texte hervorgingen, diente als Gegenprobe.
Die Wendungen sind Wortfolgen aus ein bis drei Wörtern, bewertet mit einem Log-Odds-Verhältnis. Behalten wurden nur Wendungen, die in vielen Dokumenten aus mehreren Quellen und Textsorten vorkommen, die weder reine Füllwörter noch Zahlen, Namen oder Themenwörter sind und die in zwei zufälligen Hälften der Daten in dieselbe Richtung zeigen. Die Strukturmerkmale stammen aus dem Rohtext und gelten nur, wenn beide Hälften und beide Aufgabenarten, Schreiben und Umschreiben, dieselbe Richtung zeigen. Der Vergleich mit anderen KI-Familien gewichtet jede Familie gleich.
Grenzen: ein Signal, kein Beweis
Menschen schreiben „entscheidend ist“ und „im alltag“ auch, sie verwenden Klammern und Fragezeichen, und wer häufig mit KI arbeitet, übernimmt ihre Wendungen. Die Faktoren beschreiben Familien, nicht Einzelne. Ein einzelner Text enthält meist nur wenige der Wendungen, Prompts und Textsorte verschieben den Stil, und nach dem Umschreiben von Hand verschwinden viele Merkmale. Wer allein wegen einer Phrasenliste urteilt, wird sich irren, in beide Richtungen.
Zwei weitere Grenzen: Die Listen gelten für Deutsch und für die Modelle, die im Korpus vertreten sind. Neue Modellversionen verschieben die Vorlieben. Und eine Familie sagt nichts über den Anbieter eines bestimmten Textes: Texte lassen sich überarbeiten, übersetzen und zwischen Modellen weiterreichen.
Warum Veread weit mehr liest als Phrasenlisten
Phrasenlisten sind greifbar, aber grob. Veread 1.1, das Textmodell von Fileverity, liest den ganzen Text und bewertet ihn passagenweise: den Verlauf des Textes und das Zusammenspiel vieler kleiner Signale, die sich nicht als Liste fassen lassen. Es kennt Familien auch dort, wo kein einzelnes Wort auffällt, und es arbeitet in sieben Sprachen mit einem Modell. In der Auswertung erhielten 0,28 % der von Menschen verfassten Texte einen KI-Befund, 98,6 % der vollständig KI-geschriebenen Texte wurden erkannt, und bei Modellen, die in der Entwicklung nie verwendet wurden, waren es 94,9 %. Die Bedingungen stehen auf der Seite Zuverlässigkeit der Dokumentprüfung und im Leitfaden Veread: Genauigkeit und Fehlalarme.
Wenn Sie wissen wollen, ob ein Text nach KI klingt, fügen Sie ihn in die KI-Erkennung für Texte ein: Sie sehen die Passagen, die den Befund tragen, und die Schreibstil-Ähnlichkeit mit den Modellfamilien. Text auf einer Webseite oder in einem Google-Docs-Dokument prüfen Sie auch direkt dort mit der Chrome-Erweiterung von Fileverity. Ob ein Anbieter seine Texte zusätzlich mit einem Wasserzeichen markiert, erklärt der Leitfaden KI-Textwasserzeichen 2026: Wer markiert, wer prüft.
Fragen zu den Schreibmerkmalen
Woran erkenne ich einen ChatGPT-Text auf Deutsch?
An Wendungen wie „entscheidend ist“, „von bedeutung“ und „deshalb nicht“, an Gegenüberstellungen nach dem Muster „nicht X, sondern Y“ und an gleichmäßigen Sätzen mit wenigen Klammern und Fragezeichen. Jedes dieser Merkmale kommt auch bei Menschen vor; erst die Häufung macht es zum Indiz.
Lässt sich Claude von ChatGPT unterscheiden?
Teilweise. Claude schreibt häufiger „weist darauf hin“, „hinzu kommt“ und „nur eingeschränkt“, ChatGPT eher „entscheidend ist“ und „ohne weiteres“. Claude nutzt außerdem weniger „nicht X, sondern Y“. Bei kurzen Texten reicht das für keine sichere Zuordnung.
Sind die Faktoren eine Erkennungsquote?
Nein. „27-mal so häufig“ sagt, wie viel öfter eine Wendung in KI-Text der Familie vorkommt als in menschlichem Text, und nicht, in wie vielen Texten sie auftaucht oder wie zuverlässig sie einen Text als KI-Text ausweist.
Warum sind die Aussagen zu GLM zurückhaltender?
Bei GLM haben auf Deutsch nur wenige Wendungen alle Stabilitätsprüfungen bestanden. Bei Qwen sind die Wendungen dagegen gut belegt. GLM liegt im Deutschen nah an den übrigen KI-Modellen, deshalb stützt sich die Zuordnung dort stärker auf Struktur und Gesamtstil.
Gelten die Listen auch für andere Sprachen?
Nein. Sie gelten für Deutsch. Jede Sprache hat eigene Wendungen und eigene Faktoren; die Familien selbst bleiben dieselben.
Von Yang Zheng