Erkennung bewerten
KI-Textwasserzeichen 2026: Wer markiert ChatGPT-, Claude- und Gemini-Texte und wer kann sie prüfen?
Welche Anbieter KI-Text 2026 markieren: OpenAI, Anthropic, Google, xAI, DeepSeek. Wie Textwasserzeichen funktionieren und was sie nicht belegen.
Veröffentlicht · Aktualisiert · 9 Min. Lesezeit
Auf dieser Seite
Stand 10. November 2026: Anthropic und Google markieren ihre Texte mit einem statistischen Wasserzeichen, OpenAI tut es in ChatGPT nur in der EU, xAI bietet es nur in der API an und liefert es standardmäßig nicht aus, und DeepSeek, Qwen und GLM setzen auf sichtbare Kennzeichnungen statt auf ein prüfbares Textwasserzeichen. Ein öffentliches Werkzeug, in das Sie einen Text einfügen und eine Antwort erhalten, gibt es bei keinem der fünf Anbieter. Wer das Wasserzeichen lesen darf, entscheidet der Anbieter, und er entscheidet es nach Antrag.
Dieser Leitfaden ordnet ein, was die Anbieter tatsächlich veröffentlicht haben, wie ein Textwasserzeichen technisch funktioniert, was ein Fund beweist und was nicht, und warum für Schulen, Redaktionen und Personalabteilungen die Prüfung des Schreibstils derzeit der einzige Weg bleibt, der jedem offensteht. Alle Angaben stammen von den Seiten der Anbieter und tragen ihr Prüfdatum. Die Lage ändert sich schnell, deshalb tragen die Angaben ihr Datum.
Wer KI-Text 2026 markiert: die Übersicht
Fünf Anbieter, vier Fragen: Gibt es ein Textwasserzeichen, wo ist es eingeschaltet, wer kann es prüfen, und kann es die Öffentlichkeit prüfen? Die Übersicht zeigt den Stand vom 10. November 2026.
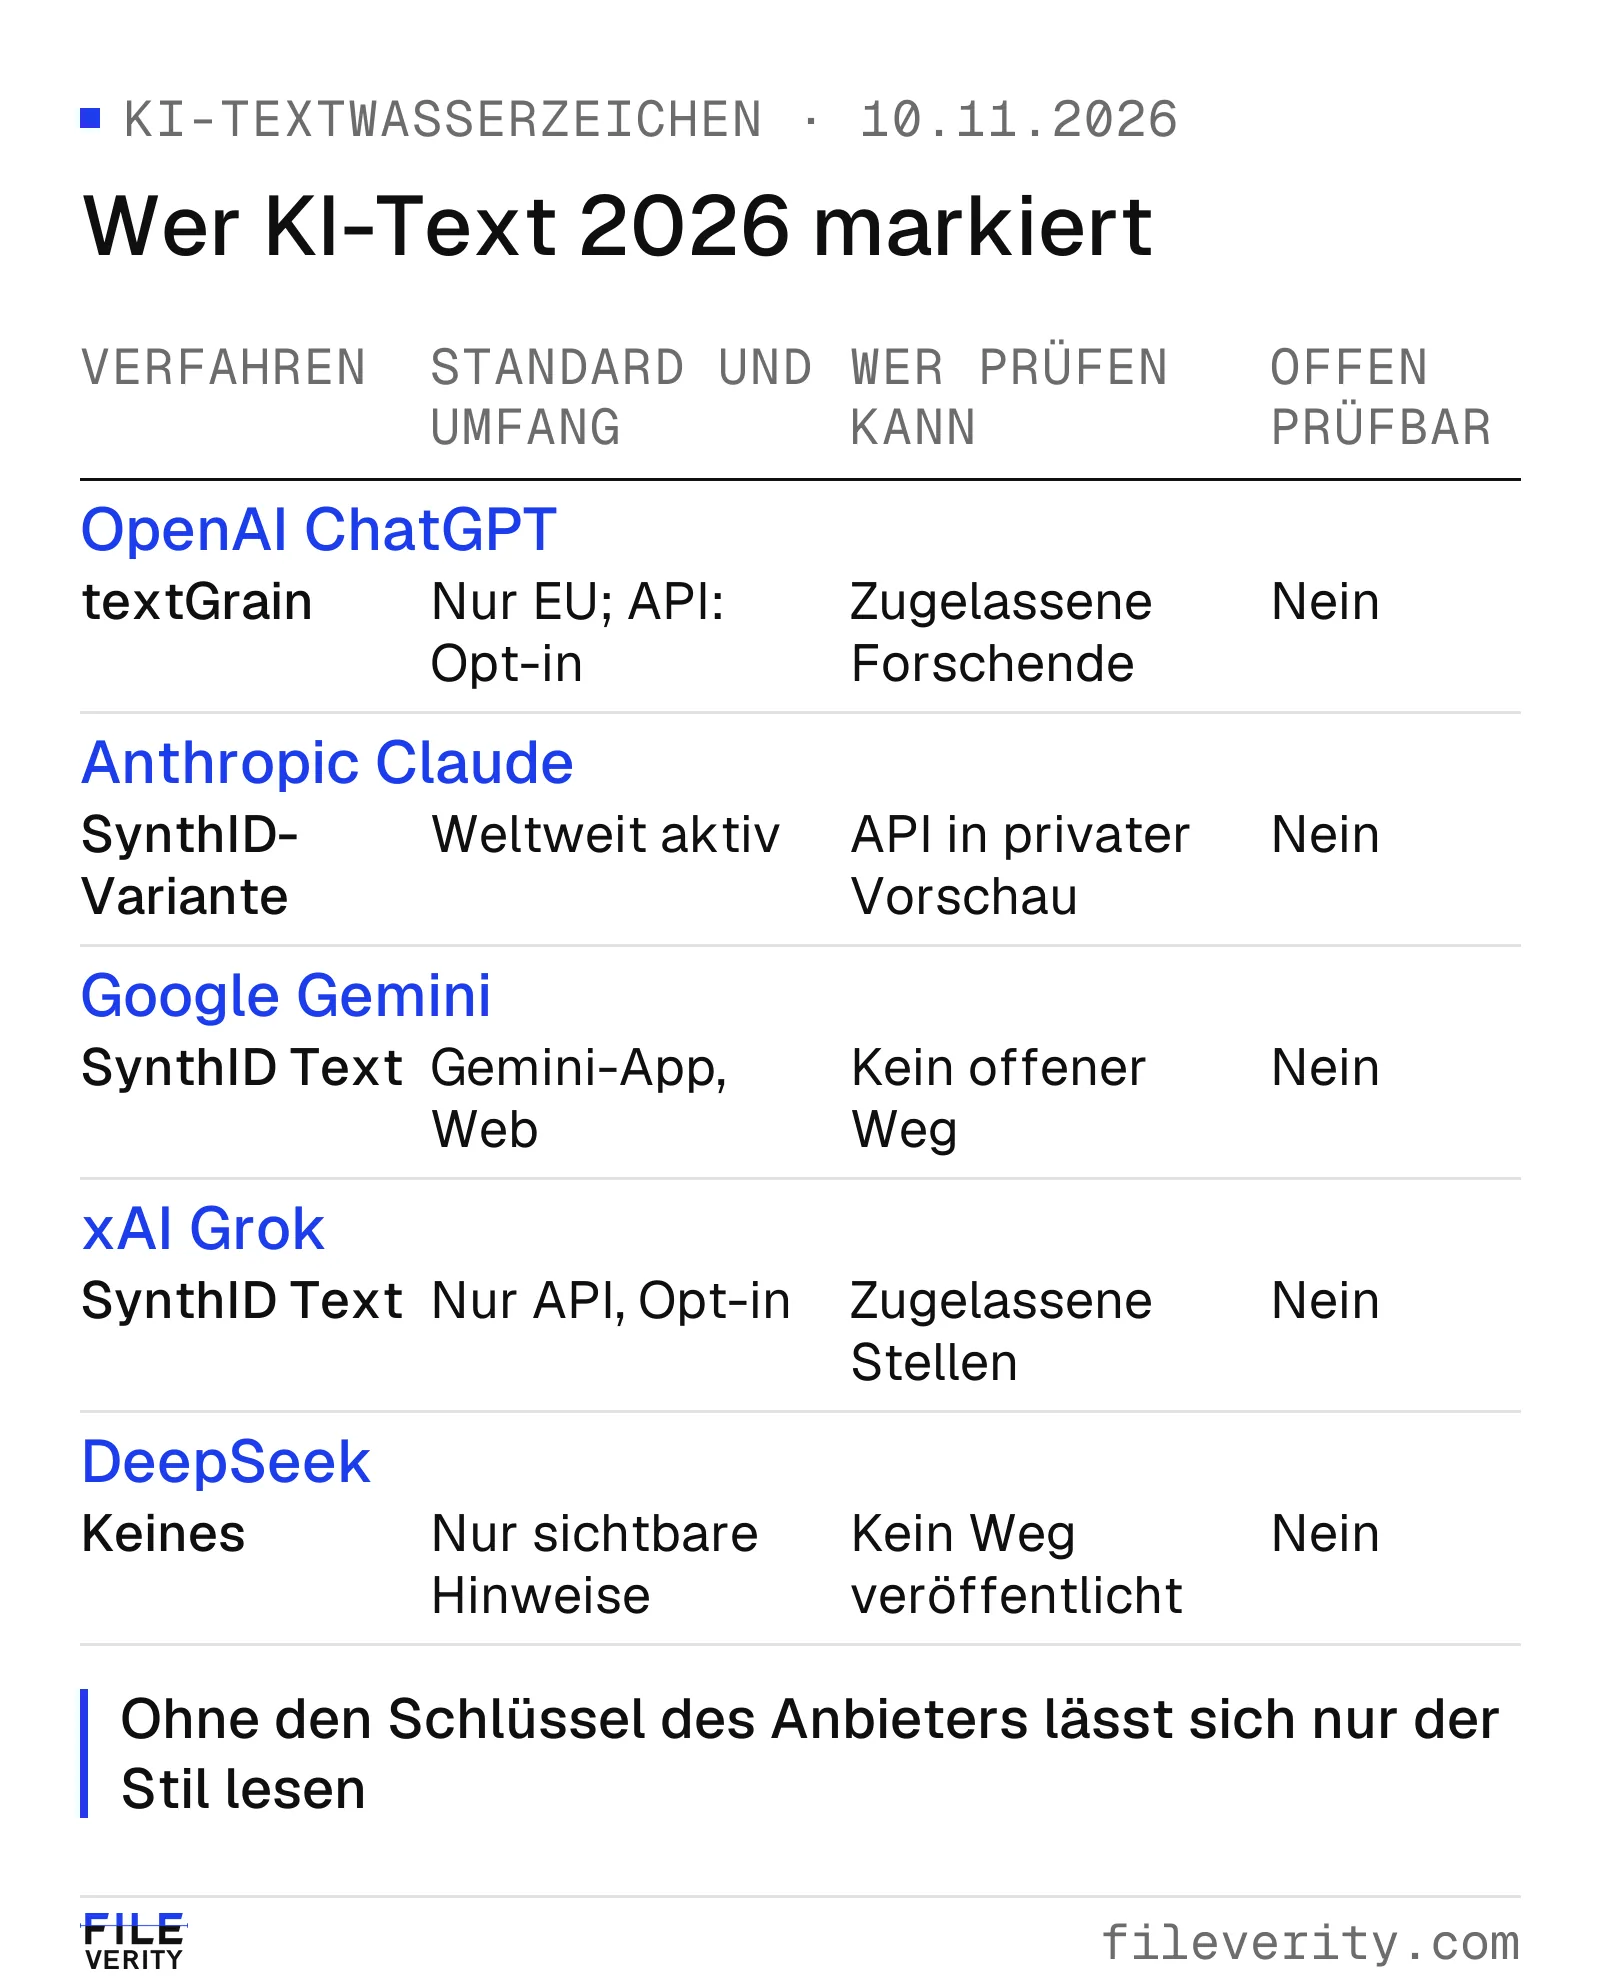
Bei keinem der fünf Anbieter kann ein Mensch ohne Antrag prüfen, ob ein Text ein Wasserzeichen trägt.
Drei Dinge fallen auf. Erstens ist das Verfahren fast überall dasselbe Prinzip, eine statistische Verschiebung der Wortwahl, und nur die Voreinstellung unterscheidet sich: Anthropic markiert weltweit, OpenAI nur in der EU, xAI nur auf Wunsch. Zweitens ist die Prüfung überall beschränkt: auf zugelassene Forschende, Organisationen mit Antrag oder gar niemanden. Drittens betrifft Googles öffentlicher SynthID Detector Bilder, Video und Audio, aber keinen Text.
Wie ein statistisches Textwasserzeichen funktioniert
Ein Textwasserzeichen fügt dem Text nichts hinzu: keine versteckten Zeichen, keine zusätzlichen Wörter. Es wirkt in dem Moment, in dem das Sprachmodell das nächste Wort auswählt. Ein geheimer Schlüssel und die unmittelbar vorangehenden Wörter legen fest, welche Kandidaten für das nächste Wort einen etwas höheren Wert erhalten. Das Modell wählt dann unter ähnlich guten Wörtern minimal öfter die höher bewerteten. Ein einzelner Satz verrät dadurch nichts, über viele Wörter summiert sich die Verschiebung aber zu einem Muster.
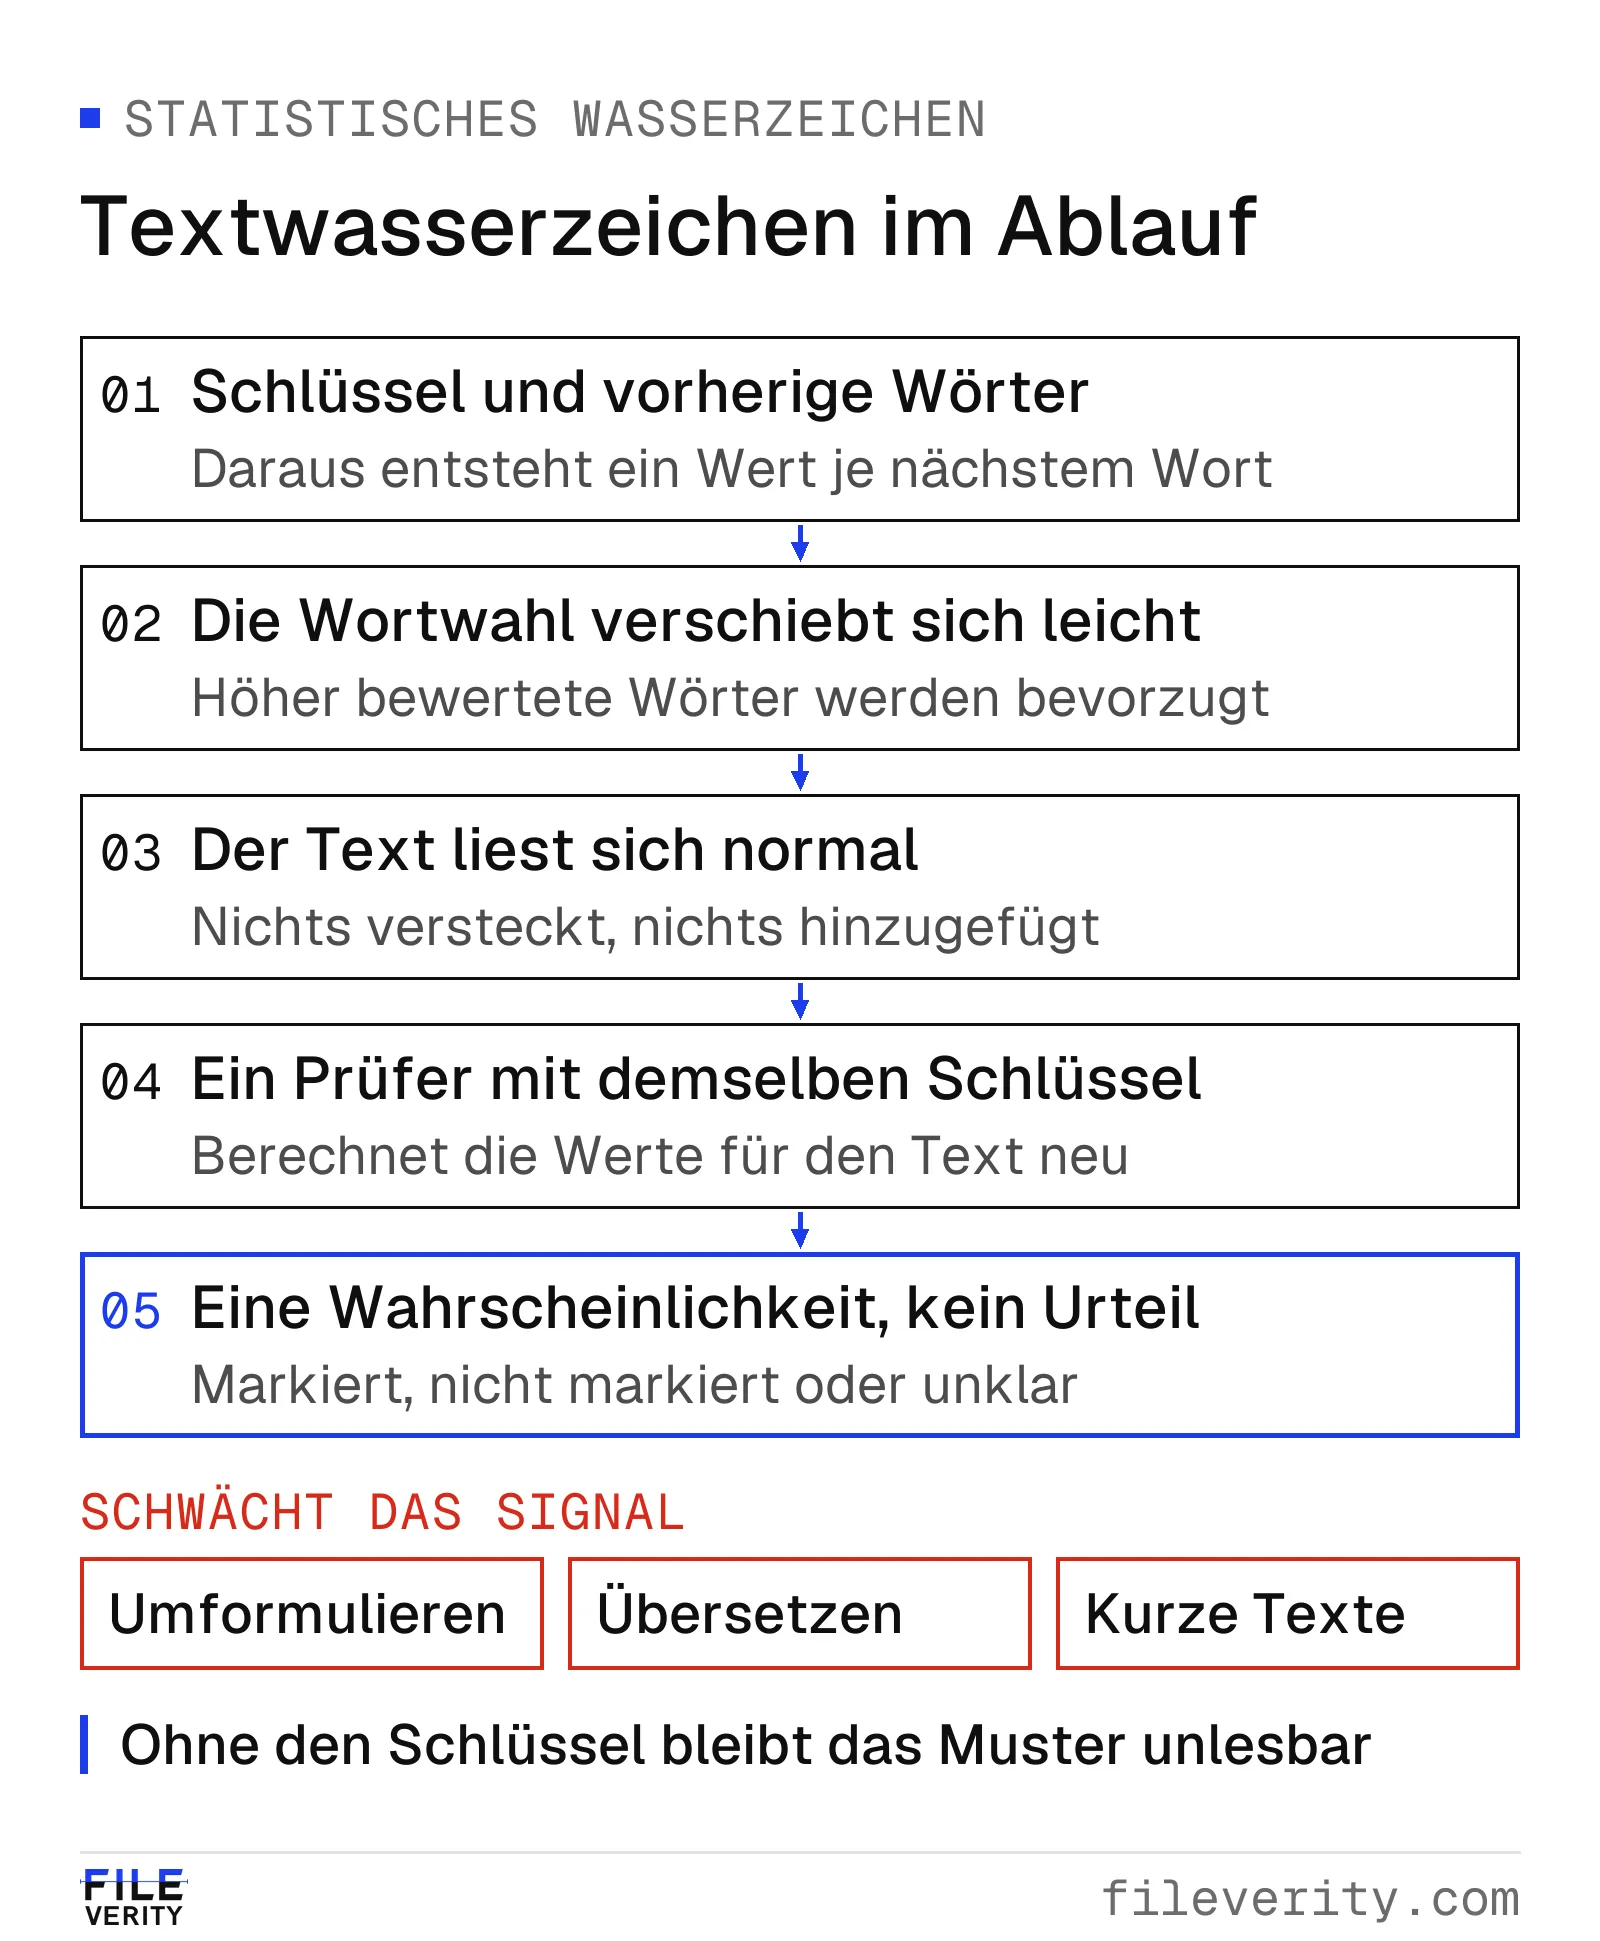
Ohne den Schlüssel bleibt das Muster unlesbar, deshalb kann nur der Anbieter oder wer von ihm zugelassen ist, es prüfen.
Die Prüfung läuft spiegelbildlich. Ein Prüfer, der denselben Schlüssel besitzt, berechnet für jedes Wort des Textes die Werte neu und fragt, ob die Wörter auffällig oft zu den höher bewerteten gehören. Das Ergebnis ist eine Wahrscheinlichkeit und kein Urteil. Bei Googles SynthID Text und bei xAI lautet die Antwort ausdrücklich markiert, nicht markiert oder unklar; je länger der Text, desto stärker das Signal.
Drei Dinge schwächen das Signal, und alle drei kommen im Alltag vor:
- Umformulieren. Wer einen Text weitgehend neu schreibt, ersetzt die Wortwahl, auf der das Muster beruht. Anthropic nennt das vollständige Umschreiben als Weg, das Wasserzeichen zu entfernen; Google schreibt, dass Konfidenzwerte nach starkem Umschreiben oder Übersetzen deutlich sinken können.
- Übersetzen. Die Wörter wechseln, damit auch die Statistik. Allerdings trägt eine von Claude selbst erzeugte Übersetzung nach Angabe von Anthropic das Wasserzeichen wieder.
- Kurze Texte und Sachtexte. Wenige Wörter liefern wenig Statistik, und bei Fakten, Zahlen und Code gibt es kaum Spielraum bei der Wortwahl. Google nennt Antworten auf Faktenfragen weniger geeignet, Anthropic sagt dasselbe für Sachpassagen und Code.
Was ein Wasserzeichen belegt und was nicht
Ein gefundenes Wasserzeichen ist ein starkes Indiz dafür, dass ein Modell des jeweiligen Anbieters an dem Text beteiligt war. Mehr behaupten die Anbieter selbst nicht. Anthropic schreibt, ein Fund sei ein Signal, aber nicht vollständig schlüssig, und das Wasserzeichen könne „Claude hat das geschrieben“ nicht von „Claude hat das stark überarbeitet“ unterscheiden. OpenAI hält fest, dass ein Wasserzeichen weder die Nutzerin identifiziert noch den menschlichen Anteil misst noch Urheberschaft belegt.
Wichtiger für die Praxis ist die Gegenrichtung. Fehlt das Wasserzeichen, folgt daraus nichts. OpenAI schreibt, dass ein nicht erkanntes Wasserzeichen keine menschliche Autorschaft beweist, und Anthropic sagt dasselbe für Claude. Ein Text kann von einem Modell stammen, das gar nicht markiert, aus einer Einstellung, in der die Markierung aus war, oder aus einem Modell, das nach dem Wasserzeichen umgeschrieben wurde. Wer ein Prüfergebnis „kein Wasserzeichen gefunden“ als Entlastung versteht, liest es falsch.
Die Anbieter im Einzelnen
OpenAI: textGrain für ChatGPT und Codex in der EU
Am 5. Oktober 2026 hat OpenAI textGrain vorgestellt, ein unsichtbares statistisches Signal in der Wortwahl. In ChatGPT und Codex soll es für geeignete Texte nur in der EU eingefügt werden, über alle Tarife, laut OpenAI „in den kommenden Wochen“; einen genauen Starttermin nennt OpenAI nicht, und es gilt ausdrücklich nicht als weltweite Voreinstellung. API-Kunden können es weltweit für ausgewählte Modelle einschalten; in der API ist es standardmäßig aus. Den Detektor gibt es nicht öffentlich: Anträge sind möglich, der Zugang erfolgt im Einzelfall, zunächst für zugelassene Forschende und Fachorganisationen. Betrugsprävention, Weiterverkauf und die Prüfung von Studienleistungen fallen laut OpenAI nicht in das Programm. Die Einordnung für Nutzer von ChatGPT lesen Sie bei ChatGPTDetect.
Anthropic: ein SynthID-ähnliches Verfahren für Claude, weltweit
Anthropic hat am 14. August 2026 beschrieben, wie das Claude-Wasserzeichen funktioniert (aktualisiert am 1. September). Es ist eine Variante des SynthID-Text-Ansatzes von Google DeepMind, fügt keine Zeichen hinzu und gilt weltweit, nicht regional begrenzt. Nach der Hilfeseite von Anthropic (Stand 10. November 2026) tragen Modelle, die ab dem 2. August 2026 erschienen sind, die Markierung von Beginn an; frühere Modelle sind inzwischen ebenfalls aufgeführt. Anthropic gibt an, das Verfahren zur Einhaltung des EU AI Act einzusetzen, und hat im Juli 2026 den EU-Verhaltenskodex zur Transparenz KI-generierter Inhalte unterzeichnet. Die Erkennung läuft über eine API in privater Vorschau für berechtigte Organisationen, etwa Aufsichtsbehörden, Medien, Faktenprüfer, Forschende und Bildungseinrichtungen. Einzelpersonen können Texte nicht selbst prüfen. Details zu Modellen und Grenzen bei ClaudeDetect.
Google: SynthID Text in Gemini, öffentlicher Detektor nur für Medien
Google hat bereits am 14. Mai 2024 angekündigt, Text aus der Gemini-App und im Web mit SynthID zu markieren, und führt das auf der aktuellen DeepMind-Seite weiter aus. SynthID Text ist quelloffen. Wer prüfen darf, legt der Betreiber eines Modells fest: privat, halb privat über eine API oder öffentlich. Googles SynthID Detector wurde am 7. Oktober 2026 für alle geöffnet, prüft aber ausdrücklich Bild-, Video- und Audiodateien; Text wird dort nicht erwähnt, und auf den gelesenen Google-Seiten fand sich kein öffentlicher Weg, Gemini-Text zu verifizieren. Das ist eine Feststellung über das Veröffentlichte, keine Aussage Googles. Die Zusammenfassung finden Sie bei GeminiDetect.
xAI: Textwasserzeichen in der Grok-API, standardmäßig aus
Nach der Dokumentation von xAI, zuletzt aktualisiert am 9. November 2026, ist das Textwasserzeichen standardmäßig aus; Administratoren eines Teams schalten es pro Modell ein. Es gilt für Text aus den Schnittstellen Responses und Chat Completions bei den freigegebenen Grok-Modellen. xAI nennt als Technik SynthID Text aus der Veröffentlichung von Google DeepMind. Die Antwort der API trägt dann den Header x-watermark mit dem Wert true. Die Erkennung ist statistisch und liefert markiert, nicht markiert oder unklar; der Zugang zur Erkennungs-API wird auf Antrag vergeben, ein öffentlicher Prüfer wurde nicht gefunden. Texte aus der Grok-App oder aus Teams, die die Funktion nicht aktiviert haben, tragen deshalb nichts, was sich finden ließe. Mehr bei GrokDetect.
DeepSeek, Qwen und GLM: Kennzeichnung nach chinesischem Recht
Chinas Maßnahmen zur Kennzeichnung KI-generierter Inhalte sind seit dem 1. September 2025 in Kraft. Sie verlangen sichtbare Hinweise für Nutzer und implizite Kennzeichnungen in den Metadaten von Dateien. DeepSeek nennt in seinen Nutzungsbedingungen Hinweise innerhalb der Plattform, die an den KI-Ursprung erinnern, und verbietet, sie zu entfernen oder zu umgehen. Ein verstecktes statistisches Textwasserzeichen oder ein öffentliches Prüfwerkzeug hat DeepSeek nach den gelesenen Quellen nicht veröffentlicht; das ist ein Befund über die Quellenlage, kein Beweis, dass es nichts gibt. Ein Metadatenvermerk geht beim Kopieren von reinem Text ohnehin verloren. Für Qwen und GLM wurde keine Anbieteraussage zu einem Textwasserzeichen gefunden. Die Seite zu DeepSeek: DeepSeekDetect.
Warum der EU AI Act das Thema antreibt
Artikel 50 des EU AI Act verpflichtet Anbieter von KI-Systemen, die synthetische Texte erzeugen, deren Ausgaben in einem maschinenlesbaren Format als künstlich erzeugt zu kennzeichnen. Ein statistisches Wasserzeichen ist eine technische Antwort auf diese Pflicht, und genau so begründen es die Anbieter: OpenAI nennt für ChatGPT in der EU den AI Act und den Verhaltenskodex zur Transparenz KI-generierter Inhalte, Anthropic nennt den AI Act und hat den Kodex unterzeichnet, xAI schreibt, das Wasserzeichen könne bei der Einhaltung helfen. Das passt dazu, dass OpenAI in ChatGPT nur in der EU markiert, während Anthropic weltweit einheitlich vorgeht.
Die Pflicht schafft allerdings keinen öffentlichen Prüfer. Sie verlangt die Kennzeichnung, nicht, dass jede Lehrerin, jeder Redakteur und jede Personalerin sie lesen kann. Für den Alltag in Deutschland, Österreich und der Schweiz ändert sich dadurch zunächst wenig: Die Markierung ist im Text, den Schlüssel haben andere.
Warum für die Praxis nur die Stilprüfung offensteht
Wer einen Text prüfen muss, hat drei Möglichkeiten. Er kann den Anbieter um Zugang bitten, was nur für Forschung, Aufsicht und ausgewählte Organisationen vorgesehen ist. Er kann die Herkunft über den Entstehungsweg klären, etwa über Versionsverlauf, Entwürfe und Gespräch mit der Verfasserin. Oder er kann prüfen, wie der Text geschrieben ist.
Die Stilprüfung braucht keinen Schlüssel. Sie liest den Text so, wie ein Modell ihn geschrieben hätte, und vergleicht ihn mit dem Schreiben von Menschen. Das liefert ein anderes Ergebnis als ein Wasserzeichen: keine Gewissheit über einen bestimmten Anbieter, sondern die Frage, ob und in welchen Passagen der Text wie KI-Text wirkt. Veread 1.1, das Textmodell von Fileverity, arbeitet so. In der Auswertung erhielten 0,28 % der von Menschen verfassten Texte einen KI-Befund, 98,6 % der vollständig KI-geschriebenen Texte wurden erkannt, und bei Modellen, die in der Entwicklung nie verwendet wurden, waren es 94,9 %. Alle Werte und Bedingungen stehen auf der Seite Zuverlässigkeit der Dokumentprüfung und im Leitfaden Veread: Genauigkeit und Fehlalarme.
Auch die Stilprüfung ist ein Indiz und kein Beweis. Sie ergänzt ein Wasserzeichen, wo es eines gibt, und sie funktioniert dort, wo keines existiert: bei Modellen ohne Markierung, bei Texten aus Einstellungen mit ausgeschalteter Markierung und bei Texten, die stark überarbeitet wurden. Sie lässt sich auf jeden Text anwenden, den Sie einfügen. Die Familien-Ergebnisse der fünf Prüfseiten sind eine Schreibstil-Ähnlichkeit mit der jeweiligen Modellfamilie und kein Wasserzeichenbefund. Welche Formulierungen die Familien unterscheiden, zeigt der Leitfaden Woran erkennt man, welche KI einen Text geschrieben hat?
Mit der KI-Erkennung für Texte fügen Sie einen Text ein und sehen in Sekunden, welche Passagen wie KI-Text wirken. Wer Texte auf Webseiten oder in Google Docs liest, kann sie mit der Chrome-Erweiterung von Fileverity an Ort und Stelle prüfen, ohne sie einzufügen. Für Bilder, Video und Audio ist die Lage eine andere, dort gibt es öffentliche Prüfer und signierte Herkunftsdaten; das erklärt der Leitfaden C2PA, KI-Wasserzeichen oder Bilddetektor.
Fragen zu KI-Textwasserzeichen
Kann ich selbst prüfen, ob ein Text ein ChatGPT- oder Claude-Wasserzeichen trägt?
Nein. Bei OpenAI und Anthropic ist der Detektor nicht öffentlich: OpenAI vergibt Zugang im Einzelfall an zugelassene Forschende und Fachorganisationen, Anthropic bietet eine API in privater Vorschau für berechtigte Organisationen. Ein Werkzeug, das Ihnen ein Wasserzeichen bestätigt, ohne den Schlüssel des Anbieters zu haben, kann es nicht lesen.
Beweist ein fehlendes Wasserzeichen, dass ein Mensch geschrieben hat?
Nein. Die Anbieter selbst sagen das ausdrücklich. Text kann aus Modellen ohne Markierung stammen, aus Einstellungen mit ausgeschalteter Markierung, aus Regionen, in denen der Anbieter nicht markiert, oder nach starkem Umschreiben.
Markiert Gemini Text, und kann ich ihn mit dem SynthID Detector prüfen?
Google markiert Text aus der Gemini-App und dem Web mit SynthID. Der öffentliche SynthID Detector prüft laut Google Bild-, Video- und Audiodateien; Text wird dort nicht genannt, und ein öffentlicher Weg für Gemini-Text wurde nicht gefunden.
Markiert Grok seine Texte?
Nur in der API und nur, wenn ein Team-Administrator es für ein Modell einschaltet. Standardmäßig ist es aus, und die Grok-App ist nicht Teil der dokumentierten Funktion.
Was bleibt, wenn es kein Wasserzeichen zu lesen gibt?
Die Prüfung des Schreibstils. Sie liefert ein Indiz auf Passagenebene, das Sie mit Entwürfen, Versionsverlauf und einem Gespräch mit der Verfasserin abgleichen. Ein Ergebnis allein sollte keine Entscheidung über eine Person tragen.
Von Yang Zheng