Erkennung bewerten
Veread 1.1 erkennt 98,6 % der KI-geschriebenen Texte bei nur 0,28 % Fehlalarmen
Veread 1.1 erkannte 98,6 % der vollständig KI-geschriebenen Texte bei nur 0,28 % Fehlalarmen in sieben Sprachen. Ergebnisse nach Sprache, Art des Textes und Modell.
Veröffentlicht · Aktualisiert · 8 Min. Lesezeit
Auf dieser Seite
Veread 1.1 erkannte in unserer Auswertung 98,6 % der vollständig KI-geschriebenen Texte und 95,9 % aller KI-geschriebenen und KI-unterstützten Texte, bei nur 0,28 % Fehlalarmen auf von Menschen verfassten Texten, über sieben Sprachen. Bei Texten von KI-Modellen, die in seiner Entwicklung nie verwendet wurden, erkannte Veread 94,9 %, und der AUROC liegt bei 0,999 für vollständige Dokumente und bei 0,996 für kurze Auszüge.
Für Schulen, Verlage, Personalabteilungen und Compliance-Teams, die KI-Textdetektoren vergleichen, liefert dieser Bericht die vollständige Übersicht: Fehlalarme nach Sprache und nach Art des Textes, Erkennung nach Sprache, Art des Textes und Modellfamilie, Ergebnisse für gemischte und umgeschriebene Dokumente sowie für kurze Auszüge. Jeder Wert nennt die Bedingungen, unter denen er gemessen wurde.
Modellversion: Veread 1.1, Release 2026.11, seit dem 18. November 2026 im Einsatz. Veread ist das Textmodell zur Erkennung von KI-Texten, das Fileverity selbst entwickelt hat. Es wird auf umfangreichen, exklusiven, professionell aufbereiteten eigenen Daten entwickelt und validiert, und ein Modell bedient alle sieben Sprachen. Die Ergebnisse unten bleiben Veread 1.1 zugeordnet, wenn neue Versionen erscheinen. Was sich mit diesem Release geändert hat, steht in der Ankündigung von Veread 1.1.
KI-Text-Erkennung im Test: die vollständige Übersicht
| Kennzahl | Ergebnis | Was sie aussagt |
|---|---|---|
| Von Menschen verfasste Texte mit KI-Befund | 0,28 % | Fehlalarmquote über alle sieben Sprachen |
| Vollständig KI-geschriebene Texte erkannt | 98,6 % | Anteil der komplett von einem KI-Modell geschriebenen Texte, die Veread erkannt hat |
| Alle KI-geschriebenen und KI-unterstützten Texte erkannt | 95,9 % | Vollständig geschriebene, fortgeführte, umgeschriebene und überarbeitete Texte zusammen |
| Texte von KI-Modellen, die in der Entwicklung nie verwendet wurden | 94,9 % | Erkennung bei Modellen, die Veread nicht kannte |
| AUROC, vollständige Dokumente | 0,999 | Wie sauber sich menschlicher und KI-Text über alle Entscheidungspunkte trennen |
| AUROC, kurze Auszüge | 0,996 | Dieselbe Trennung für Auszüge von etwa 100 Wörtern |
Die Erkennung wurde an zurückgehaltenen Testdaten gemessen, die nie für Training, Modellauswahl oder Entscheidungseinstellungen verwendet wurden. Die Fehlalarme wurden an allen zurückgehaltenen Texten von Menschen gemessen: den Testdaten und unabhängigen Panels menschlicher Texte aus Quellen, die nie im Training verwendet wurden. Die Texte reichen von etwa 100 Wörtern aufwärts, und Veread lief mit seinen Produktionseinstellungen. Der AUROC ist eine andere Kennzahl als der Anteil richtig eingestufter Texte: Er misst, wie gut die Werte menschliches und KI-Schreiben trennen, unabhängig davon, welchen Entscheidungspunkt jemand wählt.
Unter 0,5 % Fehlalarme in allen sieben Sprachen
Ein Fehlalarm ist ein von Menschen verfasster Text, der einen KI-Befund erhält. Für eine Schule, einen Verlag oder ein Schadenteam entscheidet diese Zahl darüber, ob ein Detektor bei der Arbeit echter Menschen eingesetzt werden kann. Veread hält sie niedrig: 0,28 % über alle Sprachen, 0,23 % bei vollständigen Dokumenten.
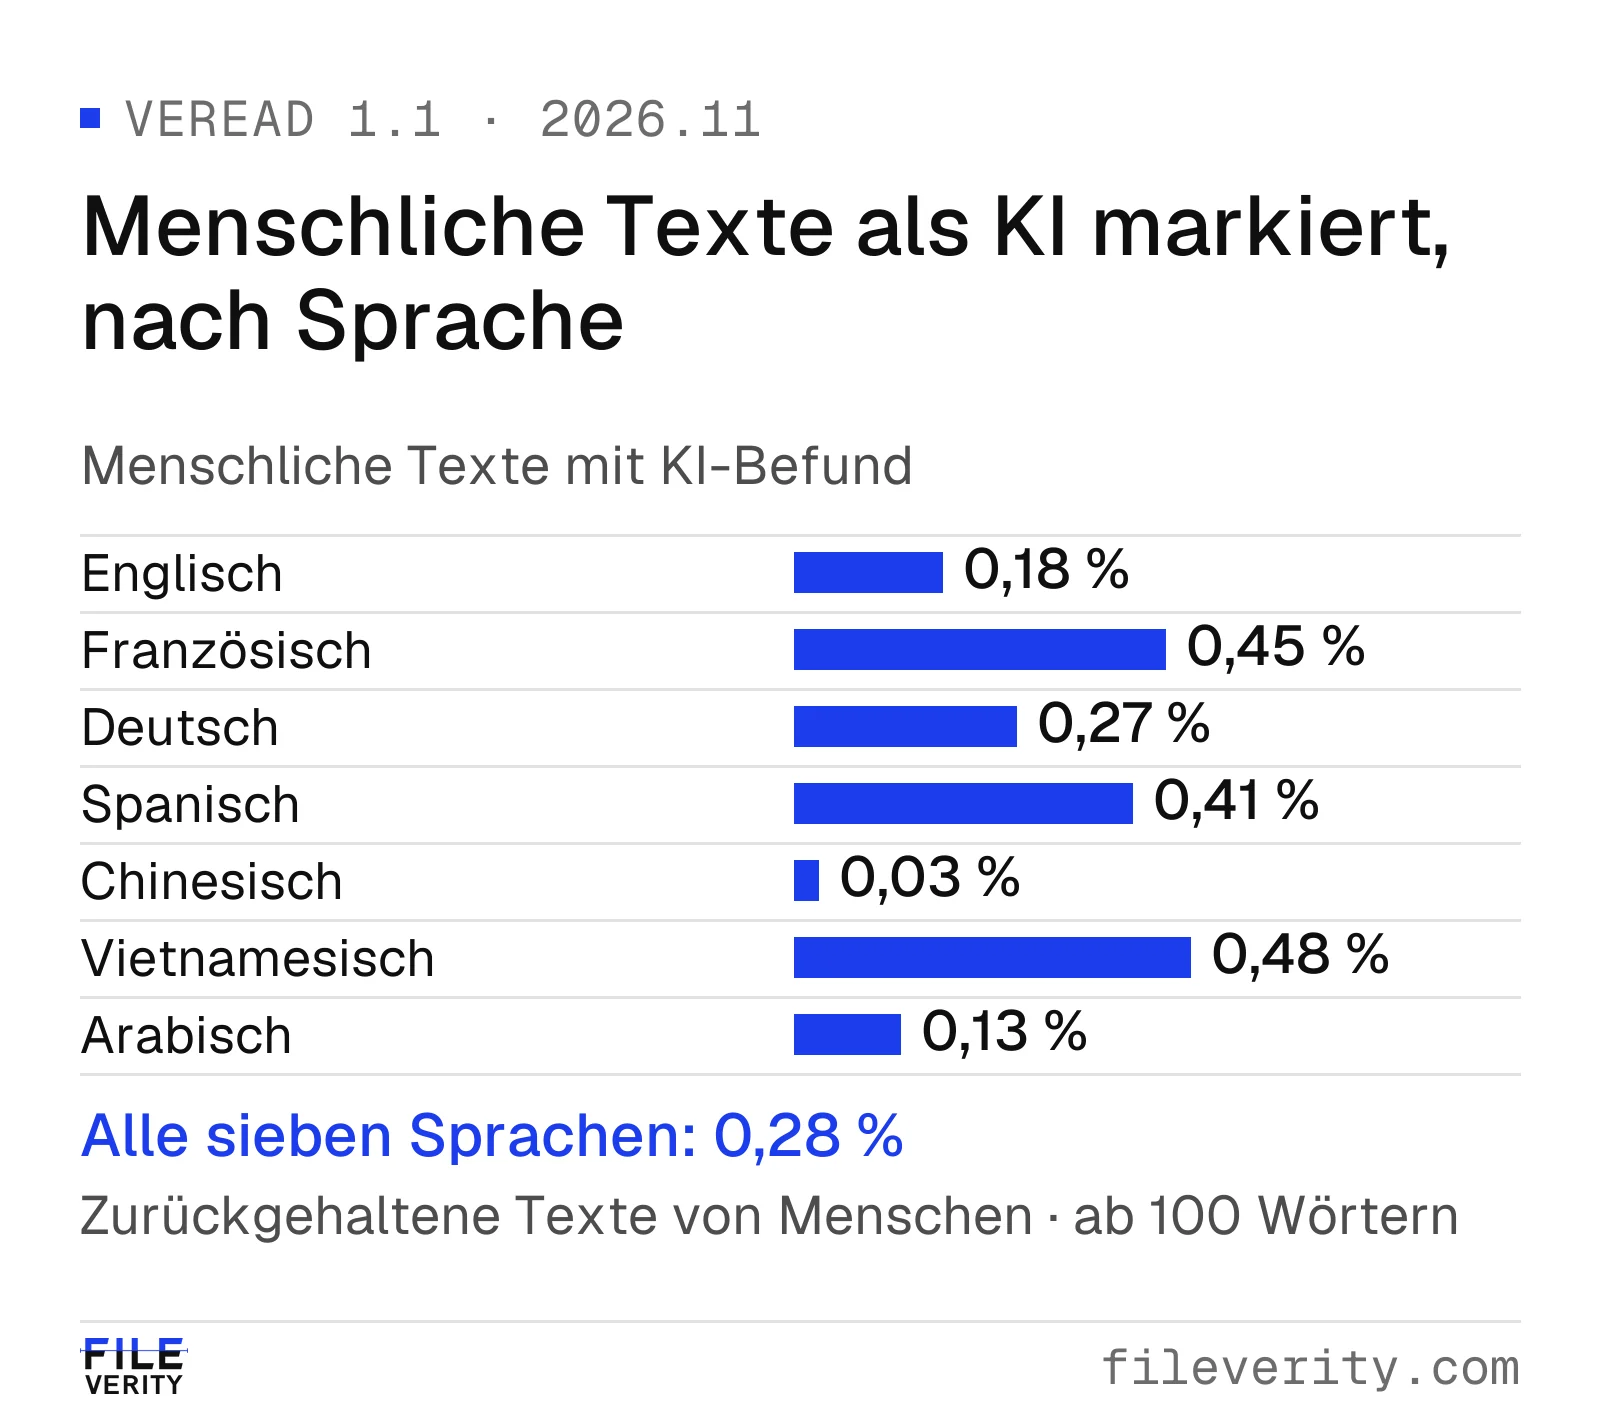
Alle zurückgehaltenen Texte von Menschen ab etwa 100 Wörtern, einschließlich unabhängiger Panels aus Quellen, die nie im Training verwendet wurden. Fileverity-Auswertung · Veread 1.1 · 2026.11.
| Sprache | Menschliche Texte mit KI-Befund | Vollständig KI-geschriebene Texte erkannt | Alle KI-geschriebenen und KI-unterstützten Texte erkannt | AUROC |
|---|---|---|---|---|
| Englisch | 0,18 % | 95,1 % | 94,5 % | 1,000 |
| Französisch | 0,45 % | 99,1 % | 96,8 % | 0,999 |
| Deutsch | 0,27 % | 100 % | 94,1 % | 0,999 |
| Spanisch | 0,41 % | 100 % | 96 % | 1,000 |
| Chinesisch | 0,03 % | 100 % | 98,8 % | 1,000 |
| Vietnamesisch | 0,48 % | 95,5 % | 92,8 % | 0,992 |
| Arabisch | 0,13 % | 98,5 % | 97,5 % | 1,000 |
Die Fehlalarme liegen je nach Sprache zwischen 0,03 und 0,48 %. Englisch, Spanisch, Chinesisch und Arabisch erreichen einen AUROC von 1,000, und Vietnamesisch und Arabisch sind mit derselben Sorgfalt gemessen wie Englisch, Französisch, Deutsch, Spanisch und Chinesisch. Wenn Ihr Team Texte in mehreren Sprachen prüft, erhalten Sie ein Modell und einen Satz gemessener Ergebnisse statt eines eigenen Werkzeugs pro Markt.
Fehlalarme nach Art des Textes
Detektoren verhalten sich je nach Schreibstil unterschiedlich, deshalb haben wir jede Art von Text getrennt gemessen. Jede Art von Text bleibt unter 1 % Fehlalarmen: Enzyklopädische Texte kamen auf 0,04 %, Literatur und kreatives Schreiben auf 0,08 % und Aufsätze von Studierenden und Sprachlernenden auf 0,30 %.
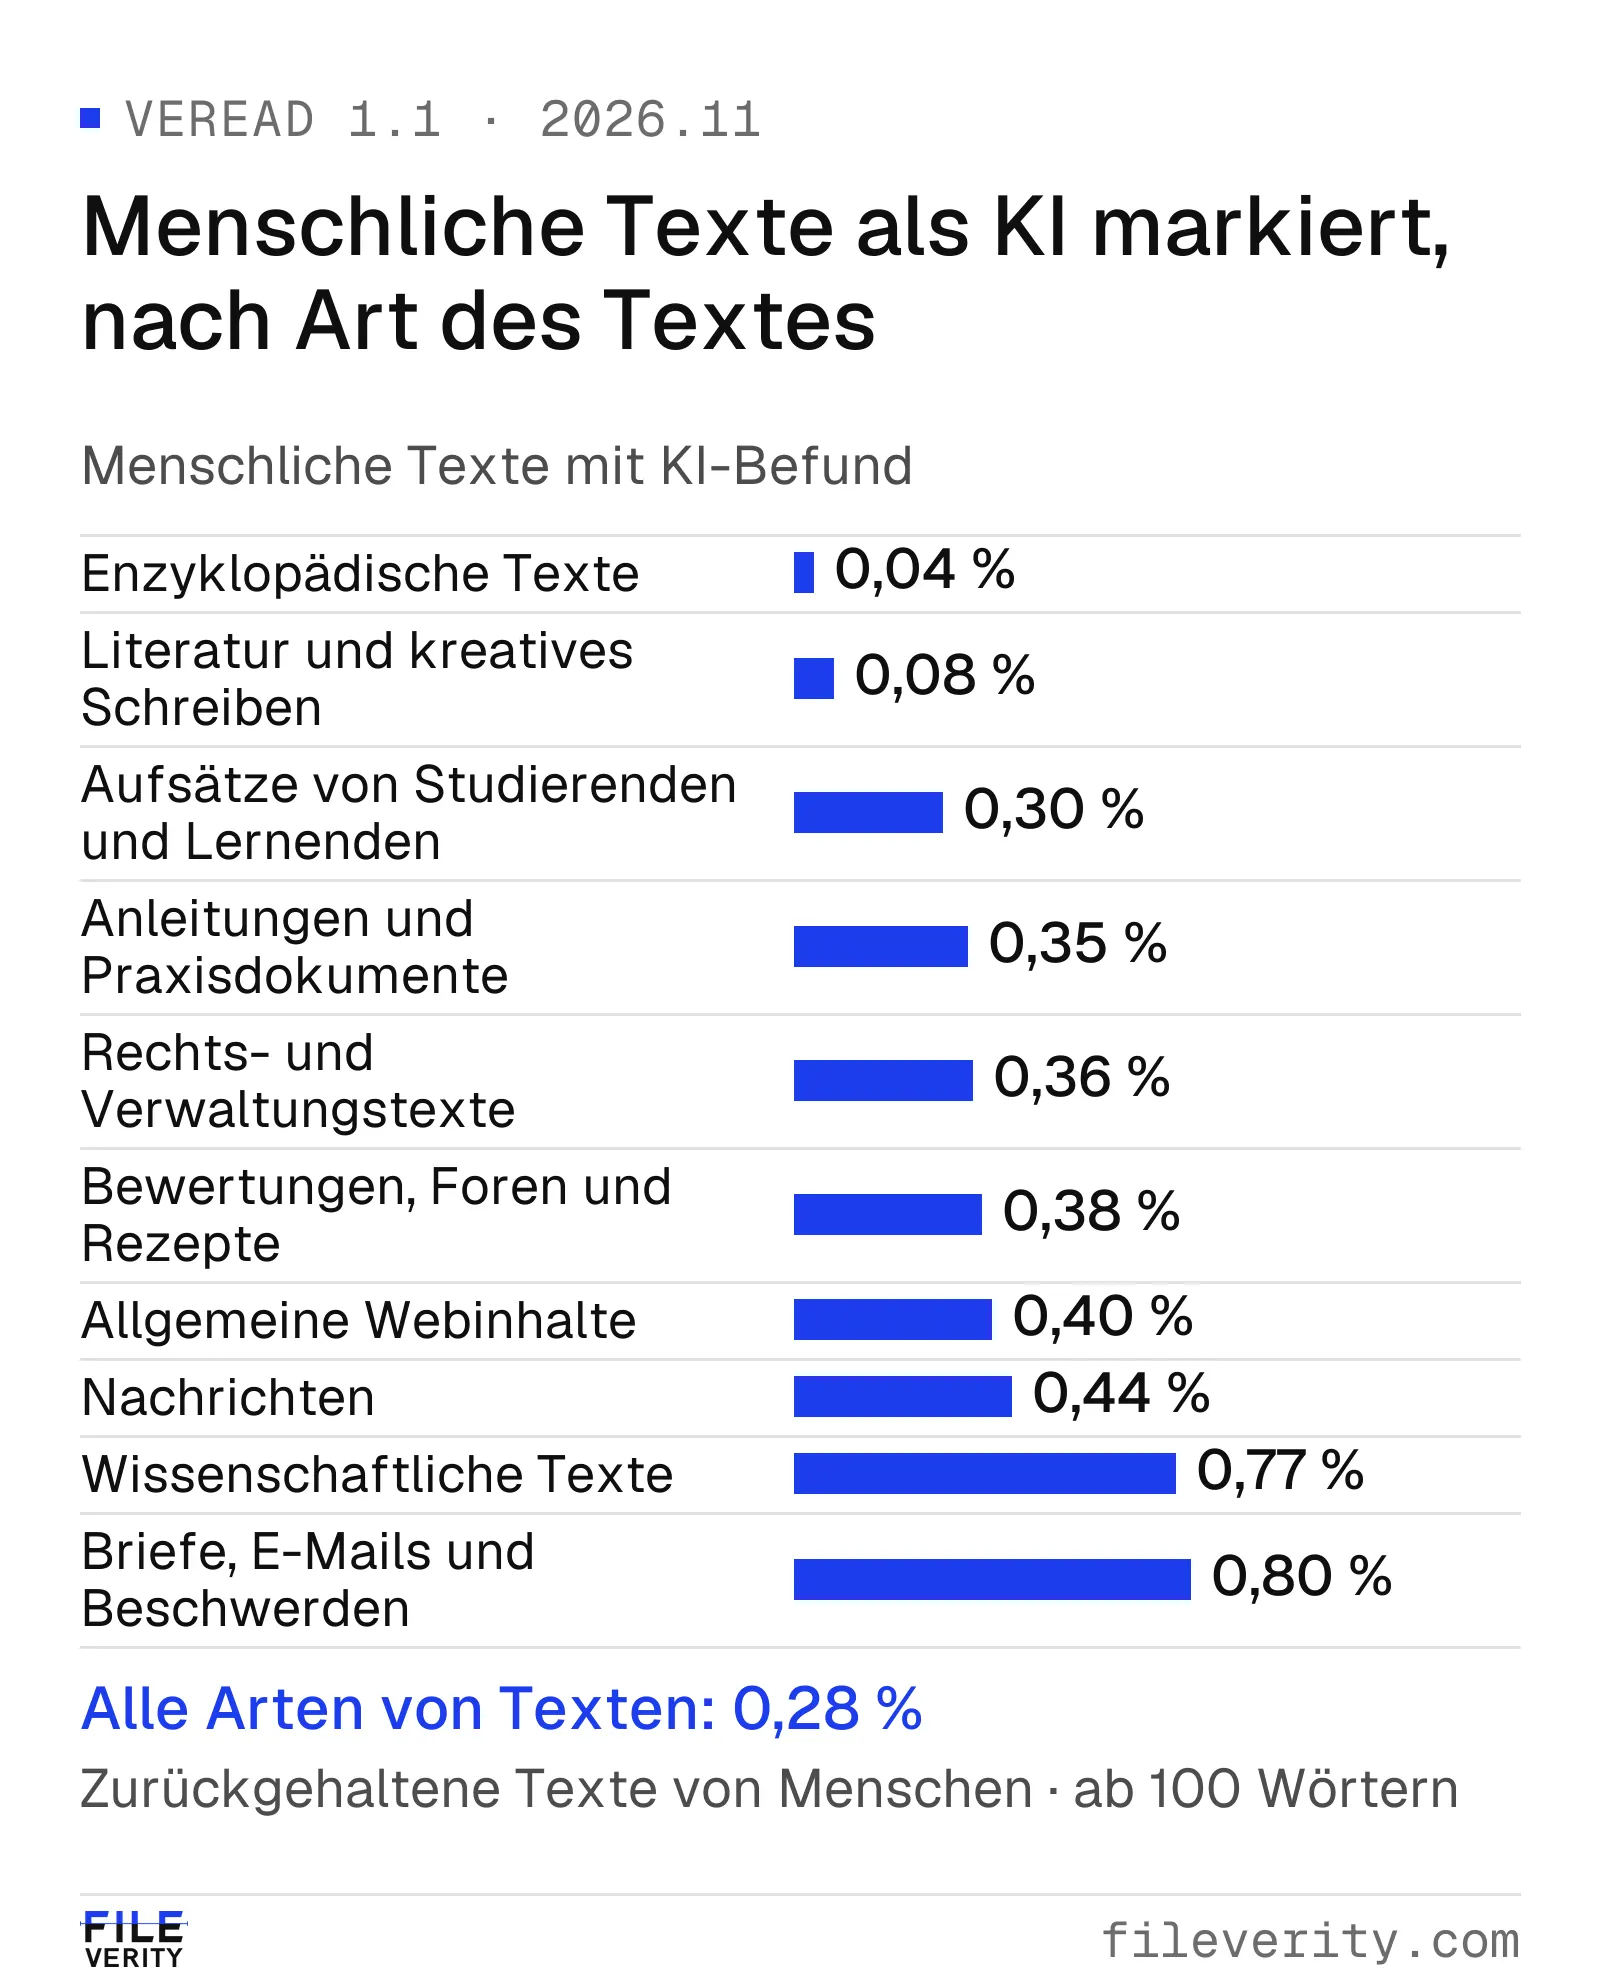
Gesamt über alle Arten von Texten: 0,28 %. Alle zurückgehaltenen Texte von Menschen, einschließlich unabhängiger Panels aus Quellen, die nie im Training verwendet wurden. Fileverity-Auswertung · Veread 1.1 · 2026.11.
| Art des Textes | Menschliche Texte mit KI-Befund | Alle KI-geschriebenen und KI-unterstützten Texte erkannt |
|---|---|---|
| Enzyklopädische Texte | 0,04 % | 95,3 % |
| Literatur und kreatives Schreiben | 0,08 % | 93,9 % |
| Aufsätze von Studierenden und Sprachlernenden | 0,30 % | 99,1 % |
| Anleitungen und Gebrauchsdokumente | 0,35 % | 97,3 % |
| Rechts- und Verwaltungstexte | 0,36 % | 92,3 % |
| Bewertungen, Foren und Rezepte | 0,38 % | 95,1 % |
| Allgemeine Webtexte | 0,40 % | 97,4 % |
| Nachrichten | 0,44 % | 94,9 % |
| Akademische und wissenschaftliche Texte | 0,77 % | 100 % |
| Briefe, E-Mails und Beschwerden | 0,80 % | 100 % |
Texte von Studierenden und Sprachlernenden
Wer Einreichungen prüft, braucht einen Detektor, der Studierende und Nicht-Muttersprachler nicht zu Unrecht verdächtigt. In dieser Auswertung erhielten Aufsätze von Studierenden und Sprachlernenden nur 0,30 % Fehlalarme, und gleichzeitig wurden 99,1 % der KI-geschriebenen und KI-unterstützten Aufsätze erkannt.
Erkennung nach Sprache: 95 bis 100 % bei vollständig KI-geschriebenen Texten
Wer in mehreren Märkten arbeitet, braucht eine Erkennung, die in jeder Sprache trägt. Vollständig KI-geschriebene Texte erkannte Veread auf Spanisch, Chinesisch und Deutsch zu 100 %, auf Französisch zu 99,1 % und auf Arabisch zu 98,5 %.
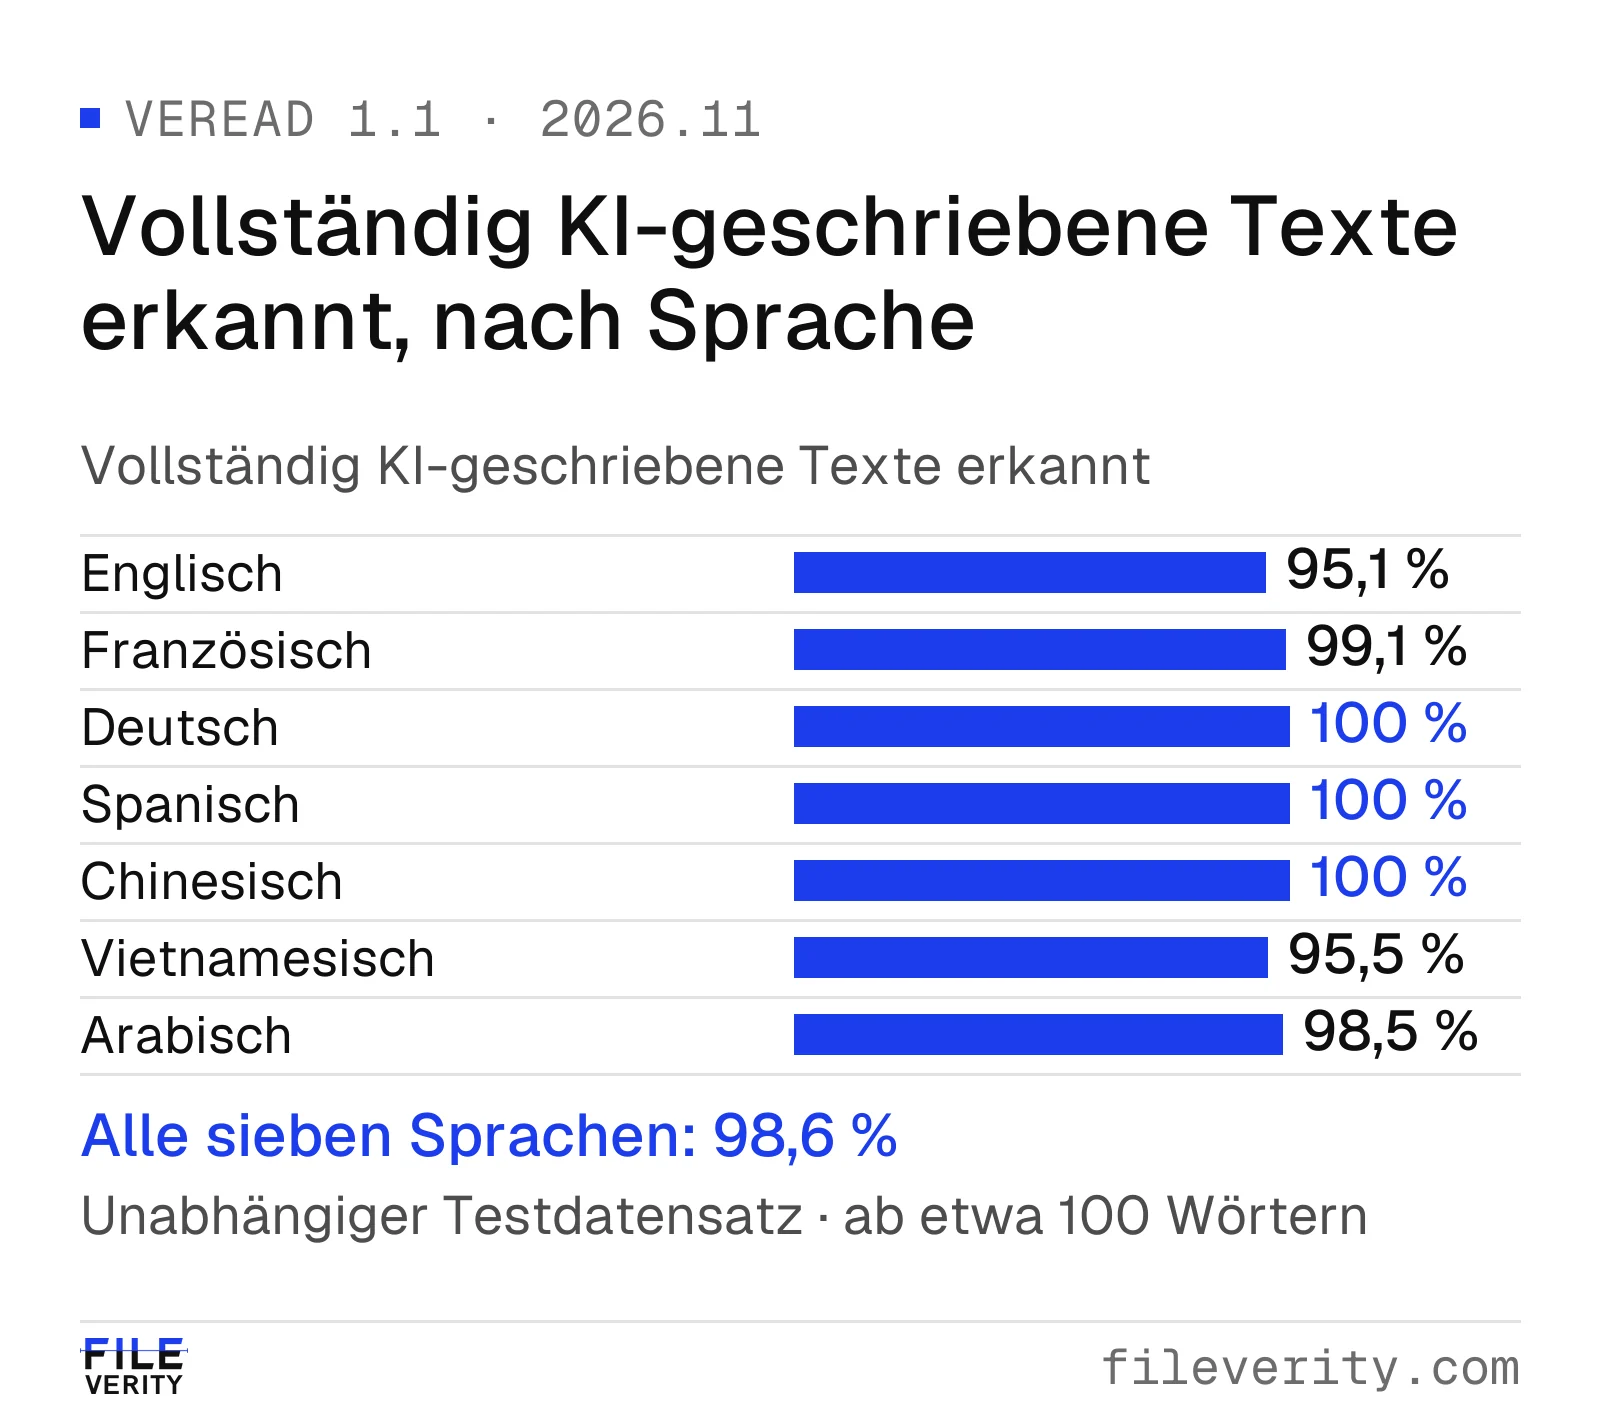
Vollständig KI-geschriebene Texte. Alle sieben Sprachen zusammen: 98,6 %. Fileverity-Auswertung · zurückgehaltene Testdaten · Veread 1.1 · 2026.11.
Über alle KI-geschriebenen und KI-unterstützten Texte hinweg, also vollständig geschriebene, fortgeführte, umgeschriebene und überarbeitete, liegt die Erkennung zwischen 92,8 und 98,8 %, mit 98,8 % auf Chinesisch, 97,5 % auf Arabisch und 96,8 % auf Französisch.
KI-Texte erkannt, nach Art des Textes
Die Erkennung von KI-geschriebenen und KI-unterstützten Texten haben wir für jede Art von Text einzeln gemessen. Akademische und wissenschaftliche Texte sowie Briefe, E-Mails und Beschwerden erreichen 100 %, und jede Art von Text liegt bei 92,3 % oder darüber.
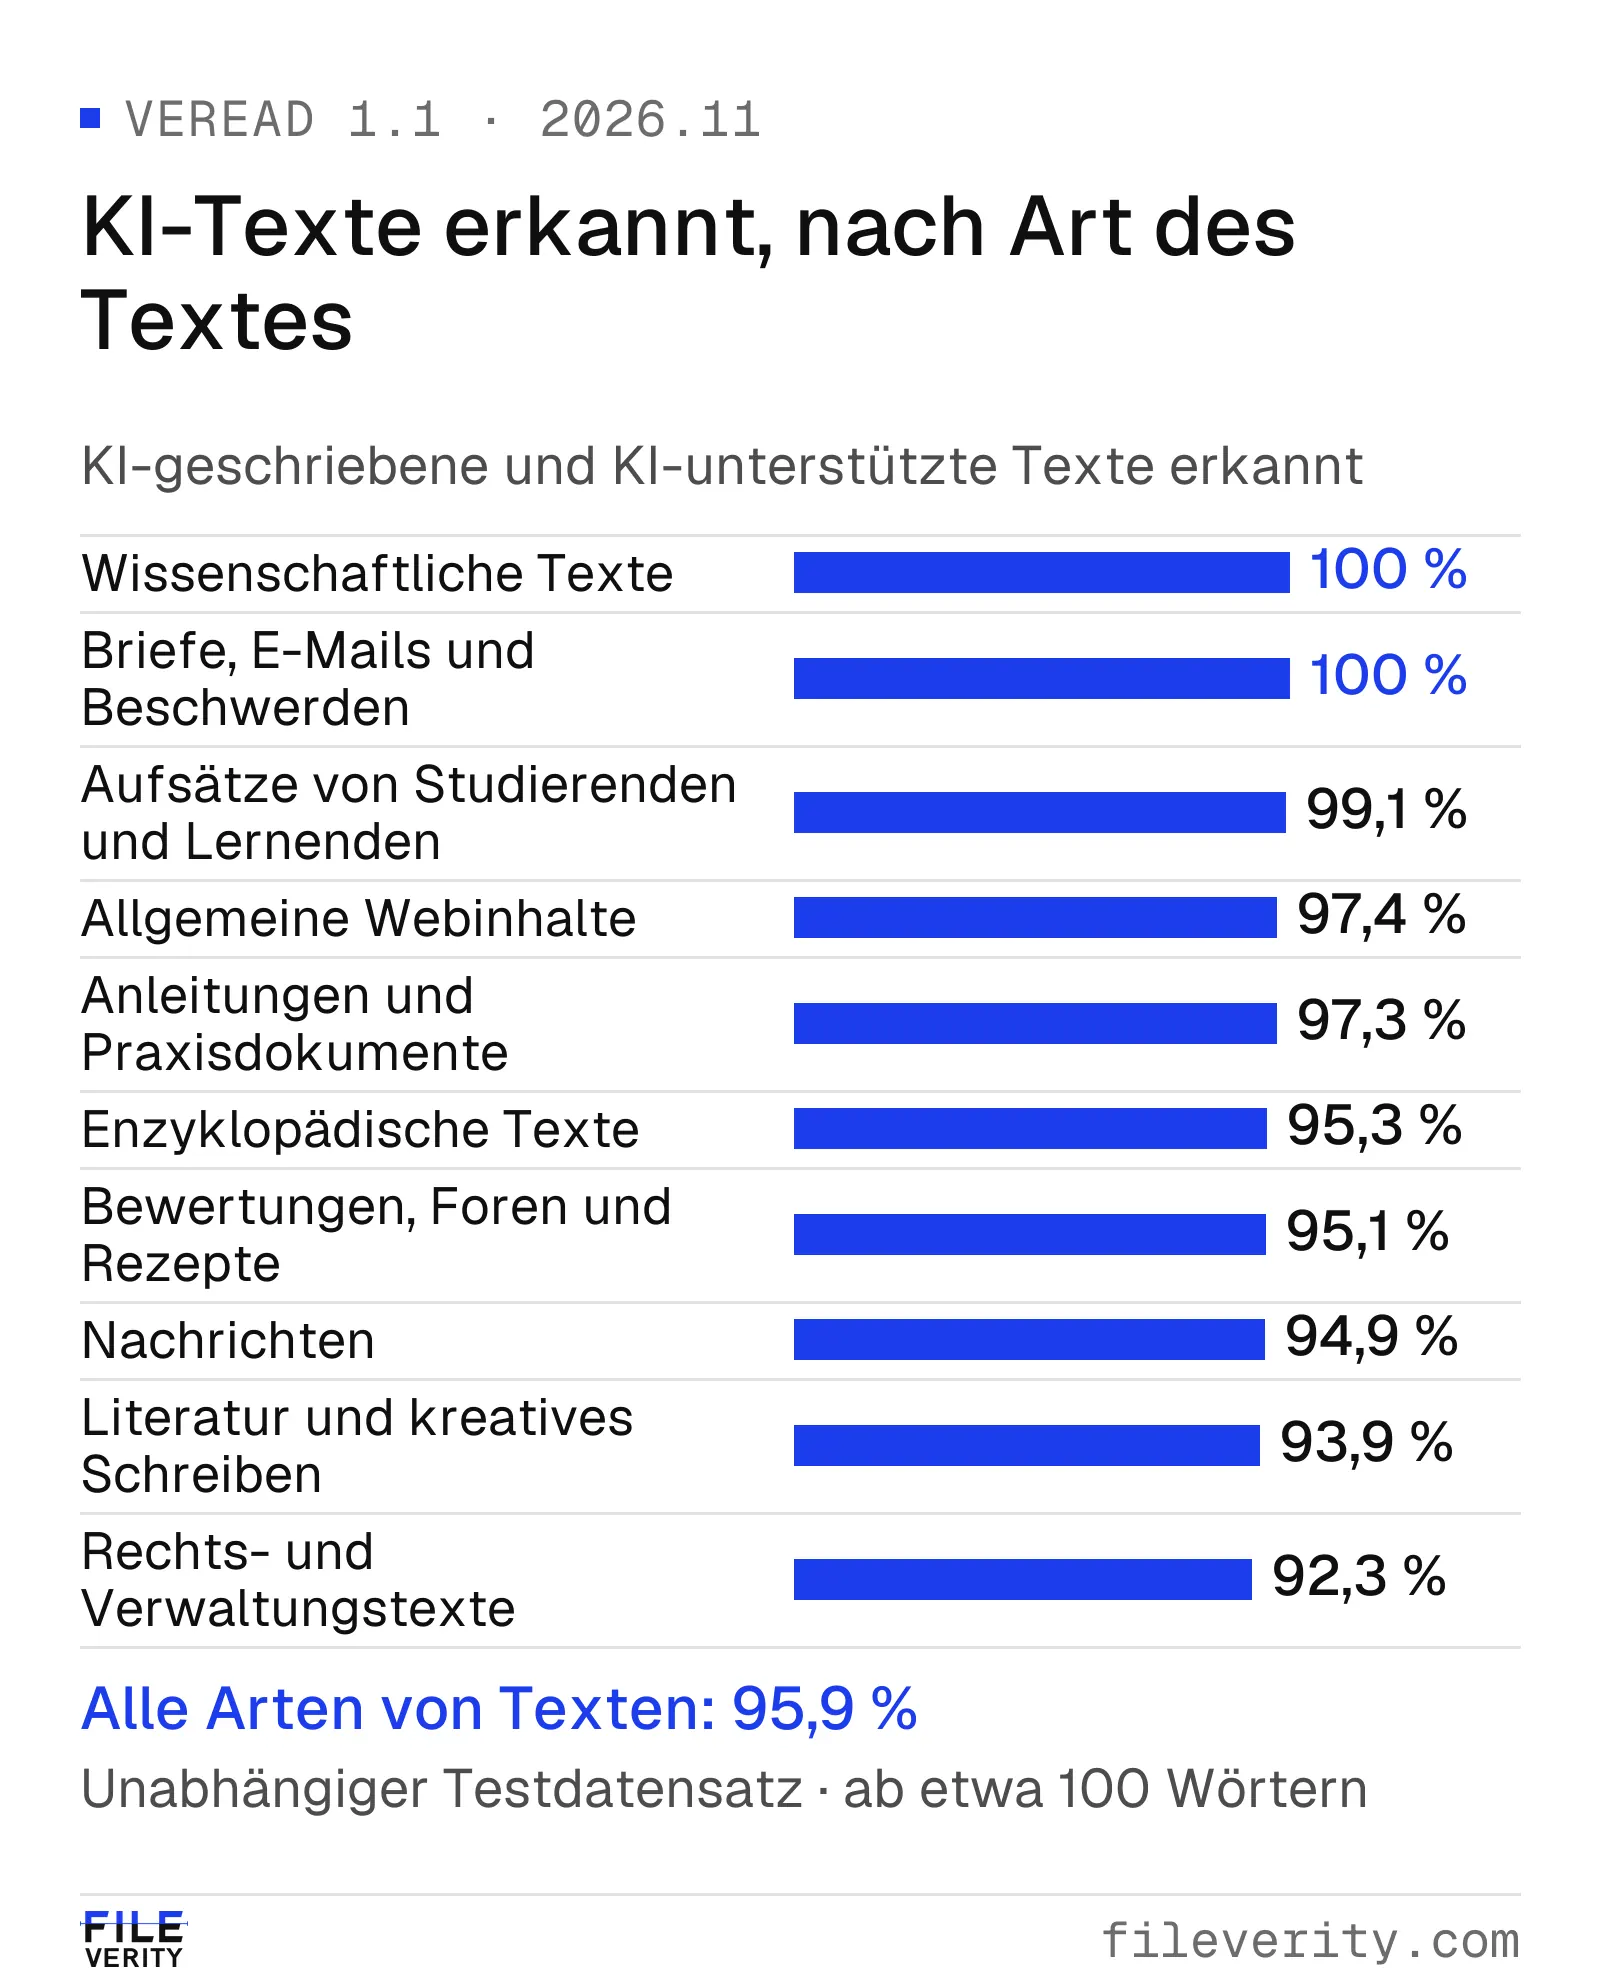
Alle KI-geschriebenen und KI-unterstützten Texte. Alle Arten von Texten zusammen: 95,9 %. Fileverity-Auswertung · zurückgehaltene Testdaten · Veread 1.1 · 2026.11.
Erkennung nach Modellfamilie
Veread wurde an Texten der großen KI-Entwickler ausgewertet, einschließlich aktueller Modelle. Bei OpenAI, Alibaba, Meta, Mistral und xAI liegt die Erkennung bei 100 %, bei Anthropic bei 97,9 %.
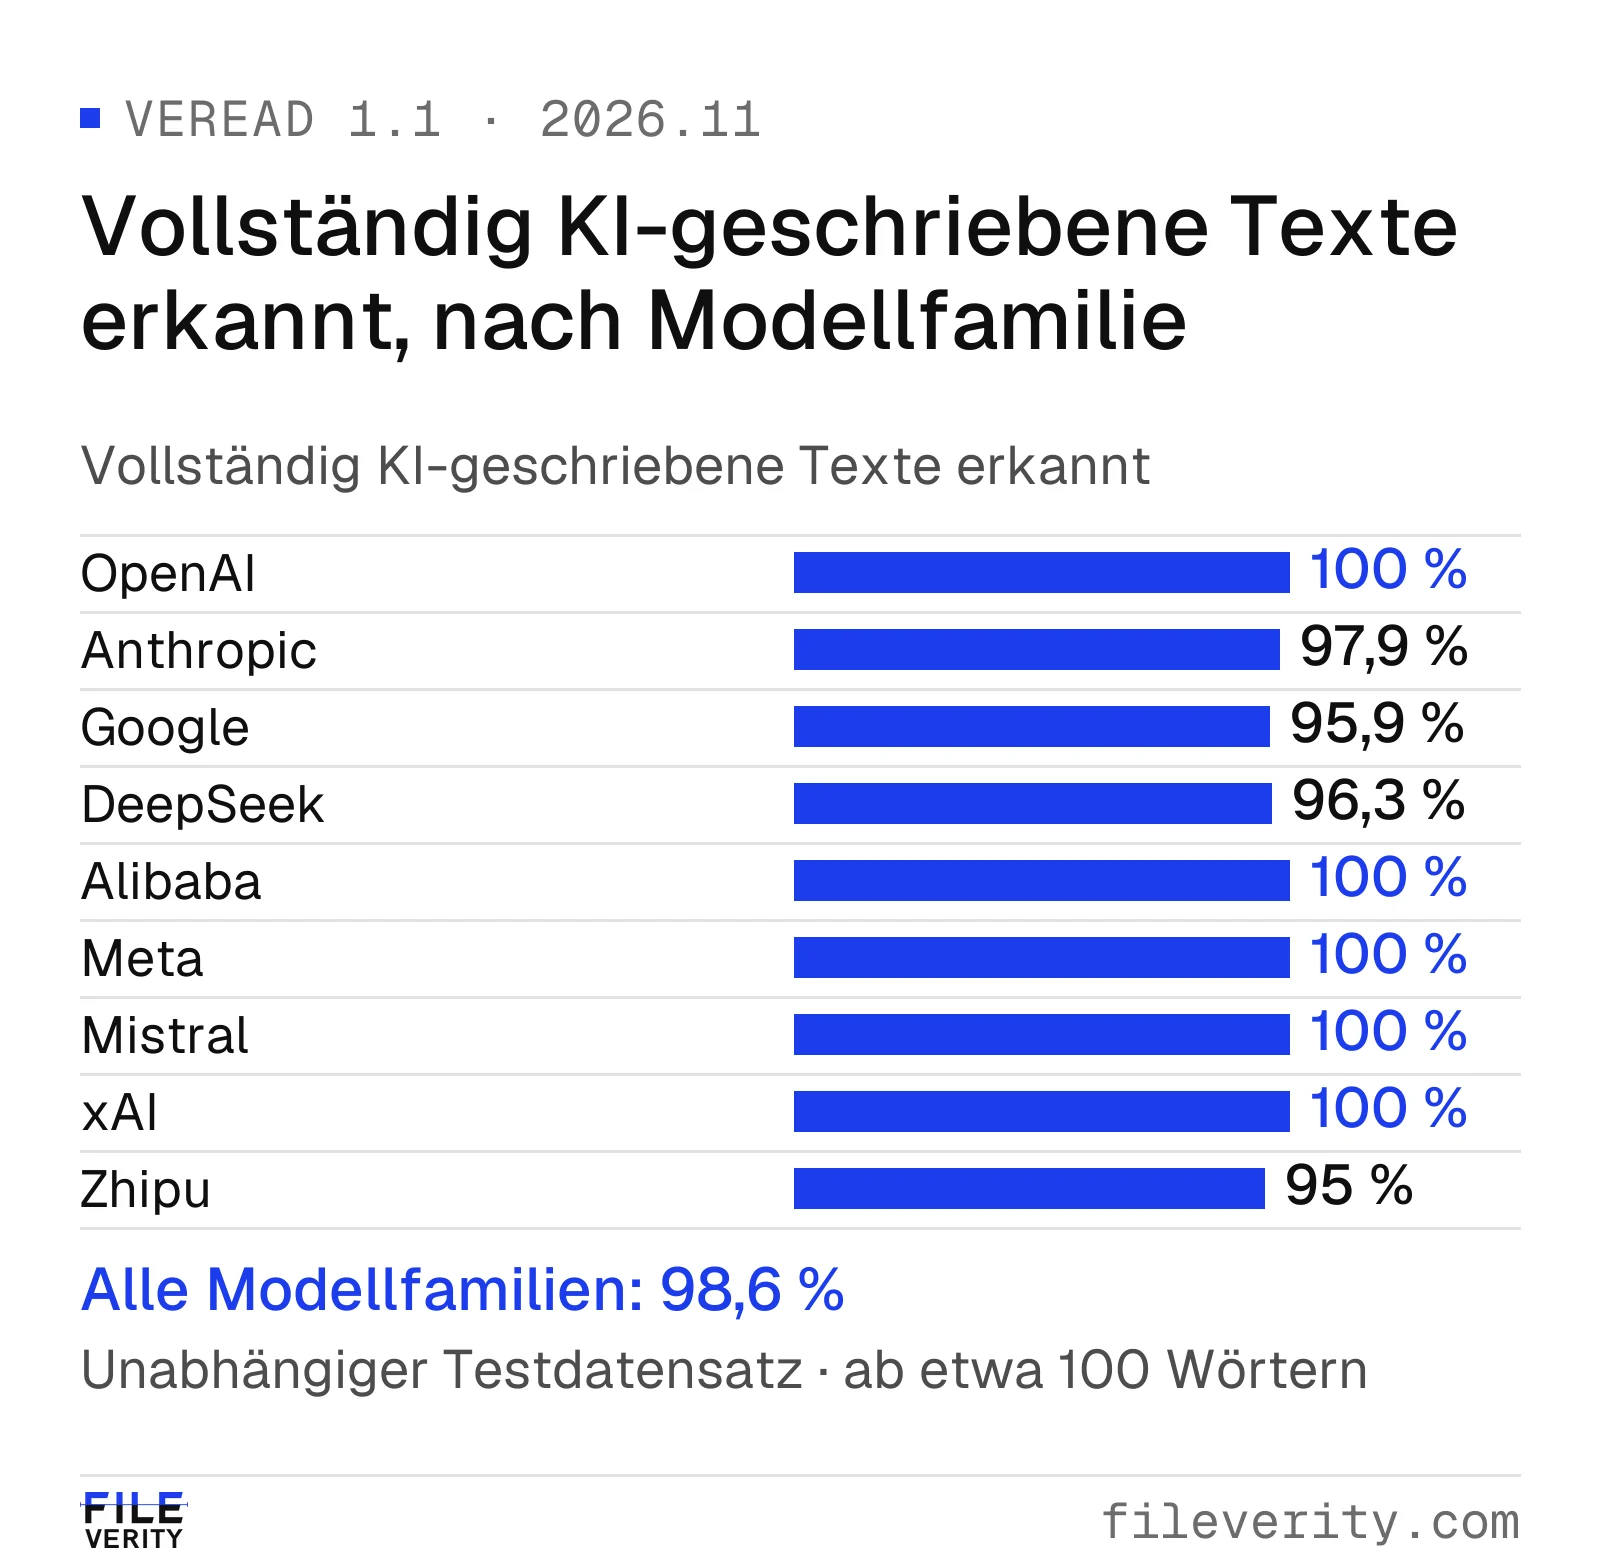
Vollständig KI-geschriebene Texte. Alle Modellfamilien zusammen: 98,6 %. Fileverity-Auswertung · zurückgehaltene Testdaten · Veread 1.1 · 2026.11.
| Modellfamilie | Vollständig KI-geschriebene Texte erkannt |
|---|---|
| OpenAI (GPT) | 100 % |
| Anthropic (Claude) | 97,9 % |
| Google (Gemini) | 95,9 % |
| DeepSeek | 96,3 % |
| Alibaba | 100 % |
| Meta | 100 % |
| Mistral | 100 % |
| xAI (Grok) | 100 % |
| Zhipu (GLM) | 95 % |
Auch neuere Entwickler wie Moonshot (Kimi), ByteDance, Tencent und MiniMax gehören zur laufenden Abdeckung von Fileverity. Das breite Ergebnis gilt auch für Modelle, die Veread in der Entwicklung nie gesehen hat: 94,9 % ihrer Texte wurden erkannt. Das ist die Kennzahl, auf die es ankommt, wenn neue Modelle schneller erscheinen, als Detektoren aktualisiert werden.
Gemischte und umgeschriebene Dokumente
Reale Einreichungen sind selten reine Maschinenausgabe. Jemand lässt eine KI einen Entwurf fortführen oder bittet sie, einen menschlichen Absatz umzuschreiben.
| Dokumenttyp | Erkannt |
|---|---|
| Von KI fortgeführte menschliche Dokumente | 94,3 % |
| Von KI umgeschriebene menschliche Dokumente | 92,8 % |
| Alle KI-geschriebenen und KI-unterstützten Texte: vollständig geschrieben, fortgeführt, umgeschrieben und überarbeitet | 95,9 % |
Veread erkennt KI-Beteiligung über diese gesamte Bandbreite, nicht nur bei Text, der in einem Durchgang erzeugt wurde, und der Dokumentbericht markiert, welche Passagen den Befund tragen.
Kurze Auszüge und vollständige Dokumente
Veread liest Texte ab etwa 100 Wörtern und antwortet in Sekunden.
| Eingabe | Menschliche Texte mit KI-Befund | KI-geschriebene und KI-unterstützte Texte erkannt | AUROC |
|---|---|---|---|
| Vollständige Dokumente | 0,23 % | 96,8 % | 0,999 |
| Kurze Auszüge von etwa 100 Wörtern | 1,4 % | 94,1 % | 0,996 |
Bei vollständigen Dokumenten sinken die Fehlalarme auf 0,23 %, und 96,8 % werden erkannt. Auch kurze Auszüge halten sich: Ab etwa 100 Wörtern werden 94,1 % erkannt, bei 1,4 % Fehlalarmen und einem AUROC von 0,996, sodass schon ein eingefügter Absatz oder eine einzelne Antwort ein belastbares Signal liefert.
Was getestet wurde
- Erkennung: zurückgehaltene Testdaten, die nie für Training, Modellauswahl oder Entscheidungseinstellungen verwendet wurden.
- Fehlalarme: alle zurückgehaltenen Texte von Menschen, also die Testdaten und unabhängige Panels menschlicher Texte aus Quellen, die nie im Training verwendet wurden.
- Sieben Sprachen: Englisch, Französisch, Deutsch, Spanisch, Chinesisch, Vietnamesisch und Arabisch.
- Viele Arten von Texten, von Briefen und Rechtstexten bis zu Nachrichten, wissenschaftlichem Schreiben und allgemeinen Webtexten.
- Vollständig geschriebene, fortgeführte, umgeschriebene und überarbeitete KI-Texte der großen KI-Entwickler, einschließlich aktueller Modelle und Modelle, die in der Entwicklung nie verwendet wurden.
- Die Entscheidungseinstellungen von Veread im Produktivbetrieb, dieselben, die auch Kunden nutzen, vor der Auswertung festgelegt.
Veread wird auf umfangreichen, exklusiven, professionell aufbereiteten eigenen Daten entwickelt.
So nutzen Sie diese Ergebnisse
Beginnen Sie mit der Kennzahl, die zu Ihrem Risiko passt. Eine Schule oder Personalabteilung sollte zuerst die Fehlalarme bei menschlichen Texten und bei Lernenden-Aufsätzen betrachten. Ein Verlag oder ein Trust-and-Safety-Team sollte auf die Erkennung nach Modellfamilie und bei unbekannten Modellen schauen. Ein Team mit gemischten Dokumenten sollte die Ergebnisse für fortgeführte und umgeschriebene Texte ansehen.
Ein Ergebnis von Veread ist ein Beleg für die Prüfung, kein Nachweis der Autorschaft, und Entscheidungen über Personen erfordern eine menschliche Prüfung. Nutzen Sie die KI-Erkennung für Texte, um einen Text zu prüfen, oder erstellen Sie einen vollständigen Dokumentbericht, wenn Sie zusätzlich Metadaten, Versionen und Signaturen brauchen. Die Zuverlässigkeitsseite der Dokumentanalyse listet die wichtigsten Messwerte, und KI-Erkennungs-API auswählen behandelt die Integration.
Fragen zu den Ergebnissen
Wie genau ist die KI-Text-Erkennung von Veread?
An zurückgehaltenen Testdaten erkannte Veread 1.1 98,6 % der vollständig KI-geschriebenen Texte und 95,9 % aller KI-geschriebenen und KI-unterstützten Texte, während nur 0,28 % der zurückgehaltenen von Menschen verfassten Texte einen KI-Befund erhielten. Der AUROC lag bei 0,999 für vollständige Dokumente und bei 0,996 für kurze Auszüge.
Wie hoch ist die Fehlalarmquote des KI-Detektors?
Über sieben Sprachen erhielten 0,28 % der von Menschen verfassten Texte einen KI-Befund, bei vollständigen Dokumenten 0,23 %. Je nach Sprache lag die Quote zwischen 0,03 und 0,48 %, und jede Art von Text blieb unter 1 %.
Funktioniert Veread für mehrsprachige KI-Text-Erkennung?
Ja. Ein Modell deckt Englisch, Französisch, Deutsch, Spanisch, Chinesisch, Vietnamesisch und Arabisch ab, und jede Sprache wurde getrennt gemessen. Vollständig KI-geschriebene Texte wurden auf Spanisch, Chinesisch und Deutsch zu 100 %, auf Französisch zu 99,1 % und auf Arabisch zu 98,5 % erkannt.
Erkennt Veread Texte neuerer KI-Modelle?
Veread erkannte 94,9 % der Texte von KI-Modellen, die in seiner Entwicklung nie verwendet wurden, und seine Abdeckung umfasst Modelle von OpenAI, Anthropic, Google, DeepSeek, Alibaba, Meta, Mistral, xAI und Zhipu.
Markiert Veread Studierende und Nicht-Muttersprachler?
In dieser Auswertung erhielten Aufsätze von Studierenden und Sprachlernenden nur 0,30 % Fehlalarme, und 99,1 % der KI-geschriebenen und KI-unterstützten Aufsätze wurden erkannt.
Erkennt Veread auch kurze Texte?
Ja. Ab etwa 100 Wörtern erkannte Veread 94,1 % der KI-geschriebenen und KI-unterstützten Auszüge bei 1,4 % Fehlalarmen, und die Antwort kommt in Sekunden.
Von Yang Zheng