Evaluar la verificación
¿Puede ChatGPT detectar imágenes de IA? Comprender la escena no demuestra su origen
La diferencia entre comprender y detectar: teoría de la información y resultados medidos de FVIMG V2, con curva ROC empírica y AUROC de 0,99625.
Publicado · Actualizado · 5 min de lectura
En esta página
¿Puede ChatGPT detectar si una imagen está generada por IA? Puede señalar indicios, pero describir correctamente una escena no demuestra de dónde procede. Una fotografía y una imagen sintética pueden representar lo mismo. La detección necesita información que permita distinguir sus orígenes, no solo comprender su contenido.
El proceso de detección de Fileverity no invoca LLM. Utiliza aprendizaje automático especializado y comprobaciones técnicas. Aquí explicamos un único fundamento público: la diferencia entre información semántica e información de origen, sin revelar las características ni las combinaciones internas de nuestros modelos.
La misma escena no implica el mismo origen
Pensemos en dos imágenes de un coche rojo junto a una pared de ladrillo. Una procede de una cámara; la otra, de un generador. La frase «un coche rojo junto a una pared de ladrillo» describe ambas con precisión.
Si el siguiente paso de la revisión solo recibe esa frase, las dos entradas resultan indistinguibles. Razonar más sobre el mismo texto no recupera las diferencias que se quedaron fuera. La descripción ha cumplido su función, pero la clasificación del origen sigue pendiente.
Por eso, la plausibilidad visual y la procedencia no son equivalentes. Unas manos correctas no prueban que haya una cámara detrás. Un reflejo extraño tampoco prueba una generación. La relación entre esos indicios y el origen debe medirse.
Qué información llega a la decisión
Llamemos Y a la categoría de origen, X a la imagen disponible y T a una representación derivada, como su descripción. Si la decisión posterior solo utiliza T, importa cuánta información de Y conserva esa representación.
La desigualdad de procesamiento de datos explicada en las notas del MIT establece I(Y; T) ≤ I(Y; X) para esa cadena: transformar la entrada no crea información adicional sobre su origen.
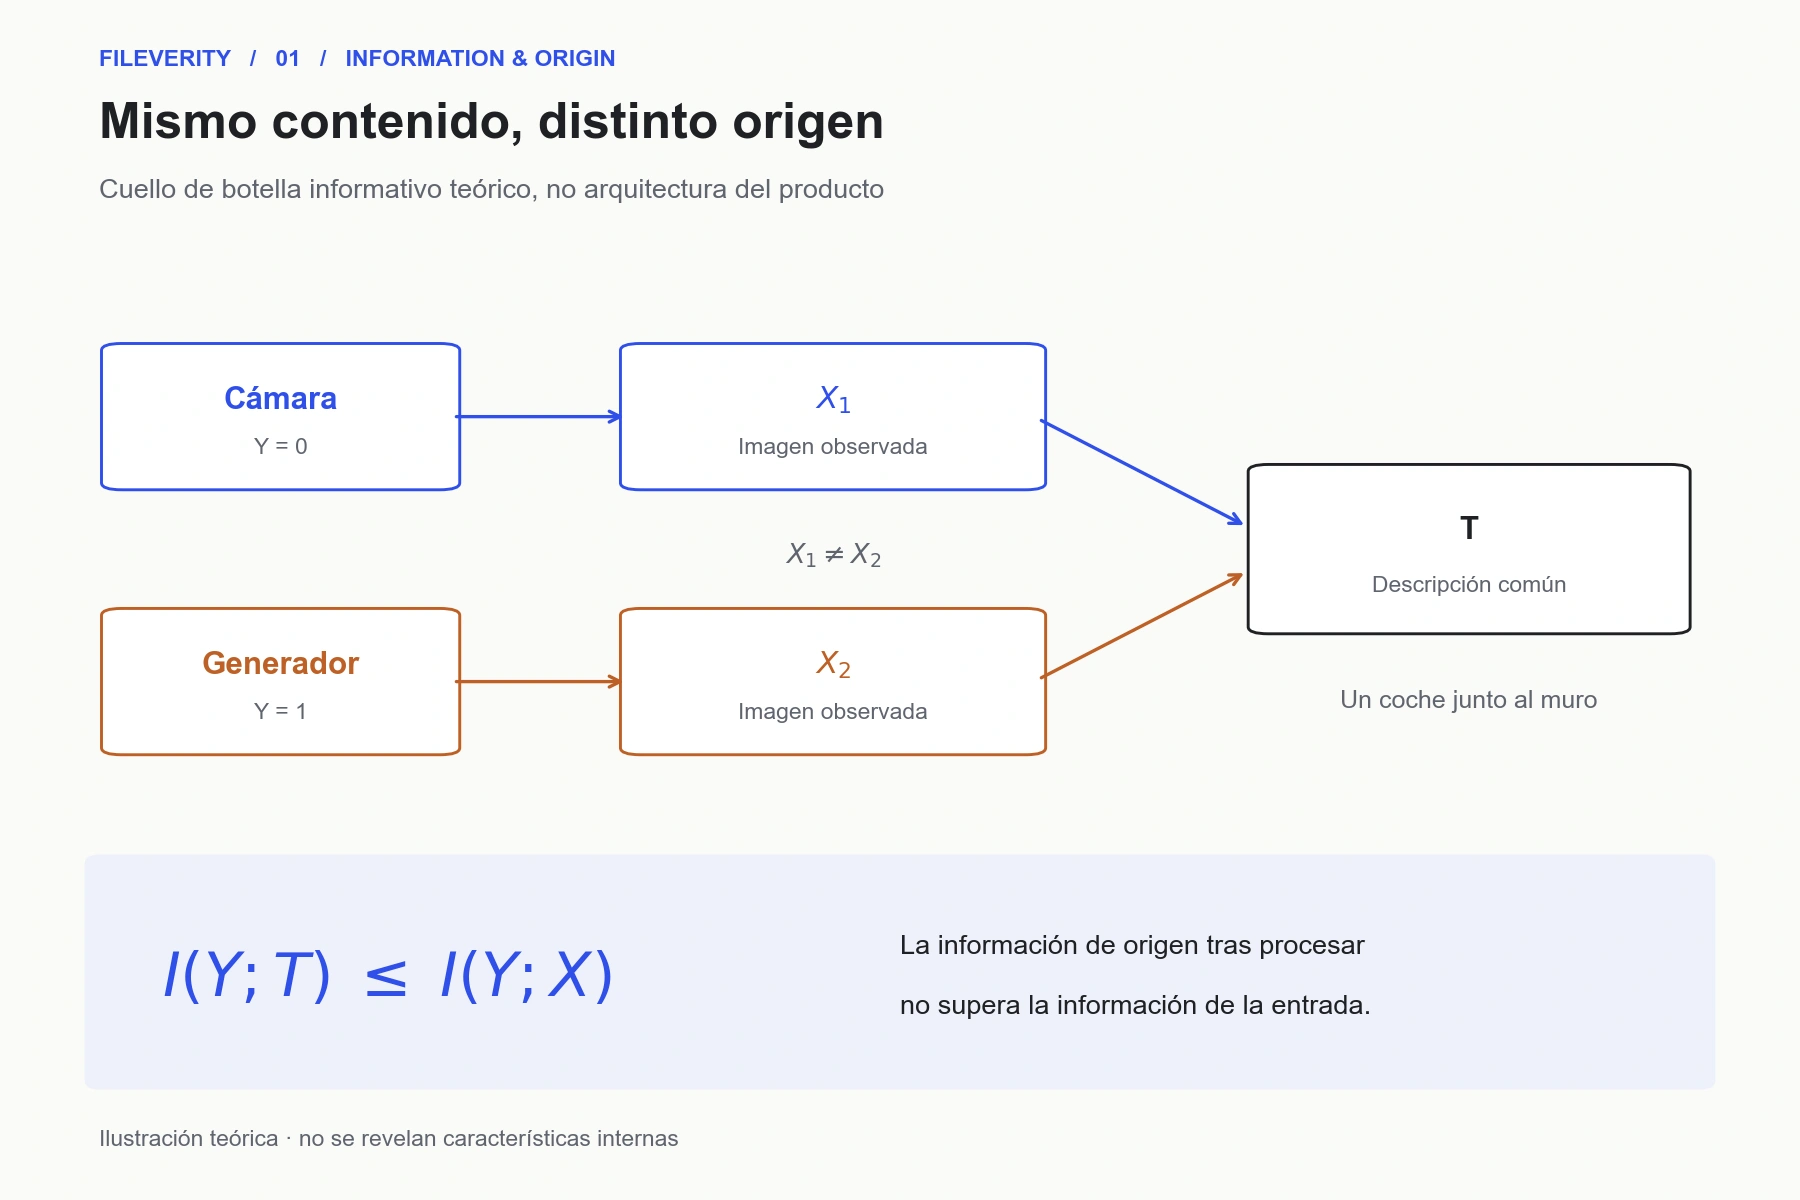
Ilustración teórica, no un esquema de la arquitectura de Fileverity. Y representa el origen; X, la imagen observada; T, una representación derivada. No se muestran características internas de detección.
Una representación bien elegida puede conservar la información necesaria para una tarea. Lo que no se puede dar por hecho es que una representación eficaz para describir escenas también sea suficiente para distinguir cómo se produjeron.
Este argumento no demuestra que cualquier LLM multimodal sea incapaz de detectar imágenes generadas. Puede recibir información visual directamente, y un entrenamiento específico puede modificar sus capacidades. La conclusión precisa es que comprender imágenes no acredita, por sí solo, una capacidad de detección validada.
De «parece real» a una hipótesis comprobable
Para una observación abstracta E, la pregunta cambia: ¿es más característica de las imágenes generadas o de las fotografías? Una forma general de expresarlo es la razón de verosimilitudes L(E) = p(E | generada) / p(E | cámara).
Es una explicación del objetivo estadístico, no la fórmula de implementación de Fileverity. Compara dos hipótesis bajo unas distribuciones supuestas; no equivale automáticamente a la probabilidad de que ese archivo individual sea falso.
Un detector aprendido puede evaluarse sin conocer las distribuciones verdaderas: se fija un umbral, se procesan ejemplos etiquetados y se cuentan aciertos, omisiones y falsos positivos. Al variar el umbral, aparece una relación entre detección y falsas alarmas. Esa relación es la que representa una curva ROC.
Como referencia de investigación, Zero-Shot Detection of AI-Generated Images estudia la predictibilidad estadística de las imágenes. Es un ejemplo de análisis de señales de origen; no una descripción de la técnica empleada por Fileverity.
Cómo se ve esa distinción en resultados medidos
La figura siguiente se ha calculado a partir de las predicciones individuales guardadas en la evaluación de FVIMG V2 del 1 de noviembre de 2026. Combina las imágenes generadas de Synthbuster con las fotografías de cámara de RAISE-1k, dos conjuntos públicos que cualquiera puede comprobar de forma independiente. Los modelos de Fileverity, en cambio, se desarrollan y validan con enormes conjuntos de datos propios y exclusivos, seleccionados por especialistas. Aquí mostramos mediciones, no una simulación del principio anterior.
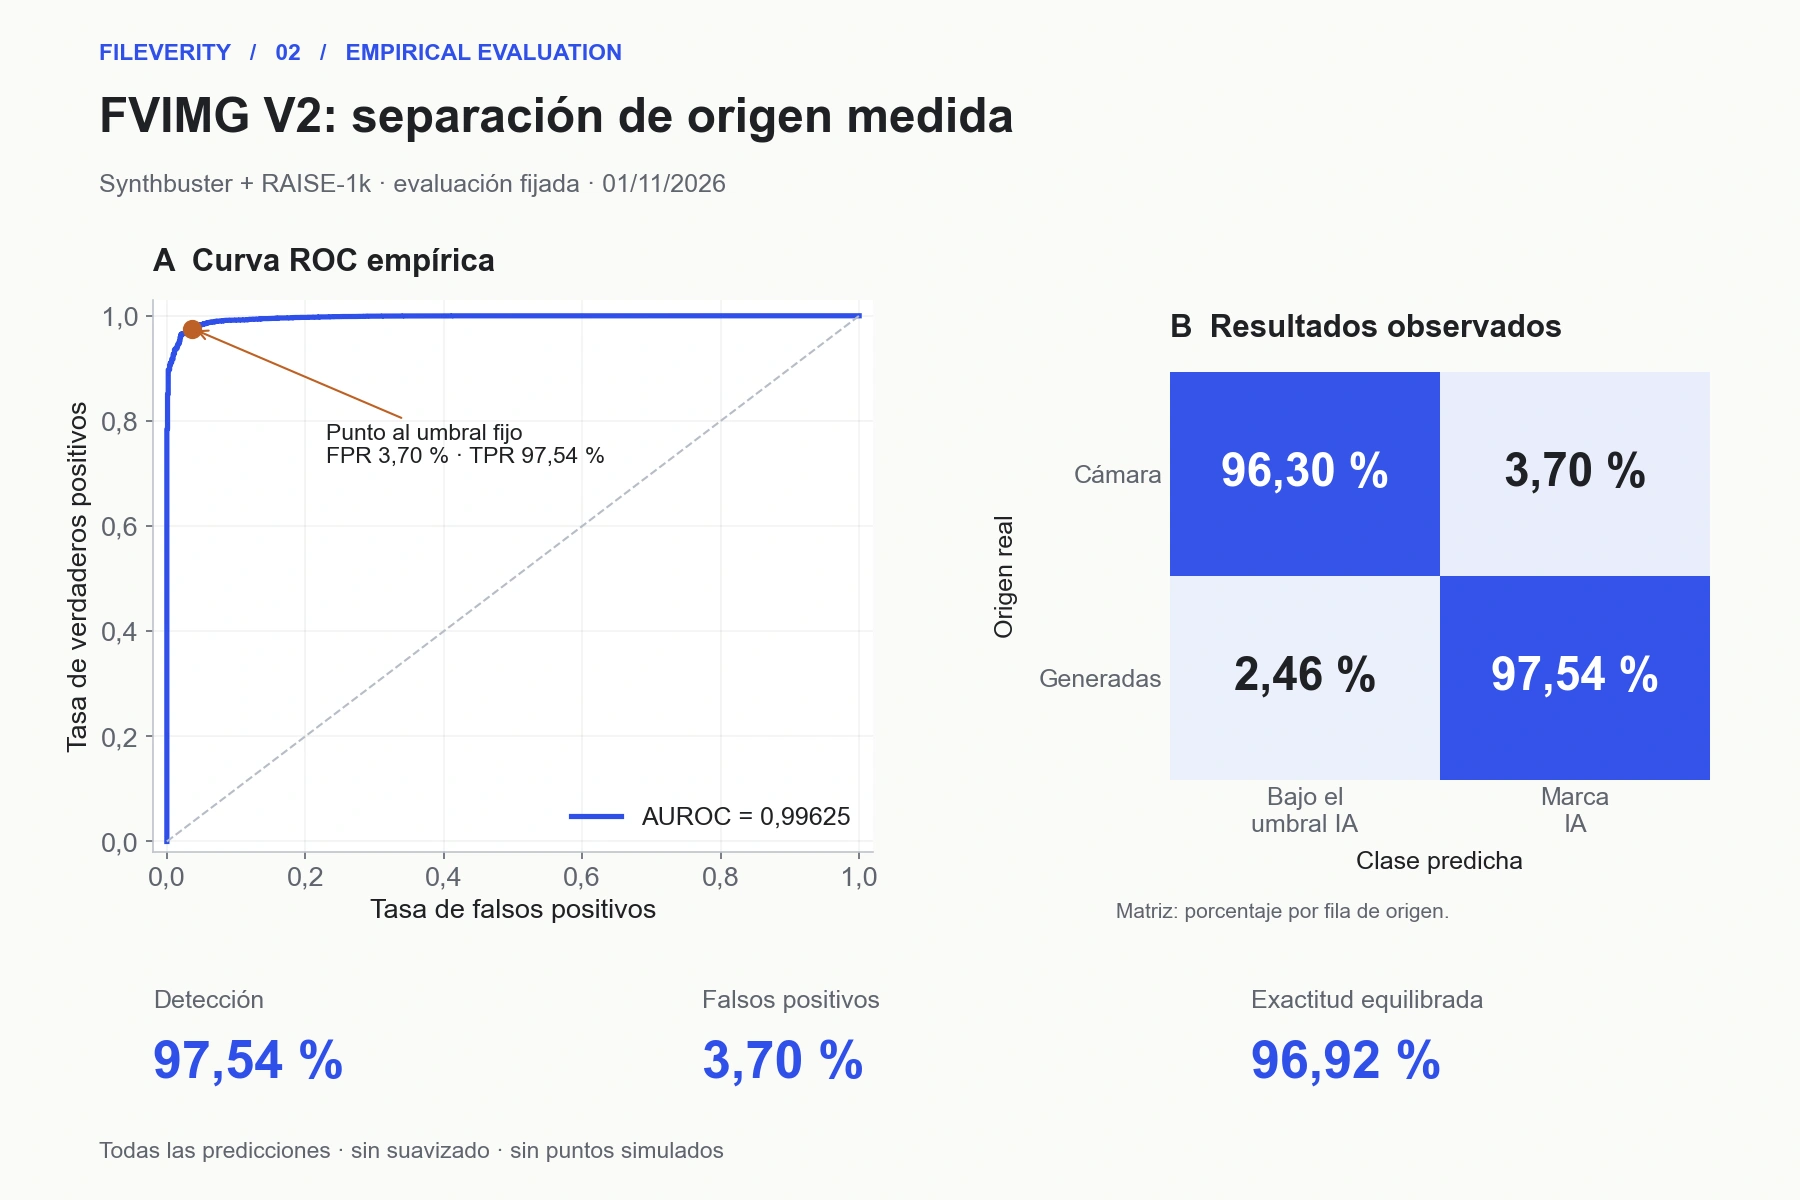
Se agrupan las puntuaciones iguales antes de integrar. El punto señalado corresponde al umbral fijo de la evaluación. La matriz muestra el porcentaje de cada fila de origen. No hay suavizado ni observaciones simuladas.
| Medida | Resultado de FVIMG V2 |
|---|---|
| Detección de imágenes generadas | 97,54 % |
| Fotografías correctamente por debajo del umbral IA | 96,30 % |
| Exactitud equilibrada | 96,92 % |
| AUROC | 0,99625 |
El 3,70 % de las fotografías quedó señalado por error: es la tasa de falsos positivos en ese umbral. La AUROC resume la separación a lo largo de los umbrales; no asigna una probabilidad de autenticidad a cada archivo.
El informe de Synthbuster documenta las entradas y el alcance: el núcleo de detección por píxeles, sin sumar metadatos ni procedencia al resultado principal. No se evaluaron LLM como competidores en esa prueba.
Contrastar evidencias: el valor está en lo que se añade
Supongamos que ya contamos con E1 y añadimos E2. Si E2 solo reformula E1, no hay una nueva observación. Si aporta información relevante que faltaba, puede ayudar a distinguir entre las hipótesis de origen.
Eso separa el contraste de evidencias de la acumulación de opiniones. Los controles pueden cometer errores correlacionados; su número no garantiza una mejora. Hay que comprobar el comportamiento de la combinación sobre archivos representativos.
La verificación de imágenes de Fileverity sigue este enfoque centrado en evidencias. FVIMG V2 y el modelo documental FVDOC V3 tienen versiones y ámbitos de evaluación identificados. No publicamos aquí sus características internas: mostramos resultados examinables y métricas asociadas a tareas concretas.
Qué preguntar antes de elegir un detector
En lugar de preguntar solo si el sistema interpreta bien la imagen, conviene preguntar qué sostiene su clasificación, dónde se ha validado y qué falsos positivos produce al mismo umbral que su tasa de detección. Nuestra guía de precisión de detectores de imágenes IA desarrolla esas métricas.
El proceso especializado de Fileverity conecta la información pertinente con comprobaciones definidas y resultados medibles. Entender el contenido ayuda; establecer una conclusión sobre su origen exige una tarea de detección propia. Si va a conectar un detector a sus propios sistemas, Cómo elegir una API de detección de IA repasa diez puntos de integración.
Por Yang Zheng