Đánh giá công cụ phát hiện
Độ chính xác của công cụ phát hiện ảnh AI: dương tính giả và khối lượng xét duyệt
Cách đọc đúng độ chính xác của công cụ phát hiện ảnh AI: ma trận nhầm lẫn, dương tính giả, ngưỡng, hiệu chuẩn và ví dụ tính khối lượng xét duyệt.
Đăng ngày · Cập nhật ngày · 13 phút đọc
Trong trang này
Độ chính xác của công cụ phát hiện ảnh AI chỉ có ý nghĩa khi bạn biết rõ nhiệm vụ được kiểm tra, bộ ảnh dùng để kiểm tra và quy tắc biến điểm số thành quyết định. Một công cụ có thể phân loại đúng gần như mọi ảnh nhưng vẫn đẩy vào hàng đợi xét duyệt nhiều cảnh báo nhầm (dương tính giả) hơn số ca phát hiện đúng. Ngược lại, một hàng đợi ngắn cũng có thể che giấu một lượng đáng kể ảnh bị bỏ sót.
Để đánh giá một công cụ phát hiện, hãy đặt ba câu hỏi có liên quan chặt chẽ với nhau: công cụ này thực sự phát hiện điều gì, nó mắc những loại lỗi nào ở ngưỡng bạn định dùng, và điều gì xảy ra với các tệp mà nó không thể đánh giá? Các ví dụ tính toán bên dưới gắn từng câu trả lời với khối lượng xét duyệt mà đội ngũ của bạn sẽ phải xử lý. Hướng dẫn này dành cho các nhóm mua hàng, công nghệ thông tin, an toàn thông tin, quản trị rủi ro và phòng chống gian lận cần kiểm chứng một con số về độ chính xác trước khi cam kết.
Nếu bạn chỉ cần kiểm tra nhanh một con số về độ chính xác, hãy bắt đầu với các phần về ma trận nhầm lẫn, tỷ lệ phổ biến và ngưỡng. Các phần này cho thấy vì sao độ chính xác tổng thể cao vẫn có thể đi kèm một hàng đợi xét duyệt kém hiệu quả. Nếu bạn phụ trách một đợt đánh giá, hãy đọc tiếp các phần về hiệu chuẩn, độ bao phủ và tập kiểm tra độc lập, rồi dùng mẫu yêu cầu bằng chứng ở cuối bài. Mọi ví dụ số liệu đều là giả định, không phải kết quả của Fileverity và cũng không phải ước tính tỷ lệ gian lận.
Fileverity dùng FVIMG V2 để phát hiện ảnh do AI tạo ra và FVDOC V3 cho văn bản trong tài liệu (FVDOC V3 phân tích văn bản tiếng Anh, tiếng Pháp, tiếng Đức, tiếng Tây Ban Nha và tiếng Trung, không áp dụng cho tiếng Việt). Đánh giá Synthbuster của FVIMG V2 ghi nhận tỷ lệ phát hiện ảnh AI 97,54% và độ chính xác cân bằng (balanced accuracy) 96,92% ở một ngưỡng cố định, kèm kết quả theo từng công cụ tạo ảnh và phương pháp kiểm thử. Các mô hình của Fileverity dựa trên kho dữ liệu độc quyền quy mô rất lớn do đội ngũ chuyên gia tuyển chọn, còn đánh giá này dùng bộ dữ liệu công khai để bên ngoài có thể tự kiểm chứng. Các kết quả về ảnh này được trình bày tách biệt với kết quả kiểm chứng văn bản của FVDOC V3.
Xác định thế nào là trường hợp dương tính
Hãy bắt đầu bằng một câu như: “Lần đánh giá này kiểm tra xem toàn bộ một bức ảnh được gửi lên có do AI tạo ra hay không.” Định nghĩa đó biến các ảnh do AI tạo ra hoàn toàn thành trường hợp dương tính và các ảnh chụp bằng máy ảnh hợp lệ thành trường hợp âm tính. Nó không cho phép đánh giá các chỉnh sửa cục bộ bằng AI, việc chỉnh sửa ảnh thông thường, chú thích gây hiểu lầm hay ảnh thật bị dùng lại ngoài ngữ cảnh. Hướng dẫn Cách nhận biết ảnh AI giúp bạn xác định ảnh cần chứng minh điều gì và chọn phép kiểm tra phù hợp cho từng tệp.
Nếu quy trình của bạn cần phát hiện ảnh do AI tạo ra một phần, hãy coi đó là một nhiệm vụ đánh giá riêng, với nhãn riêng. Một ảnh chụp thật có chứa vùng do AI tạo ra không được âm thầm chuyển qua lại giữa nhóm dương tính và nhóm âm tính tùy theo cách diễn giải nào làm kết quả đẹp hơn. Tương tự, việc dùng AI trong phạm vi được phép không nhất thiết là hành vi gian dối. Nhãn của công cụ phát hiện mô tả nội dung; chính sách nội bộ và các bằng chứng đối chiếu mới quyết định ý nghĩa của nó.
Hãy xác định cả đơn vị đếm. Năm ảnh trong cùng một hồ sơ, chẳng hạn một hồ sơ bồi thường hoặc một yêu cầu hoàn tiền, là năm quyết định về ảnh nhưng có thể chỉ là một vụ việc cần điều tra. Độ chính xác tổng thể tính theo từng ảnh không cho phép suy ra trực tiếp khối lượng xét duyệt theo hồ sơ khi chỉ một ảnh bị gắn cờ cũng kéo theo việc xem xét lại toàn bộ hồ sơ.
Đọc ma trận nhầm lẫn trước khi xem con số nổi bật
Ma trận nhầm lẫn (confusion matrix) so sánh quyết định của công cụ phát hiện với các nhãn được xác lập độc lập. Hãy xét 10.000 ảnh giả định: 100 ảnh do AI tạo ra và 9.900 ảnh không do AI tạo ra. Ở một ngưỡng cố định, công cụ gắn cờ 90 ảnh do AI tạo ra và 99 ảnh không do AI tạo ra.
| Nhãn đã biết | Bị gắn cờ | Không bị gắn cờ | Tổng |
|---|---|---|---|
| Do AI tạo ra | 90 dương tính thật (TP) | 10 âm tính giả (FN) | 100 |
| Không do AI tạo ra | 99 dương tính giả (FP) | 9.801 âm tính thật (TN) | 9.900 |
| Tổng | 189 | 9.811 | 10.000 |
Hình dưới đây biểu diễn cùng ma trận này và cho thấy precision chỉ ở mức 47,62%.
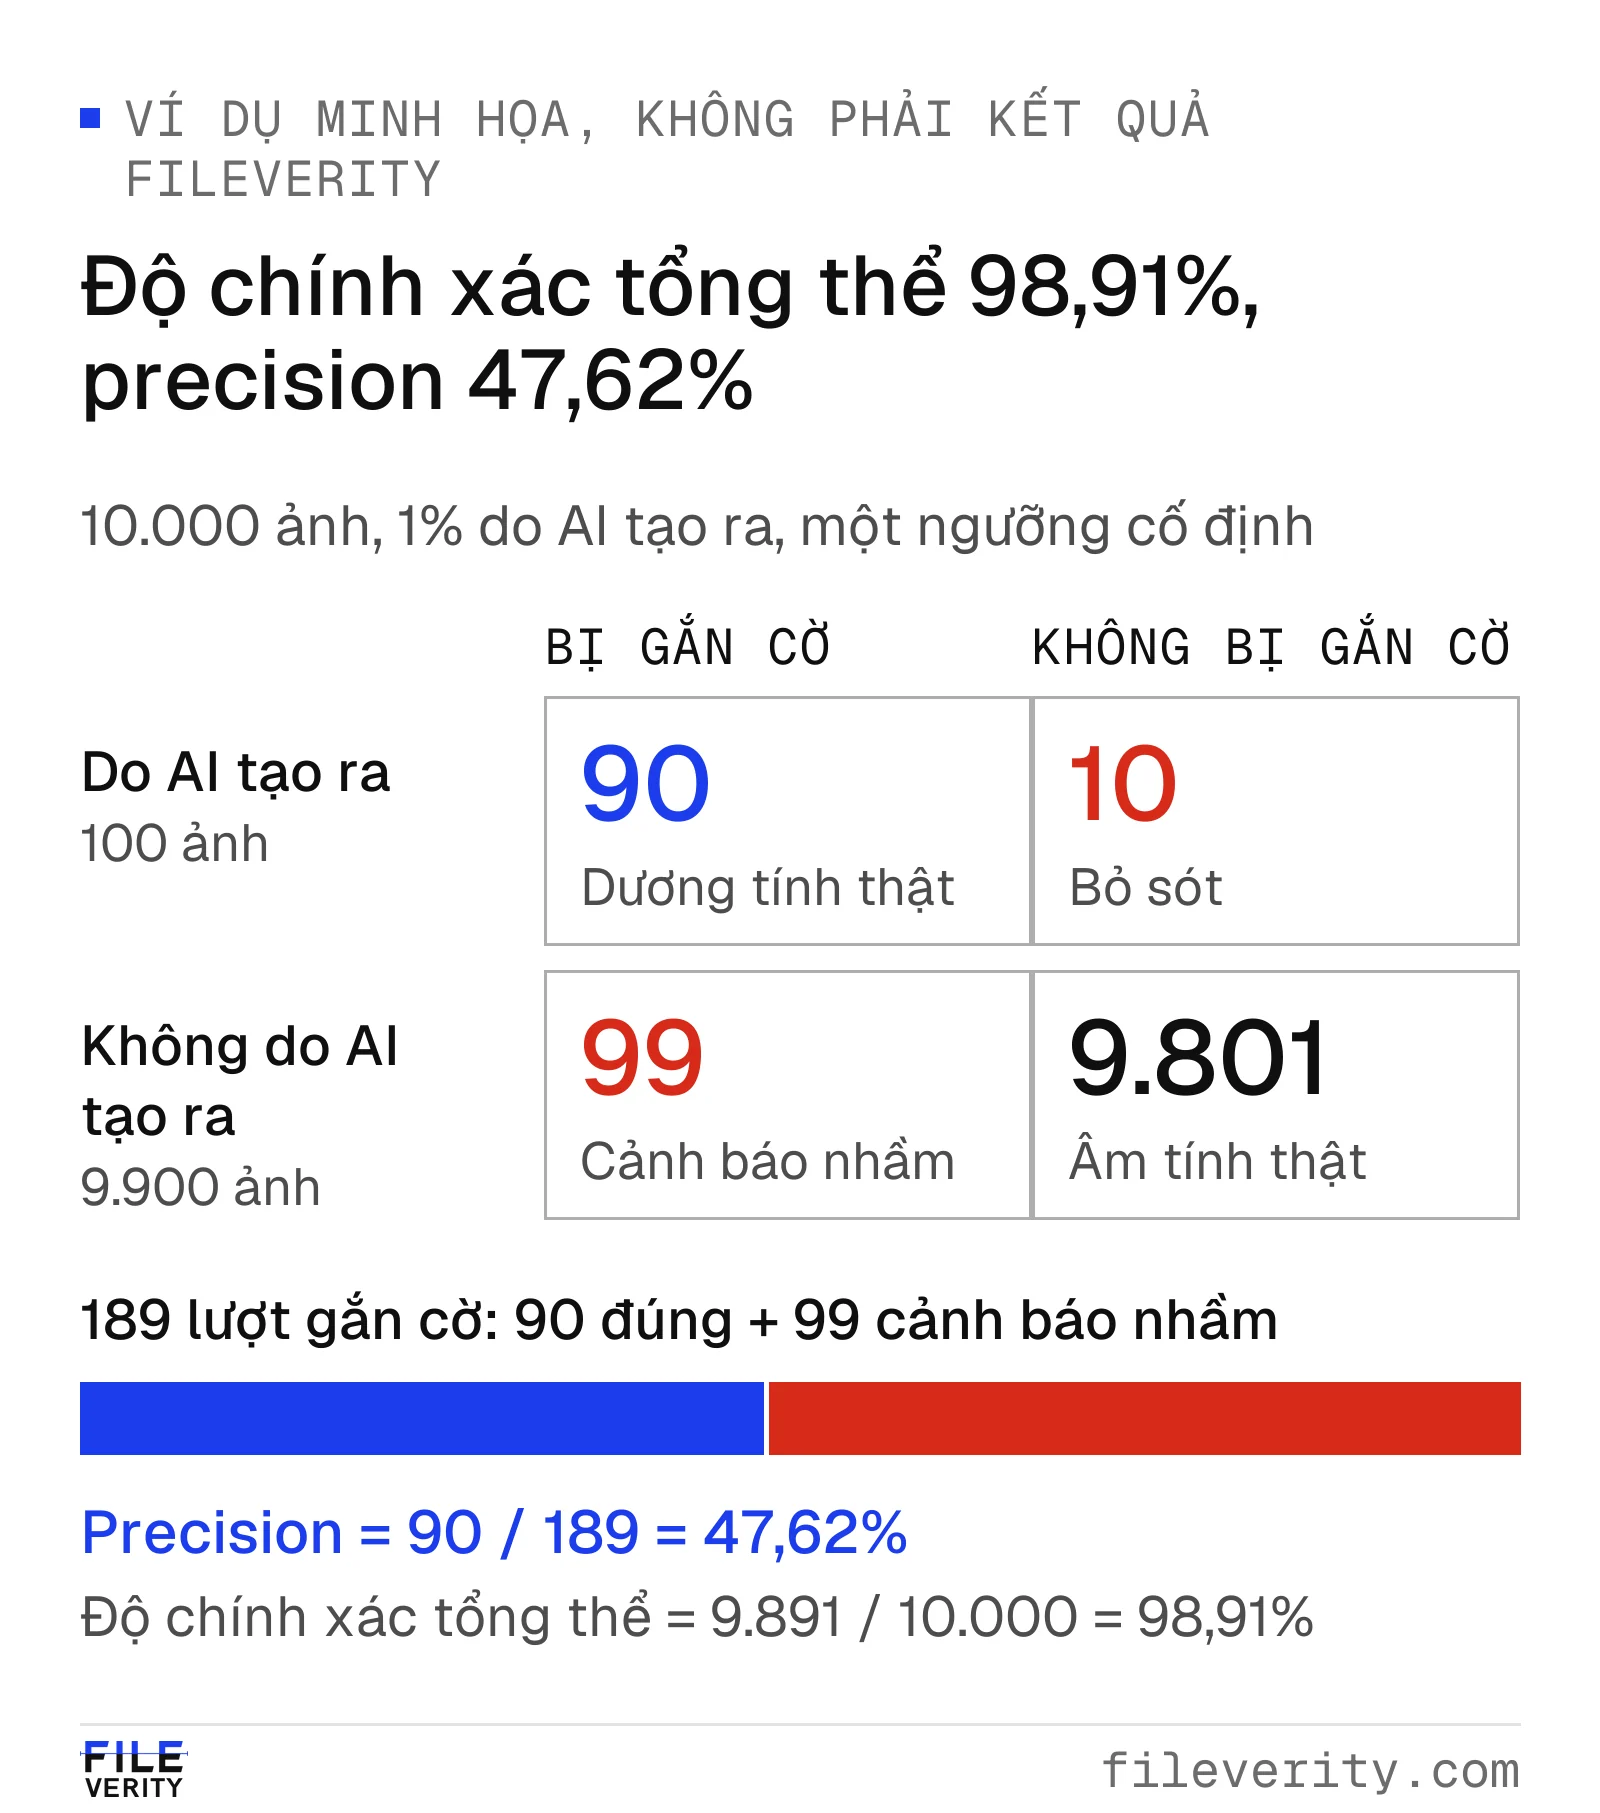
Trong 189 ảnh bị gắn cờ, 90 ảnh là đúng và 99 ảnh là cảnh báo nhầm, dù độ chính xác tổng thể lên tới 98,91%.
Mỗi chỉ số trả lời một câu hỏi khác nhau:
| Chỉ số | Cách tính | Kết quả | Câu hỏi mà chỉ số trả lời |
|---|---|---|---|
| Độ chính xác tổng thể (accuracy) | (TP + TN) / tổng số ảnh | 98,91% | Bao nhiêu quyết định là đúng? |
| Recall, hay độ nhạy (sensitivity) | TP / (TP + FN) | 90% | Tìm được bao nhiêu ảnh do AI tạo ra? |
| Tỷ lệ âm tính giả | FN / (TP + FN) | 10% | Bỏ sót bao nhiêu ảnh do AI tạo ra? |
| Tỷ lệ dương tính giả | FP / (FP + TN) | 1% | Bao nhiêu ảnh không do AI tạo ra bị gắn cờ? |
| Độ đặc hiệu (specificity) | TN / (FP + TN) | 99% | Bao nhiêu ảnh không do AI tạo ra không bị gắn cờ? |
| Precision, hay giá trị dự báo dương (PPV, positive predictive value) | TP / (TP + FP) | 47,62% | Bao nhiêu lượt gắn cờ là đúng? |
Precision được làm tròn từ 90/189. Việc phân biệt tỷ lệ dương tính giả với precision là then chốt: tỷ lệ dương tính giả 1% không có nghĩa là chỉ 1% số ảnh bị gắn cờ là cảnh báo nhầm. Hai chỉ số có mẫu số khác nhau. Ở đây, 99/189, tức 52,38% số lượt gắn cờ, là cảnh báo nhầm. Các định nghĩa chuẩn và mối liên hệ của chúng với ma trận nhầm lẫn được trình bày trong tài liệu tham khảo về các chỉ số phân loại của scikit-learn (tiếng Anh).
Lưu ý về thuật ngữ. Trong tiếng Việt, “độ chính xác” thường được dùng cho cả accuracy lẫn precision, và cách dịch recall cũng chưa thống nhất giữa các tài liệu. Khi một nhà cung cấp quảng cáo “độ chính xác 99%”, hãy hỏi họ đang đo accuracy, precision hay recall, trên mẫu số nào và ở ngưỡng nào. Trong bài này, “độ chính xác tổng thể” luôn chỉ accuracy; precision và recall được giữ nguyên tên tiếng Anh.
Một quy tắc không bao giờ gắn cờ ảnh nào sẽ đạt độ chính xác tổng thể 99% trên cùng bộ ảnh này nhưng không tìm ra được ảnh nào do AI tạo ra. Điều đó không biến nó thành một công cụ phát hiện hữu ích. Ví dụ này cho thấy vì sao so sánh theo độ chính xác tổng thể có thể khiến một cách làm sai lại được đánh giá cao khi một nhóm chiếm áp đảo.
Tính xem tỷ lệ phổ biến tác động đến hàng đợi ra sao
Tỷ lệ phổ biến (prevalence) là tỷ lệ trường hợp dương tính trong quần thể đang được đánh giá. Trong ví dụ này là 1%. Khi recall và tỷ lệ dương tính giả được giữ cố định, precision kỳ vọng được tính theo công thức sau:
PPV = (recall × tỷ lệ phổ biến) / [(recall × tỷ lệ phổ biến) + (tỷ lệ dương tính giả × (1 − tỷ lệ phổ biến))]
Thay số: 0,90 × 0,01 / [(0,90 × 0,01) + (0,01 × 0,99)] = 0,009/0,0189 = 47,619…%.
Các kịch bản dưới đây dùng số lượng kỳ vọng, nên số lẻ chỉ biểu thị giá trị trung bình kỳ vọng, không phải một phần của bức ảnh nào đó được quan sát thực tế.
Kết quả kỳ vọng giả định trên 10.000 ảnh, giữ recall ở mức 90% và tỷ lệ dương tính giả ở mức 1%.
| Tỷ lệ phổ biến giả định | Lượt gắn cờ đúng kỳ vọng | Lượt gắn cờ sai kỳ vọng | Precision kỳ vọng |
|---|---|---|---|
| 0,1% | 9 | 99,9 | 8,26% |
| 1% | 90 | 99 | 47,62% |
| 10% | 900 | 90 | 90,91% |
| 50% | 4.500 | 50 | 98,90% |
Vì vậy, một bộ kiểm thử cân bằng có thể cho precision rất ấn tượng nhưng không áp dụng được cho một luồng tiếp nhận có tỷ lệ phổ biến thấp. Phép tính này giả định hiệu năng theo từng nhóm không đổi. Trên thực tế, một luồng tiếp nhận khác có thể chứa các ảnh khó hơn, làm chính recall và tỷ lệ dương tính giả thay đổi.
Đừng ước tính tỷ lệ phổ biến từ tỷ lệ ảnh bị gắn cờ, vì tỷ lệ đó đã bao gồm cả các lỗi. Hãy dùng một mẫu của luồng tiếp nhận được gắn nhãn độc lập, báo cáo các nhãn chưa giải quyết được, và thử nhiều kịch bản tỷ lệ phổ biến hợp lý nếu ước tính vẫn còn bất định. Hãy dùng các kịch bản đó để hoạch định năng lực xét duyệt cần thiết trước khi cam kết một ngưỡng.
Chọn ngưỡng theo hành động mà nó kích hoạt
Với loại điểm số mà giá trị càng cao thì bằng chứng cho thấy ảnh do AI tạo ra càng mạnh, việc hạ ngưỡng gắn cờ sẽ đưa thêm ảnh vào hàng đợi. Trên cùng một tập đã chấm điểm, việc này không thể loại bỏ ảnh đã bị gắn cờ trước đó, nên có thể làm tăng cả số phát hiện đúng lẫn số cảnh báo nhầm. Nâng ngưỡng thì cho kết quả ngược lại. Precision không nhất thiết cải thiện ở mọi bước ngưỡng; điều đó phụ thuộc vào thứ tự của các nhãn thực tế theo điểm số.
Dưới đây là một phép so sánh minh họa trên cùng quần thể 10.000 ảnh. Không gán giá trị ngưỡng cụ thể nào, vì thang điểm khác nhau giữa các hệ thống.
So sánh ngưỡng giả định: cùng 100 ảnh do AI tạo ra và 9.900 ảnh không do AI tạo ra ở mỗi ngưỡng.
| Ngưỡng | Dương tính thật | Dương tính giả | Bỏ sót | Recall | Tỷ lệ dương tính giả | Precision | Quy mô hàng đợi |
|---|---|---|---|---|---|---|---|
| Thấp hơn | 95 | 297 | 5 | 95% | 3% | 24,23% | 392 |
| Trung bình | 90 | 99 | 10 | 90% | 1% | 47,62% | 189 |
| Cao hơn | 70 | 20 | 30 | 70% | 0,202% | 77,78% | 90 |
Hình dưới đây vẽ lại ba ngưỡng trong bảng, để thấy hàng đợi ngắn đi nhưng số ảnh bị bỏ sót tăng lên.
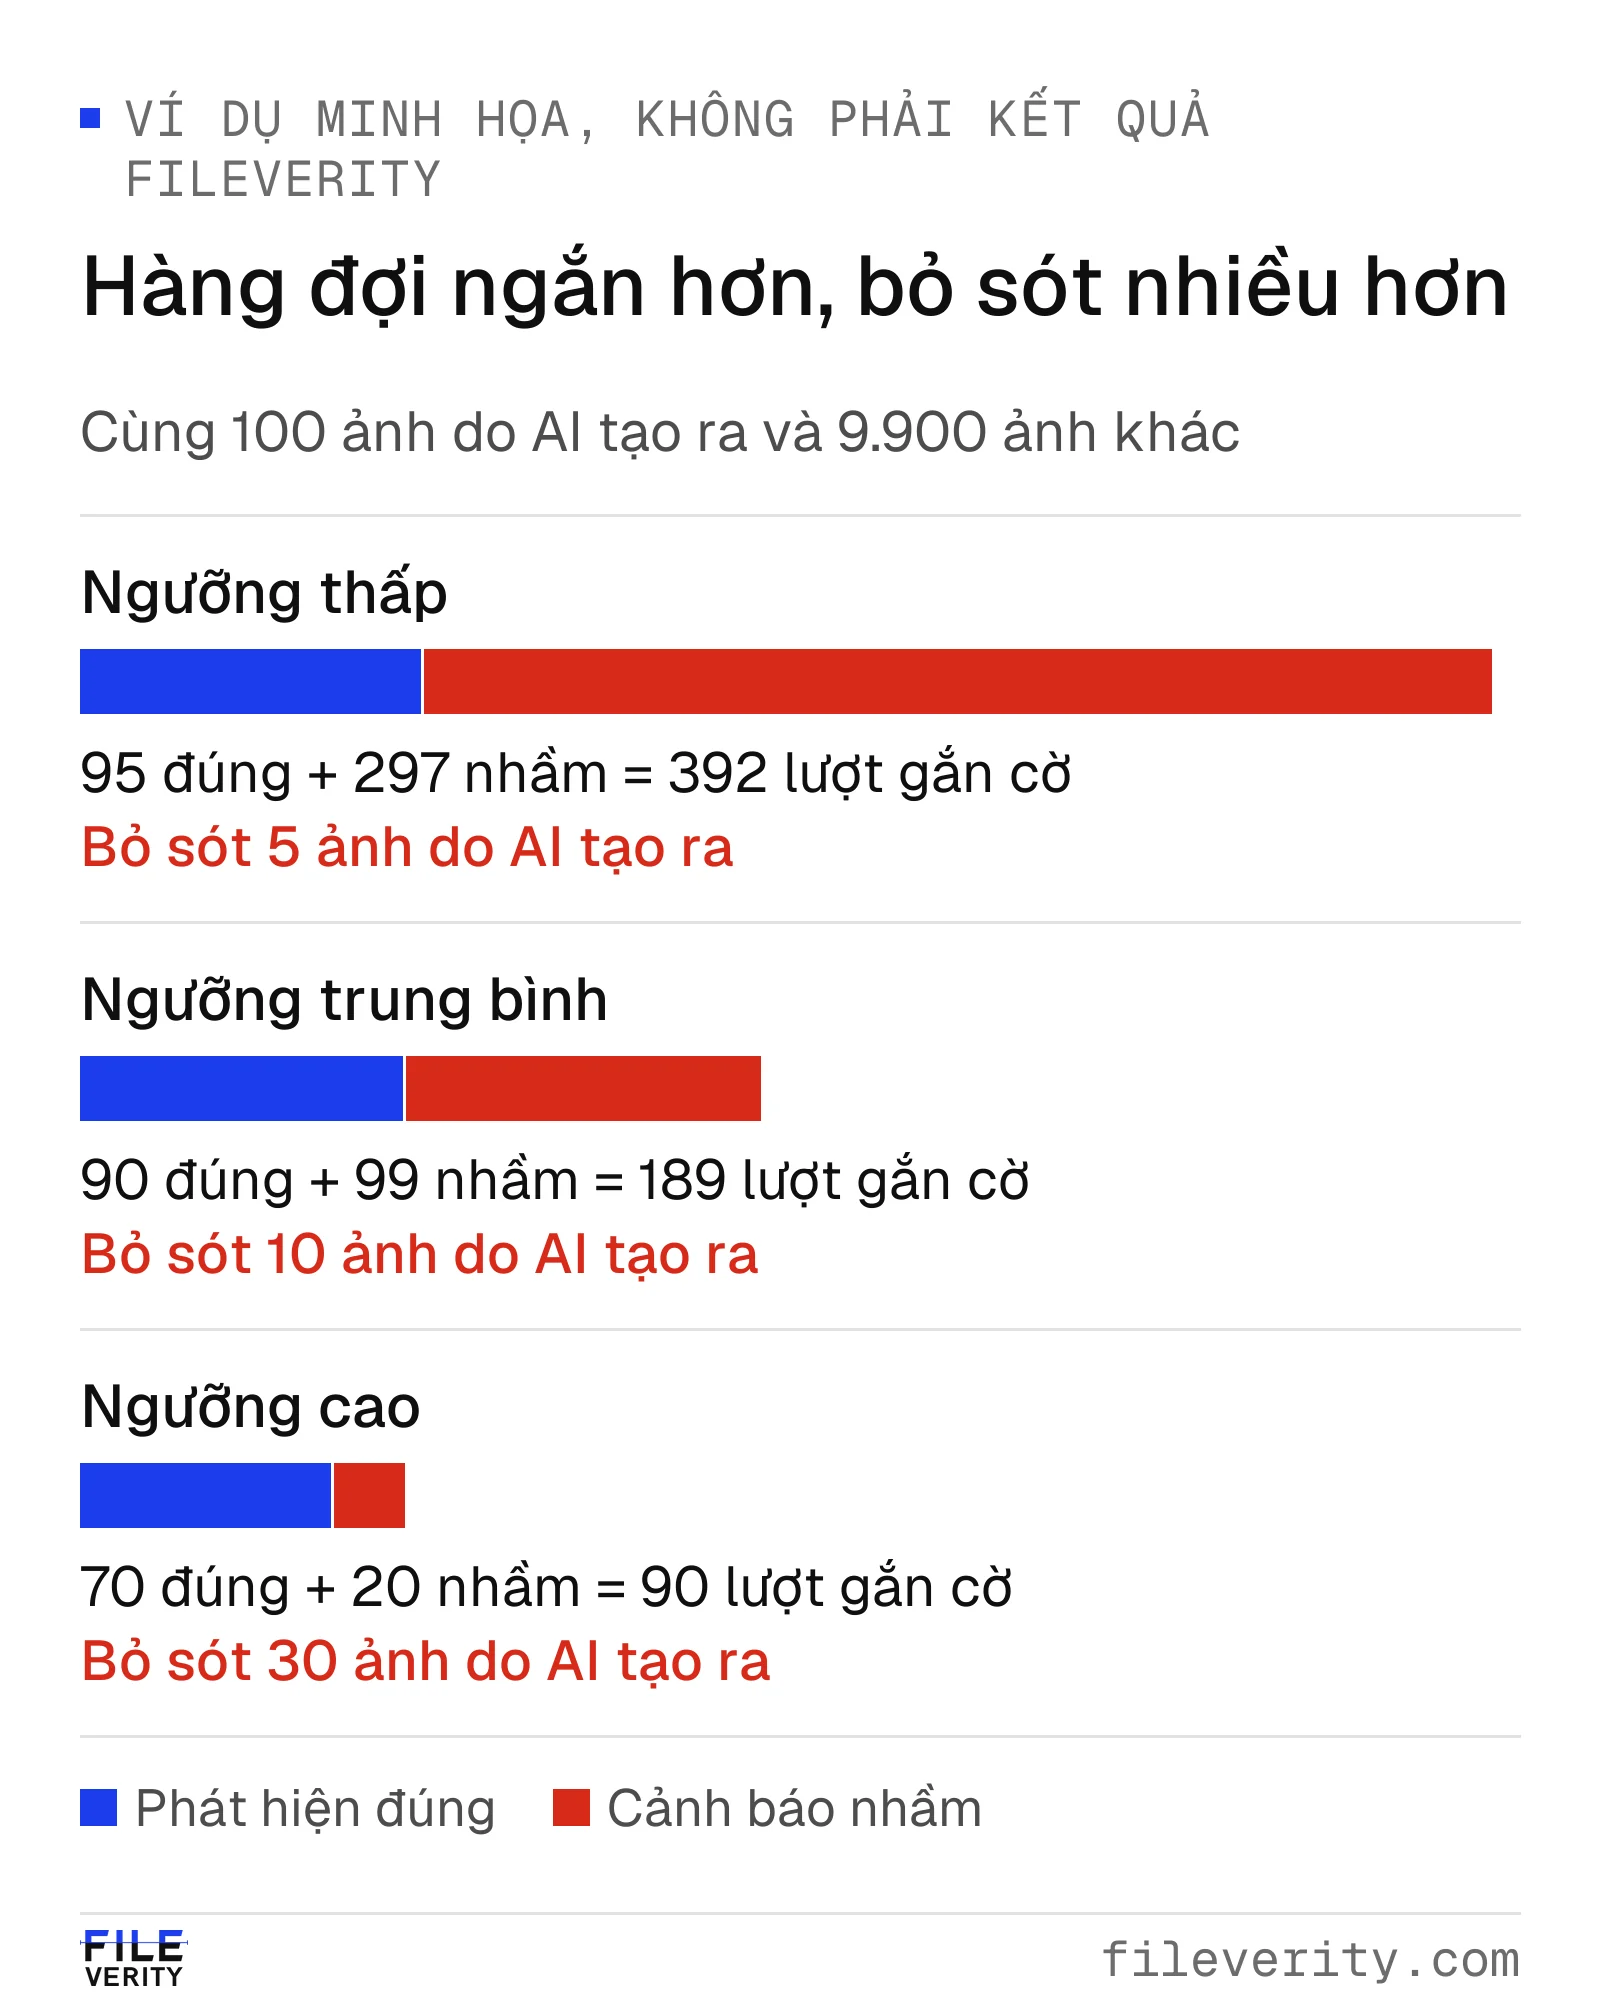
Nâng ngưỡng làm hàng đợi xét duyệt giảm từ 392 xuống 90 ảnh, nhưng số ảnh bị bỏ sót tăng từ 5 lên 30.
Với giả định sáu phút cho mỗi ảnh bị gắn cờ, ba hàng đợi này cần lần lượt 39,2, 18,9 và 9 giờ công, chưa tính điều tra bổ sung. Nếu giả định chi phí xét duyệt là 150.000 ₫ mỗi giờ (con số minh họa, không phải mức chi phí thực tế), chi phí tương ứng là 5.880.000 ₫, 2.835.000 ₫ và 1.350.000 ₫. Chọn hàng đợi nhỏ nhất cũng đồng nghĩa với việc chấp nhận bỏ sót 30 ảnh thay vì 5. Không lựa chọn nào đúng một cách tuyệt đối: hành động dự định, số người xét duyệt hiện có và hậu quả của từng loại lỗi quyết định mức nào là chấp nhận được.
Hãy yêu cầu số liệu hiệu năng tại điểm vận hành mà bạn định dùng. Đường cong ROC tóm tắt recall theo tỷ lệ dương tính giả trên mọi ngưỡng; diện tích dưới đường cong không cho bạn biết recall tại giới hạn cảnh báo nhầm cụ thể của bạn. NIST thảo luận việc báo cáo tỷ lệ dương tính thật tại một mức tỷ lệ dương tính giả thấp đã ấn định trước, khi dương tính giả có thể gây hậu quả lớn như tổn hại danh tiếng hoặc bị đối xử bất lợi. NIST AI 100-4, mục 4.2.2 và Phụ lục E (tiếng Anh)
Phân biệt mức độ tin cậy với hiệu chuẩn
Điểm 90 có thể là một tín hiệu xếp hạng, đầu ra đã qua biến đổi của mô hình hoặc một ước tính xác suất. Điểm này không mặc nhiên có nghĩa là xác suất ảnh do AI tạo ra là 90%, và cũng không có nghĩa là 90% số điểm ảnh đã bị chỉnh sửa. Hãy nắm rõ định nghĩa của điểm số trước khi gán ý nghĩa cho con số.
Hiệu chuẩn (calibration) xét xem các ước tính xác suất có khớp với tần suất quan sát được trên những trường hợp tương đương hay không. Khả năng phân biệt (discrimination) xét xem điểm số có tách được các nhóm cần phân biệt hay không. Cả hai đều quan trọng, nhưng cái này không thay thế được cái kia. Ví dụ tính toán bên dưới cho thấy cách kiểm tra một tuyên bố về xác suất trước khi đưa nó vào chính sách vận hành.
Bên trong điểm số: kiểm tra hiệu chuẩn bằng tần suất quan sát được
Hiệu chuẩn là thuộc tính cần được kiểm tra ở mọi công cụ phát hiện, kể cả công cụ của chúng tôi. Bảng dưới đây là một đợt đánh giá minh họa, không phải dữ liệu của Fileverity. Một cách cụ thể để kiểm tra hiệu chuẩn là biểu đồ độ tin cậy (reliability diagram): chia các dự đoán thành các khoảng xác suất, rồi so sánh dự đoán trung bình của từng nhóm với tần suất dương tính quan sát được của nhóm đó.
Với một nhóm B, hãy tính p̄_B = Σp_i/n_B và r_B = Σy_i/n_B, trong đó p_i là xác suất dự đoán, y_i bằng 1 với một trường hợp dương tính được xác lập độc lập và bằng 0 trong các trường hợp còn lại, còn n_B là cỡ nhóm. Khớp hoàn toàn trong nhóm đó nghĩa là p̄_B = r_B. Điều này không hàm ý từng dự đoán riêng lẻ đều chắc chắn. Guo và cộng sự thảo luận về biểu đồ độ tin cậy và cách đo hiệu chuẩn trong phân loại bằng mạng nơ-ron. Guo et al., ICML 2017 (tiếng Anh)
Hãy xét đợt đánh giá nhị phân minh họa sau:
| Khoảng xác suất | Số ảnh | Dự đoán trung bình | Số ca dương tính đã biết | Tần suất dương tính quan sát được | Chênh lệch tuyệt đối |
|---|---|---|---|---|---|
| 0,0 đến dưới 0,4 | 100 | 0,20 | 10 | 0,10 | 0,10 |
| 0,4 đến dưới 0,7 | 100 | 0,50 | 40 | 0,40 | 0,10 |
| 0,7 đến 1,0 | 100 | 0,80 | 60 | 0,60 | 0,20 |
Chênh lệch tuyệt đối theo nhóm, tính theo trọng số cỡ mẫu, là Σ(n_B/N) × |p̄_B − r_B|. Ở đây nó bằng (0,10 + 0,10 + 0,20)/3 = 0,1333, tức khoảng 13,3 điểm phần trăm. Con số này mô tả mức lệch trong các nhóm này; nó không phải tỷ lệ phân loại sai và cũng không khẳng định mọi điểm số đều sai 13,3 điểm phần trăm. Các cách chia nhóm khác nhau có thể che giấu hoặc làm lộ những chênh lệch khác nhau, vì vậy hãy giữ lại số lượng ảnh theo từng nhóm và biểu đồ cùng với con số tóm tắt.
Biểu đồ dưới đây đặt ba nhóm này cạnh đường hiệu chuẩn hoàn hảo, để thấy dự đoán cao hơn tần suất quan sát được ở cả ba nhóm.
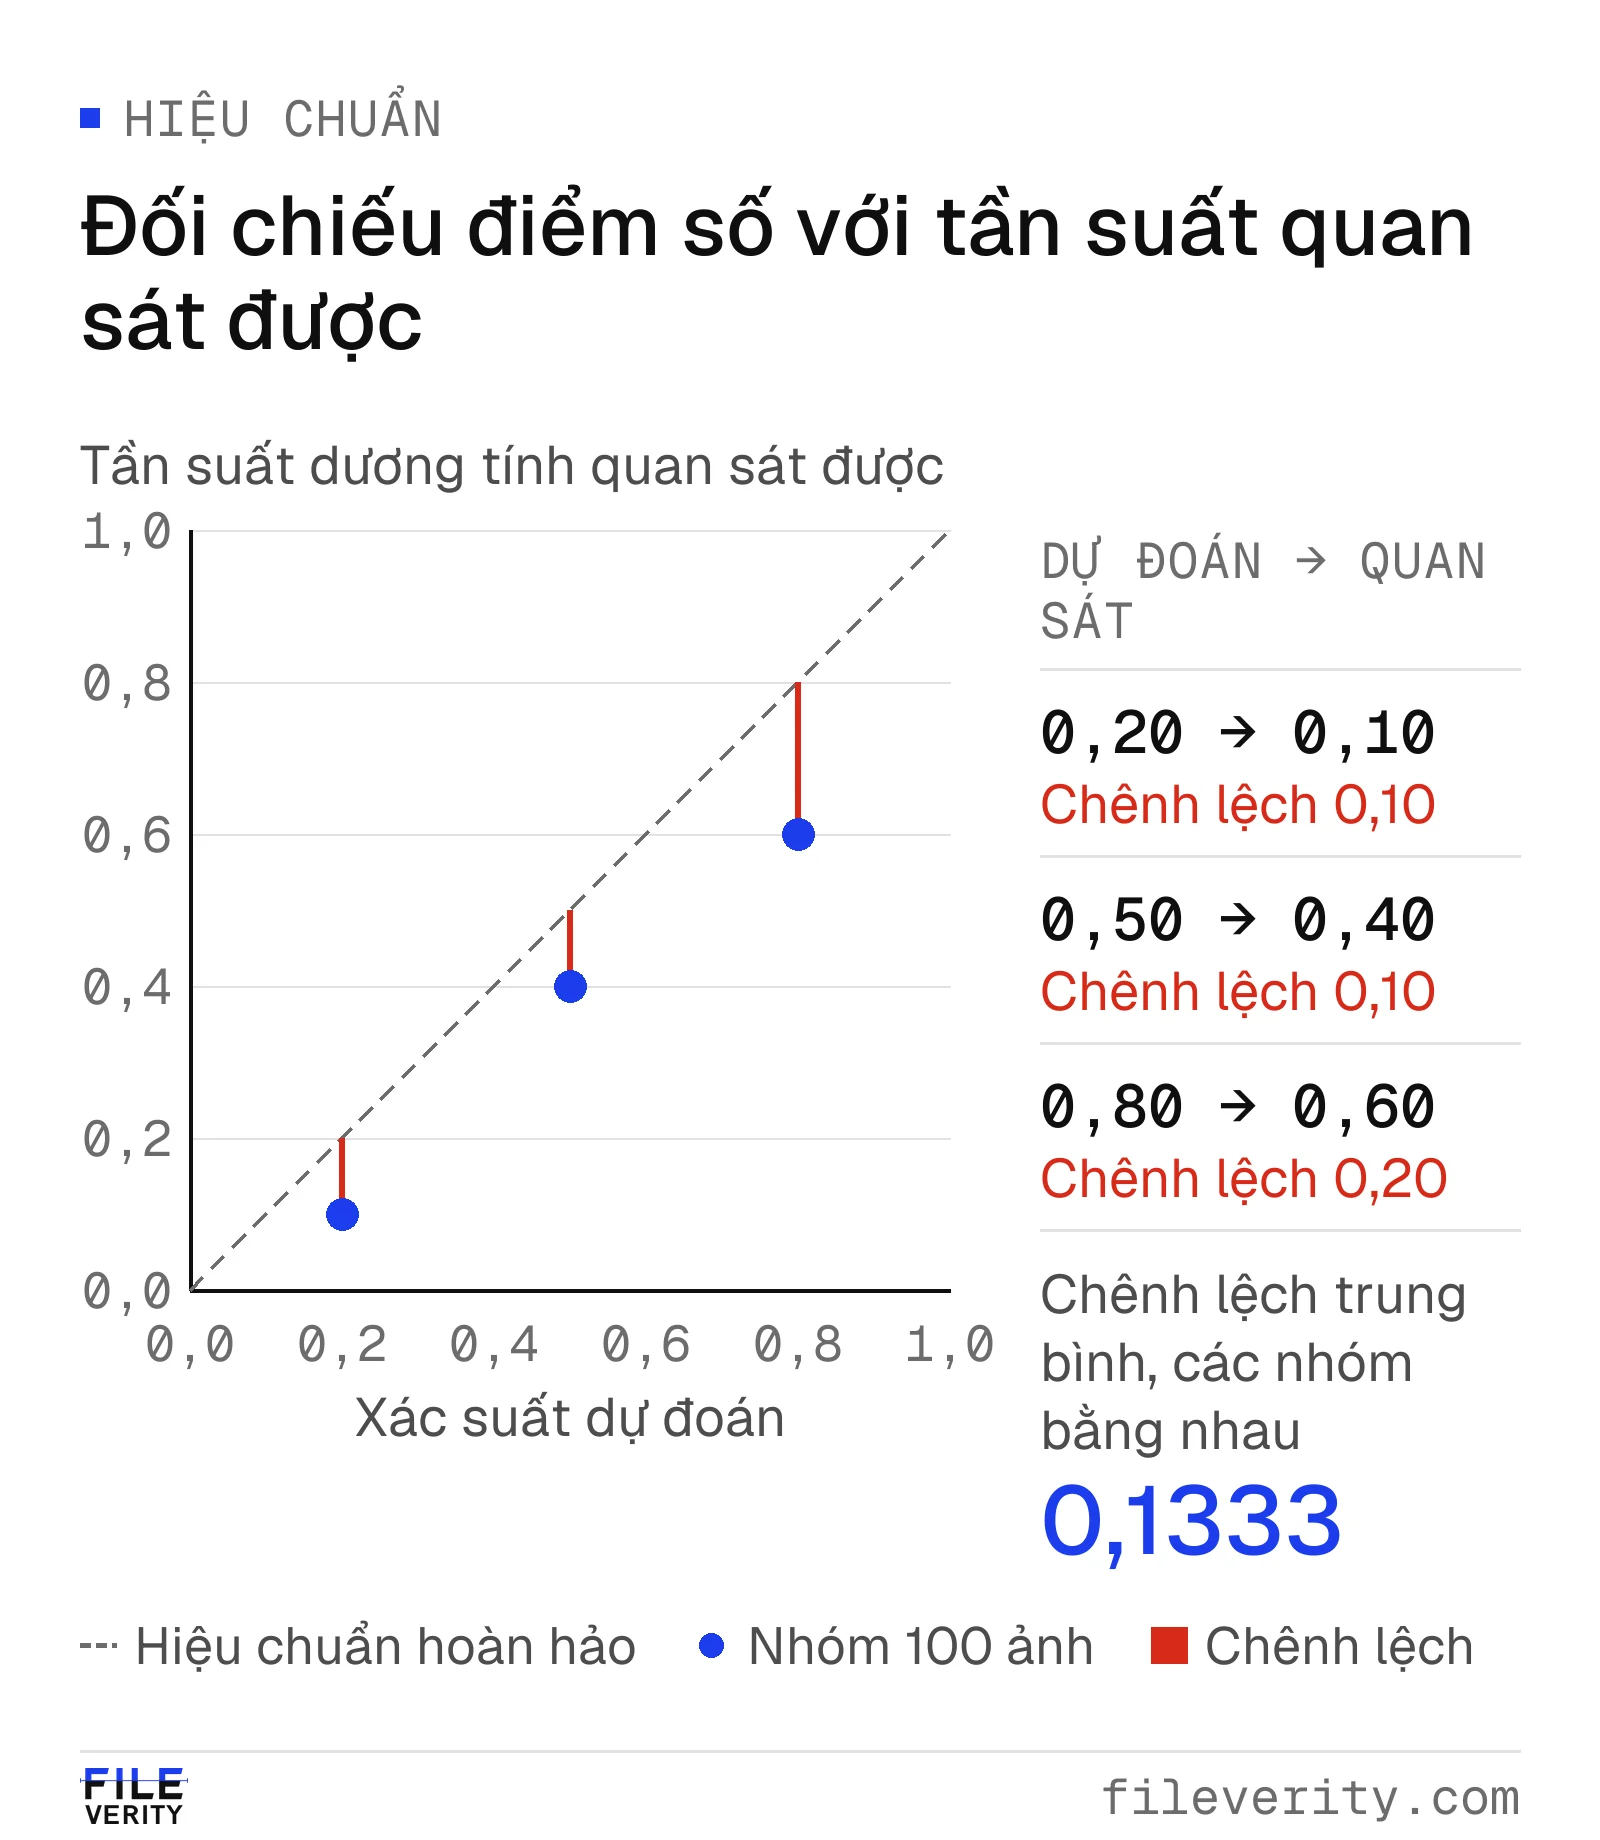
Dữ liệu minh họa, mỗi nhóm 100 ảnh: dự đoán cao hơn tần suất quan sát được lần lượt 10, 10 và 20 điểm phần trăm.
Vì sao hiệu chuẩn có thể cải thiện mà khả năng phân biệt không tốt hơn? Một phép biến đổi điểm số đơn điệu tăng ngặt (strictly increasing) giữ nguyên thứ tự của mọi cặp, nên chỉ số xếp hạng như ROC AUC không đổi, trong khi các giá trị xác suất có thể tiến gần hơn tới tần suất quan sát được. Giá trị ngưỡng ứng với cùng những quyết định đó có thể thay đổi. Do đó, hãy yêu cầu bằng chứng cả về lỗi ở điểm vận hành hoặc theo xếp hạng lẫn về cách diễn giải xác suất.
Hiệu chuẩn cũng phụ thuộc vào quần thể được đánh giá. Ovadia và cộng sự cho thấy ước lượng độ bất định có thể suy giảm khi dữ liệu bị lệch phân phối (dataset shift). Ovadia et al., NeurIPS 2019 (tiếng Anh) Hãy xây dựng mọi phép ánh xạ hiệu chuẩn trên dữ liệu tách biệt với mẫu nghiệm thu cuối cùng; sau đó kiểm tra riêng từng kênh tiếp nhận có liên quan, trong đó có các kênh tiếp nhận của chính bạn.
Giữ các tệp chưa kết luận được và không được hỗ trợ trong mẫu số
Một công cụ phát hiện có thể từ chối đưa ra kết luận, từ chối một định dạng không được hỗ trợ, hết thời gian xử lý hoặc trả về cảnh báo về chất lượng ảnh. Những kết quả này cần được đếm riêng. Nếu loại chúng ra, hệ thống có thể trông đáng tin cậy chính vì các trường hợp khó nhất đã biến mất.
Hãy xét một lô giả định khác: 1.000 hồ sơ gửi lên, trong đó 850 hồ sơ nhận được phân loại dùng được, 100 hồ sơ nhận kết quả chưa chắc chắn và 50 hồ sơ bị lỗi khi xử lý. Độ bao phủ phân loại là 850/1.000 = 85%. Nếu 833 phân loại là đúng, độ chính xác tổng thể trong số các tệp đã phân loại là 833/850 = 98%. Tính trên toàn bộ hồ sơ, 83,3% nhận được phân loại đúng; đây là một con số mô tả có tính đến độ bao phủ, không phải độ chính xác tổng thể nhị phân thông thường. Còn lại 150 hồ sơ chưa được giải quyết, không tự động bị coi là sai hay âm tính.
Hãy báo cáo độ chính xác tổng thể cùng với độ bao phủ, rồi chia nhỏ độ bao phủ theo nhãn đã biết và theo kênh tiếp nhận. Một hệ thống có thể từ chối kết luận thường xuyên hơn ở các ca dương tính. Hãy báo cáo recall tổng thể kèm cách xử lý rõ ràng các trường hợp từ chối kết luận, bên cạnh recall chỉ tính trên các ca đã phân loại, để người dùng thấy mỗi mẫu số loại trừ những gì. Hãy chuẩn bị phương án dự phòng cho các tệp chưa giải quyết được và đưa phương án đó vào ước tính khối lượng công việc. Ảnh chụp màn hình và ảnh bị nén là những tình huống dễ dẫn tới kết quả kém dứt khoát hơn; hướng dẫn Ảnh chụp màn hình và ảnh bị nén đi sâu vào những tình huống này.
Xây dựng tập kiểm tra độc lập (holdout) mang tính đại diện và chưa từng được dùng
Một đợt đánh giá cần nhãn có căn cứ rõ ràng, giải trình được và một kế hoạch lấy mẫu. Hãy dùng dữ liệu được phép sử dụng và có nguồn gốc được ghi lại: các ví dụ do AI tạo ra trong điều kiện kiểm soát, ảnh gốc từ máy ảnh có lịch sử chụp đã biết và, khi cần, các chỉnh sửa được gắn nhãn riêng. Nhận định của một công cụ phát hiện khác không phải là nhãn chuẩn (ground truth). Hãy giữ các nhãn còn tranh cãi ở trạng thái chưa giải quyết và ghi lại quy tắc phân xử.
Hãy để tập kiểm thử phản ánh đúng các tệp bạn thực sự nhận được, chứ không chỉ các ảnh gốc nguyên vẹn. Hãy đưa vào các kênh, kích thước ảnh, loại nội dung và lịch sử xử lý thông thường mà quy trình của bạn gặp phải, chẳng hạn ảnh đã qua ứng dụng nhắn tin hoặc mạng xã hội. Khi chia dữ liệu, hãy giữ các biến thể liên quan của cùng một ảnh nguồn trong cùng một tập; nếu không, cùng một khung cảnh có thể lọt vào cả tập điều chỉnh lẫn tập đánh giá. Nếu có thể, hãy tách cả các phiên chụp và các bộ sưu tập nguồn.
Hãy dùng một tập phát triển để chọn ngưỡng và một tập kiểm tra độc lập để đánh giá chính sách đã chọn, chỉ một lần. Nếu kết quả không đạt trên tập kiểm tra độc lập khiến bạn phải thay đổi chính sách, hãy coi tập đó là một phần của dữ liệu phát triển và lấy một tập kiểm thử mới chưa từng dùng cho chính sách đã sửa. Với dịch vụ có mô hình không công khai, hãy hỏi về mức độ trùng lặp đã biết với các benchmark công khai, đồng thời ghi nhận rằng có những phần trùng lặp với dữ liệu huấn luyện mà bạn không thể kiểm tra được.
Hãy bổ sung một tập thử thách gồm các ca được cố tình chọn vì khó. Hãy báo cáo tập này riêng, tách khỏi mẫu đại diện, để việc cố ý lấy nhiều ca bất thường hơn tỷ lệ thực tế không bị nhầm với tỷ lệ phổ biến bình thường của luồng tiếp nhận. Các nghiên cứu về phát hiện ảnh do AI tạo ra kiểm tra khả năng khái quát hóa giữa các công cụ tạo ảnh chính vì thành công với một nguồn không chứng minh được khả năng bao quát mọi nguồn. Wang và cộng sự, CNN-generated images are surprisingly easy to spot… for now, CVPR 2020 (tiếng Anh)
Đặt tiêu chí chấp nhận trước khi xem kết quả
Hãy lập một bản ghi đánh giá gắn từng chỉ số với quyết định mà nó phải hỗ trợ.
Ví dụ tiêu chí chấp nhận cho một quy trình chuyển ảnh sang người xét duyệt.
| Hạng mục | Tiêu chí hoặc nội dung ghi nhận ví dụ |
|---|---|
| Mục đích sử dụng | Chuyển ảnh cho người xét duyệt; không có quyết định bất lợi tự động |
| Cấu hình cố định | Ghi lại phiên bản dịch vụ, ngưỡng, định nghĩa điểm số và bước tiền xử lý |
| Cảnh báo nhầm | Cận trên tin cậy một phía 95% của tỷ lệ dương tính giả không quá 1% |
| Phát hiện | Cận dưới tin cậy một phía 95% của recall đạt tối thiểu 85% |
| Độ bao phủ | Ít nhất 95% tệp được phân loại; mọi tệp chưa giải quyết đều có phương án dự phòng |
| Năng lực | Tổng khối lượng xét duyệt và dự phòng nằm trong ngân sách nhân sự hằng ngày đã ấn định trước |
| Nhóm con | Báo cáo riêng các kênh tiếp nhận quan trọng; bằng chứng chưa đủ thì giữ ở trạng thái chưa giải quyết |
| Người quyết định | Một người xét duyệt được chỉ định đích danh ghi nhận việc chấp nhận, từ chối hoặc thí điểm có giới hạn |
Cận tin cậy giúp tránh việc coi một mẫu nhỏ không có lỗi là bằng chứng chắc chắn. Nếu không có dương tính giả nào trong 300 ca âm tính độc lập, cận trên nhị thức chính xác một phía 95% là 1 − 0,05^(1/300), xấp xỉ 0,994%. Nếu không có trường hợp nào trong 100 ca, cận này xấp xỉ 2,951%.
Cách suy ra khá ngắn gọn: nếu xác suất dương tính giả là p, xác suất không có dương tính giả nào trong n ca âm tính độc lập là (1 − p)^n; đặt giá trị này bằng 0,05 ta được cận trên p = 1 − 0,05^(1/n). Vì vậy, không quan sát thấy lỗi nào không chứng minh được tỷ lệ lỗi bằng không. Các phép tính này giả định các ca độc lập và đại diện; nhiều ảnh gần giống nhau không cung cấp bằng chứng tương đương với các hồ sơ gửi độc lập.
Với ví dụ ngưỡng trung bình, tỷ lệ dương tính giả quan sát được là 1% sẽ không đạt yêu cầu cận tin cậy trên không quá 1%. Ước lượng điểm và cận tin cậy trả lời những câu hỏi khác nhau. Hãy lập kế hoạch cỡ mẫu theo mức bằng chứng cần có trước khi thu thập tập kiểm thử.
Theo dõi hiện tượng trôi (drift) theo thời gian và diễn đạt kết luận thận trọng
Sau khi triển khai, hãy theo dõi tỷ lệ gắn cờ, tỷ lệ chưa giải quyết, cơ cấu kênh tiếp nhận, thời gian xét duyệt và các kết quả được xác nhận độc lập. Riêng việc tỷ lệ gắn cờ tăng không cho biết đó là do có nhiều ảnh do AI tạo ra hơn hay do cảnh báo nhầm tăng. Hãy lấy mẫu cả các trường hợp không bị gắn cờ; chỉ xem xét các lượt gắn cờ sẽ khiến phần lớn các ca bỏ sót gần như không bị phát hiện. Hãy tính đến xác suất lấy mẫu khi ước lượng các chỉ số cho toàn bộ luồng tiếp nhận từ những nhóm được cố ý lấy nhiều hơn tỷ lệ thực tế.
Hãy ghi lại các thay đổi về mô hình, ngưỡng và quy trình tiếp nhận. Hãy đánh giá lại sau mỗi thay đổi quan trọng và duy trì các lần kiểm tra có gắn nhãn định kỳ, kể cả khi số trung bình trên bảng điều khiển có vẻ ổn định. Một công cụ tạo ảnh mới, kênh gửi mới hoặc loại nội dung mới có thể làm hiệu năng thay đổi mà không có cảnh báo tổng thể rõ ràng.
Hãy tách quan sát khỏi quyết định trong hồ sơ vụ việc: “Ảnh vượt ngưỡng xét duyệt” là một quan sát. “Điều này củng cố mối nghi ngờ về việc ảnh do AI tạo ra” là một suy luận. Một bản gốc đã được xác minh hoặc lịch sử tạo lập có tài liệu là bằng chứng đối chiếu. Yêu cầu cung cấp những tài liệu đó là một hành động. Không câu nào trong số này, riêng lẻ, chứng minh được gian lận hay tính xác thực của cảnh được mô tả trong ảnh.
Biến một con số về độ chính xác thành yêu cầu cung cấp bằng chứng
Hãy yêu cầu đủ thông tin để gắn kết quả được công bố với luồng tiếp nhận và hành động tiếp theo của bạn. Bạn có thể sao chép yêu cầu sau vào buổi làm việc với nhà cung cấp:
Chúng tôi cần đánh giá khả năng phát hiện [ảnh do AI tạo ra hoàn toàn / chỉnh sửa cục bộ / nhiệm vụ khác đã được xác định] trên [định dạng tệp, kênh và điều kiện chất lượng]. Kết quả sẽ kích hoạt [hành động xét duyệt], với khối lượng khoảng [số ảnh và số hồ sơ mỗi ngày]. Năng lực xét duyệt của chúng tôi là [giờ công hoặc số hồ sơ mỗi ngày].
Vui lòng cung cấp: phiên bản sản phẩm đã được đánh giá và định nghĩa điểm số; nguồn gốc nhãn và số lượng dương tính/âm tính; cả bốn giá trị của ma trận nhầm lẫn tại điểm vận hành đề xuất; các ước lượng về độ bất định; và số lượng riêng cho các đầu vào chưa kết luận được, không được hỗ trợ và bị lỗi. Cho biết các tệp nào bị loại khỏi từng chỉ số, độ bao phủ và recall thay đổi ra sao khi tính cả các tệp đó, và các ảnh nguồn liên quan có trùng lặp giữa tập điều chỉnh và tập đánh giá hay không.
Chỉ rõ bằng chứng nào áp dụng cho trường hợp sử dụng này, điều kiện nào vẫn chưa được kiểm thử, và một đợt thí điểm cần xác lập những gì.
Fileverity báo cáo từng kết quả theo nhiệm vụ, hiển thị riêng các đầu vào chưa kết luận được và không được hỗ trợ thay vì giấu đi, và nêu mức độ vững chắc của bằng chứng đằng sau từng phát hiện; cách phân tích ảnh vận hành được trình bày ở trang phương pháp phân tích ảnh. Hãy liên hệ bộ phận kinh doanh và gửi cho chúng tôi yêu cầu bằng chứng cùng các kênh tiếp nhận của bạn; chúng tôi sẽ cùng đội ngũ của bạn xem xét các hồ sơ thực tế. Với quyết định mua hàng rộng hơn, gồm cả xử lý dữ liệu và tổng chi phí xét duyệt, hãy đọc tiếp danh sách kiểm tra khi chọn phần mềm phát hiện ảnh AI. Về phần tích hợp (giới hạn, webhook, thử lại, lưu giữ dữ liệu và thanh toán), hãy xem Cách chọn API phát hiện AI.
Tác giả Yang Zheng · Người kiểm duyệt Bill Liu