Đánh giá công cụ phát hiện
Cách nhận biết AI nào viết: dấu hiệu văn phong của ChatGPT, Claude, Gemini, Grok, DeepSeek, Qwen và GLM
Cụm từ và dấu câu đặc trưng của bảy dòng mô hình AI trong tiếng Việt, kèm hệ số so với người viết, cách đo và vì sao đó chưa phải bằng chứng.
Đăng ngày · Cập nhật ngày · 7 phút đọc
Trong trang này
Mỗi dòng mô hình AI có thói quen viết riêng, và trong tiếng Việt thói quen ấy lộ ra ở những từ hơi quá "đẹp" như "minh bạch", "trọn vẹn", "then chốt", ở cách nối ý bằng "trước hết... thứ hai là... ba là", và ở dấu câu: AI dùng ít dấu ba chấm, ít dấu chấm than và ít ngoặc đơn hơn người viết. Bài này tổng hợp những dấu hiệu đo được của bảy dòng mô hình: ChatGPT của OpenAI, Claude của Anthropic, Gemini của Google, Grok của xAI, DeepSeek, Qwen của Alibaba và GLM của Zhipu. Số liệu lấy từ kho văn bản tiếng Việt của Fileverity, so văn bản do AI viết hoàn toàn với văn bản của người viết cùng thể loại.
Đây là dấu hiệu, không phải bằng chứng: người viết cũng dùng những cụm từ này, mô hình đổi phiên bản thì thói quen đổi theo, và chỉ dẫn của người dùng có thể thay đổi văn phong. Nếu bạn muốn trả lời câu hỏi "ai viết đoạn này" với một văn bản cụ thể, hãy dùng công cụ phát hiện văn bản AI của Fileverity, nơi Veread đọc cả đoạn văn thay vì tra danh sách cụm từ. Nếu văn bản nằm trên một trang web hoặc trong Google Tài liệu, tiện ích Chrome của Fileverity kiểm tra ngay tại trang đó.
Cụm từ để lộ từng dòng mô hình
Biểu đồ dưới đây lấy hai cụm từ đặc trưng cho mỗi dòng, kèm số lần cụm từ xuất hiện nhiều hơn so với người viết. Ví dụ, "then chốt" xuất hiện trong văn bản Grok nhiều gấp 26 lần so với văn người viết. Vì tất cả thanh dùng chung một thang, một giá trị rất lớn như thế làm các thanh khác ngắn đi.
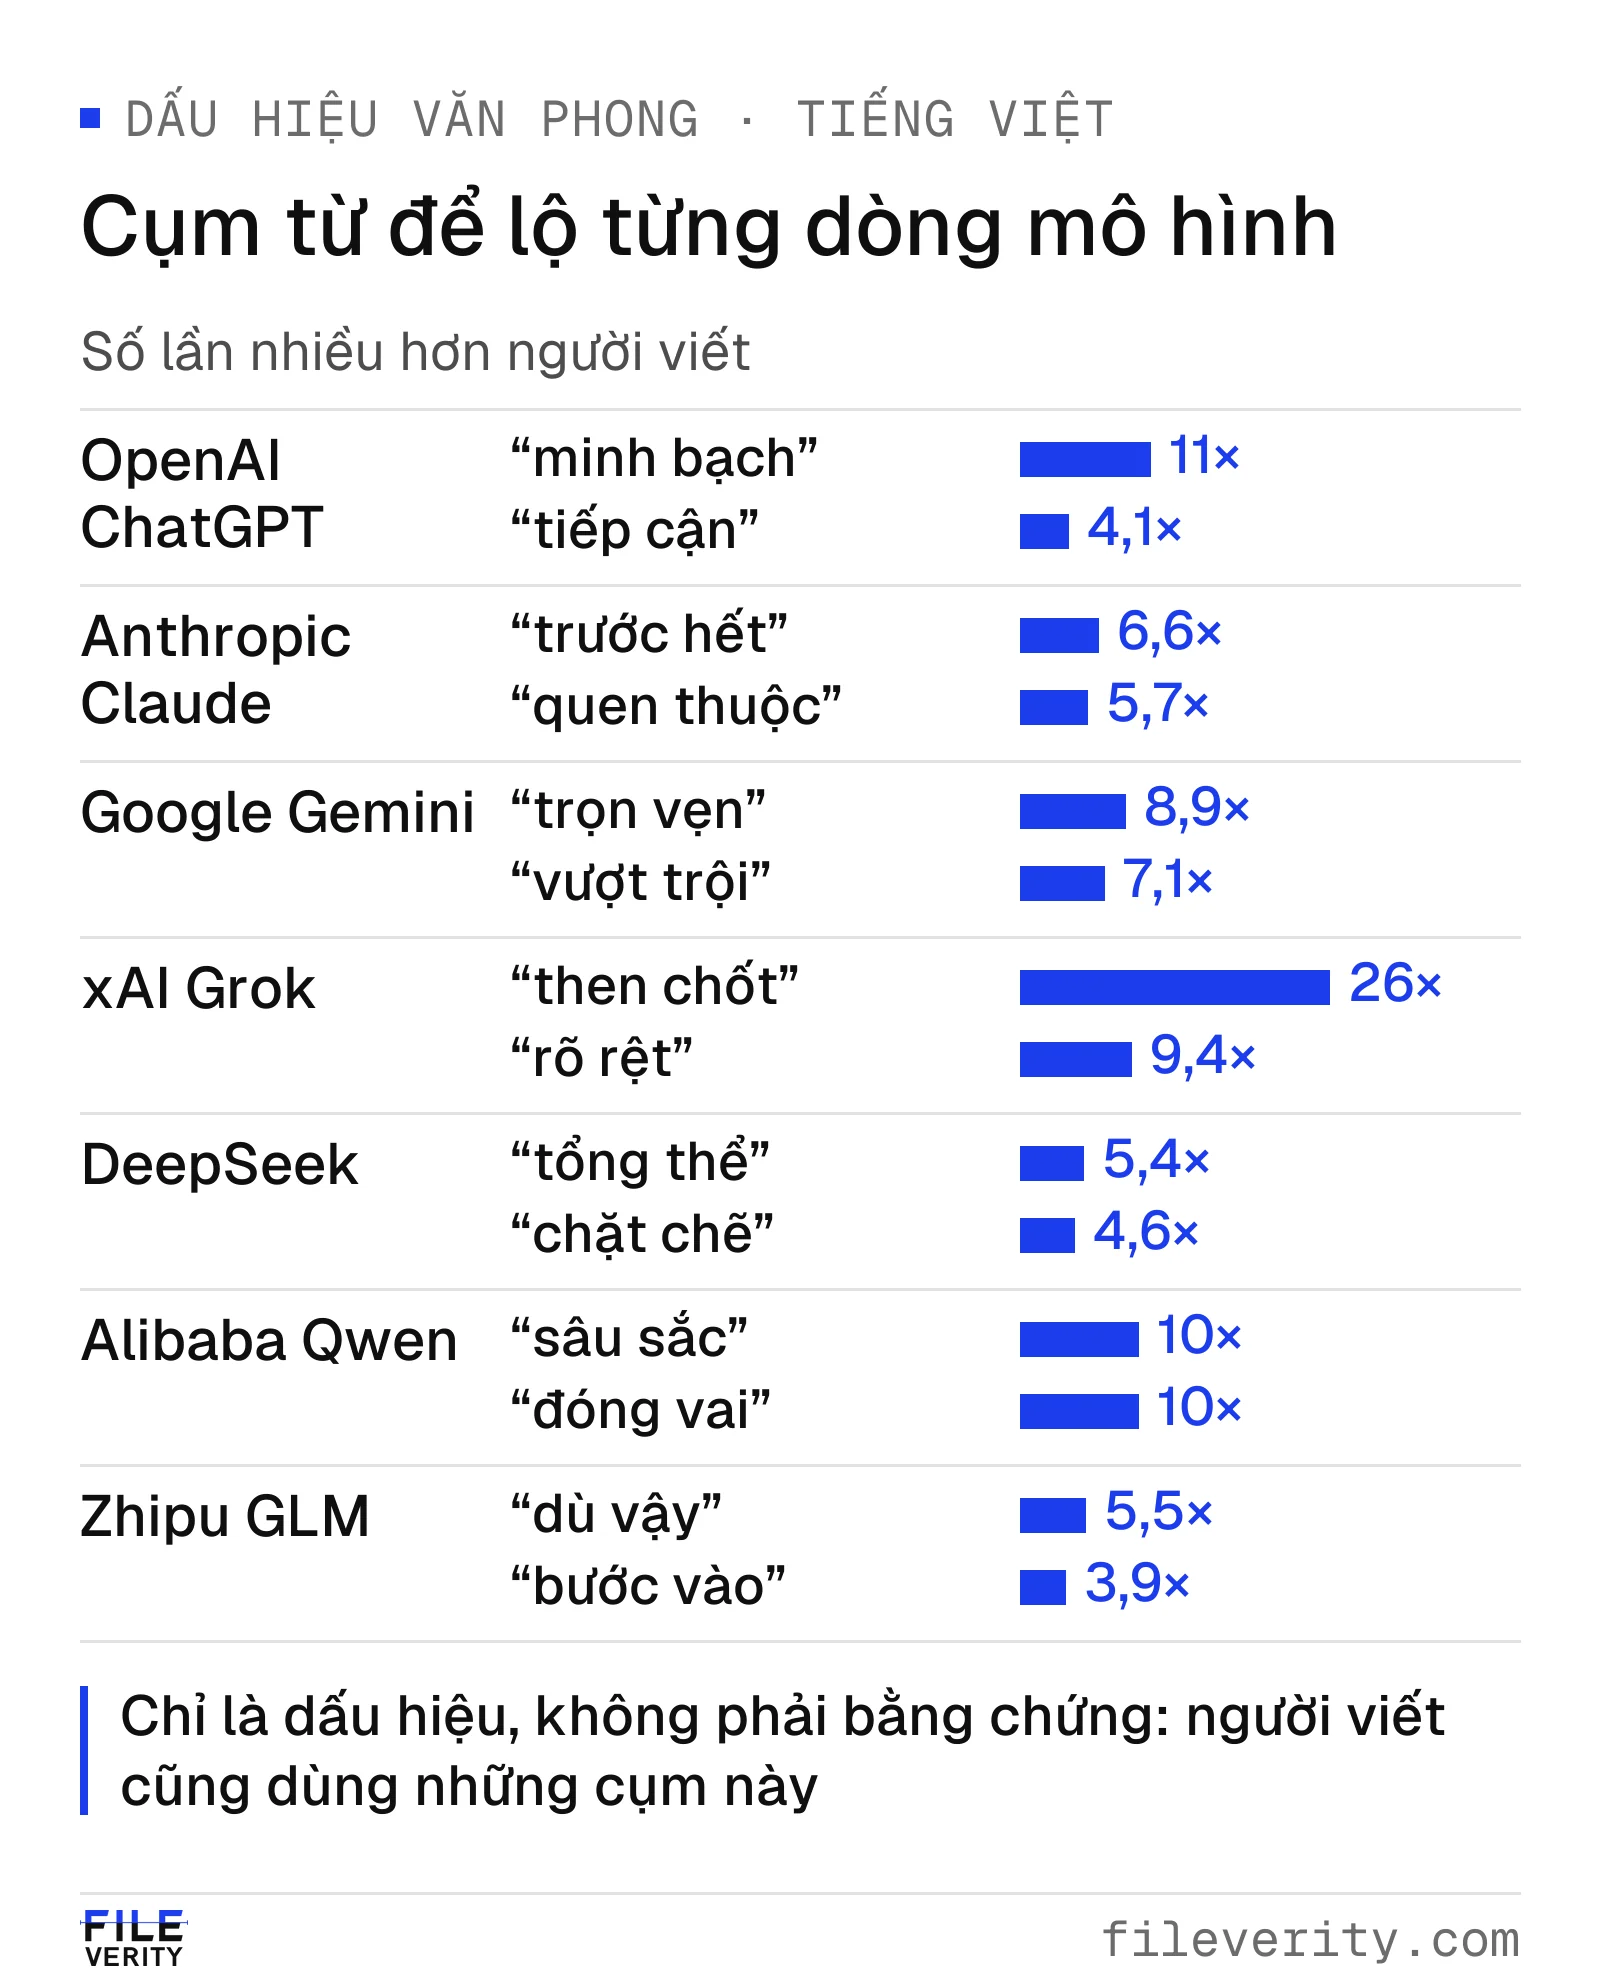
Mỗi cụm từ chỉ là một dấu hiệu: người viết cũng dùng những cụm này, chỉ là ít hơn.
Cách đọc biểu đồ: một cụm xuất hiện nhiều hơn người viết không có nghĩa là hễ gặp nó thì văn bản do AI viết. "Minh bạch" gấp 11 lần ở ChatGPT nhưng cũng nằm trong danh sách của Claude (5,8 lần) và DeepSeek (7,5 lần). Giá trị nằm ở sự kết hợp nhiều dấu hiệu cùng lúc, và ở những cụm tách dòng này khỏi các dòng AI còn lại; phần đó có ở từng mục bên dưới.
Cách đo: so sánh với người viết như thế nào
Chúng tôi lấy các văn bản do một dòng mô hình viết hoàn toàn và so với văn bản của người viết cùng ngôn ngữ. Văn bản người viết được cân lại cho khớp nguồn và thể loại với văn bản AI, nên chủ đề hay thể loại không tự tạo ra kết quả. Sau đó chúng tôi đối chiếu thêm với chính bản gốc của người viết mà văn bản AI được viết từ đó để kiểm tra chiều của kết quả.
Cụm từ là chuỗi từ một đến ba từ, được chấm theo tần suất tương đối đã làm trơn. Chỉ giữ cụm xuất hiện ở nhiều văn bản thuộc nhiều nguồn và nhiều thể loại, không phải từ nối đơn thuần, con số, tên riêng hay từ chỉ chủ đề, và phải chỉ cùng một chiều ở cả hai nửa ngẫu nhiên của dữ liệu (chia theo văn bản gốc). Dấu hiệu cấu trúc như dấu câu hay kiểu liệt kê đếm trên 1.000 từ và chỉ giữ khi chiều nhất quán ở cả hai nửa dữ liệu và ở cả nhiệm vụ viết mới lẫn viết lại. Văn bản AI trong thử nghiệm được tạo ở dạng văn xuôi thuần, nên các dấu hiệu danh sách và tiêu đề nói rất ít về trò chuyện thực tế với chatbot.
Có hai loại so sánh. "Gấp bao nhiêu lần người viết" cho biết dòng mô hình khác người viết ở đâu. "Gấp bao nhiêu lần các dòng AI khác" cho biết cụm nào giúp tách dòng này khỏi dòng kia, và là phần đáng chú ý nhất nếu bạn muốn đoán xem đoạn văn đến từ mô hình nào.
Từng dòng mô hình viết thế nào
ChatGPT (OpenAI): từ hành chính, "không X mà Y"
Văn bản của ChatGPT nghiêng về từ ngữ hành chính, quản trị: "minh bạch" (gấp 11 lần người viết), "phản ánh" (5,3 lần), "ưu tiên" (4,3 lần), "tiếp cận" (4,1 lần), "sinh hoạt" (3,9 lần). Những cụm giúp tách ChatGPT khỏi các dòng AI khác là "bảo đảm" (2,8 lần các dòng khác), "nội dung" (2 lần), "xác định" và "điều chỉnh" (cùng 1,9 lần).
Về cấu trúc, ChatGPT dùng kiểu câu "không X mà Y" gấp 6,4 lần người viết (0,9 lần mỗi 1.000 từ so với 0,1) và liệt kê ba ý gấp 2,3 lần. Ngược lại, dấu ba chấm ít hơn 4,5 lần, ngoặc đơn ít hơn 2,6 lần, dấu chấm than ít hơn 2,3 lần. So với các dòng AI khác, ChatGPT dùng nhiều dấu ngoặc kép cong hoặc kép góc (2,4 lần) và dấu chấm phẩy (1,8 lần). Xem chi tiết ở trang cách nhận biết văn bản ChatGPT viết của ChatGPTDetect.
Claude (Anthropic): nối ý theo thứ tự, "trước hết", "quen thuộc"
Claude hay mở ý bằng "trước hết" (6,6 lần người viết) và đánh số lập luận bằng "thứ hai là" (5,5 lần các dòng AI khác) và "ba là" (6,1 lần), điều khiến văn bản đọc như một lập luận có thứ tự. Các từ khác nổi bật so với người viết là "quen thuộc" (5,7 lần), "minh bạch" (5,8 lần), "nền tảng" (5,2 lần) và "định kỳ" (4,4 lần). Cũng tách Claude khỏi các dòng khác là "vì sao" (3,6 lần), "tuy vậy" (3,7 lần) và "phần lớn" (3,2 lần).
Claude có dấu ba chấm ít hơn người viết tới 8,9 lần, mức mạnh nhất trong bảy dòng, ngoặc đơn ít hơn 2,9 lần và ngoặc kép cong hay kép góc ít hơn 2,6 lần. Kiểu "không X mà Y" gấp 4 lần người viết nhưng lại ít hơn 2,2 lần so với các dòng AI khác; liệt kê ba ý gấp 1,6 lần. Xem thêm tại cách nhận biết văn bản do Claude viết của ClaudeDetect.
Gemini (Google): tính từ tuyệt đối và câu dài
Gemini ưa từ nhấn mạnh và khen ngợi: "trọn vẹn" (8,9 lần người viết), "vượt trội" (7,1 lần), "tuyệt đối" (6,6 lần), "thực chất" (5,7 lần), "mang lại" (4,7 lần), "tinh tế" (4,6 lần). So với các dòng AI khác, "cực kỳ" (3,6 lần), "tâm hồn" và "thấu hiểu" (cùng 3,5 lần) là những cụm đặc trưng.
Kiểu "không X mà Y" gấp 8,7 lần người viết, mạnh hơn hẳn ChatGPT và Claude. Gemini dùng ít dấu ba chấm hơn 6 lần, ngoặc kép ít hơn 3 lần và dấu hỏi ít hơn 2,9 lần; độ dài câu đồng đều hơn người viết (hệ số biến thiên 0,40 so với 0,60). So với các dòng AI khác, Gemini dùng nhiều ngoặc đơn hơn 1,9 lần, dấu hai chấm hơn 1,7 lần, và câu dài trung bình 38 từ, trong khi các dòng khác thường khoảng 30. Xem thêm tại cách nhận biết văn bản Gemini của GeminiDetect.
Grok (xAI): "then chốt", "rõ rệt" và câu đều đều
Grok có cụm nổi bật nhất bảng: "then chốt" gấp 26 lần người viết. Kèm theo là "rõ rệt" (9,4 lần), "lan tỏa" (8,3 lần), "gần gũi" (5,3 lần) và "biến động" (4,8 lần). Những cụm tách Grok khỏi các dòng khác là "rất nhiều" (3,1 lần), "hầu hết" (3 lần), "kiên trì" và "cực kỳ" (cùng 2,9 lần) và "rõ rệt" (3,9 lần).
Về cấu trúc, "không X mà Y" gấp 7 lần người viết, liệt kê ba ý gấp 1,9 lần; dấu ba chấm ít hơn 3,1 lần, dấu chấm than ít hơn 2,9 lần, dấu hỏi ít hơn 2,3 lần. Chỉ 3% văn bản Grok có dòng gạch đầu dòng hoặc đánh số, so với 8% của người viết, và độ dài câu đồng đều hơn (hệ số biến thiên 0,37 so với 0,51). So với các dòng AI khác, Grok dùng dấu chấm phẩy ít hơn 3 lần. Xem thêm tại cách nhận biết văn bản do Grok viết của GrokDetect.
DeepSeek: "tổng thể", "chặt chẽ" và lối nhắc đến người đọc
DeepSeek nghiêng về giọng tổng kết, phân tích hệ thống: "minh bạch" (7,5 lần người viết), "phản ánh" (6 lần), "tổng thể" (5,4 lần), "biến động" (5,3 lần), "chặt chẽ" (4,6 lần), "vận hành" (4,1 lần). Cụm tách DeepSeek khỏi các dòng khác lại nói về chính việc viết: "xác minh" (3,6 lần), "ý chính" và "câu chuyện của" (cùng 3,3 lần), "một đoạn" (2,6 lần) và "người đọc" (2,2 lần).
Kiểu "không X mà Y" gấp 8,7 lần người viết (1,2 lần mỗi 1.000 từ so với 0,1), liệt kê ba ý gấp 1,4 lần. Dấu ba chấm ít hơn 4 lần, dấu hỏi và ngoặc đơn cùng ít hơn 2,7 lần, ngoặc kép ít hơn 2,3 lần, dấu chấm phẩy ít hơn 2 lần. Chỉ 5% văn bản có dòng gạch đầu dòng hoặc đánh số, so với 10% của người viết. Xem thêm tại cách nhận biết văn bản DeepSeek viết của DeepSeekDetect.
Qwen (Alibaba): "sâu sắc", "đóng vai" và lập luận nhân quả
Qwen có nhiều cụm gấp từ 7 đến 10 lần người viết: "sâu sắc" và "đóng vai" (cùng 10 lần), "nền tảng" (9,3 lần), "chặt chẽ" (7,5 lần), "quy trình" (5,8 lần), "cấu trúc" (5,7 lần). So với các dòng AI khác, Qwen nổi bật ở "then chốt" (4 lần), "cốt lõi" (3,4 lần), "do đó" (3,1 lần), "đơn thuần" (2,9 lần) và "đóng vai trò" (2,7 lần): lối viết nhấn vào vai trò và nguyên nhân.
Kiểu "không X mà Y" là mạnh nhất trong bảy dòng, gấp 9,4 lần người viết, và liệt kê ba ý gấp 1,3 lần. Dấu ba chấm ít hơn 5,5 lần, dấu chấm than ít hơn 2,6 lần, dấu hỏi ít hơn 2,2 lần; chỉ 4% văn bản có dòng gạch đầu dòng hoặc đánh số, so với 10% của người viết, và độ dài câu đồng đều hơn (0,35 so với 0,53). Qwen và GLM dùng chung trang cách nhận biết văn bản DeepSeek viết của DeepSeekDetect.
GLM (Zhipu): ít dấu hiệu cấu trúc nổi bật, nghiêng về "nền tảng", "cấu trúc", "dù vậy"
GLM có nhiều cụm gấp 4 đến 7 lần người viết: "nền tảng" (7,6 lần), "cấu trúc" (6 lần), "dù vậy" (5,5 lần), "tinh tế" (4,9 lần), "mang lại" (4,4 lần), "đội ngũ" (4,1 lần). So với các dòng AI khác, GLM khác biệt ở "tuyệt đối" (3,3 lần), "cốt lõi" (3,2 lần), "lúc này" và "thiết lập" (cùng 3 lần).
Điểm khác với sáu dòng còn lại là GLM không có dấu hiệu cấu trúc nào "nhiều hơn người viết" đủ ổn định qua các kiểm tra. Cái ổn định là những thứ GLM dùng ít hơn: dấu chấm than ít hơn 4,7 lần, ngoặc kép ít hơn 3,2 lần, dấu ba chấm ít hơn 3,1 lần, ngoặc đơn ít hơn 2 lần; chỉ 3% văn bản có dòng gạch đầu dòng hoặc đánh số, so với 8% của người viết. Vì thế với GLM nên đọc kèm nhiều dấu hiệu khác thay vì dựa vào một cụm. GLM dùng chung trang cách nhận biết văn bản DeepSeek viết của DeepSeekDetect với DeepSeek và Qwen.
Dấu câu và cấu trúc: điều bảy dòng cùng làm
Nhìn riêng dấu câu, bảy dòng giống nhau nhiều hơn khác nhau. Tất cả đều dùng dấu ba chấm ít hơn người viết, từ 3,1 lần (Grok và GLM) đến 8,9 lần (Claude). Sáu dòng trong bảy có kiểu "không X mà Y" nhiều hơn người viết, từ 4 lần ở Claude đến 9,4 lần ở Qwen, và cũng sáu dòng liệt kê ba ý nhiều hơn, dù mức chênh nhỏ hơn.
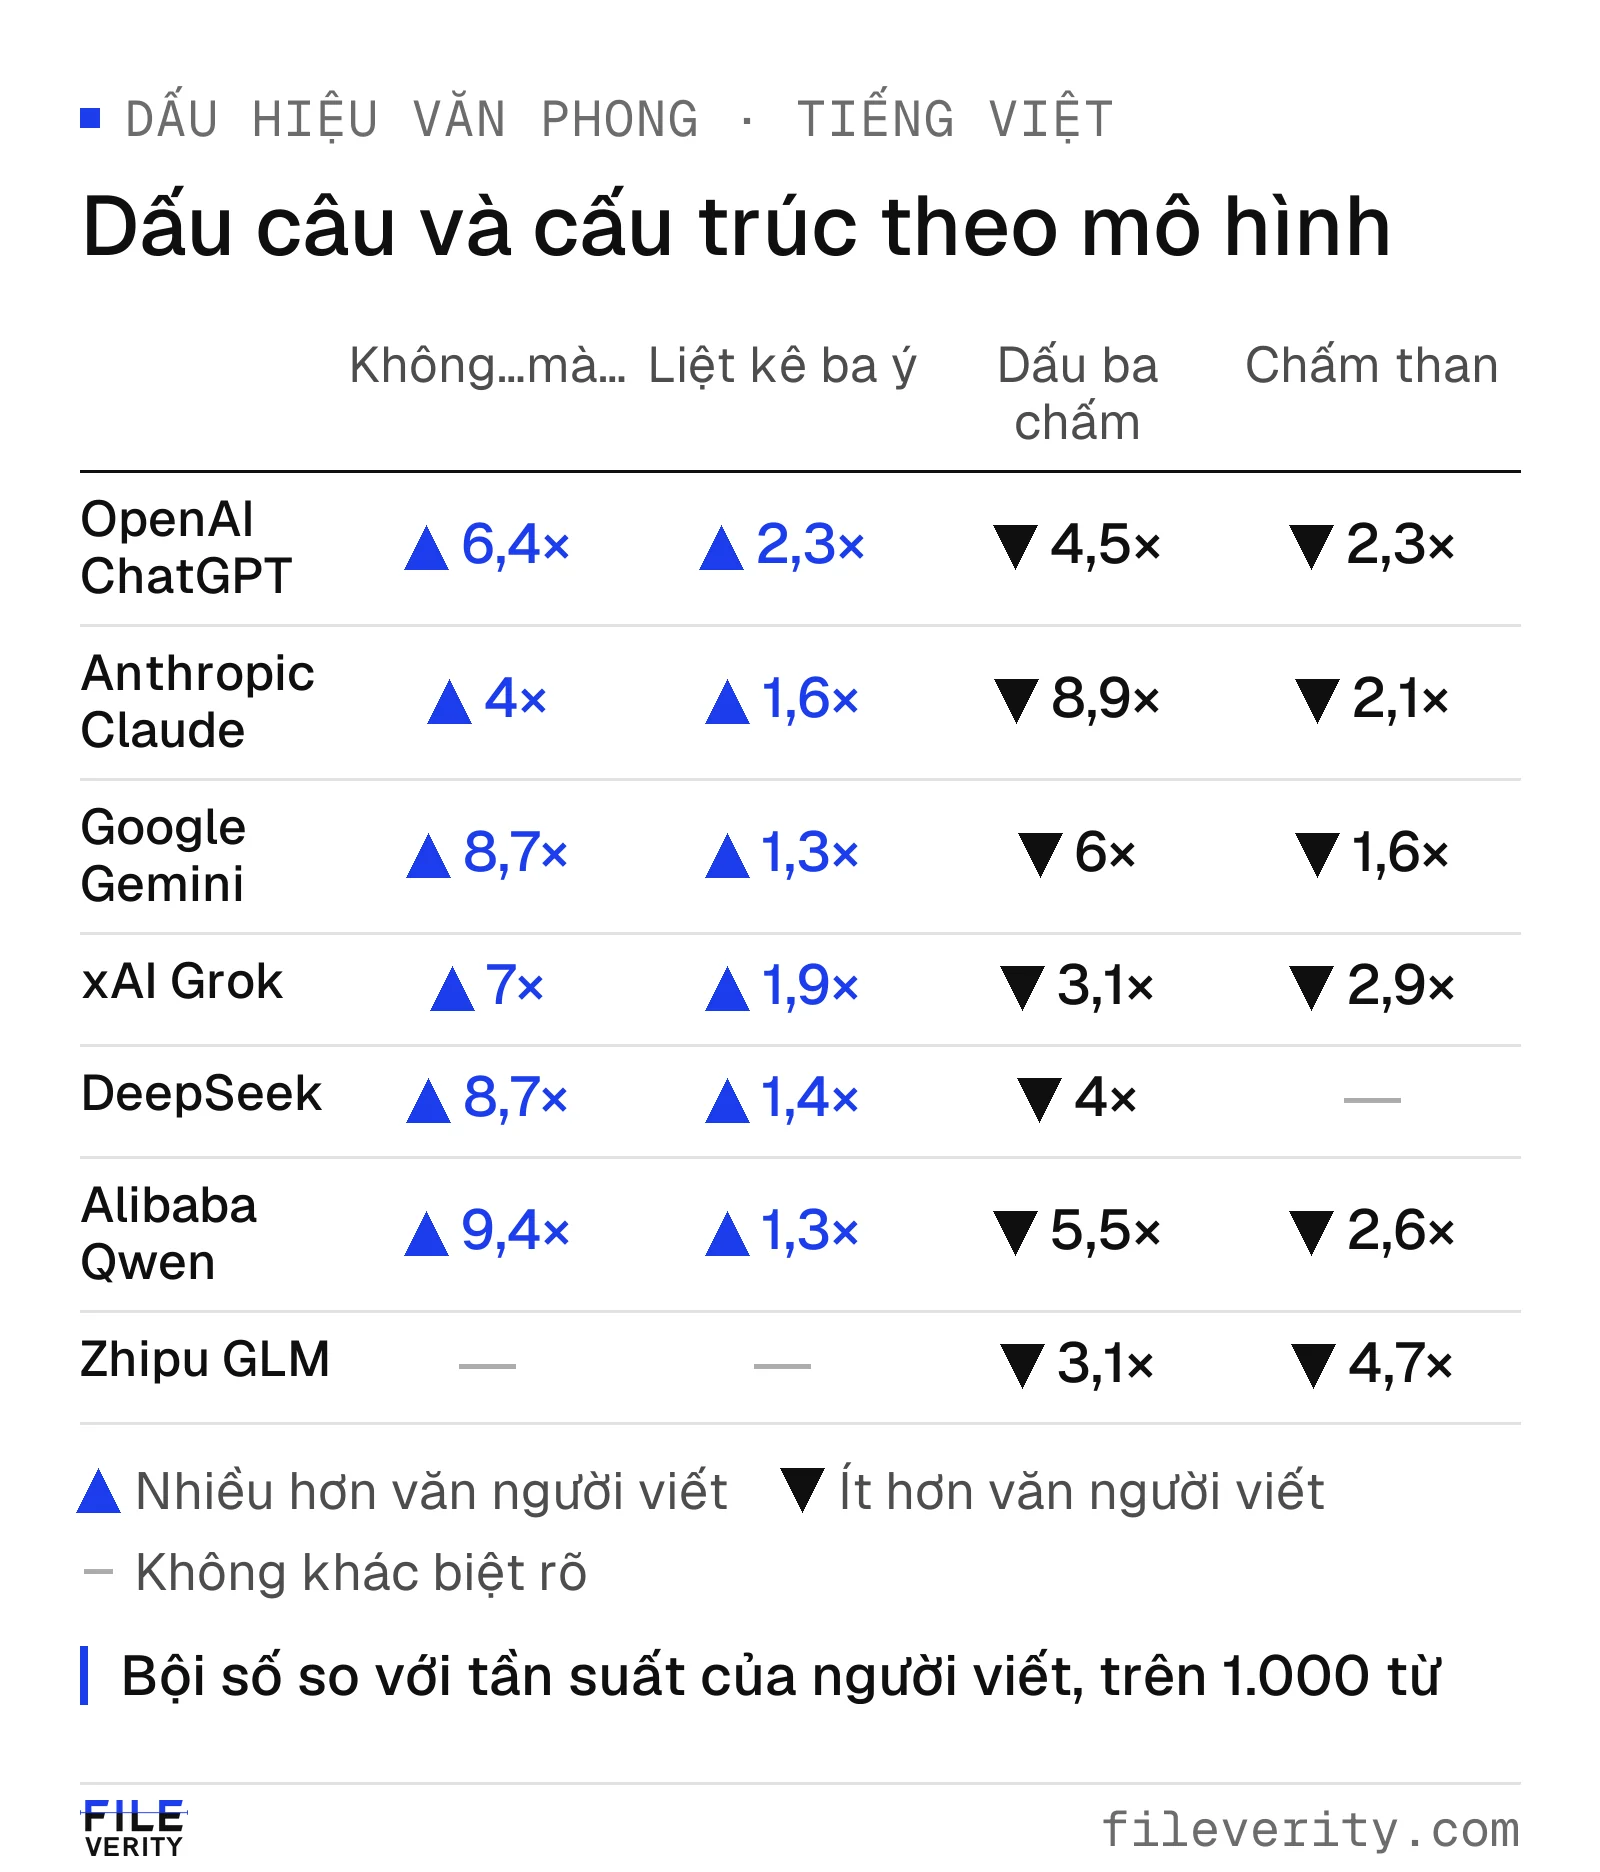
Bội số là so với tần suất của người viết trên 1.000 từ: tam giác xanh là nhiều hơn, tam giác đen là ít hơn, gạch ngang là chưa có chênh lệch rõ.
Đọc ma trận: tam giác xanh nghĩa là dòng mô hình viết nhiều hơn người viết, tam giác đen là ít hơn, và con số là bội số của tần suất trên 1.000 từ. Hai ô gạch ngang của GLM là chỗ không có dấu hiệu cấu trúc nào "nhiều hơn" đủ ổn định, còn ô dấu chấm than của DeepSeek không có chênh lệch đủ rõ. Cột dấu ba chấm cho thấy dấu hiệu chung nhất của văn bản AI tiếng Việt: ít dấu ba chấm hơn người viết, ở cả bảy dòng. Đây là thói quen đã đo được, nhưng vẫn chỉ là một dấu hiệu: nhiều người viết cũng ít dùng dấu ba chấm.
Vì sao danh sách cụm từ chưa đủ, và Veread đọc thêm gì
Danh sách cụm từ dễ hiểu nhưng mỏng. Một người viết trang trọng có thể dùng "minh bạch" và "chặt chẽ" liên tục, còn một mô hình được nhắc "viết tự nhiên" có thể tránh gần hết những cụm này. Cụm từ cũng đổi theo từng phiên bản mô hình, và văn bản ngắn thì chưa đủ chỗ để các dấu hiệu xuất hiện.
Veread không chấm điểm bằng danh sách cụm từ. Đây là mô hình do Fileverity phát triển, đọc cả đoạn văn và đánh giá từng đoạn được đánh dấu có khả năng do AI viết, nhờ khối dữ liệu đồ sộ, độc quyền cho bảy ngôn ngữ. Kết quả theo dòng mô hình là mức giống văn phong, tức một con số cho biết văn bản giống cách viết của dòng nào, không phải xác nhận nguồn gốc. Về độ chính xác, Veread 1.1 phát hiện 98,6% văn bản do AI viết hoàn toàn, 94,9% văn bản từ các mô hình AI chưa từng dùng trong quá trình phát triển và chỉ 0,28% văn bản do người viết bị gắn kết luận AI, trên bảy ngôn ngữ; chi tiết ở bài độ chính xác của Veread.
Khi một đoạn văn bị đánh dấu, hãy xem đó là lý do để hỏi thêm: xin bản nháp, lịch sử sửa, và trao đổi với tác giả. Với một dòng mô hình cụ thể, bạn có thể dùng ChatGPTDetect, ClaudeDetect, GeminiDetect, GrokDetect và DeepSeekDetect, năm công cụ chạy trên cùng nền Veread. Nếu câu hỏi của bạn là hãng nào đánh dấu văn bản của mình và ai kiểm tra được, xem bảng theo dõi thủy vân văn bản AI.
Câu hỏi thường gặp
Có nhận ra văn bản do AI viết bằng mắt thường không?
Đôi khi có, với những văn bản dài và nhiều cụm đặc trưng, nhưng không đáng tin. Người viết trang trọng và người học ngoại ngữ cũng dùng những cụm này, và mô hình có thể được nhắc để viết khác đi. Hãy dùng dấu hiệu để đặt câu hỏi, không để kết luận.
Cụm từ nào chắc chắn cho thấy văn bản do AI viết?
Không có cụm nào chắc chắn. Mọi cụm trong bài này đều chỉ là tần suất cao hơn người viết ở một dòng mô hình, và người viết vẫn dùng chúng.
Văn bản ngắn có phân biệt được dòng mô hình không?
Khó. Dấu hiệu cần đủ độ dài mới xuất hiện đều, và phân biệt dòng này với dòng khác khó hơn nhiều so với phân biệt AI với người viết.
Tác giả Yang Zheng