Đánh giá công cụ phát hiện
ChatGPT có phát hiện được ảnh do AI tạo ra không? Nguyên lý pháp y ảnh số
Vì sao hiểu nội dung một bức ảnh chưa chứng minh được nguồn gốc: lý thuyết thông tin, phát hiện nguồn gốc và đường cong ROC thực nghiệm của FVIMG V2 với AUROC 0,99625.
Đăng ngày · Cập nhật ngày · 6 phút đọc
Trong trang này
ChatGPT có phát hiện được ảnh do AI tạo ra không? ChatGPT có thể chỉ ra một số manh mối hữu ích, nhưng việc hiểu nội dung một bức ảnh vẫn chưa đủ để biết ảnh đó được tạo ra bằng cách nào. Bài toán trung tâm của pháp y ảnh số là giữ lại và kiểm chứng thông tin về nguồn gốc, kể cả những thông tin mà một bản mô tả hoàn toàn chính xác vẫn có thể bỏ sót.
Nếu bạn đang cân nhắc nhờ ChatGPT nhận biết ảnh AI trong công việc xét duyệt, hãy xem câu trả lời của chatbot là gợi ý để kiểm tra tiếp, chưa phải bằng chứng về nguồn gốc ảnh. Quy trình phát hiện của Fileverity không sử dụng LLM (mô hình ngôn ngữ lớn). Chúng tôi dùng học máy chuyên biệt và các bước kiểm tra kỹ thuật để phân tích tệp. Bài viết này giải thích một nguyên lý công khai đứng sau lựa chọn đó: thông tin về nội dung không đồng nghĩa với thông tin về nguồn gốc, mà không mô tả mô hình hay cách triển khai nội bộ của chúng tôi.
ChatGPT có nhận biết được ảnh AI không? Một mô tả đúng vẫn chưa trả lời câu hỏi về nguồn gốc
Hãy hình dung hai bức ảnh cùng thể hiện một chiếc ô tô màu đỏ đỗ cạnh bức tường gạch. Một bức do máy ảnh chụp, bức còn lại do công cụ AI tạo ra. Cả hai đều có thể được mô tả đúng bằng câu “ô tô màu đỏ đỗ cạnh bức tường gạch”. Ánh sáng, phối cảnh và các vật thể trong ảnh cũng có thể được mô tả chính xác ở cả hai trường hợp.
Bản mô tả đã hoàn thành nhiệm vụ của nó. Nhưng câu hỏi “ảnh này do máy ảnh chụp hay do công cụ AI tạo ra?” vẫn còn nguyên. Khi hai ảnh đã được quy về cùng một bản mô tả, mọi quyết định ở bước sau mà chỉ dựa vào bản mô tả đó sẽ không thể phân biệt hai ảnh này. Dù lập luận trên cùng một câu mô tả có công phu đến đâu, những khác biệt đã bị loại bỏ cũng không thể khôi phục.
Vì vậy, một danh sách các điểm bất thường nhìn thấy được chưa đủ làm cơ sở để phát hiện ảnh AI. Bàn tay trông hợp lý về mặt giải phẫu không chứng minh ảnh đến từ máy ảnh. Một vệt phản chiếu lạ không chứng minh ảnh do AI tạo ra. Những quan sát như vậy có thể là manh mối hữu ích, nhưng chúng có giúp phân biệt được nguồn gốc hay không thì phải kiểm chứng, không thể mặc nhiên thừa nhận.
Muốn biết trình tự kiểm tra trong thực tế, hãy xem cách nhận biết ảnh do AI tạo ra. Bài viết này tập trung vào câu hỏi vì sao bài toán phát hiện nguồn gốc đòi hỏi nhiều hơn một lời kể hợp lý về cảnh trong ảnh.
Nút thắt cổ chai thông tin: điều gì đến được bước ra quyết định?
Gọi Y là loại nguồn gốc, X là ảnh đầu vào và T là một biểu diễn rút ra từ ảnh, chẳng hạn bản mô tả. Nếu bước ra quyết định phía sau chỉ nhận T, câu hỏi đặt ra là T còn giữ lại bao nhiêu thông tin về nguồn gốc.
Theo bất đẳng thức xử lý dữ liệu (data-processing inequality) trong bài giảng lý thuyết thông tin của MIT (tài liệu tiếng Anh; Định lý 2.5, chương 2), với chuỗi xử lý này ta có I(Y; T) ≤ I(Y; X): việc biến đổi đầu vào không thể tạo thêm thông tin về nguồn gốc của nó.
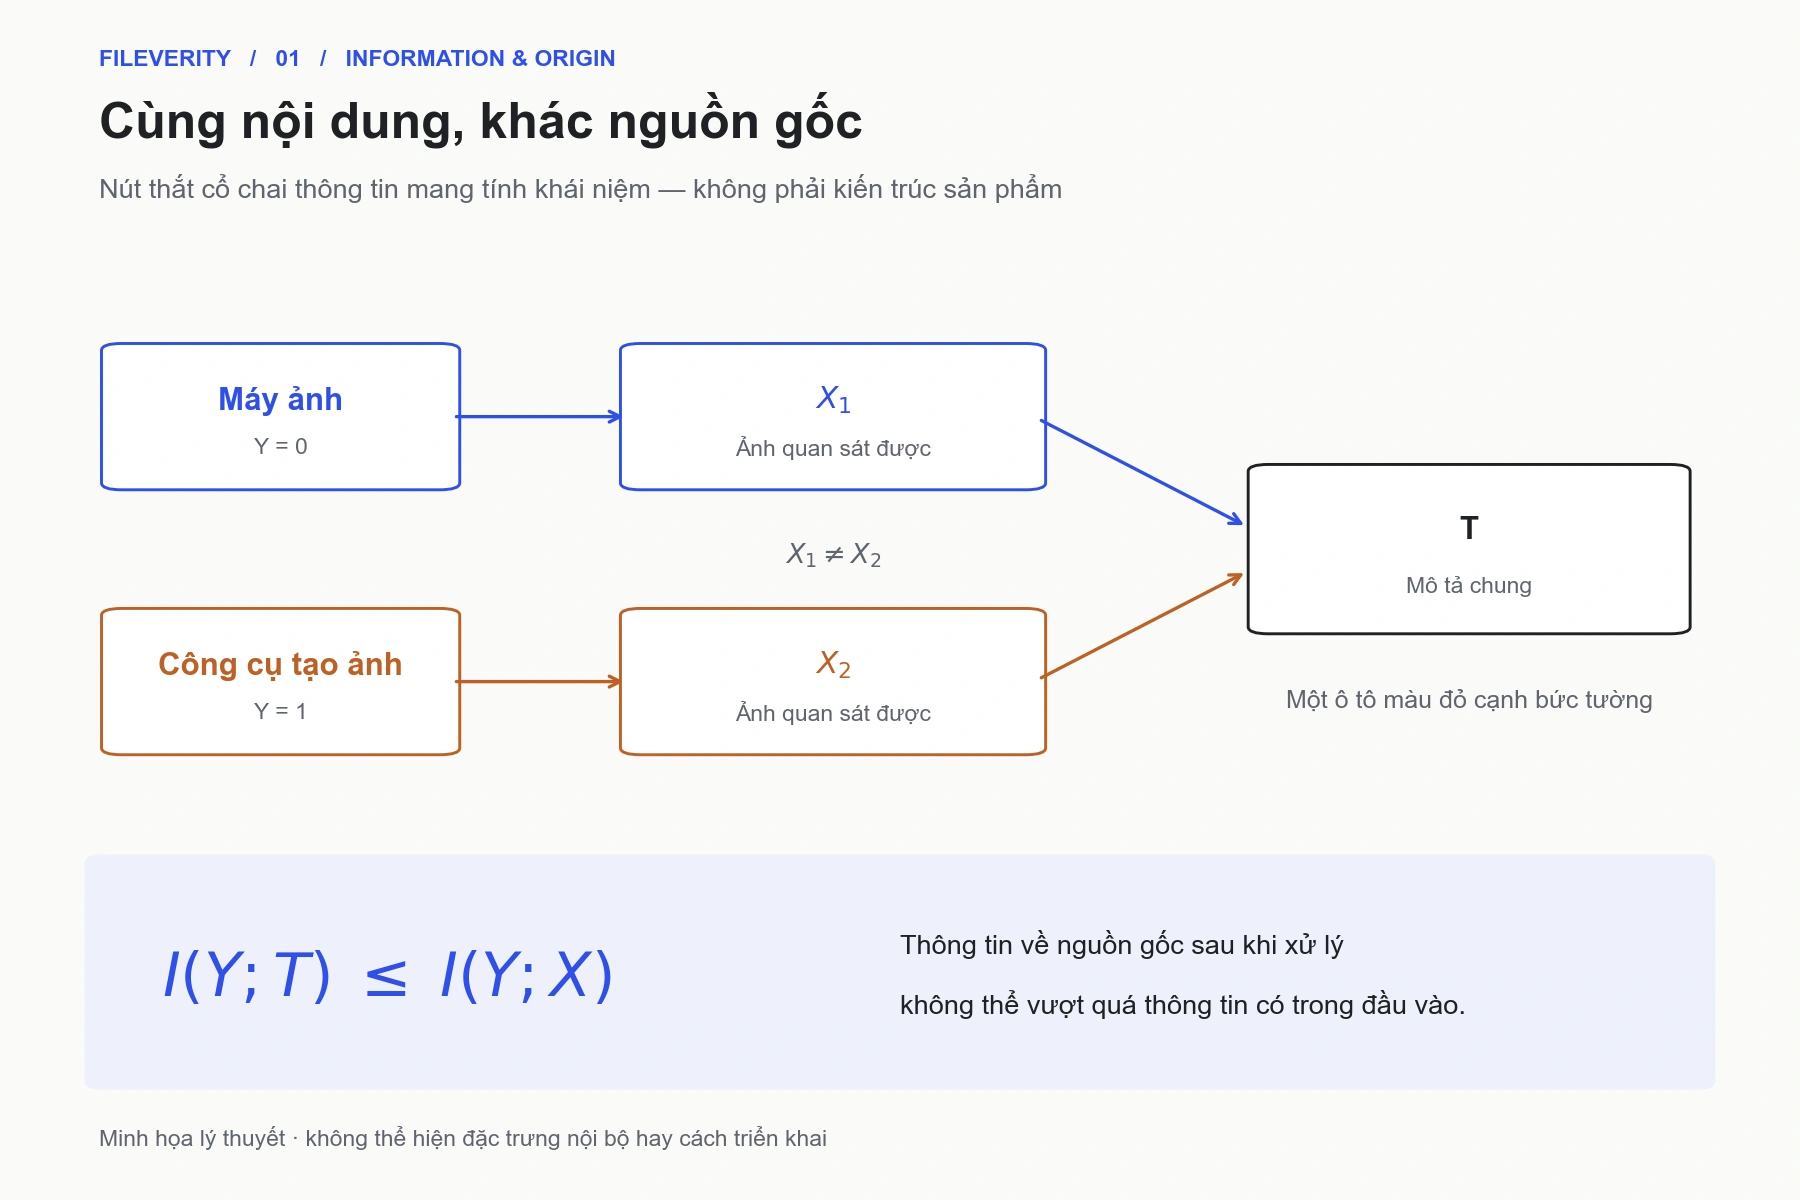
Minh họa khái niệm, không phải sơ đồ kiến trúc của Fileverity. X là ảnh quan sát được, Y là loại nguồn gốc của ảnh và T là biểu diễn rút ra từ ảnh. Hình không thể hiện đặc trưng của bất kỳ mô hình cụ thể nào.
Cần lưu ý rằng biểu diễn không nhất thiết làm mất thông tin về nguồn gốc. Một biểu diễn được chọn phù hợp có thể giữ lại đúng những gì bài toán phát hiện cần. Nhưng một biểu diễn tốt cho việc mô tả cảnh không tự động đủ để phân loại nguồn gốc. Đó là hai mục tiêu tối ưu hóa khác nhau.
Nguyên lý này không chứng minh rằng mọi LLM đa phương thức đều không thể phát hiện ảnh AI. Một mô hình như vậy có thể nhận thông tin ảnh trực tiếp, và quy trình huấn luyện chuyên biệt có thể thay đổi năng lực của nó. Nguyên lý này chỉ khẳng định một điều hẹp hơn nhưng chắc chắn hơn: bản thân năng lực hiểu ngữ nghĩa chưa phải là bằng chứng về hiệu năng phát hiện nguồn gốc đã được kiểm chứng.
Thực tế cũng cho thấy câu trả lời của chatbot về ảnh AI cần được kiểm chứng. Trong phân tích của Full Fact (tiếng Anh) công bố ngày 28 tháng 8 năm 2026, tổ chức kiểm chứng thông tin của Vương quốc Anh này ghi nhận rằng khi được hỏi về các tuyên bố liên quan đến ảnh giả, nhiều chatbot AI đã nhận định nhầm một số ảnh do AI tạo ra là ảnh thật. Full Fact kết luận rằng không thể coi các mô hình này là cách kiểm chứng bảo đảm không sai sót. Đây là quan sát trên một số trường hợp cụ thể, không phải phép đo hiệu năng phát hiện nguồn gốc.
Công cụ phát hiện biến bằng chứng thành quyết định có thể kiểm chứng như thế nào
Xét một phép đo tổng quát E. Công cụ phát hiện nguồn gốc đặt câu hỏi: giá trị E quan sát được thường gặp hơn ở ảnh do AI tạo ra hay ở ảnh chụp bằng máy ảnh? Về mặt khái niệm, phép so sánh này có thể viết là:
L(E) = p(E | do AI tạo ra) / p(E | máy ảnh)
Đây là tỷ số hợp lý (likelihood ratio), không phải khẳng định rằng Fileverity triển khai trực tiếp công thức này. Nó giải thích mục tiêu: phân biệt các đặc điểm phụ thuộc vào nguồn gốc, thay vì đánh giá xem cảnh trong ảnh có hợp lý hay không. Tỷ số cao ủng hộ một cách giải thích hơn cách giải thích còn lại, theo các phân phối được giả định; nó không tự động là xác suất để một tệp cụ thể là ảnh giả.
Điểm số của một bộ phát hiện dựa trên học máy có thể được đánh giá bằng thực nghiệm mà không cần biết phân phối thật. Chỉ cần đặt một ngưỡng, áp dụng ngưỡng đó cho các ví dụ đã gán nhãn rồi đếm kết quả. Nâng hay hạ ngưỡng sẽ thay đổi sự đánh đổi giữa việc tìm ra nhiều ảnh do AI tạo ra hơn và việc gắn cờ nhầm nhiều ảnh chụp thật hơn. Đường cong ROC cho phép quan sát trực tiếp sự đánh đổi này.
Một số nghiên cứu đã công bố minh họa cho sự phân biệt này. Zero-Shot Detection of AI-Generated Images (bài báo tiếng Anh) xem xét mức độ một ảnh có thể được dự đoán về mặt thống kê dựa trên mô hình của ảnh thật. Chúng tôi dẫn bài báo này làm ví dụ về một câu hỏi nghiên cứu xoay quanh tín hiệu nguồn gốc, không phải để tiết lộ phương pháp của Fileverity.
Từ lý thuyết đến quan sát: một lần đánh giá với cấu hình cố định
Hình dưới đây được tính từ kết quả dự đoán đã lưu cho từng ảnh trong lần đánh giá FVIMG V2 ngày 1 tháng 11 năm 2026. Khác với sơ đồ khái niệm ở trên, đây là kết quả đo trên ảnh do AI tạo ra từ Synthbuster và ảnh chụp bằng máy ảnh từ RAISE-1k, hai bộ dữ liệu công khai mà bất kỳ ai cũng có thể đối chiếu.
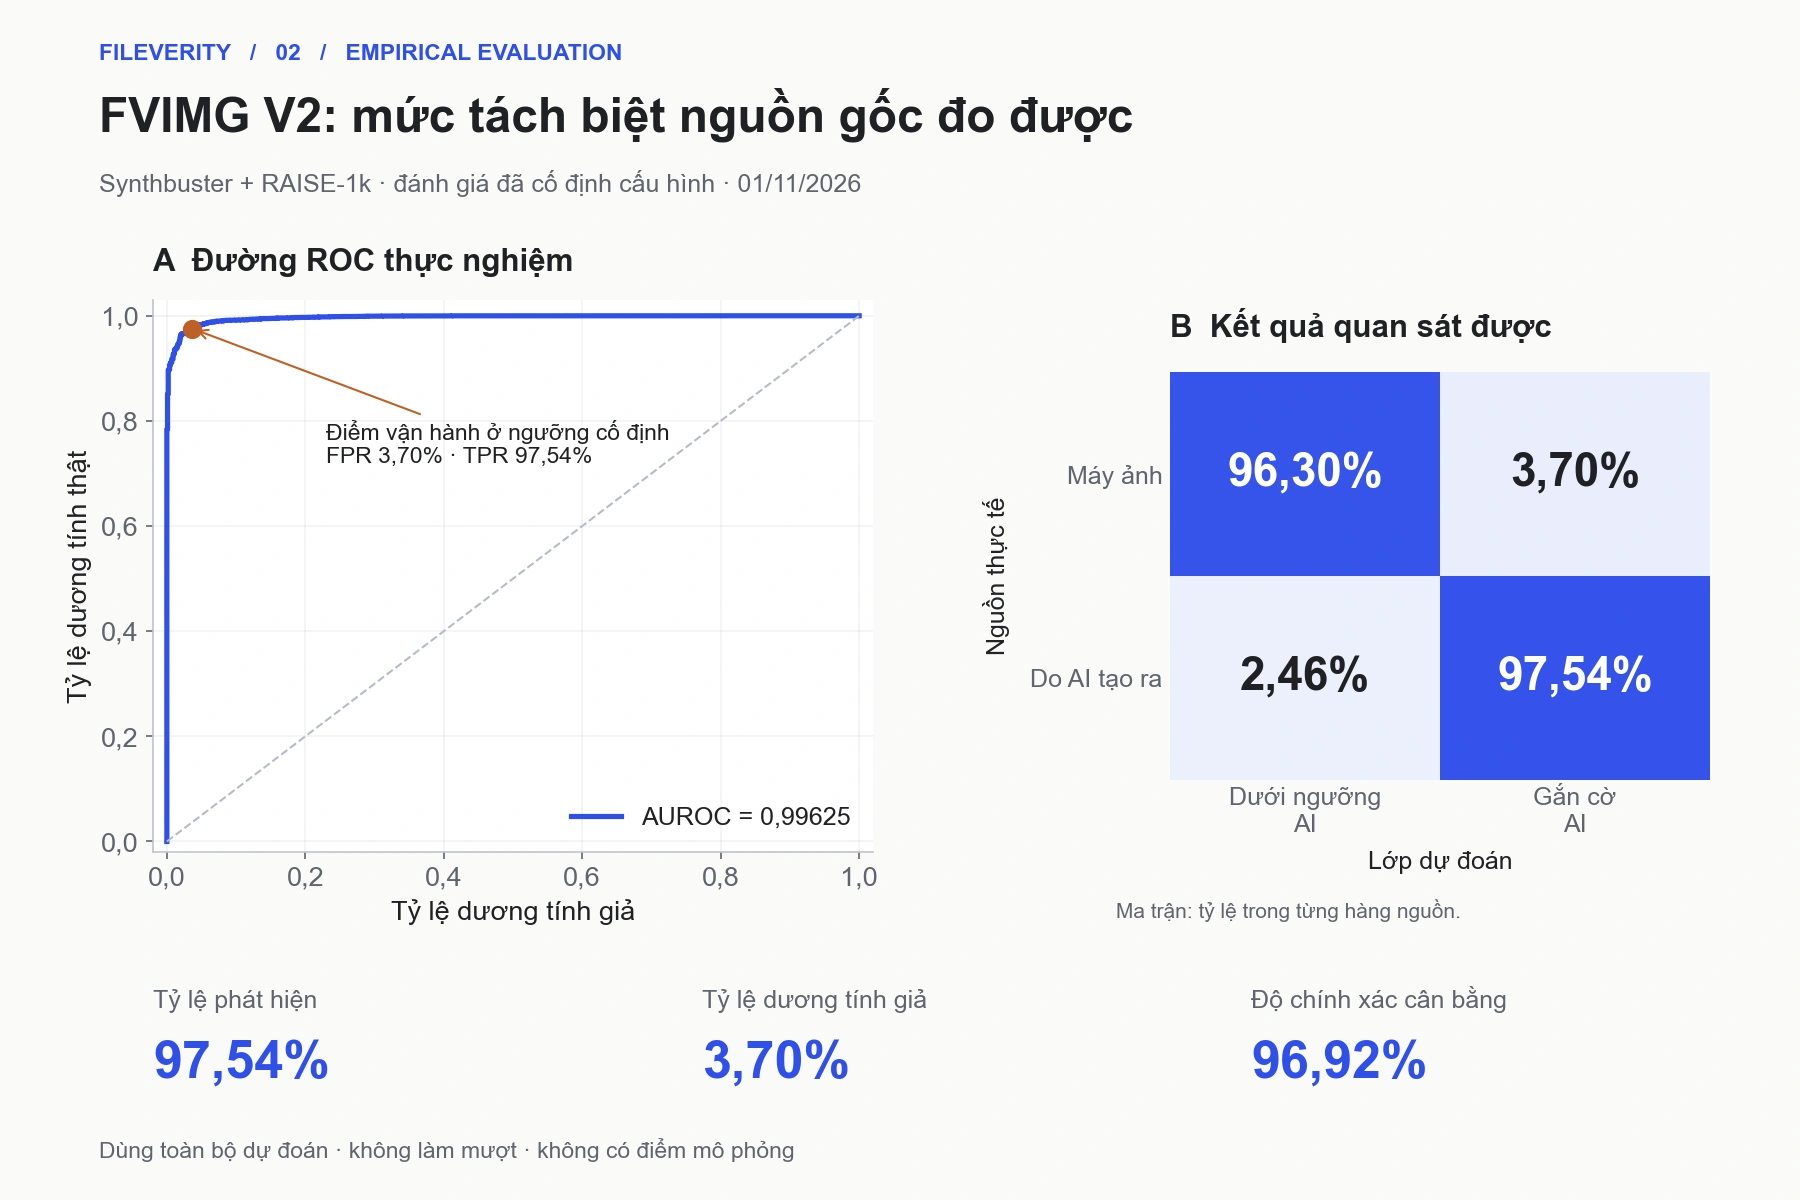
Phần A là đường ROC thực nghiệm; các điểm số trùng nhau được gộp lại trước khi lấy tích phân. Điểm được đánh dấu ứng với ngưỡng cố định của lần đánh giá. Phần B là ma trận kết quả quan sát được: mỗi ô là tỷ lệ phần trăm trong tổng của hàng nguồn tương ứng. Đường cong không được làm mượt và không dùng dữ liệu mô phỏng.
| Điều được đo | Kết quả của FVIMG V2 |
|---|---|
| Ảnh do AI tạo ra được phát hiện | 97,54% |
| Ảnh chụp thật được xếp đúng dưới ngưỡng AI | 96,30% |
| Độ chính xác cân bằng | 96,92% |
| AUROC | 0,99625 |
Tỷ lệ dương tính giả trên ảnh chụp thật là 3,70%, tức là tỷ lệ ảnh chụp thật bị gắn cờ ở ngưỡng cố định. Mức tách biệt giữa các điểm số đủ để làm cơ sở cho một nhận định cụ thể về khả năng phát hiện trong lần đánh giá này, nhưng không biến điểm số của mô hình thành xác suất tổng quát để một ảnh là ảnh thật. Báo cáo benchmark đầy đủ ghi lại cách xử lý đầu vào và phạm vi: lõi phát hiện dựa trên điểm ảnh, không đưa metadata hay thông tin nguồn gốc vào kết quả chính. Lần đánh giá này không đưa LLM vào làm mô hình so sánh.
Vì sao các bằng chứng bổ trợ lẫn nhau lại hữu ích
Chính nguyên lý thông tin này giải thích giá trị của việc dùng nhiều phép kiểm tra. Sau khi quan sát E1, một phép đo E2 hữu ích nếu nó cho biết thêm điều gì đó về nguồn gốc. Diễn đạt lại E1 bằng lời khác không tạo thêm phép đo nào; một quan sát thực sự bổ trợ thì có thể.
Đó là điểm khác biệt giữa việc thu thập thêm ý kiến và việc xem xét thêm bằng chứng. Các phép kiểm tra có tương quan với nhau có thể lặp lại cùng một sai sót; việc có nhiều thành phần hơn không phải là một bảo đảm về mặt toán học. Phép thử thực tế là liệu sự kết hợp đó có cải thiện chất lượng các quyết định, được đo trên những tệp đại diện, hay không.
Một nguồn bằng chứng bổ trợ nữa có thể nằm ngay trong tệp. Tại Việt Nam, Luật Trí tuệ nhân tạo số 134/2025/QH15, có hiệu lực từ ngày 1 tháng 3 năm 2026, yêu cầu nhà cung cấp bảo đảm âm thanh, hình ảnh, video do hệ thống AI tạo ra được đánh dấu theo định dạng máy đọc được (khoản 2 Điều 11), và yêu cầu bên triển khai gắn nhãn dễ nhận biết cho nội dung mô phỏng người thật hoặc tái hiện sự kiện thực tế (khoản 4 Điều 11). Nghị định 142/2026/NĐ-CP, có hiệu lực từ ngày 1 tháng 5 năm 2026, hướng dẫn việc đánh dấu kỹ thuật trong cấu trúc tệp, metadata hoặc chữ ký số (Điều 17) và việc gắn nhãn hiển thị (Điều 18). Với người xét duyệt, dấu và nhãn như vậy là một tín hiệu đáng kiểm tra, nhưng cần hiểu đúng giới hạn của chúng. Chúng chỉ xuất hiện khi nhà cung cấp hoặc bên triển khai đã thực hiện nghĩa vụ này (hệ thống đã vận hành trước ngày 1 tháng 3 năm 2026 còn thời gian chuyển tiếp theo Điều 35 của Luật), và có thể không còn khi ảnh bị chụp màn hình, nén lại hoặc chia sẻ qua nền tảng xóa metadata. Không có dấu hay nhãn cũng không chứng minh được ảnh do máy ảnh chụp. Phần giới hạn này được phân tích kỹ hơn trong C2PA, watermark AI và công cụ phát hiện ảnh.
Fileverity áp dụng cách tiếp cận dựa trên bằng chứng này vào xác minh hình ảnh. FVIMG V2 và mô hình phát hiện tài liệu FVDOC V3 của chúng tôi có phiên bản và phạm vi đánh giá riêng, và đều dựa trên kho dữ liệu độc quyền quy mô rất lớn do đội ngũ chuyên gia tuyển chọn. Chúng tôi không công bố ở đây việc lựa chọn đặc trưng nội bộ hay cách kết hợp chúng; điều được công bố là một báo cáo có thể kiểm chứng và hồ sơ hiệu năng gắn với một nhiệm vụ được xác định rõ.
Dùng ChatGPT hay công cụ chuyên dụng để phát hiện ảnh AI: nên hỏi gì?
Câu hỏi hữu ích không phải là “Hệ thống có giải thích được bức ảnh này không?” mà là “Bằng chứng nào làm cơ sở cho phân loại nguồn gốc của nó, và phân loại đó được đánh giá ra sao?”. Hãy yêu cầu nhà cung cấp cho biết tên phiên bản, tập kiểm thử được xác định rõ và tỷ lệ dương tính giả bên cạnh tỷ lệ phát hiện. Hướng dẫn về độ chính xác giải thích cách đọc các chỉ số này.
Hiểu được nội dung của một bức ảnh là điều có giá trị. Phát hiện nguồn gốc ở mức chuyên nghiệp còn đòi hỏi một yêu cầu khác: giữ lại bằng chứng liên quan, biến nó thành một quyết định được xác định rõ và chứng minh quyết định đó hoạt động ra sao. Đó là nền tảng của quy trình xác minh chuyên biệt của Fileverity. Nếu bạn dự định kết nối công cụ phát hiện với hệ thống của mình, Cách chọn API phát hiện AI nêu mười điểm cần kiểm tra khi tích hợp.
Tác giả Yang Zheng