Phát hành mô hình
Veread 1.1: ít dương tính giả, đánh dấu đoạn AI chính xác hơn
Veread 1.1 phát hiện 98,6% văn bản do AI viết hoàn toàn, dương tính giả 0,28%, và nhận ra 92,2% tài liệu có cả phần người viết lẫn AI. Từ 18/11/2026.
Đăng ngày · 6 phút đọc
Thông tin chính
- Phiên bản
- Veread 1.1
- Ngày phát hành
- 18 tháng 11 năm 2026
- Dương tính giả trên văn bản do người viết
- 0,28% (từ 0,45%)
- Văn bản do AI viết hoàn toàn được phát hiện
- 98,6%
- Tài liệu có cả người viết lẫn AI được phát hiện
- 92,2% (từ 87,3%)
- Văn bản từ mô hình AI chưa từng thấy được phát hiện
- 94,9%
Veread 1.1, phát hành ngày 18 tháng 11 năm 2026, phát hiện 98,6% văn bản do AI viết hoàn toàn, và chỉ gắn nhầm kết luận AI cho 0,28% văn bản do người viết, giảm từ 0,45% ở Veread 1.0. Các số liệu được đo trên dữ liệu kiểm tra giữ riêng, chưa từng dùng để huấn luyện, trong bảy ngôn ngữ. Với tài liệu có cả phần người viết lẫn phần AI viết, Veread 1.1 phát hiện 92,2% (từ 87,3%) và đánh dấu các đoạn do AI viết với độ chính xác 97,2%.
Veread là mô hình phát hiện văn bản AI do chính Fileverity phát triển. Từ hôm nay, mọi lượt kiểm tra văn bản và tài liệu trên Fileverity đều chạy trên phiên bản 1.1.
Veread 1.1 có gì mới
- Huấn luyện tập trung vào tiếng Anh, tiếng Tây Ban Nha và tiếng Pháp. Cả bảy ngôn ngữ vẫn nằm trong một mô hình duy nhất: tiếng Anh, Pháp, Đức, Tây Ban Nha, Trung, Việt và Ả Rập.
- Nguồn văn bản do người viết rộng hơn nhiều. Bài luận và bài tập của học sinh, sinh viên, bài báo khoa học hoàn chỉnh (từ phần mở đầu, nội dung chính đến kết luận, không chỉ phần tóm tắt), thư và đơn khiếu nại, bài đánh giá phim và sản phẩm, thảo luận trên diễn đàn, truyện và văn xuôi văn học, văn bản pháp lý và hành chính, tin tức và bài viết bách khoa.
- Có chủ đích đưa vào những văn bản khó của người viết. Văn phong trang trọng, rập khuôn hoặc được trau chuốt kỹ, đúng loại mà công cụ phát hiện hay nhầm là AI, nay là một phần cốt lõi của quá trình huấn luyện.
- Văn bản AI thế hệ mới nhất từ chín dòng mô hình: OpenAI, Anthropic, Google, DeepSeek, Alibaba, Meta, Mistral, xAI và Zhipu, kể cả văn bản AI bị diễn đạt lại hoặc “làm cho giống người viết” để né công cụ phát hiện, và văn bản do AI viết lại từ bài của người viết.
- Nhãn đến từng câu. Mỗi câu do AI viết trong một tài liệu hỗn hợp đều được gắn nhãn, nên mô hình học được chính xác chỗ nào người viết dừng và AI bắt đầu.
- Văn bản huấn luyện sạch hơn. Dòng tác giả, ghi nguồn, thông báo cookie và đăng ký, mã đánh dấu, ký hiệu chú thích và số đếm từ đã được loại bỏ, chỉ bằng cách xóa. Nội dung câu chữ không bị chỉnh sửa, nên Veread đánh giá chính văn phong chứ không phải hình thức trình bày.
- Loại bỏ văn bản trùng lặp hoàn toàn và gần trùng lặp giữa dữ liệu huấn luyện và dữ liệu đánh giá, nên mô hình không bị kiểm tra trên những văn bản mà thực chất nó đã từng thấy.
- Ngưỡng quyết định mới, được hiệu chỉnh trên văn bản của người viết giữ riêng. Tính năng đánh dấu đoạn văn và tính năng cho biết văn phong gần nhất với dòng mô hình nào cũng được hiệu chỉnh lại cho mô hình mới. Phần văn phong nay xuất hiện thường xuyên hơn và đúng hơn so với 1.0.
Kết quả: Veread 1.1 so với Veread 1.0
Cả hai phiên bản chạy qua cùng một bài đánh giá: các văn bản giữ riêng từ khoảng 100 từ trở lên, trong bảy ngôn ngữ.
| Chỉ số | Veread 1.0 | Veread 1.1 |
|---|---|---|
| Văn bản do người viết bị gắn nhầm kết luận AI | 0,45% | 0,28% |
| Văn bản do AI viết hoàn toàn được phát hiện | 98,3% | 98,6% |
| Mọi văn bản do AI viết và có AI hỗ trợ được phát hiện | 95,4% | 95,9% |
| Văn bản do người viết mở đầu rồi AI viết tiếp được phát hiện | 91,7% | 94,3% |
| Tài liệu có cả phần người viết lẫn phần AI viết được phát hiện | 87,3% | 92,2% |
| Đoạn trích ngắn khoảng 100 từ được phát hiện | 92,9% | 94,1% |
| Tài liệu đầy đủ được phát hiện | 96,6% | 96,8% |
| Văn bản do AI viết lại được phát hiện | 92,5% | 92,8% |
| F1 đánh dấu đoạn văn | 90,3 | 92,9 |
| AUROC, đoạn trích ngắn | 0,995 | 0,996 |
Veread 1.1 còn phát hiện 100% đoạn do AI chèn vào văn bản của người viết, 97,6% văn bản được AI trau chuốt và 94,9% văn bản từ các mô hình AI chưa từng dùng trong quá trình phát triển. AUROC trên tài liệu đầy đủ đạt 0,999.
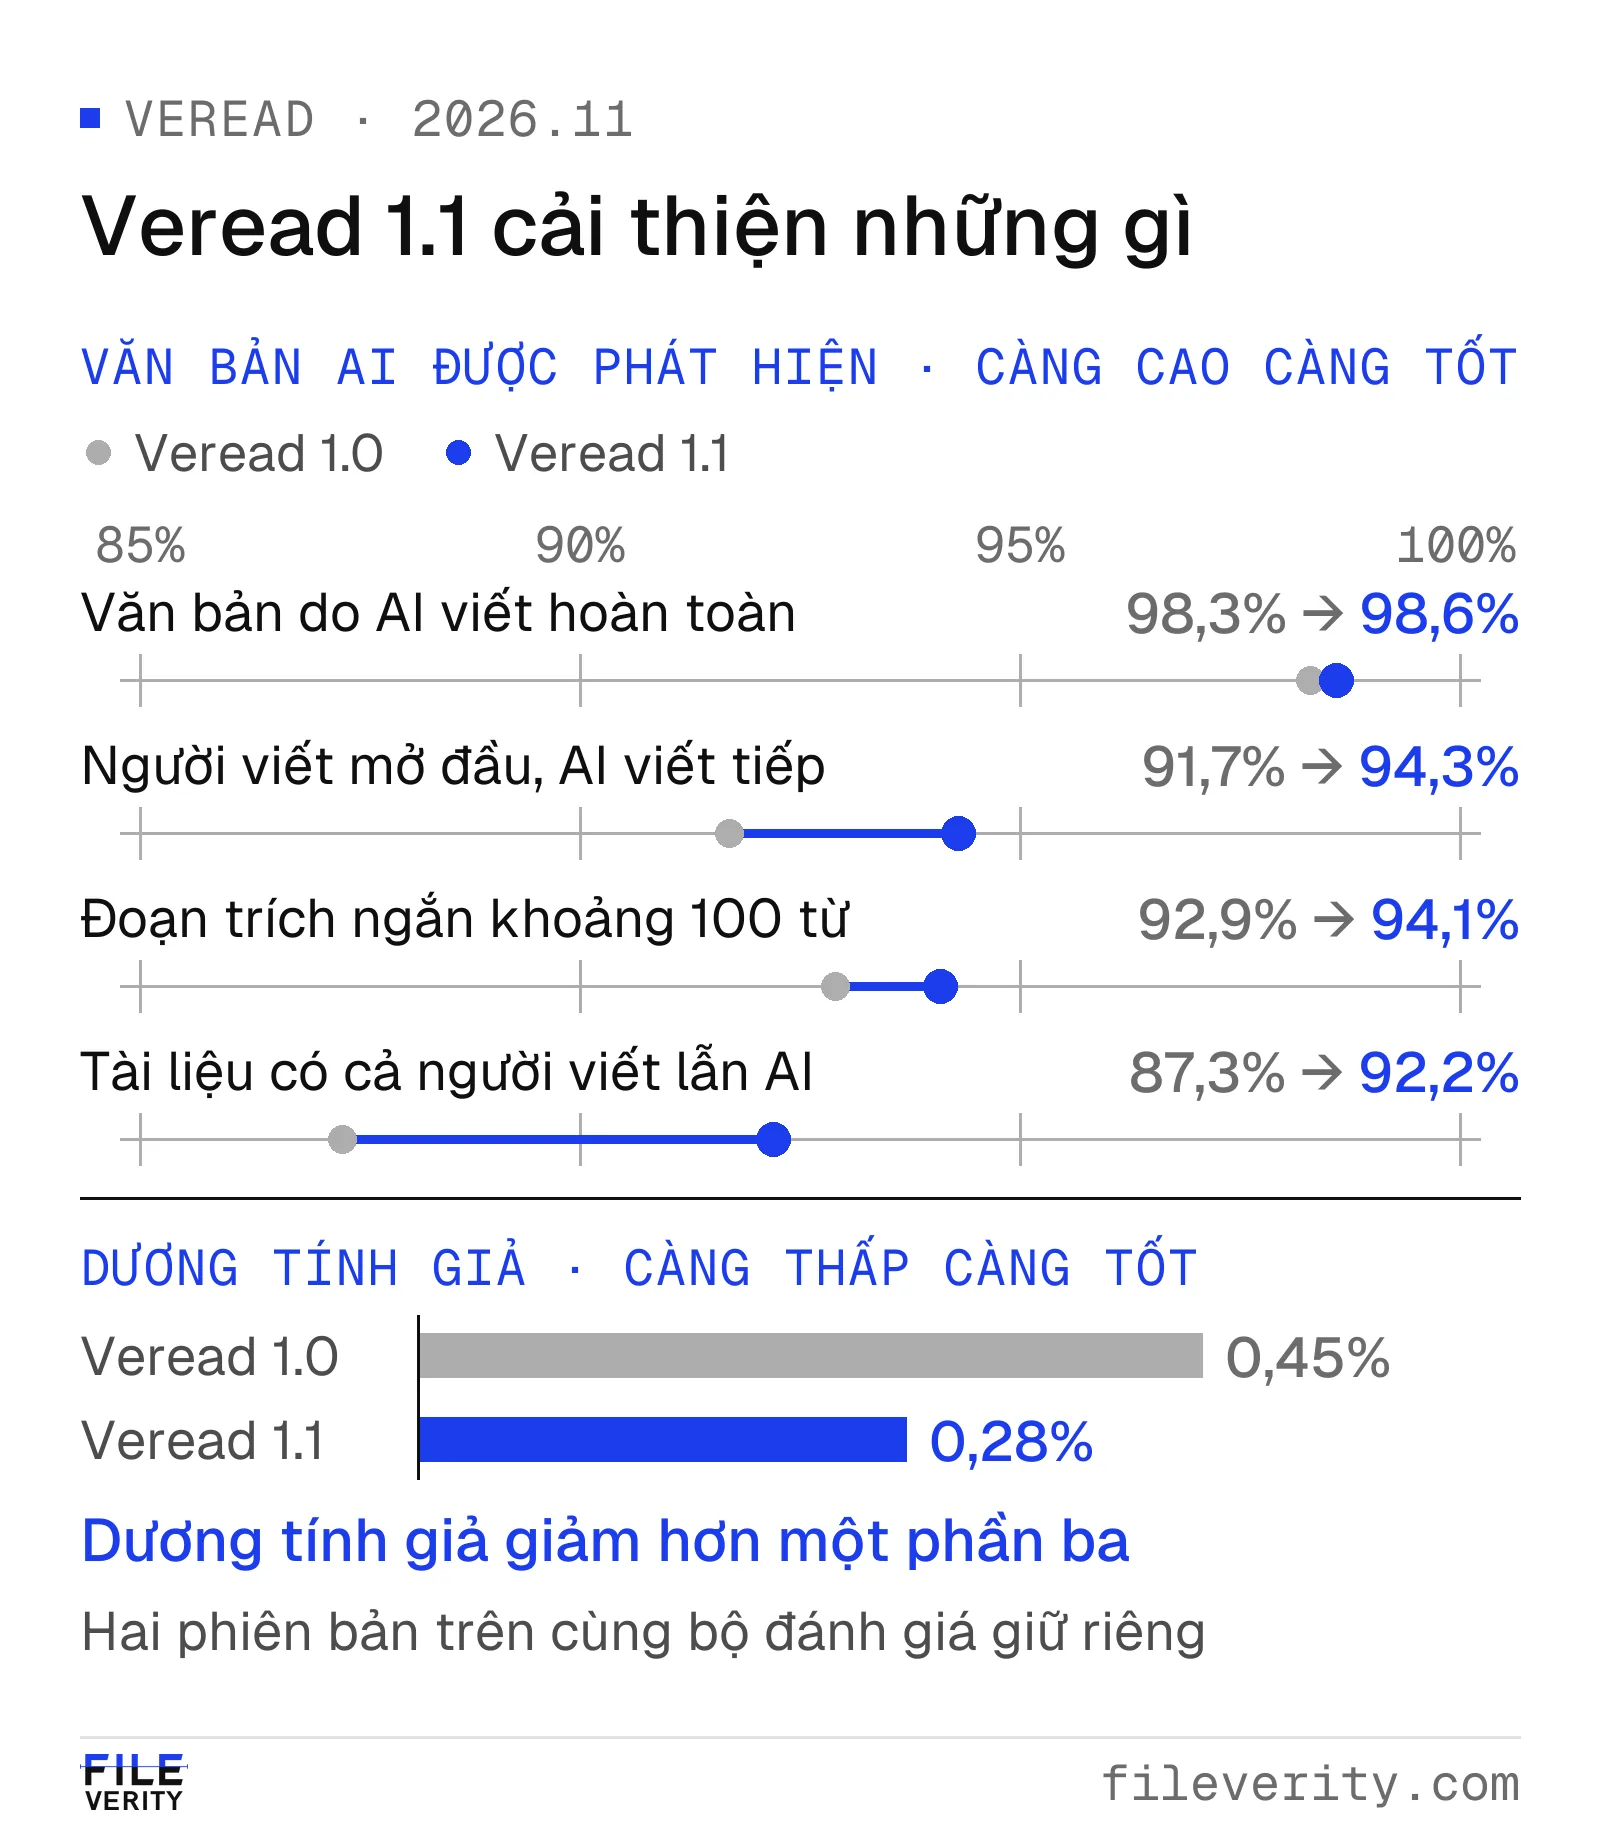
Dương tính giả giảm hơn một phần ba, trong khi tỷ lệ phát hiện tăng ở mọi chỉ số chính.
Các chỉ số, giải thích ngắn gọn
- Tỷ lệ dương tính giả: tỷ lệ văn bản do người viết bị gắn kết luận AI. Càng thấp càng tốt.
- Tỷ lệ phát hiện: tỷ lệ văn bản do AI viết hoặc có AI hỗ trợ mà Veread nhận ra. Càng cao càng tốt.
- Có AI hỗ trợ: một văn bản chỉ được tính khi AI thực sự thay đổi câu chữ, dù là viết tiếp, viết lại, trau chuốt hay chèn vào văn bản của người viết.
- AUROC: mức độ điểm số của Veread tách bạch văn bản do người viết và do AI viết, dù chọn mức quyết định nào. Điểm 1 là tách bạch hoàn toàn.
- F1 đánh dấu đoạn văn: một điểm số gộp hai điều: Veread tìm được bao nhiêu đoạn do AI viết, và trong số đoạn được đánh dấu có bao nhiêu thật sự do AI viết.
- Độ chính xác của đoạn được đánh dấu: tỷ lệ phần văn bản được đánh dấu thật sự do AI viết.
Ít dương tính giả hơn với văn bản do người viết
Dương tính giả là bài do chính một người viết nhưng bị gắn kết luận là máy viết. Với giáo viên, phòng tuyển sinh hay biên tập viên, đây là con số quyết định công cụ phát hiện có đủ tin cậy để dùng với bài viết của người thật hay không.
Veread 1.1 gắn nhầm 0,28% văn bản do người viết, giảm hơn một phần ba so với Veread 1.0. Con số này tính trên toàn bộ văn bản của người viết giữ riêng, gồm cả các nhóm văn bản độc lập từ những nguồn chưa từng dùng để huấn luyện. Với tài liệu đầy đủ, tỷ lệ là 0,23%.
Mọi ngôn ngữ đều dưới 0,5%. Tiếng Anh giảm từ 0,43% xuống 0,18%, tiếng Tây Ban Nha từ 0,77% xuống 0,41% và tiếng Pháp từ 0,76% xuống 0,45%; danh sách đầy đủ nằm trong bảng ngôn ngữ bên dưới. Mọi loại văn bản đều dưới 1%. Văn học và sáng tác giảm từ 0,62% xuống 0,08%, đánh giá và diễn đàn từ 0,84% xuống 0,38%, bài viết của học sinh, sinh viên và người học từ 0,51% xuống 0,30%, văn bản học thuật và khoa học từ 1,08% xuống 0,77%.
Đánh dấu đoạn văn chính xác hơn trong tài liệu hỗn hợp
Bài nộp thực tế hiếm khi hoàn toàn do máy viết. Veread 1.1 học từ nhãn đến từng câu, nên phát hiện 92,2% tài liệu có cả phần người viết lẫn phần AI viết (từ 87,3%), đánh dấu đoạn văn với độ chính xác 97,2%, và đạt F1 đánh dấu đoạn văn 92,9 (từ 90,3). Các kết quả này được đo từ đầu đến cuối qua chính hệ thống đang phục vụ khách hàng.
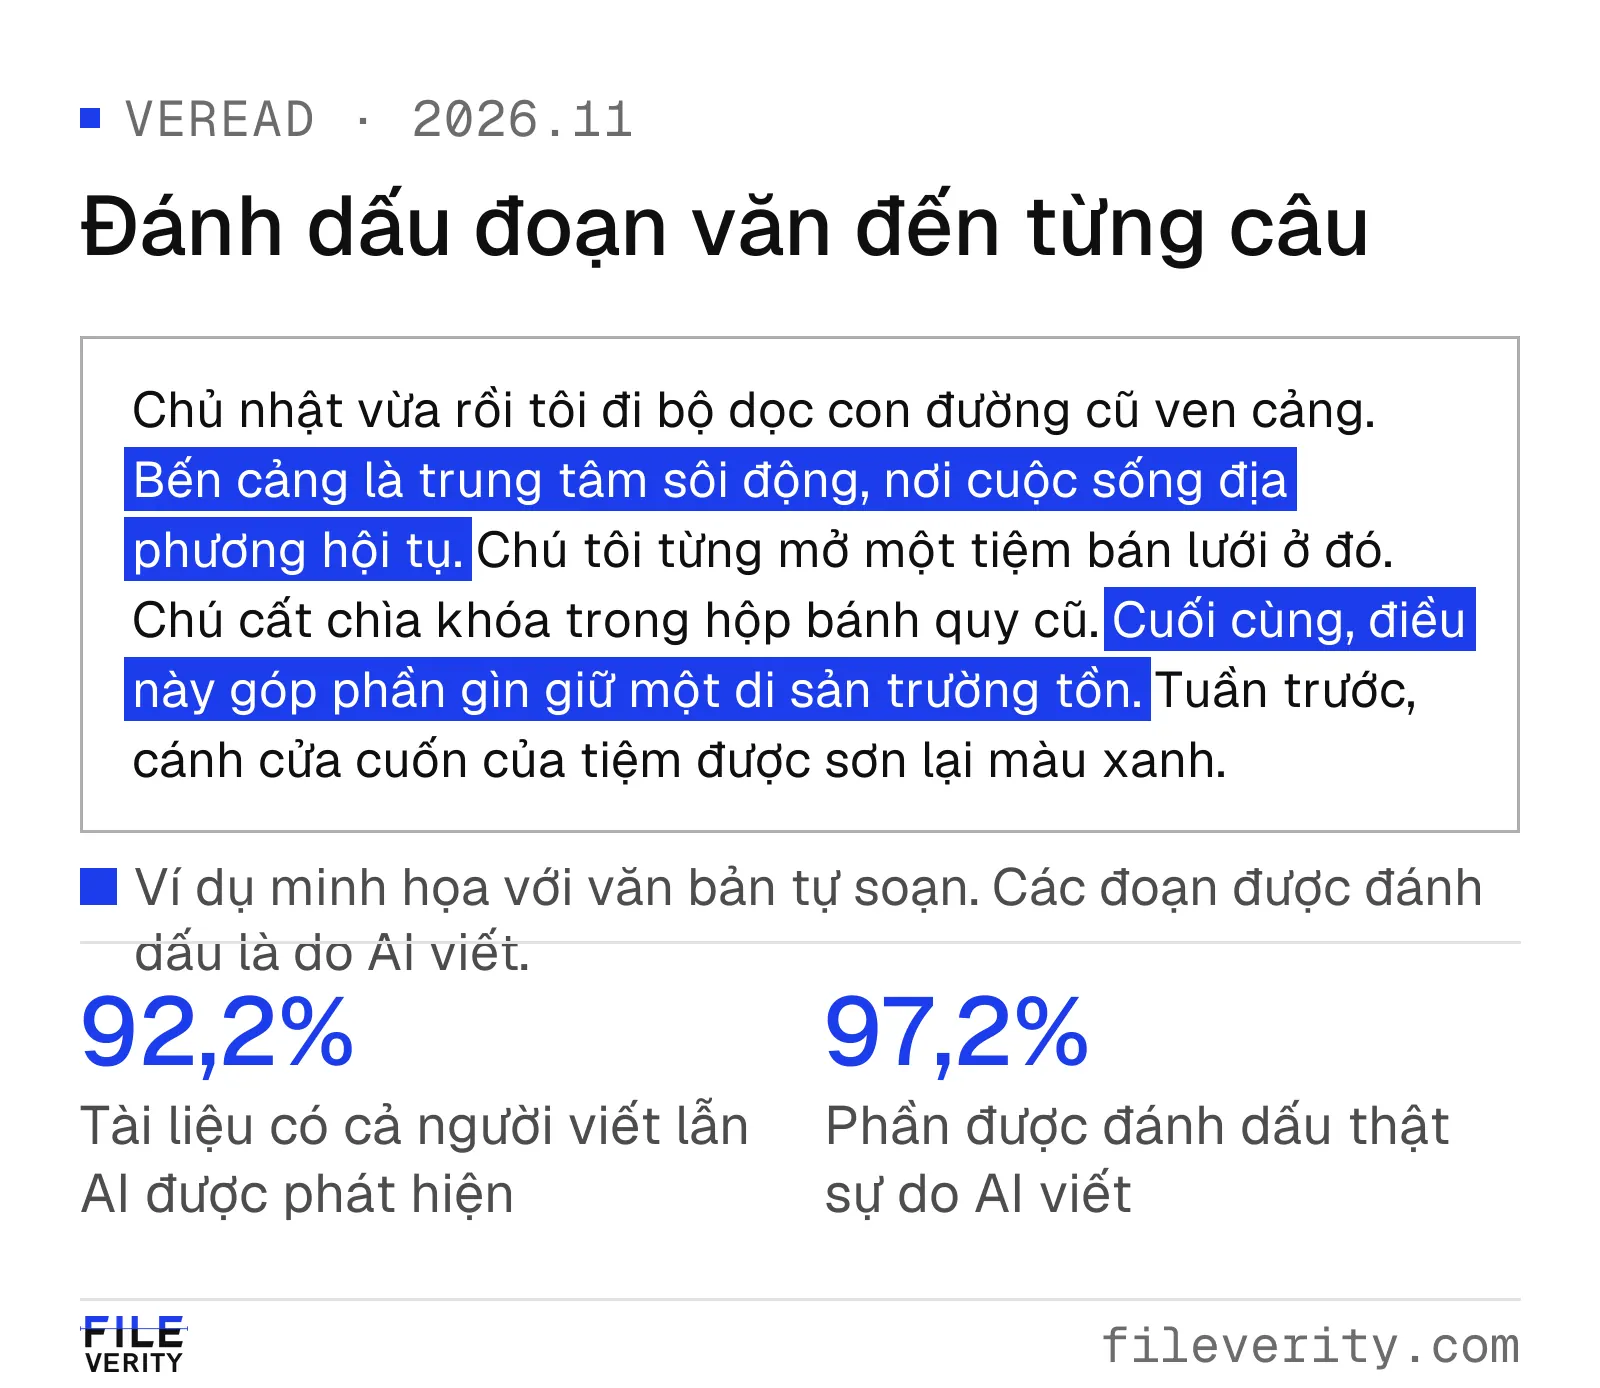
Ví dụ minh họa với văn bản tự soạn. Veread 1.1 đánh dấu các câu do AI viết trong một tài liệu có xen cả phần do người viết.
Kết quả vững ở cả bảy ngôn ngữ
Một mô hình phục vụ cả bảy ngôn ngữ, và mỗi ngôn ngữ đều được đo riêng.
| Ngôn ngữ | Văn bản do người viết bị gắn nhầm kết luận AI | Văn bản do AI viết và có AI hỗ trợ được phát hiện | Văn bản do AI viết hoàn toàn được phát hiện |
|---|---|---|---|
| Tiếng Anh | 0,18% | 94,5% | 95,1% |
| Tiếng Pháp | 0,45% | 96,8% | 99,1% |
| Tiếng Đức | 0,27% | 94,1% | 100% |
| Tiếng Tây Ban Nha | 0,41% | 96,0% | 100% |
| Tiếng Trung | 0,03% | 98,8% | 100% |
| Tiếng Việt | 0,48% | 92,8% | 95,5% |
| Tiếng Ả Rập | 0,13% | 97,5% | 98,5% |
Với văn bản do AI viết và có AI hỗ trợ, tỷ lệ phát hiện tăng từ 93,3% lên 94,5% ở tiếng Anh, từ 93,2% lên 94,1% ở tiếng Đức, từ 90,7% lên 92,8% ở tiếng Việt và từ 97,2% lên 97,5% ở tiếng Ả Rập. Với văn bản do AI viết hoàn toàn, tiếng Đức tăng từ 99,1% lên 100% và tiếng Việt từ 94,3% lên 95,5%.
Theo dòng mô hình, văn bản do AI viết hoàn toàn từ OpenAI, Alibaba, Mistral, xAI và Meta được phát hiện 100% (Meta từ 96,8%), DeepSeek 96,3% (từ 95,1%) và Google 95,9% (từ 93,9%).
Theo loại văn bản, văn bản học thuật và khoa học cũng như thư, email và đơn khiếu nại do AI viết hoặc có AI hỗ trợ được phát hiện 100%, còn bài viết của học sinh, sinh viên và người học đạt 99,1% (từ 98,1%).
Cách chúng tôi kiểm tra Veread
Một công cụ phát hiện chỉ đáng tin khi cách đánh giá nó đáng tin. Veread được xây dựng và kiểm định trên khối dữ liệu đồ sộ, độc quyền, do chuyên gia tuyển chọn, và mọi kết quả trong bài này đều đến từ quy trình đánh giá dưới đây.
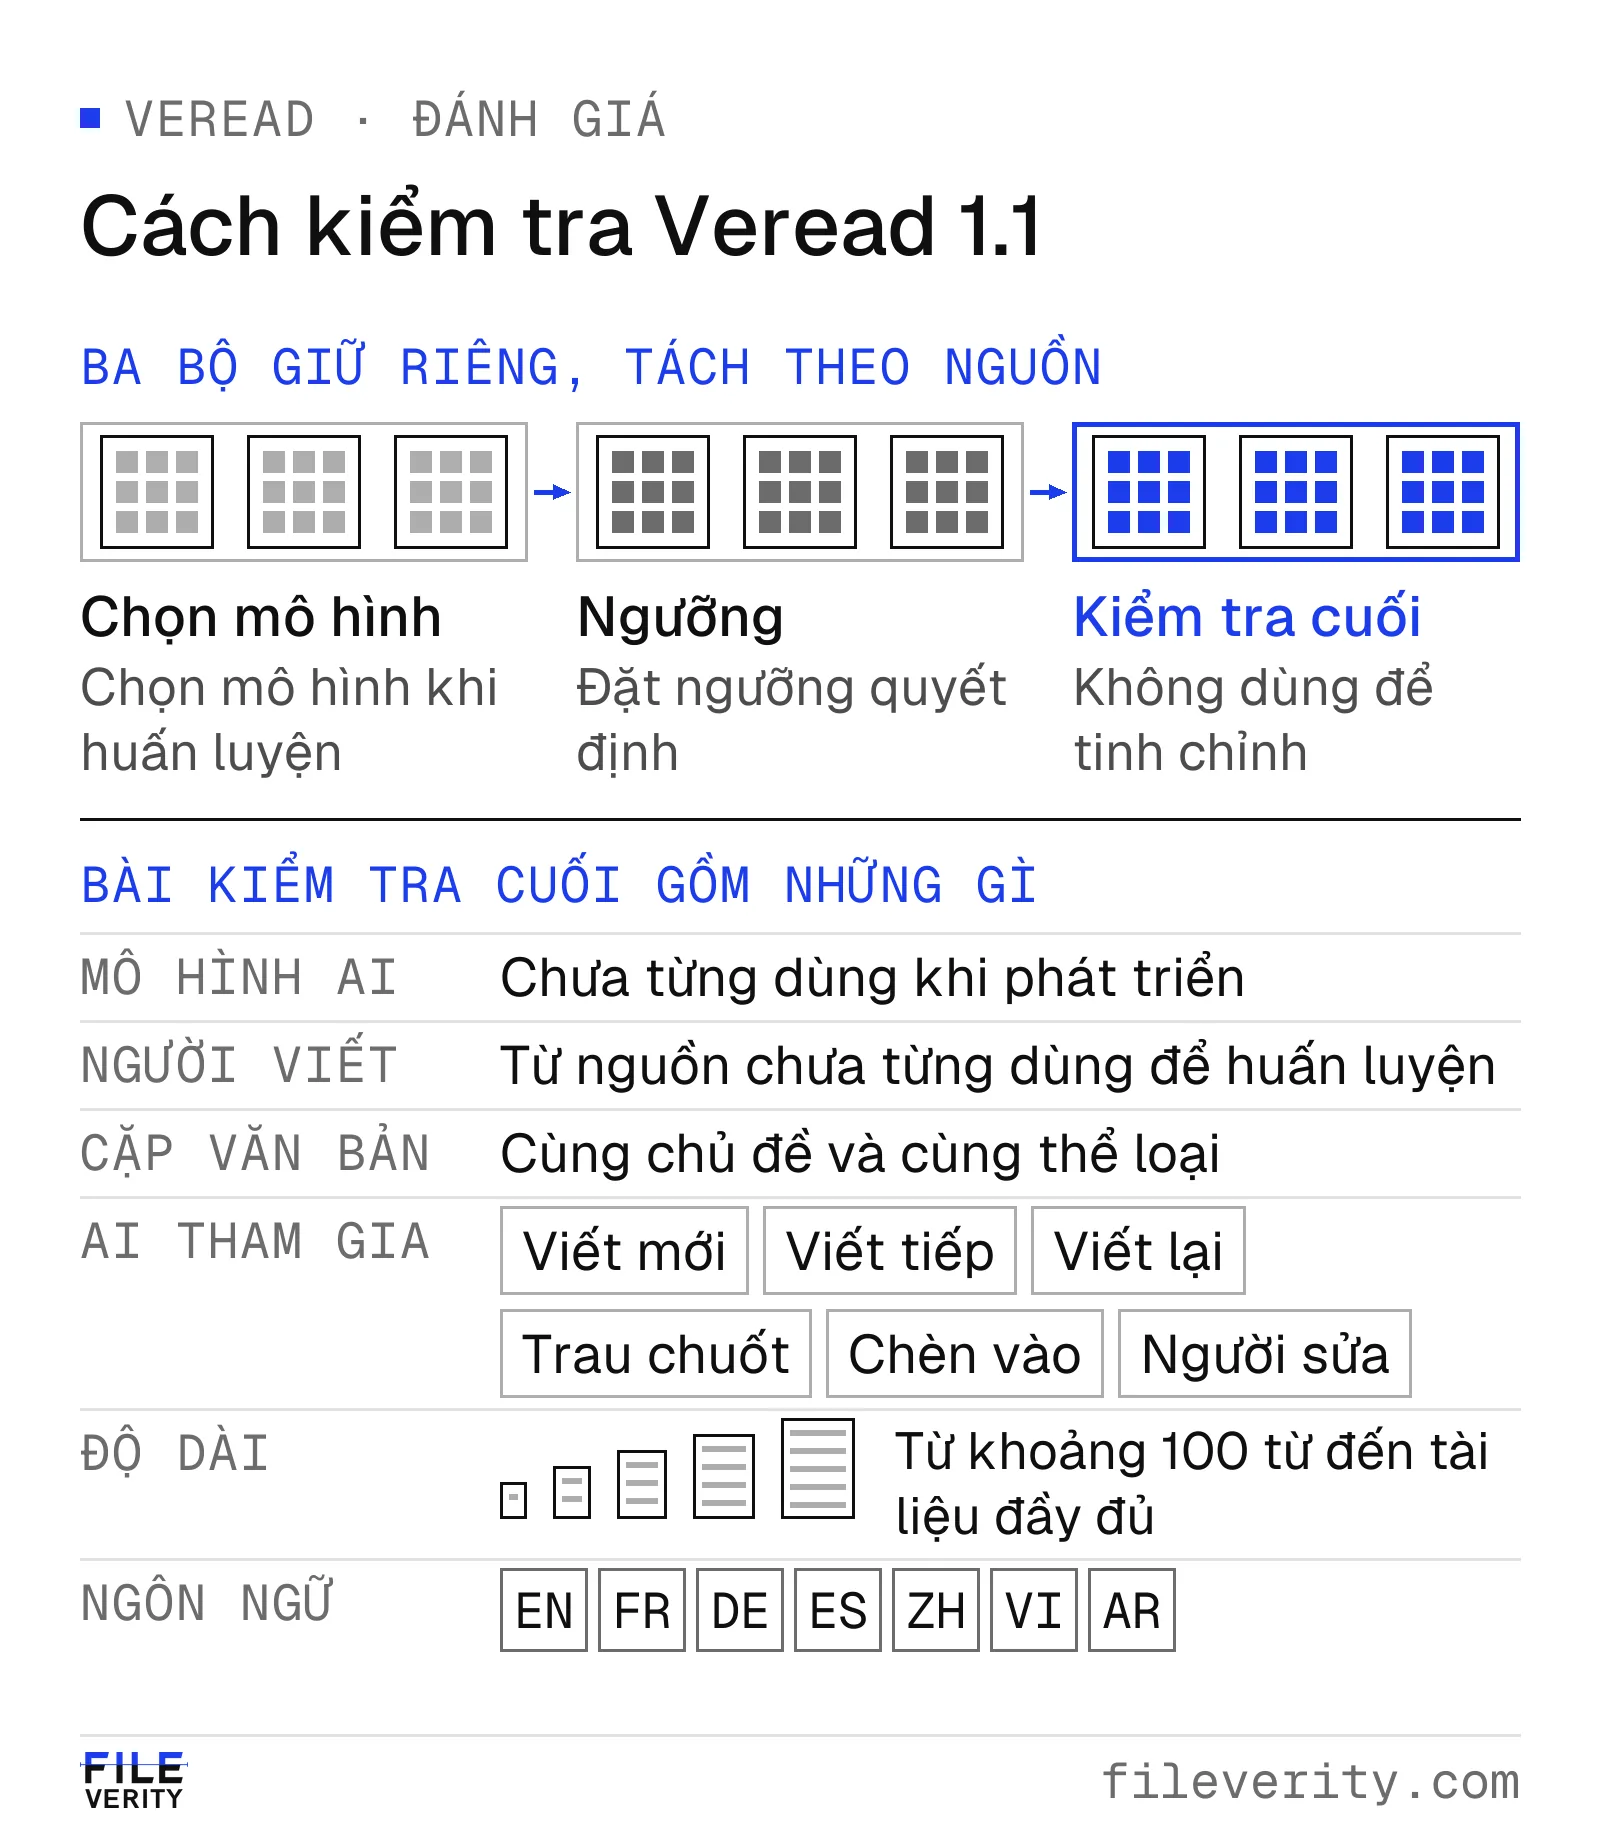
Quy trình đánh giá tách riêng việc chọn mô hình, đặt ngưỡng quyết định và bài kiểm tra cuối, và đo đúng hệ thống mà khách hàng sử dụng.
- Ba bộ dữ liệu giữ riêng, mỗi bộ một nhiệm vụ. Một bộ để chọn mô hình trong lúc huấn luyện, một bộ để đặt ngưỡng quyết định, và một bộ cho bài kiểm tra cuối. Bộ kiểm tra cuối không bao giờ được dùng để tinh chỉnh bất cứ điều gì.
- Tách theo nguồn. Các tài liệu cùng nguồn hoặc cùng nhóm tác giả luôn nằm cùng một phía khi chia dữ liệu, nên bài kiểm tra đo khả năng khái quát hóa chứ không đo khả năng ghi nhớ.
- Mô hình AI chưa từng thấy. Bài kiểm tra gồm văn bản từ những mô hình chưa từng được dùng ở bất kỳ bước nào trong quá trình phát triển.
- Nguồn văn bản người viết chưa từng thấy. Các nhóm văn bản của người viết từ những nguồn chưa từng dùng để huấn luyện giúp đo dương tính giả đúng như khách hàng gặp trong thực tế.
- Cặp văn bản tương ứng. Văn bản AI được viết cùng chủ đề và cùng định dạng với văn bản của người viết, nên công cụ phát hiện không thể đạt kết quả tốt chỉ nhờ nhận ra chủ đề hay định dạng.
- Mọi hình thức có AI tham gia. Viết từ đầu, người viết mở đầu rồi AI viết tiếp, viết lại, trau chuốt, đoạn do AI chèn vào văn bản của người viết, và người viết chỉnh sửa bản nháp do AI viết.
- Chỉ tính văn bản thật sự có AI viết. Một văn bản đã chỉnh sửa chỉ được tính là có AI hỗ trợ khi AI thực sự thay đổi câu chữ. Những chỉnh sửa nhẹ mà vẫn giữ nguyên câu chữ của người viết đều bị loại.
- Đủ mọi kiểu đầu vào. Từ đoạn trích khoảng 100 từ đến tài liệu đầy đủ, trong bảy ngôn ngữ, qua văn bản pháp lý và hành chính, văn học, bài viết của học sinh và sinh viên, bài báo khoa học, tin tức, nội dung web, đánh giá và diễn đàn, tài liệu thực hành, thư và đơn khiếu nại.
- Hệ thống vận hành thực tế. Kết quả được đo từ đầu đến cuối qua chính hệ thống đang phục vụ khách hàng, không phải trên một bản thử nghiệm trong phòng thí nghiệm.
Có sẵn ngay hôm nay
Veread 1.1 hoạt động từ ngày 18 tháng 11 năm 2026, bạn không cần làm gì thêm:
- Công cụ phát hiện văn bản AI trên web và Console.
- API, với mã mô hình không đổi (
veread-1-textcho văn bản,veread-1cho tài liệu) và một bản snapshot mới ghi ngày 2026-11-18. Xem tài liệu API phát hiện văn bản. - Báo cáo tài liệu, nơi Veread kiểm tra phần văn bản bên trong tài liệu. Trang độ chính xác nêu các số đo chính.
- Tiện ích Chrome và tính năng kiểm tra hàng loạt cho giáo viên.
Bảng kết quả đầy đủ của Veread 1.1, theo ngôn ngữ, loại văn bản và dòng mô hình, nằm trong báo cáo độ chính xác phát hiện văn bản AI của Veread.
Tác giả Yang Zheng